


为什么Python代码中混用下划线和点会报错?
深入解析在Python代码中混用下划线与点号导致报错的底层原因,对比属性访问与标识符命名规则,并提供排查与修复指南。
在编写Python代码时,混用下划线(_)与点号(.)之所以会报错,核心原因在于下划线在Python中是普通的标识符字符,用于构建单个名称;而点号是具有特殊运算语义的操作符,专门用于对象的属性访问或模块层级划分。当开发者误将点号当作变量名的一部分,或者将本该进行对象属性调用的操作写成了单一下划线名称时,Python解释器会因为词法分析切分错误或属性查找失败,分别抛出 SyntaxError 或 AttributeError。
一、语法本质:字符组成与操作符的差异
要搞清报错的根源,首先需要理解Python解释器在编译代码时是如何处理下划线和点号的。
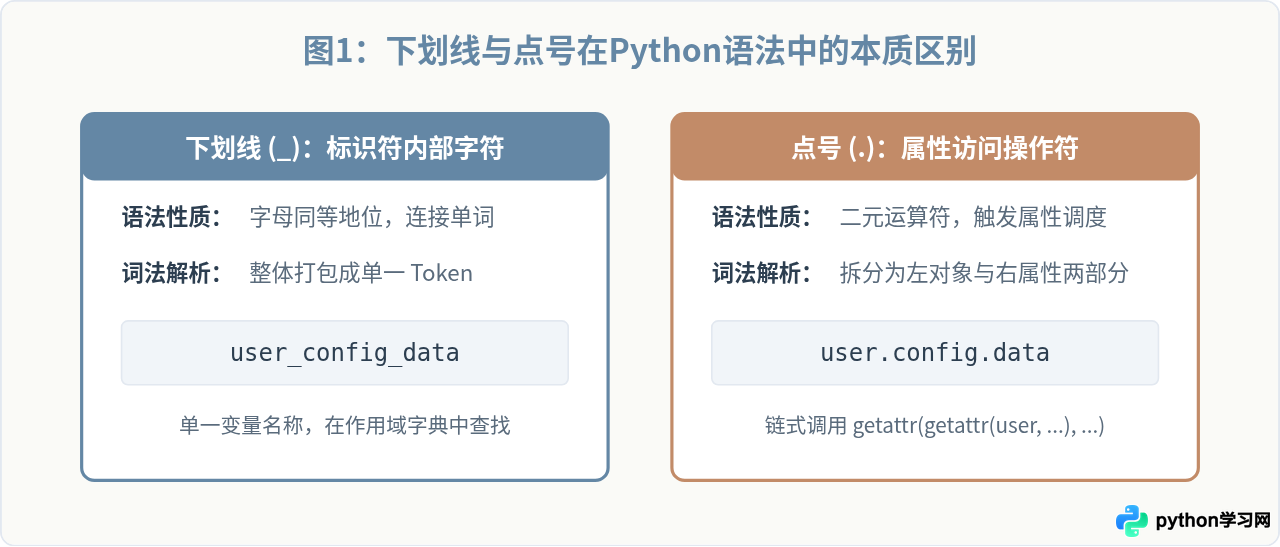
在Python官方语法规范中,变量名、函数名以及类名都统称为“标识符”(Identifier)。标识符的构成规则非常严格:只能包含字母、数字以及下划线,且不能以数字开头。也就是说,下划线 _ 在语法树中被归类为“字母字符”,它负责把多个单词粘合成一个完整的独立单词(例如 user_profile_data)。
相反,点号 . 在Python语法中根本不是合法的标识符字符。点号是一个操作符(Attribute Access Operator),其语法结构固定为 表达式.标识符。每次解释器遇到点号,都会将其拆解为左右两部分:左边必须是一个可以求值的对象表达式,右边必须是该对象拥有的有效属性或方法名。
二、常见的两大混用报错场景与原因分析
混用下划线和点号通常在两种完全不同的代码场景下发生,触发的错误类型也截然不同。
场景一:把点号误当成普通命名分隔符(引发 SyntaxError 或 NameError)
许多初学者或从R语言迁移过来的开发者(R语言中允许使用 model.data 作为变量名),习惯性地用点号来分隔单词:
# 错误示例:试图定义一个包含点号的变量名
student.name = "张三"
底层原因分析:
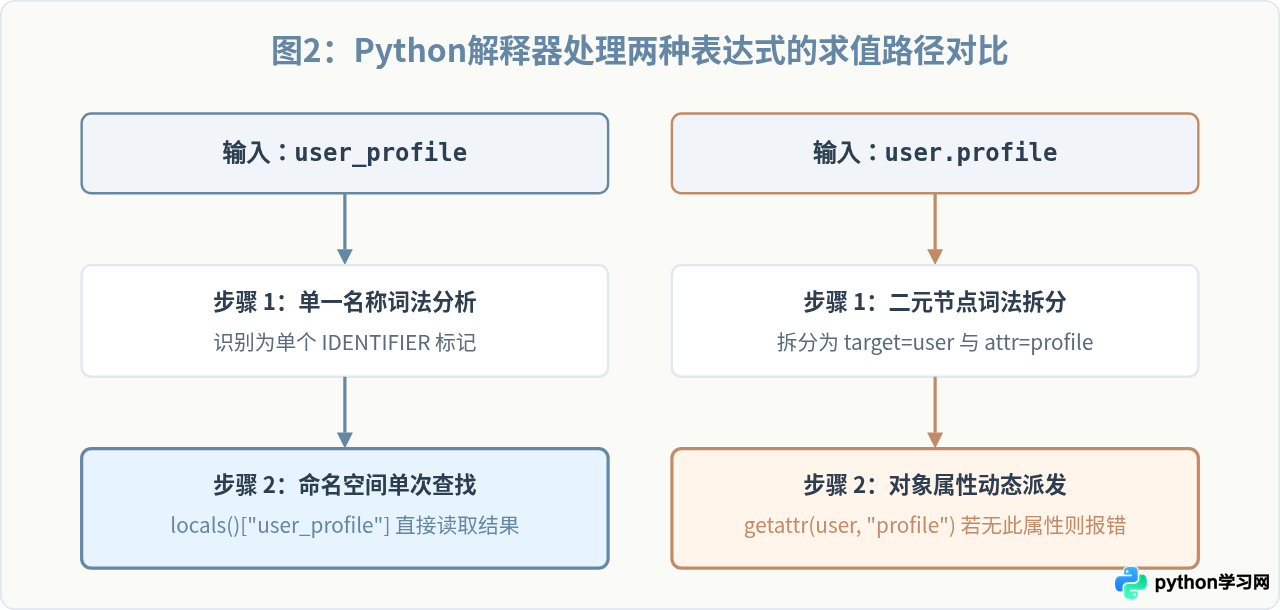
当解释器看到 student.name = "张三" 时,它不会将 student.name 视作一个变量,而是判定为“试图给对象 student 的 name 属性赋值”。此时如果当前作用域中根本没有定义过 student 对象,Python立即抛出 NameError: name 'student' is not defined;若写在函数参数列表里(例如 def process(data.file):),语法解析器在编译期就会直接抛出 SyntaxError: invalid syntax,因为函数形参只能是合法标识符,不能包含操作符。
场景二:属性访问与下划线拼写混用(引发 AttributeError)
在面对第三方库、内置对象或类实例时,开发者常常记不清方法或属性使用的是蛇形命名(snake_case)还是点式链式调用:
# 常见错误 1:试图调用模块中的复合函数
import os
path = os.path_exists("test.txt")  # 报错:AttributeError: module 'os' has no attribute 'path_exists'

# 正确写法:os 模块下有 path 子模块,path 子模块中包含 exists 函数
path = os.path.exists("test.txt")
# 常见错误 2:混淆属性与子方法
class ModelConfig:
def __init__(self):
self.learning_rate = 0.01
cfg = ModelConfig()
print(cfg.learning.rate) # 报错:AttributeError: 'ModelConfig' object has no attribute 'learning'底层原因分析:
对象属性访问是通过 __getattribute__ 机制在对象的属性字典中查找键名。在错误1中,os 命名空间中只有名为 path 的模块对象,根本不存在键名为 "path_exists" 的属性;在错误2中,cfg 只有 learning_rate 这个单键,试图先解析 cfg.learning 就会在第一步报错中途退出。
三、遇到报错时的排查与修复步骤
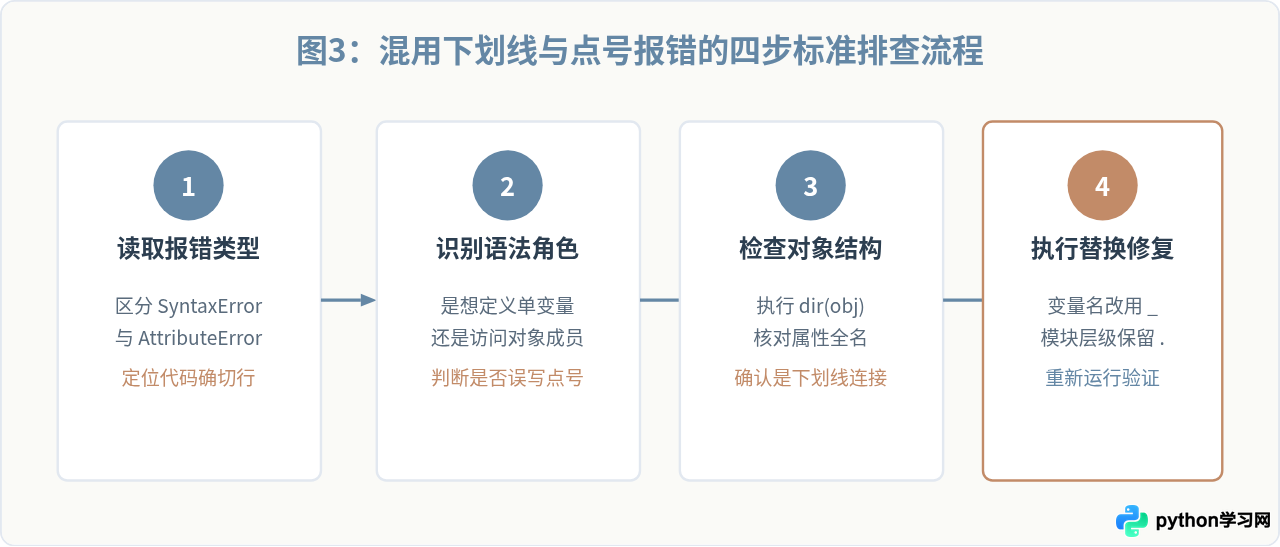
当终端中弹出包含点号或下划线的报错信息时,建议按照以下具体步骤进行排查:
- 核对Traceback错误类型:
- 如果是
SyntaxError:检查是否有在变量定义、函数形参或字典解包中误输入了点号。 - 如果是
AttributeError:确认报错对象右侧的点号属性名,是否实际上应该是一个带下划线的连贯方法(例如将str.lower_case误写为str.lower.case)。
- 如果是
- 检查左侧操作数是否存在:
对于形如
obj.field的报错,先在终端或脚本中通过print(type(obj))或dir(obj)检查obj的真实类型及其所暴露的有效属性清单。 - 对照官方库命名规范:
Python标准库严格遵循 PEP 8 命名规范:普通模块、函数、属性名使用小写加下划线命名法(
snake_case);只有在跨模块引入(如urllib.request)或访问实例方法(如dataframe.to_csv)时才会使用点号。
四、代码修复与正确书写对比
通过实际场景中的错误写法与修复写法的对照,可以更直观地把握正确用法:
凡是作为一个整体概念的变量或函数名,单词之间只能使用下划线;凡是表达“从属关系”、“模块/包层级”或“对象调用方法”,层次之间必须使用点号。
下表展示了常见误区及其修复方式:
- 误区一:文件路径与配置命名
错误:file.path = "data.csv"(在未定义file时报错NameError)
修复:file_path = "data.csv"(作为单变量声明) - 误区二:内置函数与模块误拼
错误:json.load_file(f)(报错AttributeError: module 'json' has no attribute 'load_file')
修复:json.load(f)(使用标准模块内置的下划线/单一标识符函数) - 误区三:双下划线特殊方法被误写成点号
错误:obj.init()或obj._init_()
修复:def __init__(self):(Python魔法方法固定使用前后各两个下划线包围)
五、总结与编码规范决策图
总结来说,Python 中混用下划线和点号产生报错,不是解释器的偶然限制,而是语法层面“词法标识符”与“句法语义操作符”职责分离的必然结果。遵守 PEP 8 命名准则,在设计变量和调用对象属性时理清它们的归属层级,即可从根源上杜绝此类错误。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















