


怎么制定基于在线网站的Python系统自学路径
针对自学者在海量网络资源中容易迷失、无法形成系统能力的问题,全面解析如何分类甄选在线网站、分阶段搭建从语法破冰到独立工程交付的Python自学路径,并建立高效的本地实践闭环。
一、在线网站学习的核心矛盾与四象限分类
很多自学者在刚接触 Python 时,习惯在各大搜索引擎、技术社区和视频网站中收藏数十个书签:从交互式语法平台到视频长课,再到算法刷题网站。然而,数周后往往发现自己仍然处于“只记住了变量定义、离开了网页运行按钮就不会写程序”的窘境。这种现象在编程自学中被称为“教程陷阱”(Tutorial Hell)。
出现这一问题的根本原因在于混淆了不同网站在学习流程中的职责边界。任何在线教程网站由于自身产品形态的限制,都只能覆盖学习链条的一部分。要在自学中获得系统性,第一步必须建立清晰的网站分类认知,明确定位各自的分工。
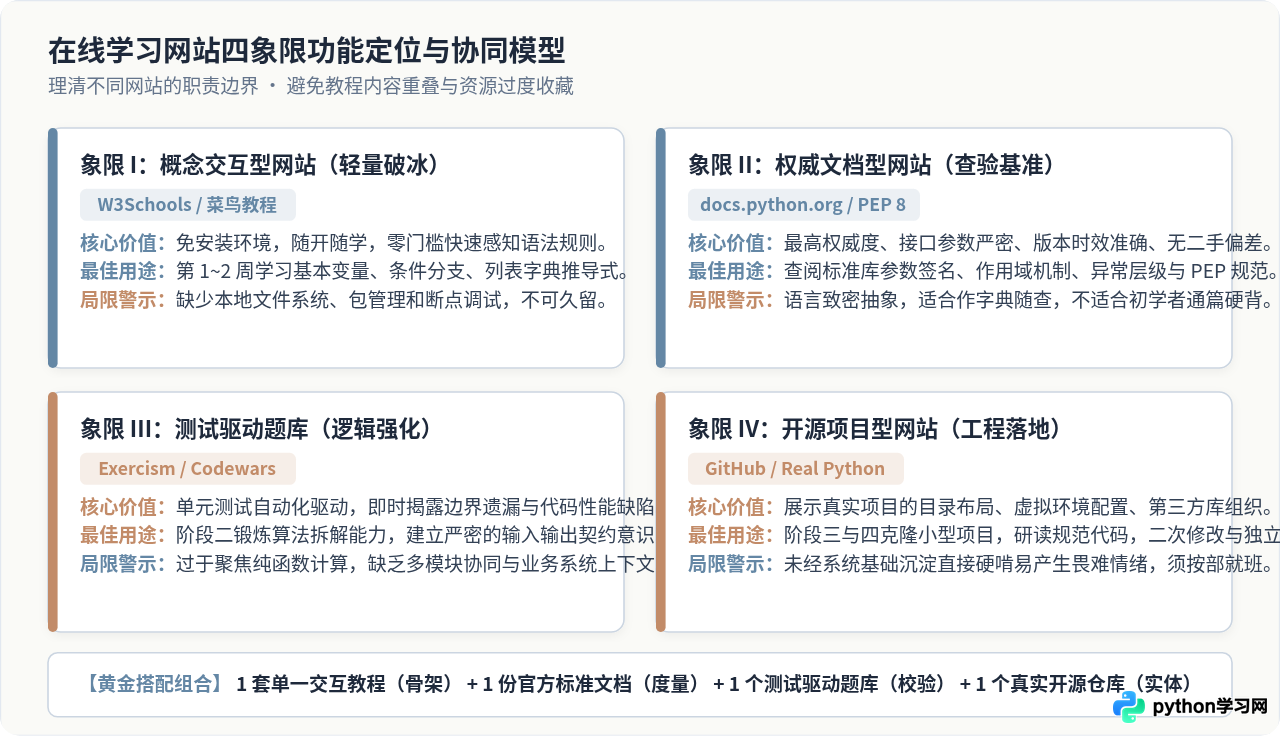
在整体路径中,应将不同网站严格划分为四个功能象限,并在特定时期采取不同的搭配策略:
- 概念交互型网站(轻量破冰):以菜鸟教程、W3Schools、廖雪峰 Python 教程为代表。这类平台提供网页内直接执行代码的简易沙盒与平实讲解,主要价值在于初学前两周迅速扫清语法概念盲区,获得即时正向反馈。但其局限在于没有真实文件系统读写、第三方模块安装与调试环境,读者在掌握基础语法后必须主动离开。
- 官方权威型文档(查验基准):以 Python 官方文档(
docs.python.org)、官方教程、PEP 8 编码规范及 Real Python 深度专栏为代表。其信息准确度最高、接口更新最及时。官方文档适合作为编写代码时的权威手册,用于核对标准库参数与作用域规则,而非从第一页逐行背诵。 - 自动化题库型网站(逻辑强化):以 Exercism、Codewars 及初级 LeetCode 为代表。这类网站的最大特点是自带严谨的单元测试(如
pytest断言),迫使自学者写出满足各种边界用例的健壮代码,消除在交互教程中“随便打印一下算看懂”的虚假掌握感。 - 工程开源型仓库(交付落地):以 GitHub 优质小型开源项目、freeCodeCamp 和 Kaggle 为代表。自学者在这里能观察到真实的工业级项目结构:虚拟环境配置、依赖声明文件(
pyproject.toml或requirements.txt)、测试目录与模块分层。
在任何一个学习周期内,务必遵循“1 套主干交互教程作为骨架 + 1 份官方标准库文档作为裁判 + 1 个测试驱动题库作为磨刀石 + 1 个真实开源项目作为对照”的组合策略。坚决拒绝同时开启三套同质化的入门教程。
二、四阶段自学路径的递进设计与交付产物
系统化自学不能依靠宽泛的时间安排,而必须依靠清晰的阶段目标与硬性的交付产物作为准出标准。以下是将在线资源深度融入的四个递进学习阶段。
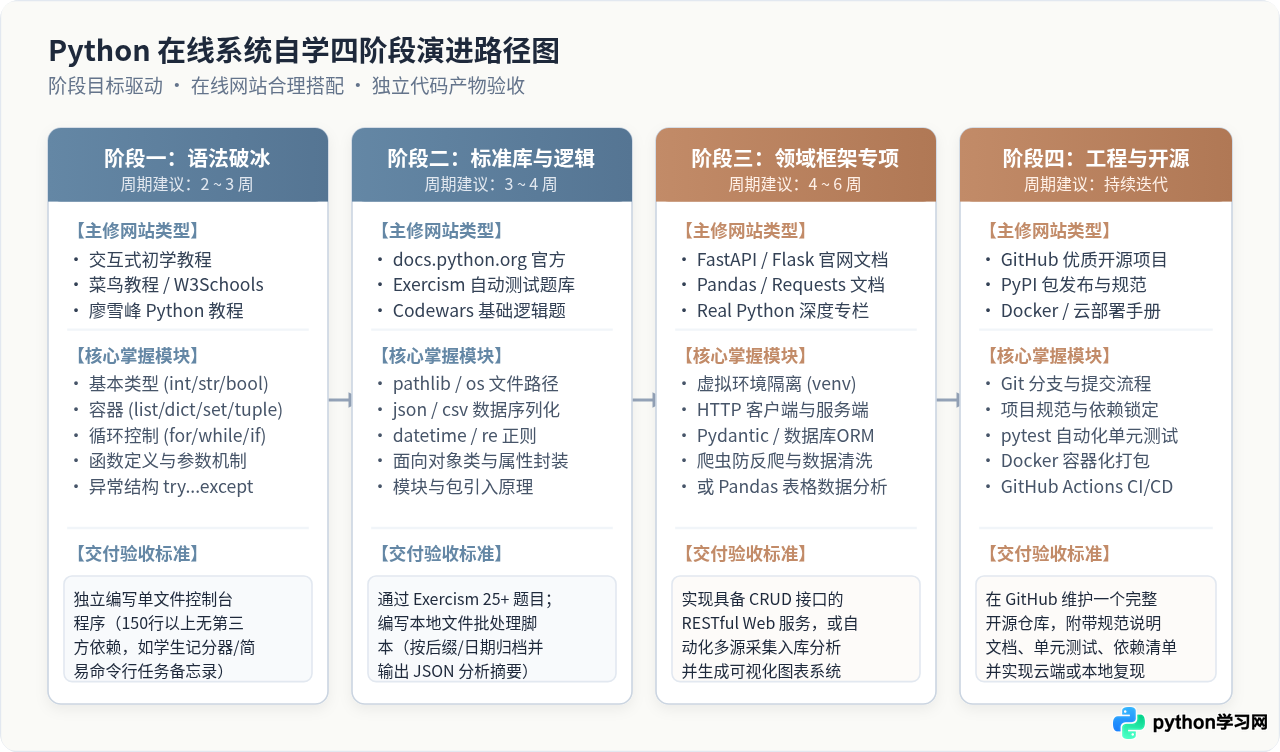
阶段一:核心语法破冰与控制台交互(周期:2 ~ 3 周)
该阶段的核心任务是掌握 Python 的基础语法规则和运行模型,消除对代码符号的陌生感。在这个阶段,自学者需要专注吸收语言的最基本构造:
- 数据类型与容器:整型、浮点型、布尔型、字符串处理与常用切片;列表(
list)、元组(tuple)、字典(dict)、集合(set)的核心增删改查方法与推导式。 - 逻辑与控制流:条件判断分支(
if / elif / else)、迭代循环(for ... in、while、break / continue)。 - 函数机制:参数定义规则(位置参数、默认参数、
*args、**kwargs)、返回值(return)及变量局部与全局作用域。 - 基础异常处理:掌握
try ... except Exception as e的拦截用法,理解程序遭遇错误时不应直接崩溃,而应给出明确提示。
主线选站与执行要求:选定一套讲解平实的交互网站(例如廖雪峰 Python 基础篇或官方 Tutorial)。网页上的每一个示例代码,都必须在本地编辑器(如 VS Code)中手动敲入,并在本地终端中执行。严禁直接复制代码。
准出交付产物:在不引入任何第三方依赖库的前提下,独立编写一个行数超过 150 行的控制台应用程序(例如:简易学生成绩增删查改终端、命令行记账助手或文本频次统计工具)。
阶段二:标准库进阶与代码逻辑强化(周期:3 ~ 4 周)
掌握语法后,如果直接去学庞大的 Web 框架或深度学习框架,往往会因为基础不扎实而寸步难行。阶段二的关键在于深入 Python 内置的强大标准库,并强化算法逻辑。
- 现代路径与文件系统:使用
pathlib.Path代替繁琐的旧式字符串拼接,掌握文件的创建、遍历、重命名和文本写入。 - 数据解析与序列化:掌握
json.dumps()、json.loads()处理结构化数据,掌握内置csv模块的读写操作。 - 时间与文本匹配:掌握
datetime、timedelta的格式化与计算;掌握re正则表达式的基本匹配规则。 - 面向对象编程基石:掌握
class的声明、__init__构造函数、实例方法、类属性及私有属性约定。
主线选站与执行要求:主要参考 docs.python.org 标准库章节;同时将 Exercism(Python Track)作为日常练兵场。Exercism 提供了本地 CLI 工具,每道题都配有一组严格的测试脚本,本地运行 pytest 全部通过后方可提交到网页记录。这能从根本上培养严谨的编码规范。
准出交付产物:在 Exercism 上通过至少 25 道涉及字符串、字典、递归与类的练习题;同时手写一个能扫描指定文件夹、根据文件扩展名与修改日期自动整理归档,并生成 JSON 格式分析报表的本地批处理程序。
阶段三:垂直领域技术栈专项突破(周期:4 ~ 6 周)
在夯实了标准库和面向对象编程之后,自学者应当根据实际工作或兴趣诉求,选择一个垂直方向进行单点突破。常见的两个高回报方向为:
- 方向 A:Web 后端与 API 设计(推荐轻量级技术栈)
学习 HTTP 请求方法(GET/POST/PUT/DELETE)、状态码与 JSON 通信规范。选用现代异步微框架 FastAPI 或 Flask。重点阅读 FastAPI 官方文档(其文档包含从零到工程落地的全部教学)。掌握
pydantic字段校验机制,以及 SQLite 数据库与简易 ORM(如 SQLModel 或 Peewee)的结合使用。 - 方向 B:自动化脚本与数据处理
使用
requests或httpx库抓取合法公开数据接口,结合BeautifulSoup或parsel进行 DOM 结构抽取。随后学习数据分析基石库 Pandas,掌握DataFrame的索引、分组聚合(groupby)、缺失值处理与多表合并,最后使用 Matplotlib 导出基础业务趋势图表。
准出交付产物:如果是 Web 方向,交付一个具备完整增删查改(CRUD)功能并自动生成 Swagger 在线文档的 RESTful API 服务;如果是数据方向,交付一个包含定时抓取公开数据、清洗转换并输出 Excel 报表与图表的自动化管道系统。
阶段四:工程规范、Git 协作与开源实战(周期:持续演进)
个人写单文件代码与工业界工程规范之间存在巨大的鸿沟。阶段四的目标是使自己的代码仓库符合现代软件工程的标准规范:
- 环境隔离与依赖管理:熟练使用
python -m venv .venv创建隔离环境,熟练使用pip freeze > requirements.txt或pyproject.toml锁定运行依赖。 - 版本控制习惯:在 GitHub 上建立代码仓库,学会写清晰规范的 Git Commit 消息,掌握基本的拉取、合并与分支管理。
- 测试与工程目录分层:使用
pytest编写针对核心业务逻辑的单元测试;代码结构区分src/、tests/、docs/。 - 部署与轻量容器化:编写简单的
Dockerfile并在本地构建镜像运行,或者部署到云服务器或轻量 PaaS 平台。
准出交付产物:在 GitHub 建立并维护一个公开仓库,包含规范的 README.md(阐述项目背景、本地安装步骤、运行指令与接口说明)、完整的测试用例,并且任意第三方克隆该仓库后能依据文档一键运行成功。
三、从“浏览网页”到“本地工程”的四步操作闭环
在制定好宏观路线后,能否学成很大程度上取决于每一天的学习动作是否形成了有效的反馈循环。以下是推荐的日常四步操作闭环:
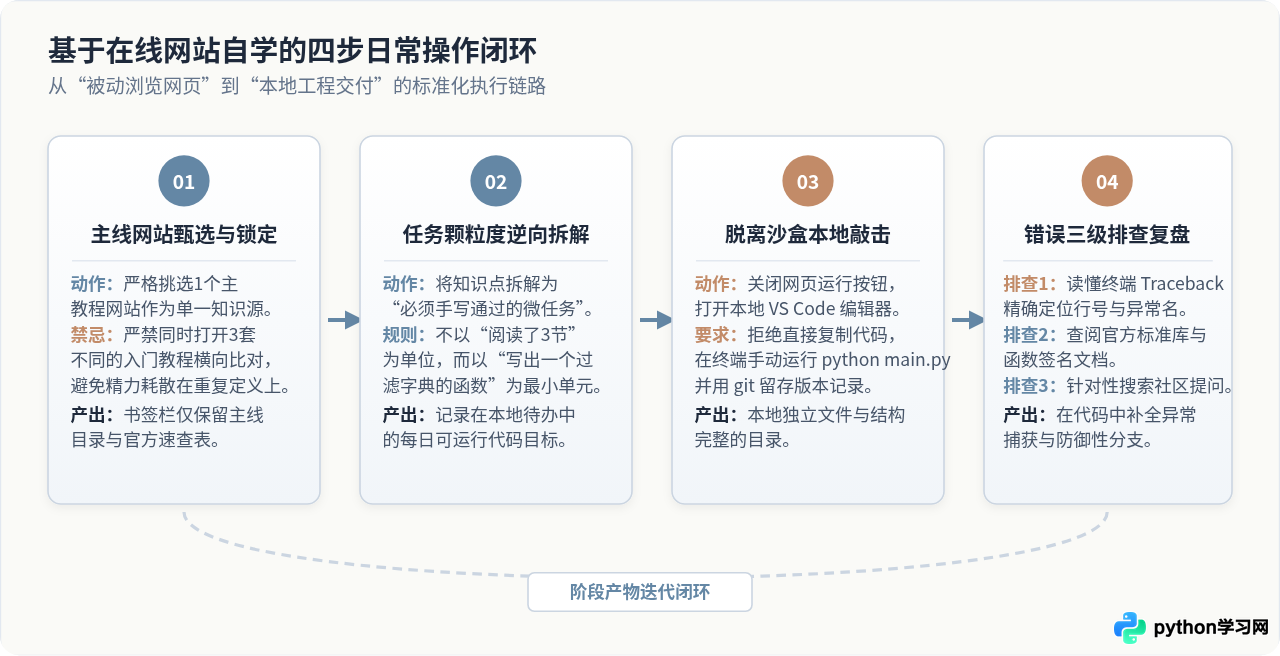
第一步:主线网站甄选与单点绑定
在开展新模块学习前,仅在书签栏保留 1 个主线网站。若本周学习核心是“函数式编程与闭包”,只需选定官方文档对应章节或 Real Python 的单篇专题。切忌在搜索引擎中搜索“闭包最好的教程”并连开 10 个网页,这会导致信息过载与认知疲倦。
第二步:任务颗粒度逆向拆解
拒绝把“今天看完教程第 5 章”作为学习计划。这种以阅读量计量的计划极易造成“看完就忘”。应采用以功能输出为导向的度量方法,例如:
- “今天手写一个接受任意数量数字并返回均值与方差的函数”;
- “今天编写一个读取本地
config.json并解析为自定义对象的模块”; - “今天在 Exercism 上通过 2 个包含字符串翻转与元音统计的练习”。
第三步:脱离网页沙盒,在本地 IDE 输入与落盘
在线交互网站虽然方便,但不能让人学会真正的开发习惯。必须在第一周就完成本地环境的基础搭建。以下是本地工作流的标准命令参考:
# 1. 创建项目目录并进入
mkdir -p ~/projects/py-learning/task-day01
cd ~/projects/py-learning/task-day01

# 2. 创建并激活 Python 虚拟环境
python3 -m venv .venv
source .venv/bin/activate  # macOS/Linux 环境
# 或 .venv\Scripts\activate  # Windows 环境

# 3. 新建主程序文件并开始手写代码
touch main.py
code .  # 在 VS Code 中打开

# 4. 在终端直接运行调试
python main.py
在本地编辑器编写代码时,主动开启代码补全与格式化工具(如 Black 或 Ruff)。当你在本地面对空白编辑器能够敲出可运行的代码时,才说明知识真正内化为你自己的技能。
第四步:错误三级排查与反思沉淀
自学过程中最容易让人退缩的是程序运行报错。建立结构化的三级排查习惯,是拉开普通自学者与优秀工程师差距的关键:
- 第一级(阅读终端 Traceback):很多初学者一看到红字报错就感到慌乱,直接复制整个终端内容去搜索。正确做法是顺着调用栈直接看最底下一行,获取具体的异常类型(如
KeyError,TypeError,AttributeError)以及具体的报错行号。 - 第二级(查阅官方文档与参数类型):通过报错行找出调用的函数名,直接到官方文档中查验该函数的形参要求与返回值类型,确认自己传入的变量类型是否匹配。
- 第三级(精确搜索技术社区):若仍无法理解根因,提取错误类型 + 最小核心关键词在 Stack Overflow 或 GitHub Issues 中进行搜索,严禁将包含个人本地私有路径的无意义字符串复制到搜索框中。
四、常见认知偏差与破局对策
在以在线网站为载体的自学过程中,绝大多数人都会在不同阶段遇到典型瓶颈。及早识别这些认知偏差,能大幅降低放弃率。
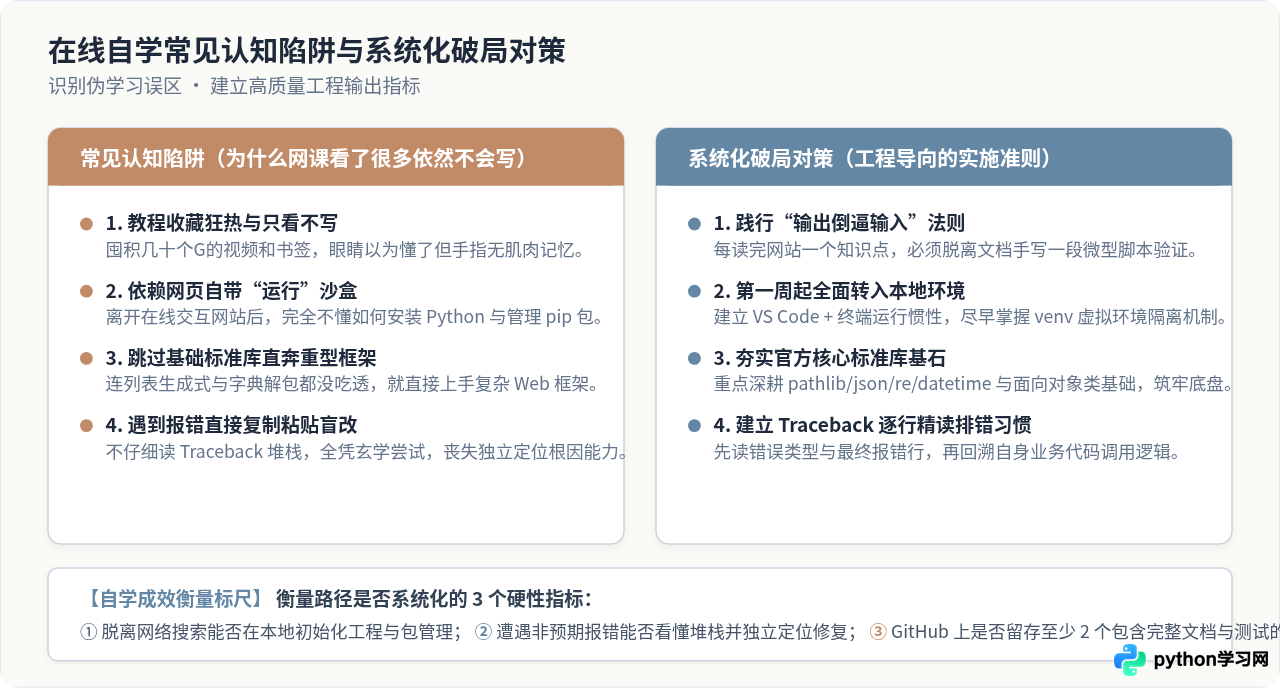
| 常见陷阱类型 | 典型表征与危害 | 破局执行对策 |
|---|---|---|
| 教程囤积综合征 | 网盘收藏数百 GB 视频、书签收藏上百个教程网站,但实际敲代码时间每周不足 2 小时。 | 强制单源原则:清空冗余书签,只保留当前阶段的唯一主线站点,执行“看 1 小时文档,写 2 小时代码”的铁律。 |
| 网页沙盒依赖症 | 在交互网站上点击“Run”按钮一切正常,换到本地终端连 pip install 和环境变量都无法正确配置。 |
本地第一准则:第三天起全面弃用网页在线执行窗口,所有代码统一在本地编辑器内输入,通过命令行运行。 |
| 跳步追赶框架热点 | 在尚未搞懂面向对象与异常捕获前,直接套用大型 Web 或 AI 框架,遇到细微报错完全束手无策。 | 阶段门禁机制:必须完成阶段二的标准库与 25 道题库练习后,才允许开启阶段三的第三方框架学习。 |
| 代码复制黏贴惯性 | 直接拷贝教程源码并运行成功,误以为自己已经掌握,换一个题目依然无法动笔。 | 遮挡重写练习:读懂代码后遮住教程页面,凭理解在本地重新敲写全部代码,直到能够无参考顺利通过。 |
五、阶段验收自测清单与行动建议
为了确保制定的学习路径落到实处,自学者可以在每个学习阶段结束前,对照以下自测清单评估当前的技术成熟度:
- 阶段一检查项 能否脱离教程,独立手写实现包含循环、函数、字典列表嵌套及异常拦截的控制台交互小工具?
- 阶段二检查项 是否能熟练使用
pathlib遍历文件夹、使用json读写数据,并在 Exercism 题库中通过包含多项测试用例的算法题? - 阶段三检查项 能否使用
venv创建纯净虚拟环境,正确安装第三方依赖,并独立实现一个具备结构化数据交互的 Web API 或数据自动化抓取程序? - 阶段四检查项 在 GitHub 上是否拥有至少 1 个结构严谨的个人项目,具备规范的
README.md、依赖清单与单元测试,且他人克隆后能顺利运行?
制定基于在线网站的自学路径,本质上是用自律和结构化的工程方法,去战胜互联网信息的无序与碎片化。不要追求在最短时间内“浏览完”最多的网站,而要追求用最克制的网站组合,在本地写出最高质量的交付代码。当你真正把注意力从“看教程”转移到“写代码、解报错、推仓库”时,Python 系统的自学路径便已经顺畅运转起来。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















