


Python基础语法代码示例:变量、循环与条件判断
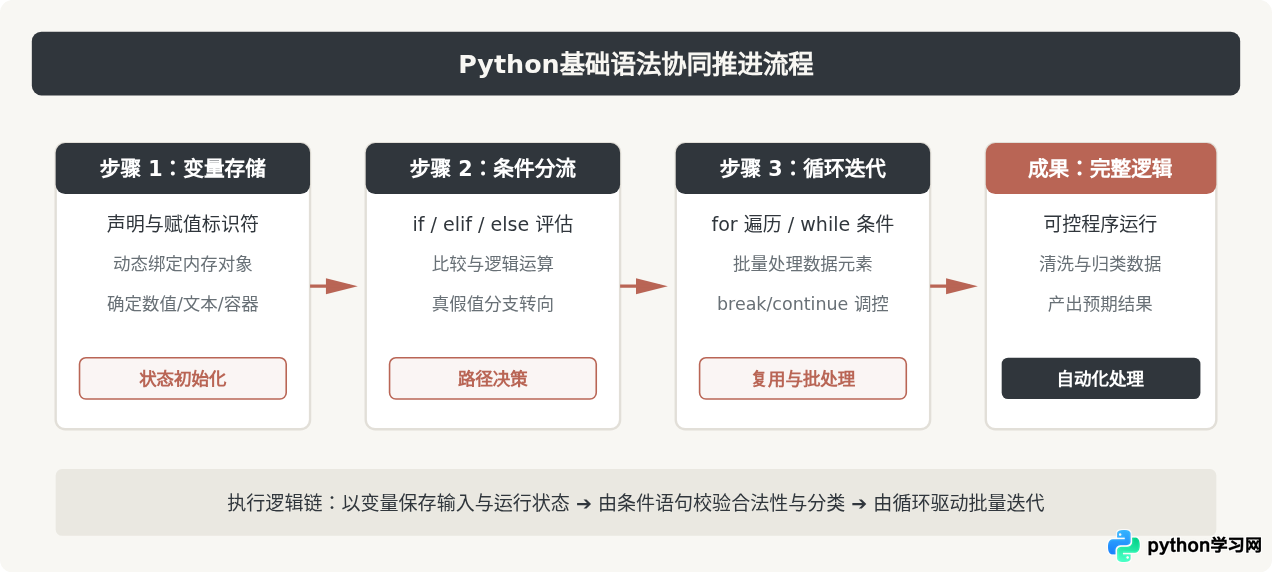
本文通过完整、规范的代码示例,深入讲解Python基础语法中的三大核心基石:变量定义与数据类型、条件分支判断(if-elif-else)以及循环控制(for与while),并结合综合实战演示其协同工作逻辑。
编写任何 Python 程序的核心,都在于组织数据并指挥计算机按照设定逻辑作出决策和重复动作。这一过程依靠三个最根本的语法支柱:用于存储和标记数据的变量、用于依据状态做出路径选择的条件判断,以及用于自动化重复任务的循环结构。本文将通过简洁规范的代码示例,逐一拆解这三者的语法规则、底层工作方式与常见边界陷阱,并在文末提供一个综合实例展现三者的协作模式。
一、变量:数据定义与引用机制
在 Python 中,变量不需要事先声明数据类型,也无需使用特定关键字(如 C 语言中的 int 或 JavaScript 中的 let)。创建变量的过程就是“变量名 = 表达式”的赋值语句。当执行该语句时,Python 会在内存中创建对应的值对象,然后将变量名绑定到该对象上。
1. 变量定义与常用数据类型
以下代码演示了数值、字符串、布尔值及常用容器类型的变量赋值:
# 整数与浮点数
item_count = 12
unit_price = 19.9

# 字符串与布尔值
product_name = "机械键盘"
is_in_stock = True

# 列表与字典
tags = ["办公", "外设", "热插拔"]
product_info = {
    "name": product_name,
    "price": unit_price,
    "available": is_in_stock
}

print("商品:", product_name)
print("总价估算:", item_count * unit_price)
print("属性字典:", product_info)总价估算: 238.8
属性字典: {'name': '机械键盘', 'price': 19.9, 'available': True}
2. 变量命名与类型转换规则
定义变量时必须遵循以下规范:
- 命名格式:变量名只能包含字母、数字和下划线,且不能以数字开头。推荐采用全小写字母加下划线的蛇形命名法(如
user_age)。 - 避开保留字:不能使用
if、for、while、class、def等 Python 内置关键字。 - 显式类型转换:虽然 Python 是动态类型语言,但它是强类型语言,不同类型数据之间不会自动隐式转换。进行混合运算时必须显式转换,例如
int("25")或str(100)。
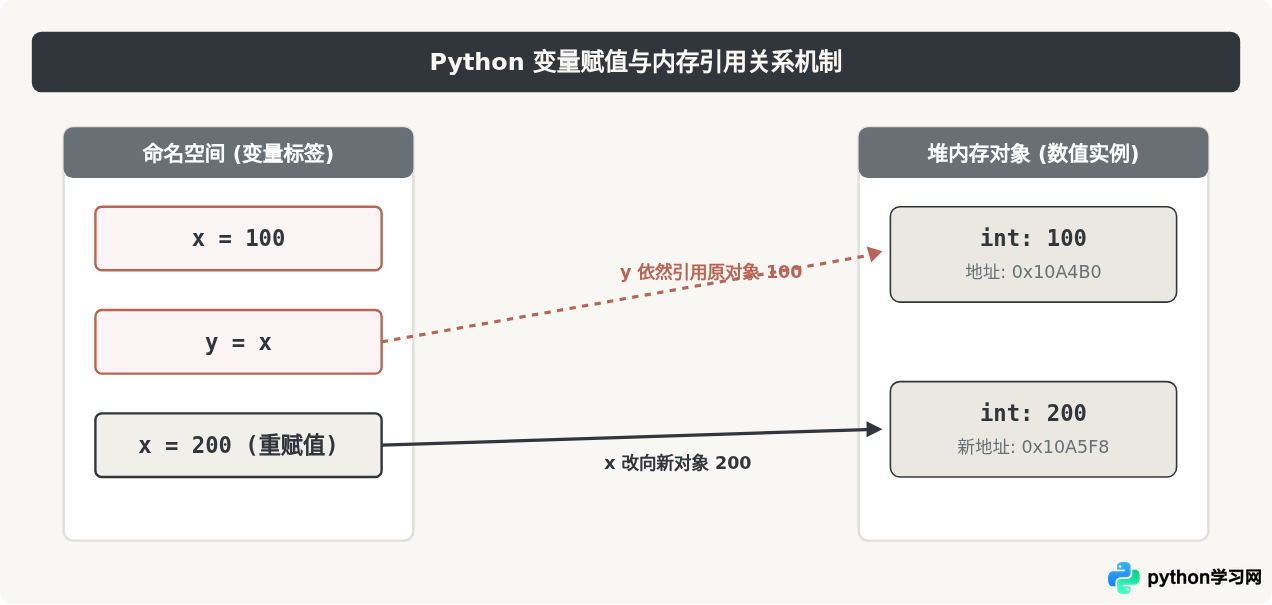
机制关键点:在 Python 中,变量名更像是贴在对象上的“标签”,而不是装物体的盒子。当对基本不可变类型(如数值、字符串、元组)的变量重新赋值时,并不是在原有内存位置修改数据,而是创建了新对象并更新了变量标签的指向。
二、条件判断:基于规则的分支逻辑
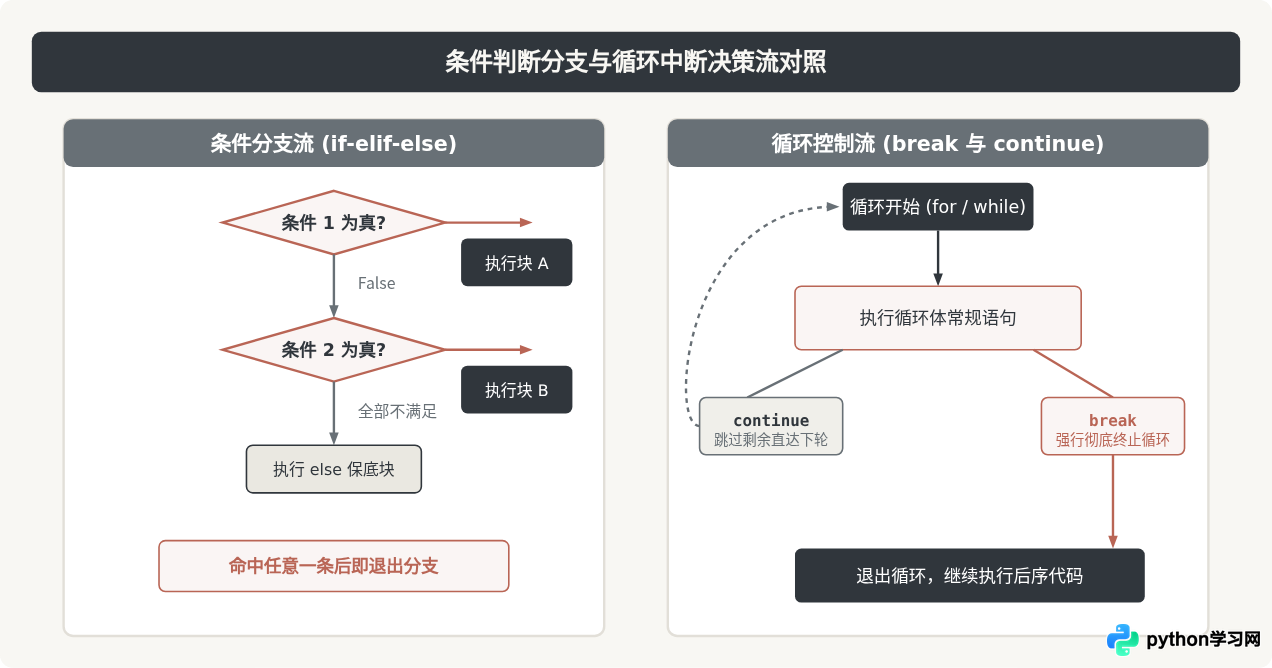
程序能够处理变化,核心在于根据条件是否满足走不同的执行分支。Python 使用 if、elif 和 else 关键字构建多路分支,使用半角冒号 : 引导代码块,并通过严格统一的 4 个空格缩进来界定作用域。
1. 比较运算与逻辑运算符
条件表达式通常由比较运算符与逻辑运算符组合而成:
- 比较运算符:
==(等于)、!=(不等于)、>、<、>=、<=。务必注意:等于比较是双等号,单等号是赋值。 - 逻辑运算符:
and(两者皆真为真)、or(任一为真即为真)、not(取反)。
2. 多分支与短路逻辑代码示例
以下代码模拟对用户信用评分进行等级评定及放款资格审核:
credit_score = 735
has_overdue_record = False
annual_income = 180000

# 多重阶梯判断
if credit_score >= 800:
    tier = "AAA"
    loan_limit = 500000
elif credit_score >= 700 and not has_overdue_record:
    tier = "AA"
    # 根据收入计算额度
    if annual_income >= 150000:
        loan_limit = 300000
    else:
        loan_limit = 150000
elif credit_score >= 600:
    tier = "A"
    loan_limit = 50000
else:
    tier = "D (不予准入)"
    loan_limit = 0

print("评定等级:", tier)
print("授信额度:", loan_limit)授信额度: 300000
3. Python 的真值判定(Truth Value Testing)
在 Python 中,除了显式的布尔表达式,任何对象都可以直接作为判断条件。以下对象在条件判断中会被隐式求值为 False:
- 数值
0、0.0 - 空字符串
"" - 空容器:空列表
[]、空元组()、空字典{}、空集合set() - 特殊空值
None
因此在检查列表是否为空时,推荐直接使用 if items:,而不需要写 if len(items) > 0:。
三、循环结构:自动化迭代与流程控制
当需要对成组的数据执行相同操作,或者在满足某个条件之前保持持续计算时,必须使用循环。Python 提供了两种主要形式:用于迭代已知集合序列的 for 循环,以及基于状态布尔条件持续运转的 while 循环。
1. for 循环与序列迭代
Python 的 for 循环本质上是一个“迭代器驱动”的语法,每次循环直接从可迭代对象(列表、字符串、字典、元组、生成器)中取出一个元素赋给迭代变量。如果需要按数字范围循环,则搭配内置的 range() 函数:
# 1. 结合 range(start, stop, step) 计数循环
total_sum = 0
for i in range(1, 6):  # 产生 1, 2, 3, 4, 5 (包含1,不包含6)
    total_sum += i
print("1到5的累加和:", total_sum)

# 2. 直接遍历列表元素
fruits = ["苹果", "香蕉", "车厘子"]
for fruit in fruits:
    print("当前水果:", fruit)

# 3. 遍历字典的键值对
scores = {"语文": 88, "数学": 95, "英语": 91}
for subject, score in scores.items():
print(f"{subject}成绩: {score}分")当前水果: 苹果
当前水果: 香蕉
当前水果: 车厘子
语文成绩: 88分
数学成绩: 95分
英语成绩: 91分
2. while 循环与退出状态维护
while 循环在指定的布尔条件为 True 时持续执行。使用 while 循环时,必须在循环体内部提供改变条件的步进语句,否则会导致死循环,耗尽 CPU 资源。
# 倒计时示例
countdown = 3

while countdown > 0:
    print("倒计时:", countdown)
    countdown -= 1  # 步进语句:每次减少 1,直至不满足条件

print("发射启动!")倒计时: 2
倒计时: 1
发射启动!
3. break 与 continue 的差异
循环的控制灵活性来自于两个关键字:
continue:立即结束当前这一轮循环的后续语句,直接进入下一轮迭代。break:直接永久跳出整个循环,循环体后续以及未遍历的剩余项均不再执行。
numbers = [12, -5, 8, 0, 15, -3, 20]
positive_evens = []

for num in numbers:
    # 遇到负数,直接跳过当前轮
    if num < 0:
        continue

    # 遇到 0,作为终止信号彻底退出
    if num == 0:
        print("遇到终止标记 0,提前停止遍历")
        break

    # 仅收集正偶数
    if num % 2 == 0:
        positive_evens.append(num)

print("已收集的正偶数:", positive_evens)已收集的正偶数: [12, 8]
四、综合应用:数据清洗与分类统计
为了让读者直观理解变量存储、条件判断与循环结构如何在实际项目中协同运作,以下提供一段完整的数据清洗与统计代码。场景为:解析一批用户注册信息原始列表,过滤异常脏数据,并按年龄阶段分类统计合法用户的平均消费。
# 模拟用户原始数据:包含缺失值、负数异常与合法记录
raw_records = [
    {"user_id": "U101", "age": 22, "spent": 150.0},
    {"user_id": "U102", "age": -3, "spent": 20.0},   # 异常数据:年龄为负
    {"user_id": "U103", "age": 35, "spent": 420.5},
    {"user_id": "U104", "age": None, "spent": 80.0},  # 异常数据:缺失年龄
    {"user_id": "U105", "age": 19, "spent": 90.0},
    {"user_id": "U106", "age": 42, "spent": 310.0},
]

# 1. 变量初始化:用于分类存储与累加的容器和计数器
young_group_spent = 0.0
young_group_count = 0
mature_group_spent = 0.0
mature_group_count = 0
invalid_records_count = 0

# 2. 循环遍历每一条输入记录
for item in raw_records:
    age = item.get("age")
    spent = item.get("spent", 0.0)

    # 3. 条件判断:先检查数据有效性
    if age is None or age <= 0:
        invalid_records_count += 1
        continue  # 跳过脏数据,不计入统计

    # 4. 条件判断:业务分类归档
    if age < 30:
        young_group_spent += spent
        young_group_count += 1
    else:
        mature_group_spent += spent
        mature_group_count += 1

# 5. 计算并输出统计结果
avg_young = (young_group_spent / young_group_count) if young_group_count > 0 else 0.0
avg_mature = (mature_group_spent / mature_group_count) if mature_group_count > 0 else 0.0

print(f"清洗完成,剔除无效记录数: {invalid_records_count}")
print(f"青年组 (<30岁): 人数={young_group_count}, 平均消费={avg_young:.2f}元")
print(f"成熟组 (>=30岁): 人数={mature_group_count}, 平均消费={avg_mature:.2f}元")青年组 (<30岁): 人数=2, 平均消费=120.00元
成熟组 (>=30岁): 人数=2, 平均消费=365.25元
在这段代码中:
- 变量(如
young_group_spent和计数器)负责维持统计过程中的累加状态。 - 循环(
for item in raw_records:)负责按序提取每一项,驱动程序批量处理。 - 条件判断(
if age is None or age <= 0:)作为守卫逻辑拦截不合规记录,后续的if-else则根据年龄划分业务统计区间。
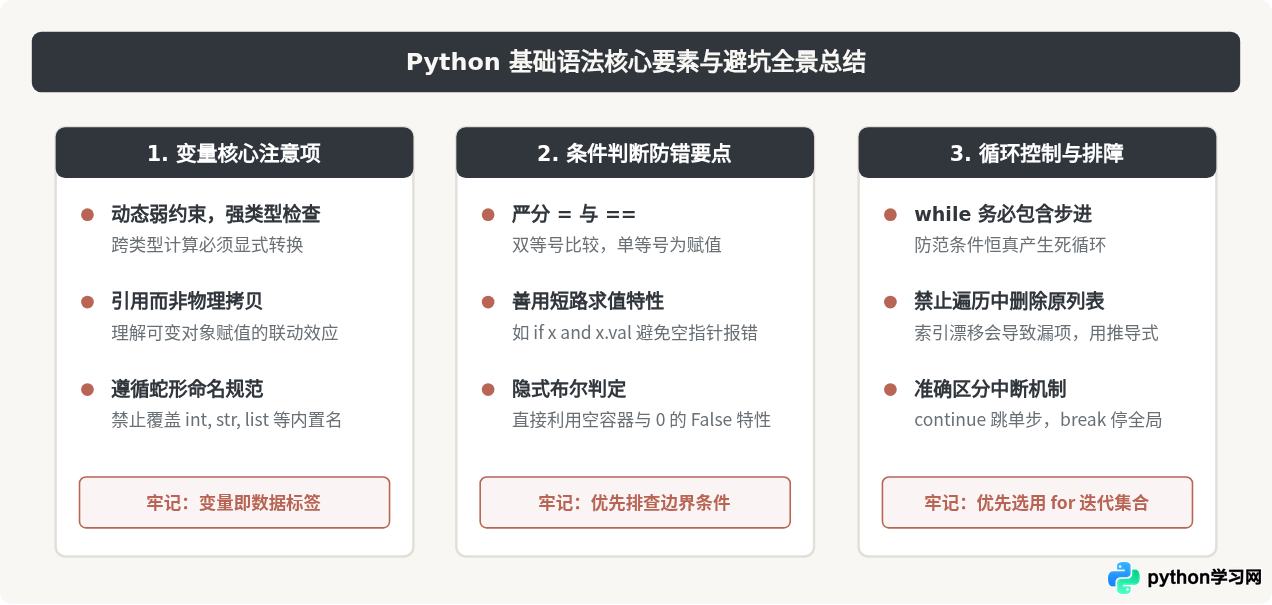
五、常见问题与调试建议
1. 混淆空格与制表符(IndentationError)
Python 对代码缩进极度敏感。虽然语法上允许使用制表符(Tab)或空格缩进,但切忌在同一个文件中混用两者。现代 Python 社区统一规范为:每一级缩进采用 4 个纯空格。若出现 IndentationError: unexpected indent 或 unindent does not match any outer indentation level,应首先检查编辑器是否将 Tab 键统一映射为了 4 个空格。
2. 遍历列表时同步删除元素的“漏项陷阱”
新手常犯的错误是在 for item in my_list: 循环体中调用 my_list.remove(item)。由于删除操作会动态改变原列表的长度及后续元素的物理索引,导致循环迭代器跳过紧邻的下一个元素。正确的做法是使用列表切片副本进行遍历(for item in my_list[:]:),或者直接使用列表推导式生成新列表:
# 错误示范:会导致漏删偶数
# for n in numbers:
#     if n % 2 == 0:
#         numbers.remove(n)

# 正确做法:使用列表推导式构建过滤后的列表
numbers = [1, 2, 2, 3, 4, 5]
odd_numbers = [n for n in numbers if n % 2 != 0]
print("过滤后的纯奇数列表:", odd_numbers)3. while 循环未更新退出条件的死循环排查
当执行 Python 脚本后终端卡死且 CPU 占用率飙升时,通常是因为 while 循环未能到达终止边界。排查时应重点检查:循环体内部是否存在明确改变条件判定变量的语句(例如递增、递减或从队列弹出元素),并确保所有条件分支最终都有机会触碰退出临界值。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















