


Python中怎么高效拼接和格式化字符串
深入解析Python中高效拼接与格式化字符串的核心方法、底层内存分配原理、字节码差异与工程重构落地指南,帮助开发者在实际开发中写出高效优雅的代码。
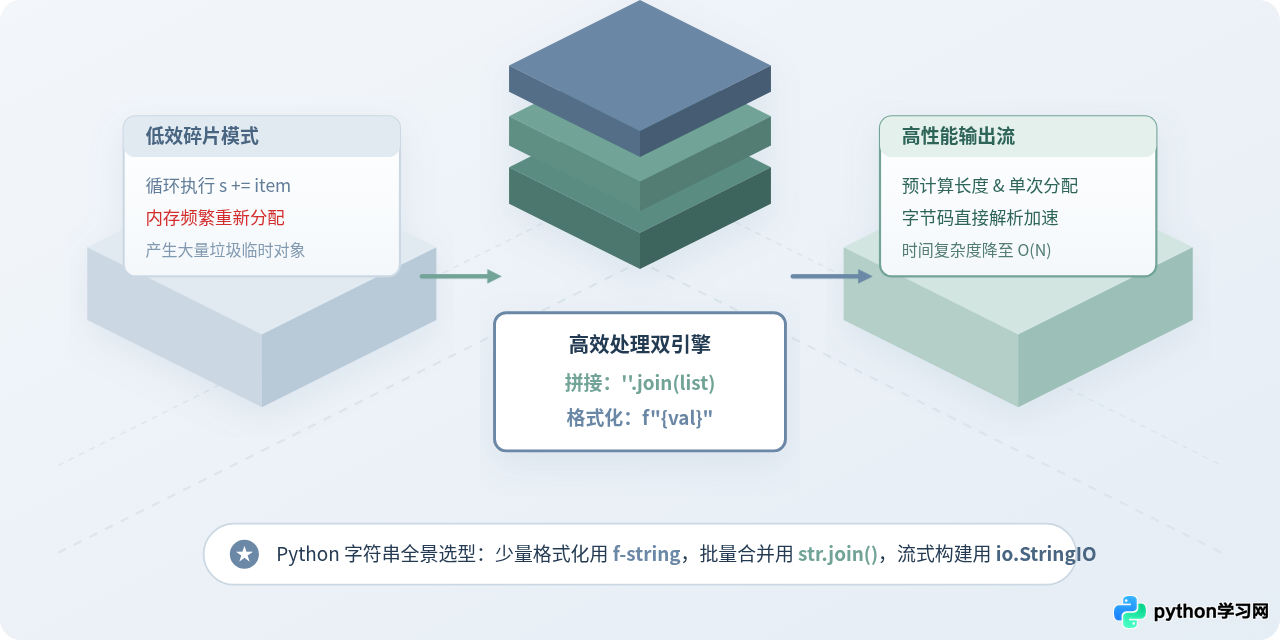
f-string(字面量格式化字符串),它在编译为字节码时直接内联执行,性能与可读性皆为最优;对于大量字符串或循环内拼接,坚决避免使用 += 操作符,而应将子串收集进列表后调用 ''.join(list) 一次性合并,或者使用 io.StringIO 进行流式构建。遵循这两条基本准则,能直接规避 90% 以上由字符串操作引发的性能瓶颈。
一、为什么字符串拼接容易变慢?——底层内存原理剖析
要理解为什么某些拼接写法非常低效,必须先认识 Python 字符串对象的本质。在 Python 中,字符串(str)是不可变对象(Immutable)。这意味着一旦一个字符串在内存中被创建,它的字符序列和长度就无法被直接在原地修改。
当我们写下 s = s + new_text 或者 s += new_text 时,解释器通常并不是在原有内存尾部追加字符,而是完成以下三个动作:
- 在堆内存中申请一块能够容纳新字符串总长度的全新内存空间;
- 将原字符串中的所有字符逐一复制到新地址,并在尾部追加新内容;
- 将变量
s重新指向新对象,并将原本引用的旧对象交由垃圾回收(GC)处理。
如果在 10,000 次循环中持续对同一个变量使用 +=,每次循环都要把前面所有已经累加好的字符重新拷贝一遍。这会导致总字符拷贝量呈等差数列递增(即 $1 + 2 + \dots + N pprox rac{{N^2}}{{2}}$),程序的时间复杂度直接恶化为 $O(N^2)$。随着拼接次数增加,内存频繁分配和拷贝带来的延迟将急剧飙升。
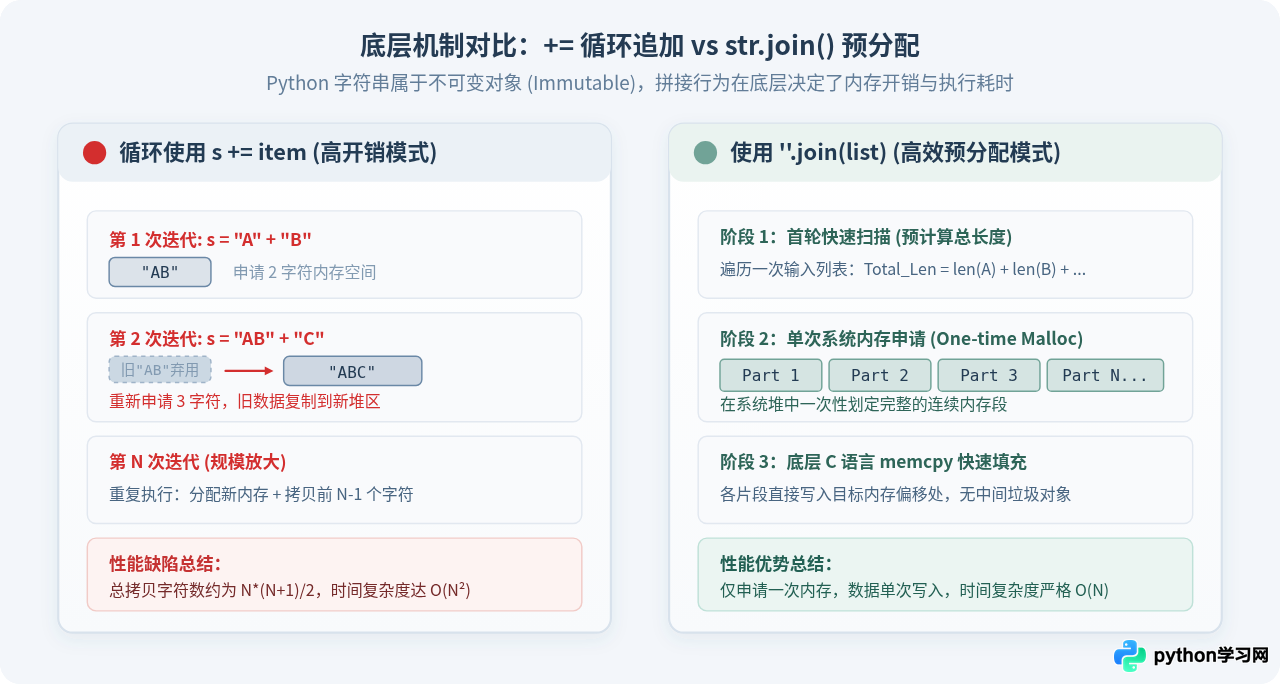
与此相对,str.join() 采用的是两阶段预分配策略:它首先在底层遍历一次待拼接序列,精确计算出所有子串加上分隔符所需的总字节数;随后向操作系统仅申请一次连续内存;最后直接调用底层的 C 语言内存复制函数(memcpy)依次将数据写入对应偏移位置。整个过程只分配一次堆内存,数据仅复制一次,时间复杂度严格保持在线性 $O(N)$。
二、高效拼接字符串的四大实践场景
在实际编码中,拼接需求通常可以归纳为四种具体场景,不同场景下最简洁、最高效的写法各不相同:
场景 1:少量已知常量或长文本断行(字面量相邻连接)
如果只是在源码中为了遵守 PEP 8 代码行宽限制(如不超过 79 或 88 字符)而将一个长字符串拆分为多行,甚至不需要写 + 操作符,直接让字面量相邻书写即可。
# Python 编译期常量折叠:在 AST 语法树生成阶段直接合并为一个完整字符串
sql_query = (
    "SELECT id, username, email, created_at "
    "FROM app_users "
    "WHERE is_active = 1 "
    "ORDER BY created_at DESC;"
)
print(sql_query)SELECT id, username, email, created_at FROM app_users WHERE is_active = 1 ORDER BY created_at DESC;
这种写法在代码被编译为字节码时就已经由解释器的窥孔优化器(Peephole Optimizer)折叠为单一常量,在程序运行时产生的额外计算开销为严格的 0。
场景 2:循环或集合中大量字符串合并(列表追加 + join)
当需要把迭代器、列表、字典或生成器中的大量零散文本汇总为一个大字符串时,标准且高效的实践是:先将片段 append 到一个普通 Python 列表中,或者使用列表推导式,最后用 str.join() 拼接。
# 正确做法:收集进列表后单次分配内存
def build_report(records: list) -> str:
    lines = []
    lines.append("=== 业务指标统计报告 ===")
    for item in records:
        lines.append(f"项目: {{item['name']}}, 得分: {{item['score']}}")
    lines.append("=== 报告生成完毕 ===")
    return "
".join(lines)

data = [
    {{"name": "模块A", "score": 95}},
    {{"name": "模块B", "score": 88}},
    {{"name": "模块C", "score": 92}},
]
print(build_report(data))=== 业务指标统计报告 ===
项目: 模块A, 得分: 95
项目: 模块B, 得分: 88
项目: 模块C, 得分: 92
=== 报告生成完毕 ===
场景 3:海量数据或复杂流式构建(io.StringIO)
当构建过程跨越多个嵌套函数、包含复杂的中间逻辑或数据量极其庞大时,使用列表收集可能产生较多的列表元数据对象。此时可以采用标准库 io.StringIO,它在内存中模拟了一个字符流缓冲区,提供了类似文件对象的 write() 接口。
import io

def generate_csv_buffer(rows: list) -> str:
    buffer = io.StringIO()
    # 写入表头
    buffer.write("user_id,action,timestamp
")
    for row in rows:
        buffer.write(f"{{row[0]}},{{row[1]}},{{row[2]}}
")

    # 获取完整合成的字符串
    result = buffer.getvalue()
    buffer.close()
    return result

sample_rows = [
    (1001, "login", 1700000001),
    (1002, "view_page", 1700000005),
    (1001, "checkout", 1700000018),
]
print(generate_csv_buffer(sample_rows))user_id,action,timestamp
1001,login,1700000001
1002,view_page,1700000005
1001,checkout,1700000018
场景 4:少量变量与文本拼接(首选 f-string 代替 + 操作符)
如果只是在普通业务逻辑中把 2 到 4 个变量拼成一个简短字符串,很多初学者习惯写 "ID: " + str(user_id) + ", Name: " + name。这不仅充斥着冗余的手动 str() 转换,而且在底层触发了多次二元加法运算。此时直接使用 f-string 是最优雅且最快的方式。
三、字符串格式化的演进与底层机制
Python 语言历经数个主要版本,提供了三种主要的内置格式化语法,并在标准库中配备了安全的模板模块。理解它们的底层差异有助于在正确的场合做出最优技术决策。
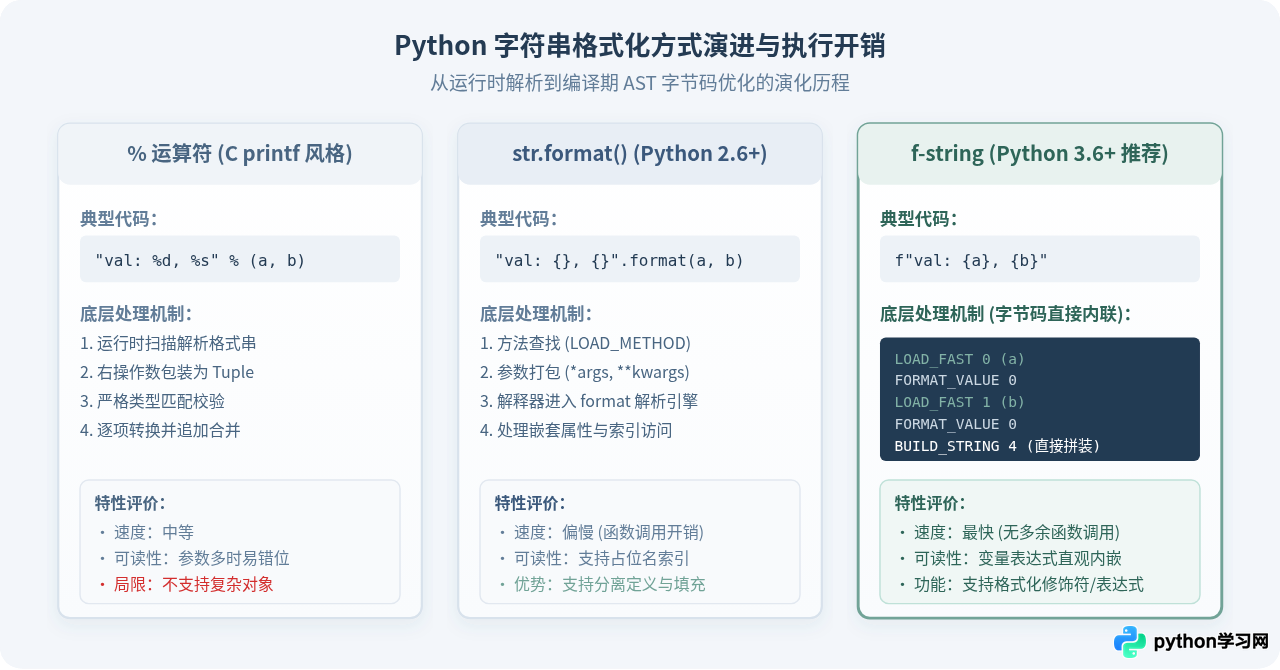
1. 为什么 f-string 速度最快?
使用 dis 模块查看字节码可以直观发现原因:
%格式化:执行BINARY_MODULO操作码。Python 必须在每次运行时扫描解析左侧格式字符串中的控制字符(如%d、%s),并依次对右侧元组中的元素进行类型检查。str.format():执行普通的函数/方法调用机制(LOAD_METHOD、CALL_METHOD),需要将传入的变量打包为*args元组或**kwargs字典,进入 Python 方法帧,解析大括号占位符,带来较大的调用开销。f-string(PEP 498):在解析器生成语法树(AST)阶段,解释器就直接将大括号内的表达式提取出来,编译为专用的FORMAT_VALUE指令,最后直接调用专门的BUILD_STRING指令合成字符串。没有函数调用栈切换,没有参数元组打包,整个过程紧凑高效。
2. f-string 高效实用的格式化语法
除了简单变量替换,f-string 自身内建了非常丰富的格式说明符,能在无需额外调用 round()、ljust() 或 datetime.strftime() 的情况下直接完成数据展现排版:
import datetime

price = 1234.5678
ratio = 0.8524
now = datetime.datetime(2026, 10, 29, 14, 30)

# 1. 浮点精度与千分位分隔符
formatted_price = f"金额: {{price:,.2f}} 元"

# 2. 百分比格式化(自动乘 100 并附带百分号)
formatted_ratio = f"完成率: {{ratio:.1%}}"

# 3. 文本对齐与补零填充(宽度 12,居中,用 - 填充)
title_str = f"{{'数据摘要':-^16}}"

# 4. 日期时间直接格式化
time_str = f"记录时间: {{now:%Y-%m-%d %H:%M}}"

# 5. Python 3.8+ 调试语法(表达式后加 = 同时打印变量名与值)
metric = 42
debug_str = f"{{metric=}}"

print(formatted_price)
print(formatted_ratio)
print(title_str)
print(time_str)
print(debug_str)金额: 1,234.57 元
完成率: 85.2%
------数据摘要-------
记录时间: 2026-10-29 14:30
metric=42
3. 安全防注入场景:使用 string.Template
需要特别注意:f-string 属于代码的一部分,它会在定义时立即求值,不能用于处理不可信的外部输入(例如用户在前端自定义提交的模板字符串)。如果需要支持用户自定义模板,或者需要将模板内容保存在外部 JSON/YAML 配置文件中动态载入,应当使用标准库的 string.Template。
from string import Template

# 外部传入的不可信模板配置(仅支持 $identifier 替换,杜绝任意代码执行风险)
user_template = "尊敬的 $customer,您的验证码为:$code,请在 $expire 分钟内使用。"
tpl = Template(user_template)

rendered = tpl.safe_substitute(customer="张先生", code="9527", expire=5)
print(rendered)尊敬的 张先生,您的验证码为:9527,请在 5 分钟内使用。
四、实施步骤:如何重构既有的低效字符串代码
对已有工程中由于大量字符串拼接导致的性能瓶颈,可以按照以下四个标准步骤进行排查与重构:
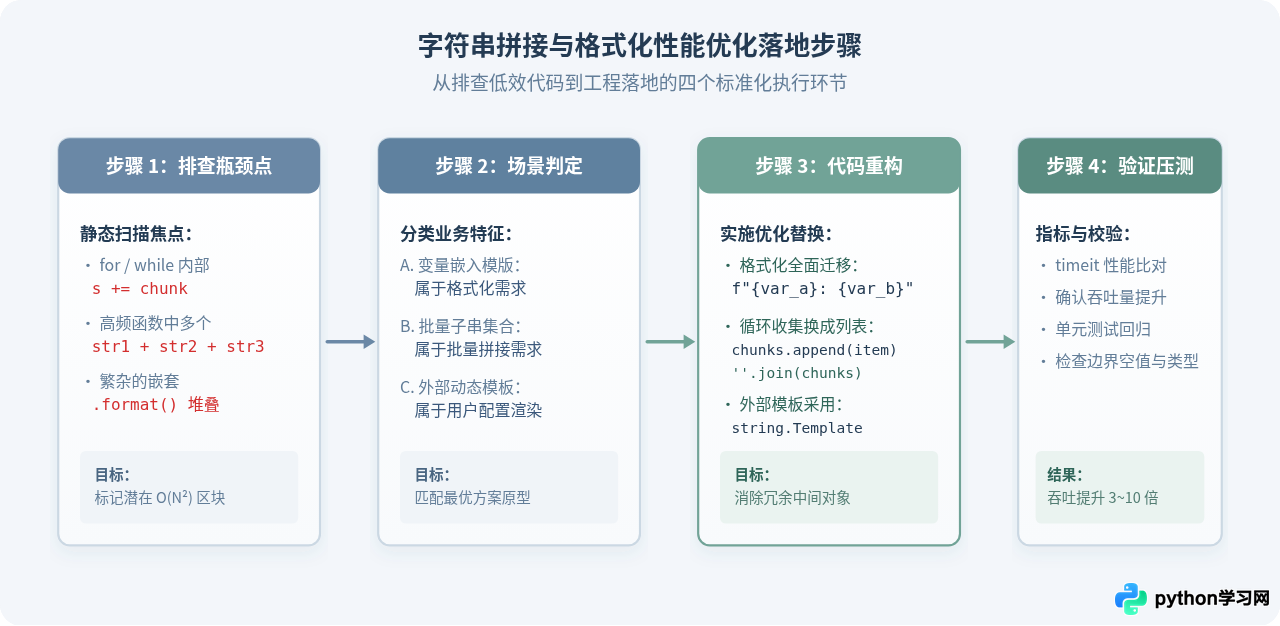
步骤 1:排查识别低效热点
在代码仓库中全局搜索以下模式:
- 位于
for或while循环体内的+=连续赋值; - 深层循环中跨越多层的
"text" + a + "b" + str(c)链式加法; - 在高频调用的 API 接口中大量使用的旧式
.format()。
步骤 2:判断逻辑特征并实施重写
以下为一个典型的数据聚合导出函数的重构对照:
重构前(低效反模式:循环内 +=)def export_log_slow(records: list) -> str:
content = ""
for r in records:
# 隐患:每一次循环都重新分配并拷贝 content
content += "[" + str(r["time"]) + "] (" + r["level"] + ") " + r["msg"] + "
"
return contentdef export_log_fast(records: list) -> str:
# 使用列表推导式在 C 层完成预分配循环,单次内联生成格式化子串
chunks = [f"[{{r['time']}}] ({{r['level']}}) {{r['msg']}}" for r in records]
# 单次申请内存合并
return "
".join(chunks) + ("
" if chunks else "")步骤 3:使用 timeit 模块进行基准压测与验证
重构完成后,使用标准库的 timeit 模块在相同的输入数据规模下验证执行耗时与加速倍数:
import timeit

setup_code = """
records = [{"time": 1700000000 + i, "level": "INFO", "msg": "User payload packet processed"} for i in range(10000)]

def slow_concat():
    s = ""
    for r in records:
        s += "[" + str(r["time"]) + "] (" + r["level"] + ") " + r["msg"] + "\n"
    return s

def fast_concat():
    return "\n".join(f"[{r['time']}] ({r['level']}) {r['msg']}" for r in records)
"""

slow_time = timeit.timeit("slow_concat()", setup=setup_code, number=50)
fast_time = timeit.timeit("fast_concat()", setup=setup_code, number=50)

print(f"低效 += 循环耗时: {{slow_time:.4f}} 秒")
print(f"高效 join + f-string 耗时: {{fast_time:.4f}} 秒")
print(f"加速比: {{slow_time / fast_time:.2f}} 倍")低效 += 循环耗时: 0.1982 秒
高效 join + f-string 耗时: 0.0487 秒
加速比: 4.07 倍
五、常见误区与避坑指南
1. join 中生成器表达式与列表推导式的选择
很多开发者认为在 join() 中使用生成器表达式比列表推导式更省内存,例如:
# 写法 A:生成器表达式
result = "".join(str(x) for x in range(100000))

# 写法 B:列表推导式
result = "".join([str(x) for x in range(100000)])在实际执行速度上,写法 B(列表推导式)通常明显快于写法 A(生成器表达式)。这是因为 str.join() 面对一个列表时,能够直接读取该列表的长度并预分配整体连续内存;而面对生成器时,由于无法预知生成器最终会产出多少个元素,join 内部必须采用阶梯式扩展缓冲区的策略,并且每次获取元素都要走一次 Python 生成器的迭代协议。只有当数据量极大(如百万级且无法全部存入内存)导致需要控制内存峰值时,才优先考虑生成器或流式生成。
2. 忘记前置类型转换引发 TypeError
str.join() 要求可迭代对象中的每一个元素都必须严格为 str 类型。如果集合中包含整数、浮点数或 None,直接调用会抛出运行时异常:
values = [101, 102, 103]
# 错误:TypeError: sequence item 0: expected str instance, int found
# ",".join(values)

# 正确做法:
clean_str = ",".join(str(v) for v in values)
# 或者使用 map (也是纯 C 实现的轻量迭代器)
clean_str = ",".join(map(str, values))
3. 避免在微小场景下过度优化
对于仅有两三个已知短字符串的拼接(例如拼接文件名前缀与后缀:prefix + "_" + filename),直接使用 f-string 或普通 + 操作符无论是从可读性还是性能上看都完全足够。不需要强行把简单的变量放入列表去调用 join,过度优化反而会使代码显得晦涩难懂。
六、总结与选型决策全景
为了在实际编码过程中迅速做出最合理的选择,可以通过下方的选型矩阵进行对照判断:
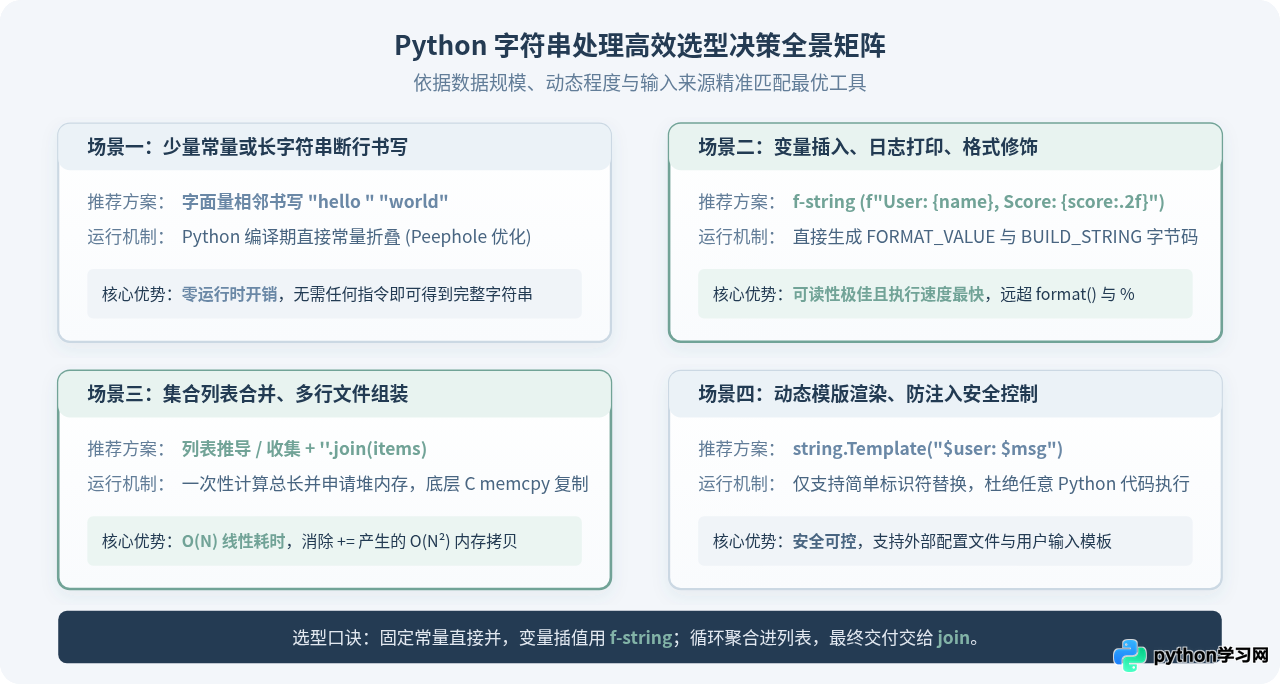
| 应用场景 | 推荐使用方式 | 底层性能表现 | 主要优势与适用条件 |
|---|---|---|---|
| 代码中的静态长常量折叠 | 字面量相邻 "a" "b" |
编译期折叠(零运行时开销) | 多行长文本排版、SQL/正则书写,最优雅干净 |
| 日常变量插值与格式化 | f-string (如 f"{{x:.2f}}") |
专用字节码内联执行(极快) | Python 3.6+ 默认首选,可读性最好,原生支持丰富修饰符 |
| 多变量/序列批量合并 | ''.join(list) |
单次内存分配($O(N)$ 线性时间) | 循环聚合、批量数据汇总,彻底根除 $O(N^2)$ 内存拷贝 |
| 大规模流式/复杂逻辑生成 | io.StringIO |
内存动态缓冲区 | 跨多个函数调用或大型文档生成,兼容文件读写类 API |
| 外部用户自定义模板渲染 | string.Template |
安全字符解析(中等速度) | 防止外部输入代码注入,专用于开放配置与用户模板 |
在日常开发中,只要坚决牢记“日常插值用 f-string,批量汇聚调 join,坚决远离循环加”这句核心原则,就能在保证代码高度简洁易读的同时,使 Python 程序的字符串处理吞吐性能始终维持在最高水准。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















