


Python f-string怎么实现高效字符串拼接

在 Python 3.6 引入的格式化字符串字面量(Formatted String Literals,简称 f-string)中,实现高效字符串拼接的核心机制在于:Python 解释器在编译期直接将其解析为专门的高效字节码指令 BUILD_STRING,并在运行时利用 C 语言层面的内存管理机制完成拼接。相比传统的加号级联、百分号占位符与 str.format() 方法,f-string 省去了中间临时字符串对象的分配开销和 Python 层的函数调用损耗,在变量拼接与模板构造场景下兼具顶尖的执行效率与直观的代码可读性。
一、底层原理:为什么 f-string 能够实现高吞吐拼接
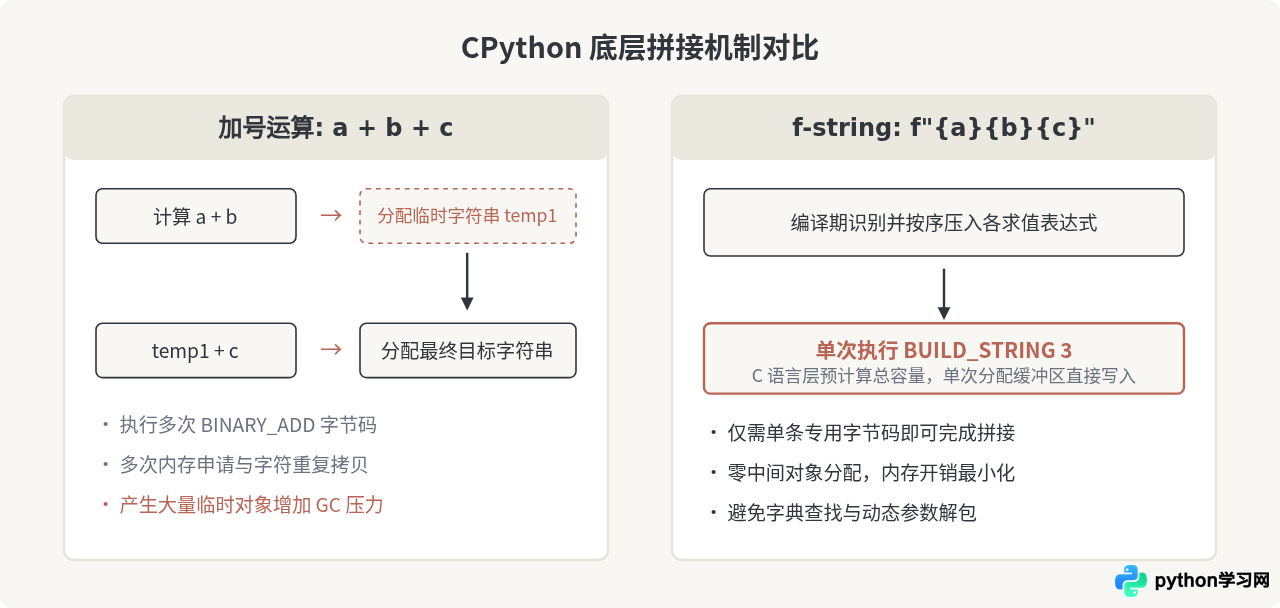
在 Python 中,字符串属于不可变对象(Immutable Object)。一旦创建,其内存大小与字符内容便不可修改。这意味着,如果采用加号(+)对多个变量进行连续拼接,CPython 每次遇到一个加号就需要开辟一块全新的内存空间,并将前一次的结果和新的字符串拷贝进去,随后丢弃前一个中间对象。
例如执行表达式 a + b + c 时,解释器会先在内存中生成一个存放 a + b 的临时对象,然后再创建存放 (a + b) + c 的最终对象。这种链式分配不仅放大了内存拷贝量,还增加了垃圾回收器追踪和清理短命对象的负担。
与此相对,f-string 并非普通的函数调用,而是直接嵌入到 Python 语法解析树中的语言特性。当解释器编译 f"{a}{b}{c}" 时,并不执行任何 str.format() 类的查找与参数打包,而是直接发出 BUILD_STRING 指令。该指令在 C 语言实现中会直接预先统计所有拼接片段的字节长度,一次性在堆上申请对应容量的字符串缓冲区,并直接调用底层的内存复制将各个部分灌入缓冲区,彻底杜绝了中间对象的产生。
二、字节码实证:观察 f-string 的生成指令
通过 Python 内置的 dis 模块,可以直接反编译不同拼接方式对应的底层字节码。比较常见的三种写法:
import dis

def concat_plus(a, b, c):
    return a + "_" + b + "_" + c

def concat_format(a, b, c):
    return "{}_{}_{}".format(a, b, c)

def concat_fstring(a, b, c):
    return f"{a}_{b}_{c}"
对 concat_plus 反编译时,字节码中会出现连续 4 次 BINARY_OP (加号),意味着连续进行了 4 次字符串创建;对 concat_format 反编译时,需要先执行 LOAD_METHOD 加载 format 方法,接着压入三个参数,最后调用 CALL_METHOD,其内部开销涉及字典查找、参数元组封装以及 Python 栈帧的上下文切换。
而反编译 concat_fstring 时,字节码表现为简洁的压栈序列后紧跟一条核心指令:
# concat_fstring 对应的关键字节码片段
LOAD_FAST            0 (a)
LOAD_CONST           1 ('_')
LOAD_FAST            1 (b)
LOAD_CONST           1 ('_')
LOAD_FAST            2 (c)
BUILD_STRING         5
RETURN_VALUE
常数字符串(下划线)与变量值被依次推入栈顶后,解释器直接调用 BUILD_STRING 5,将栈顶的 5 个元素在底层单次收敛为一个完整的字符串对象。这种机制保证了 f-string 在拼接已知数量的项时具备原生的 C 语言性能。
三、语法结构与核心执行步骤
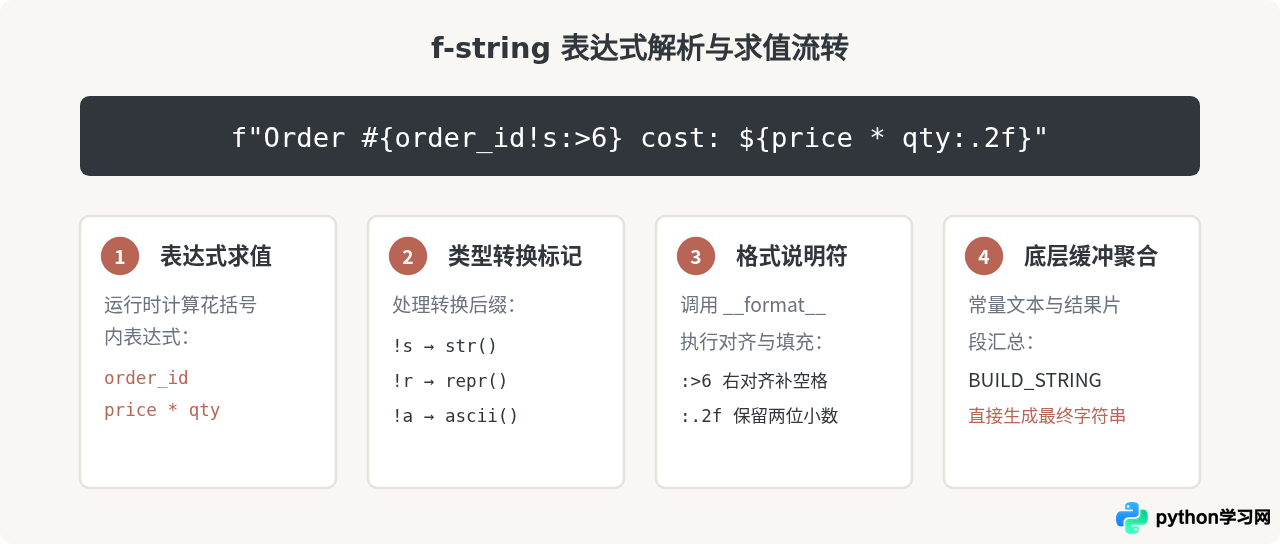
f-string 并非纯粹的简单变量代换,它允许在花括号内执行任意 Python 表达式,同时支持原生类型转换符与格式说明符。理解其完整的执行步骤,有助于写出兼具可读性与高吞吐的代码:
四、提升拼接效率的具体使用技巧
要让 f-string 发挥最大效能,除了替换加号外,还可以利用其内建能力减少冗余代码和中间辅助调用:
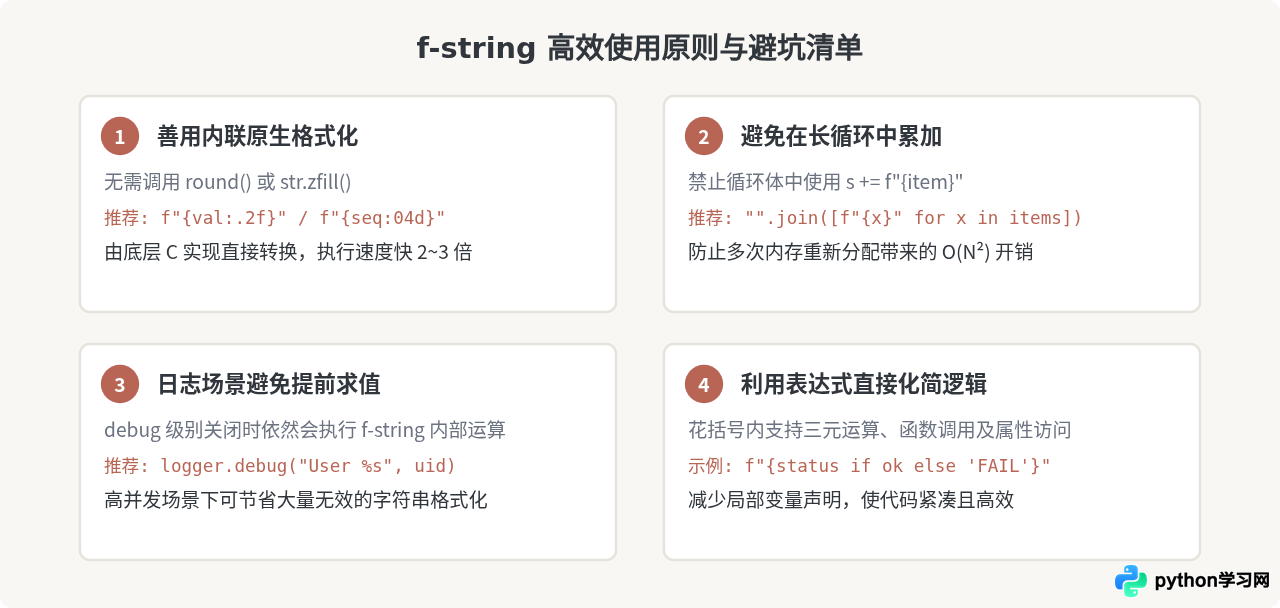
1. 善用原生格式化控制,避免调用外部辅助函数
在拼接数值、日期或定宽字段时,避免先调用 round()、str.zfill() 或 strftime() 生成中间字符串,而应直接交给 f-string 的格式规范符处理:
# 低效做法:生成了多余的中间字符串对象
balance_str = str(round(balance, 2))
id_str = str(user_id).zfill(6)
msg = f"User: {id_str}, Balance: {balance_str}"

# 高效做法:直接在 f-string 中利用底层的格式化实现
msg = f"User: {user_id:06d}, Balance: {balance:.2f}"
在底层,{user_id:06d} 由 CPython 的格式化例程直接填充缓冲区,跳过了 Python 层的方法调用与短命对象创建。
2. 内联求值避免无效局部变量
f-string 支持三元表达式、字典查找与方法调用,可以直接在花括号中完成简明逻辑,而不需要在外部定义多余的临时变量:
# 直接内联判断状态,减少局部变量分配与代码行数
status_desc = f"Status: {'Active' if is_valid else 'Suspended'}"
3. Python 3.8+ 的自说明调试语法
在调试和日志记录时,增加等号(如 f"{var=}")会自动将表达式文本与值拼接输出,省去重复键入变量名的时间:
x = 42
# 输出 "x=42"
debug_info = f"{x=}"
五、场景选型:何时使用 f-string 与何时选择 str.join()
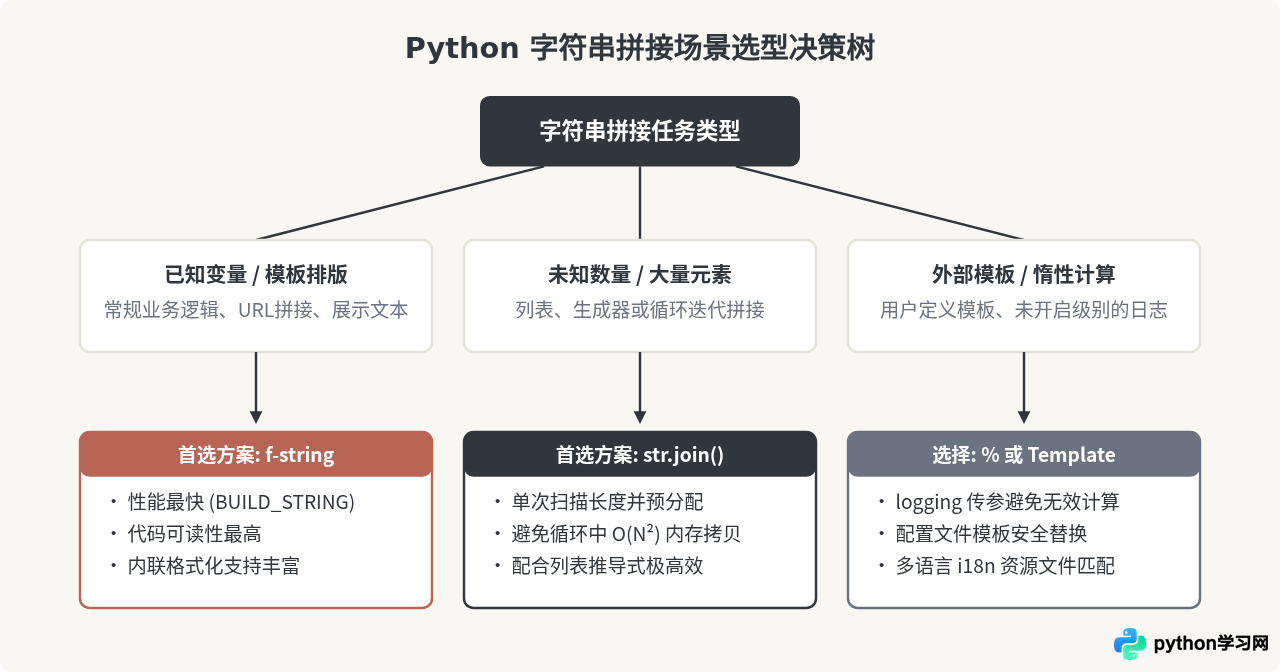
虽然 f-string 在大部分变量拼接场景中速度领先,但它并不是所有字符串拼接的万能解。最典型的性能陷阱发生在循环累加中。
如果需要在循环体中动态追加未知数量的字符串,即使使用 s += f"{item}\n",依然会触发不可变对象的重复分配,产生 $O(N^2)$ 的时间复杂度。对于集合、列表或生成器输出的批量字符串,应当使用 str.join()。
六、关键避坑指南与最佳实践
在实际工程代码中,开发者容易在以下三个场景中出现性能失控:
- 长列表处理:不要在
for循环中通过result += f"{item}"拼接字符串,应采用列表推导式配合"\n".join(f"{item}" for item in items)。 - 日志输出(Logging):不要在日志输出中使用
logging.debug(f"Process {heavy_calc()}")。因为 f-string 在进入 logging 函数前就已经完成了求值。如果当前日志级别为 INFO,该调试语句依然会执行字符串拼接乃至内部计算,白白浪费 CPU 周期。在日志场景中,建议保留标准占位符风格:logging.debug("Process %s", heavy_calc)。 - 动态模板安全性:f-string 具有代码执行能力,绝不能接受未经清洗的外部用户输入直接作为模板字符串进行求值,以防注入风险。对于配置项或外部模板,应采用
string.Template。
七、总结
Python f-string 之所以能够实现高效的字符串拼接,关键在于编译期对语法的静态结构识别以及运行期 BUILD_STRING 指令对堆内存的单次精确分配。在业务代码中,只要是固定数量变量或表达式的组合展示,都应优先使用 f-string;当处理动态规模的可迭代对象时,以列表推导式收集片段并结合 str.join() 汇聚,二者配合便能全面保障字符串处理的高性能与易读性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















