


Python中怎么判断对象是否为序列类型?Sequence抽象基类用法
详解在Python中如何使用collections.abc.Sequence准确判断对象是否为序列类型,剖析常见硬编码类型的误区与字符串陷阱,并提供完整的类型分流与自定义序列类实现方案。
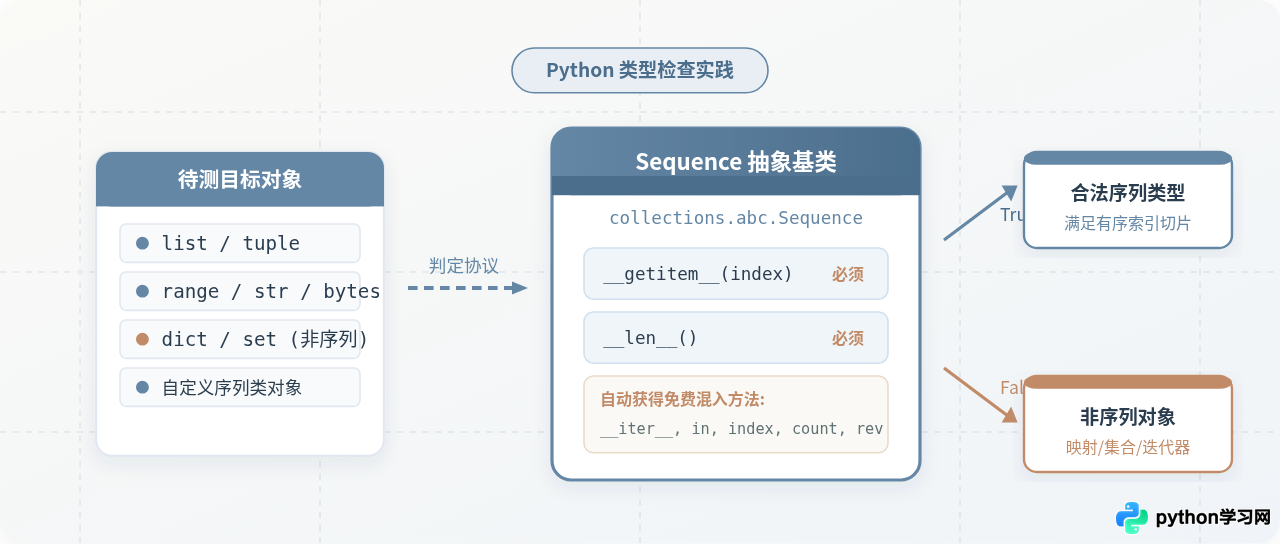
collections.abc.Sequence 抽象基类,即调用 isinstance(obj, collections.abc.Sequence)。它不仅涵盖内置的 list、tuple,还能精确识别 range、bytes 以及所有符合序列协议的第三方或自定义类。本文将系统阐述其底层运行机制、常见误区,以及在业务开发中规避“字符串陷阱”的工程化实践。
一、为什么不建议用 isinstance(obj, (list, tuple))?
在很多初学者的代码中,经常能看到形如 if isinstance(obj, (list, tuple)): 的类型判断。这种写法虽然直观,但在实际工程中存在明显的局限性,违背了 Python 的“鸭子类型”(Duck Typing)与抽象协议设计:
- 遗漏内置序列对象:Python 内置的标准类型中,
range对象也是不可变序列。使用元组白名单会导致range(10)判定失败,迫使调用方在传参前额外执行list(range(10)),造成无谓的内存分配和性能开销。 - 无法识别自定义类与第三方扩展:例如科学计算中的多维切片封装,或数据结构库中的
collections.deque。若自定义类通过下标管理有序元素,硬编码具体类名将彻底切断代码的可扩展性。
另一种常见的错误做法是检查魔法方法,如 hasattr(obj, '__getitem__') 或 hasattr(obj, '__iter__')。这种做法的问题在于:
- 字典
dict实现了__getitem__,但它通过哈希键寻址,而不是基于 0 开始的连续整数索引,属于映射(Mapping)而非序列。 - 集合
set和生成器实现了__iter__,但集合无序且不可通过下标访问,生成器是单向消费流且没有长度属性len(),它们都不是序列。
二、Sequence 抽象基类的判定决策树
为了准确区分什么是序列、什么是非序列,Python 在标准库 collections.abc 中定义了结构化的抽象基类(Abstract Base Classes, ABC)。通过 isinstance 配合基类进行判断,是现代 Python 代码的标准实践。
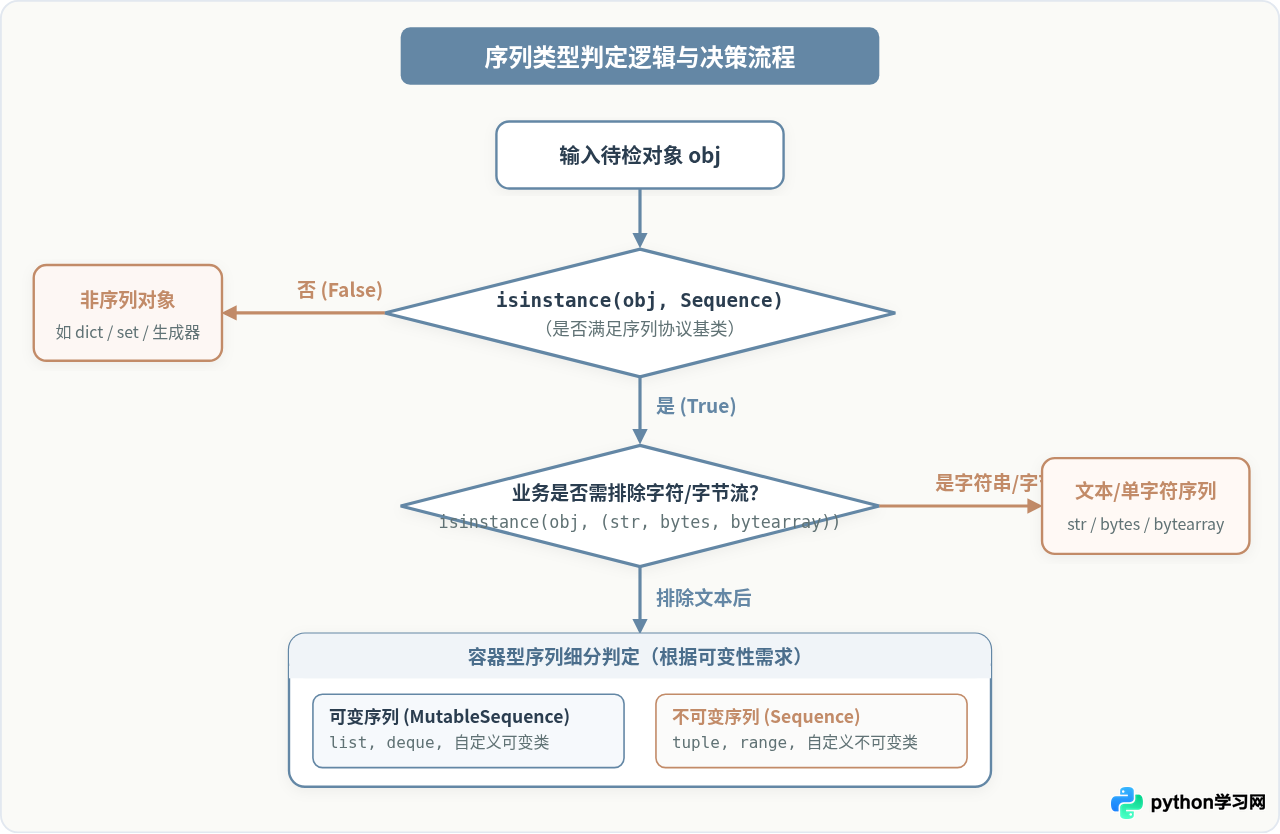
从流程图可以看出,判定逻辑分为三个核心层级:
- 基类校验:通过
isinstance(obj, Sequence)判断对象是否具备序列的核心契约(包含有序索引、长度与成员判定)。若返回False,可直接判定为字典、集合或单向迭代器等非序列类型。 - 文本与二进制流过滤:由于 Python 中的
str、bytes和bytearray同样实现了序列协议,如果业务函数要求的是“容器序列”(即元素应作为独立项处理),则需要防御性地排除文本类型,防止字符串被当做单字符列表迭代。 - 可变性分流:如果后续操作涉及
append、pop、就地修改元素等写操作,应进一步使用MutableSequence进行校验。
三、Sequence 在抽象基类层次中的位置与原理
理解 Sequence 的强大之处,需要看清楚它在 collections.abc 体系中的继承结构。Python 并不是孤立地定义某个基类,而是通过细粒度接口组合构建完整的类型体系。
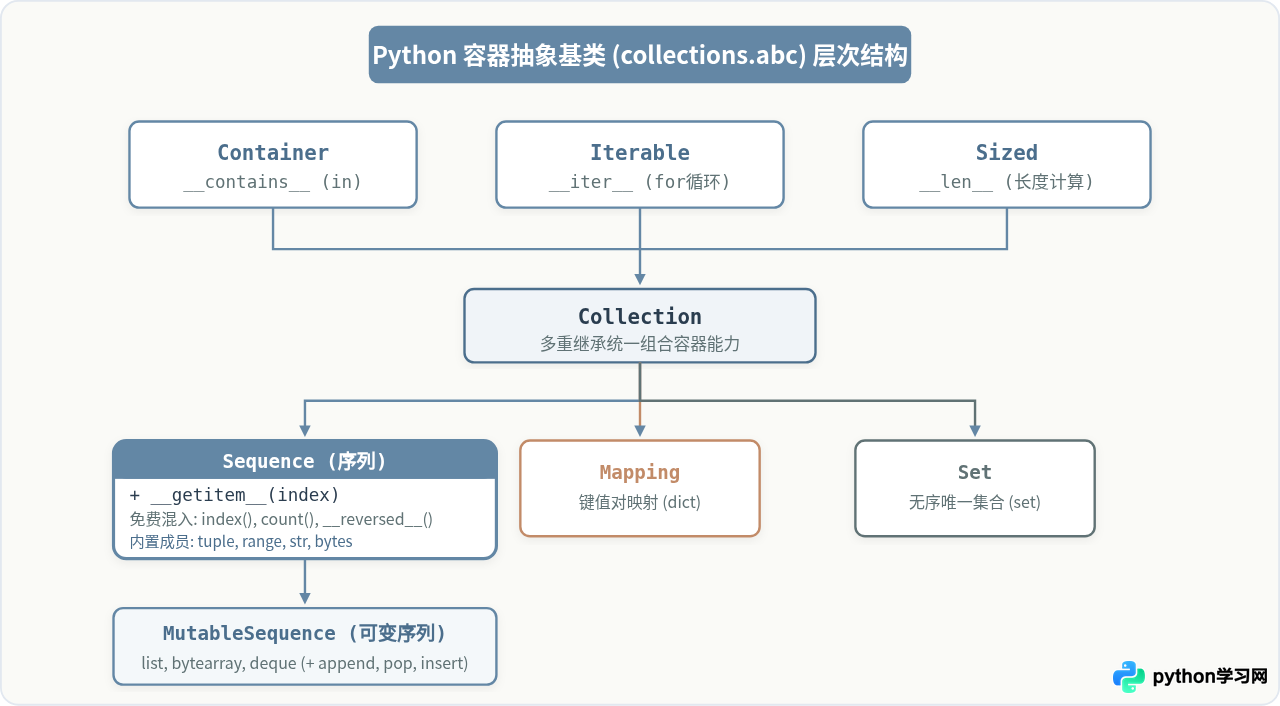
如上图所示,Sequence 位于 Collection 之下,它聚合了三个最基础的接口契约:
Sized:要求实现__len__(),支持len(obj)计算元素数量;Iterable:要求实现__iter__(),支持for循环迭代;Container:要求实现__contains__(),支持item in obj成员检查。
在此基础上,Sequence 强制要求子类实现抽象方法 __getitem__()。更重要的是,Sequence 提供了丰富的混入方法(Mixin Methods)。只要一个类实现了 __len__ 和 __getitem__ 并继承 Sequence,它便能自动免费获得 __iter__、__contains__、__reversed__、index() 和 count() 的标准实现,无需手动重复编写。
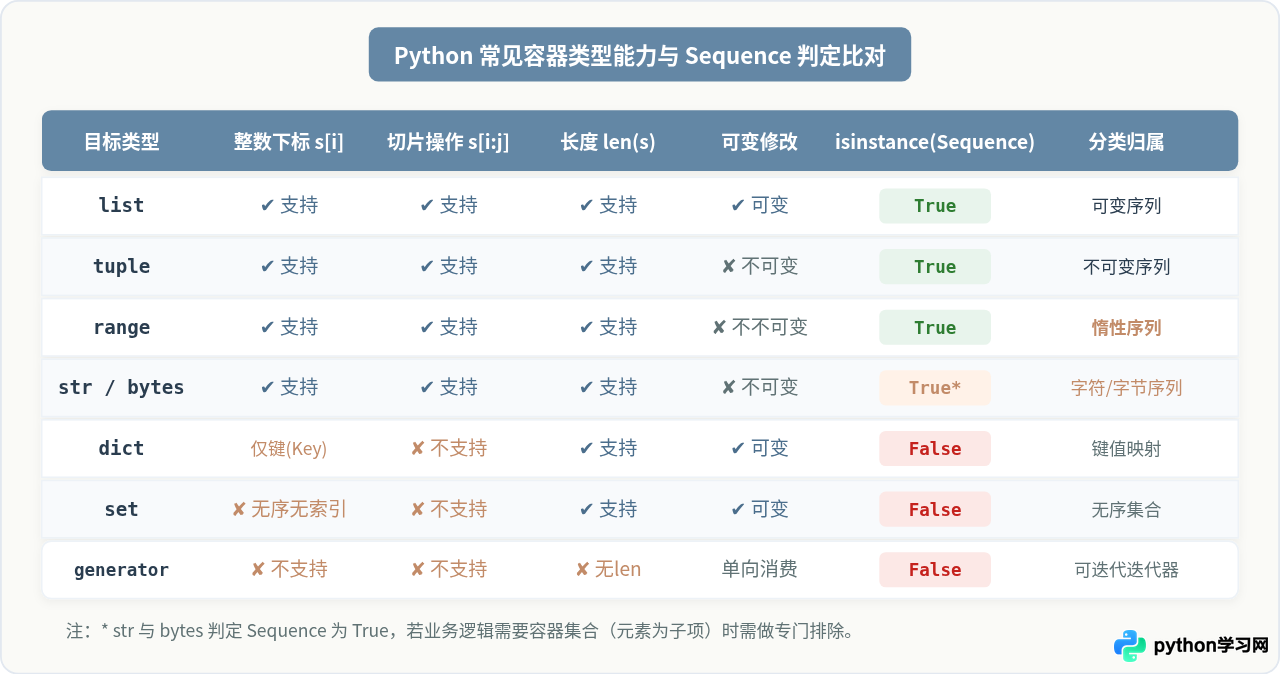
四、常见内置类型的能力矩阵比对
为了清晰展示为什么 isinstance(obj, Sequence) 能够准确工作,下表归纳了 Python 各常见容器类型所支持的操作特性与判定输出:
下面我们通过具体的交互式代码验证这些判定行为:
from collections.abc import Sequence, MutableSequence

# 1. 常见内置序列
print(isinstance([1, 2, 3], Sequence))       # 输出: True (列表)
print(isinstance((1, 2, 3), Sequence))       # 输出: True (元组)
print(isinstance(range(5), Sequence))        # 输出: True (惰性序列,非 list/tuple)
print(isinstance("hello", Sequence))         # 输出: True (字符串也是序列)
print(isinstance(b"data", Sequence))         # 输出: True (字节流也是序列)

# 2. 非序列容器
print(isinstance({"a": 1, "b": 2}, Sequence)) # 输出: False (字典是 Mapping,非序列)
print(isinstance({1, 2, 3}, Sequence))        # 输出: False (集合是 Set,无序且无下标)

# 3. 可变序列校验
print(isinstance([1, 2], MutableSequence))   # 输出: True
print(isinstance((1, 2), MutableSequence))   # 输出: False (元组不可变)
print(isinstance(range(5), MutableSequence)) # 输出: False (range 不可变)
五、工程实践中的“字符串陷阱”与防错封装
在实际项目中,纯粹使用 isinstance(obj, Sequence) 会遇到一个极其经典的隐患——字符串是序列。
["u101", "u102"])。如果调用方不小心传入了单个字符串 "u101",isinstance("u101", Sequence) 会返回 True!随后的迭代逻辑将把字符串拆解为 'u'、'1'、'0'、'1' 四个独立元素进行处理,导致难以排查的业务逻辑错误。
为了解决这一问题,推荐在项目公共工具库中封装一个排除字符和字节流的辅助判断函数:
from collections.abc import Sequence
from typing import Any

def is_container_sequence(obj: Any) -> bool:
    # 判断对象是否为容器型序列(排除文本与二进制字节流)。
    # 适用于需要把入参当作集合列表处理,同时防止单字符串被误拆解的场景。
    return isinstance(obj, Sequence) and not isinstance(obj, (str, bytes, bytearray))

# 验证测试
if __name__ == "__main__":
    print(is_container_sequence([1, 2, 3]))      # 输出: True
    print(is_container_sequence((10, 20)))       # 输出: True
    print(is_container_sequence(range(10)))      # 输出: True
    print(is_container_sequence("username"))     # 输出: False (安全拦截)
    print(is_container_sequence(b"raw_bytes"))   # 输出: False (安全拦截)
    print(is_container_sequence({"key": "val"})) # 输出: False (字典非序列)
六、自定义序列类:如何正确接入 Sequence 协议
当业务需要定义自定义数据结构(如时间窗口滑动列表、分页游标包装器等),希望外界将其当作标准序列使用时,有两种接入 Sequence 的方式:
方法 1:显式继承 collections.abc.Sequence(推荐)
直接继承 Sequence 并实现 __len__ 和 __getitem__ 两个核心方法。基类会自动注入其余的辅助方法:
from collections.abc import Sequence

class StepRange(Sequence):
    # 自定义等差整数序列,无需存储所有数值,支持切片与索引
    def __init__(self, start: int, stop: int, step: int = 1):
        if step == 0:
            raise ValueError("step 不能为 0")
        self.start = start
        self.stop = stop
        self.step = step
        # 计算长度
        self._len = max(0, (stop - start + (step - 1 if step > 0 else step + 1)) // step)

    def __len__(self) -> int:
        return self._len

    def __getitem__(self, index):
        if isinstance(index, int):
            if index < 0:
                index += self._len
            if not 0 <= index < self._len:
                raise IndexError("序列索引越界")
            return self.start + index * self.step
        elif isinstance(index, slice):
            return [self[i] for i in range(*index.indices(self._len))]
        raise TypeError(f"索引类型错误: {type(index).__name__}")

# 运行验证
nums = StepRange(0, 10, 2)  # 代表 0, 2, 4, 6, 8
print(f"是否为序列: {isinstance(nums, Sequence)}")  # 输出: True
print(f"长度: {len(nums)}")                       # 输出: 5
print(f"下标访问 nums[2]: {nums[2]}")              # 输出: 4
print(f"免费获得的 in 操作: {4 in nums}")           # 输出: True
print(f"免费获得的 count 方法: {nums.count(4)}")    # 输出: 1
print(f"免费获得的反转支持: {list(reversed(nums))}") # 输出: [8, 6, 4, 2, 0]
方法 2:使用虚拟子类注册(Sequence.register)
如果你使用的第三方类无法修改其基类定义,但其已经实现了符合序列规范的接口,可以通过 Sequence.register(ThirdPartyClass) 将其动态注册为 Sequence 的虚拟子类。注册后,isinstance(obj, Sequence) 和 issubclass(ThirdPartyClass, Sequence) 都会返回 True,且无需改变原类的继承链(MRO 不受影响)。
七、总结与最佳实践检查清单
在日常开发与框架设计中,合理使用 Sequence 能显著提升接口的通用性和健壮性。以下是总结出的核心实践准则:
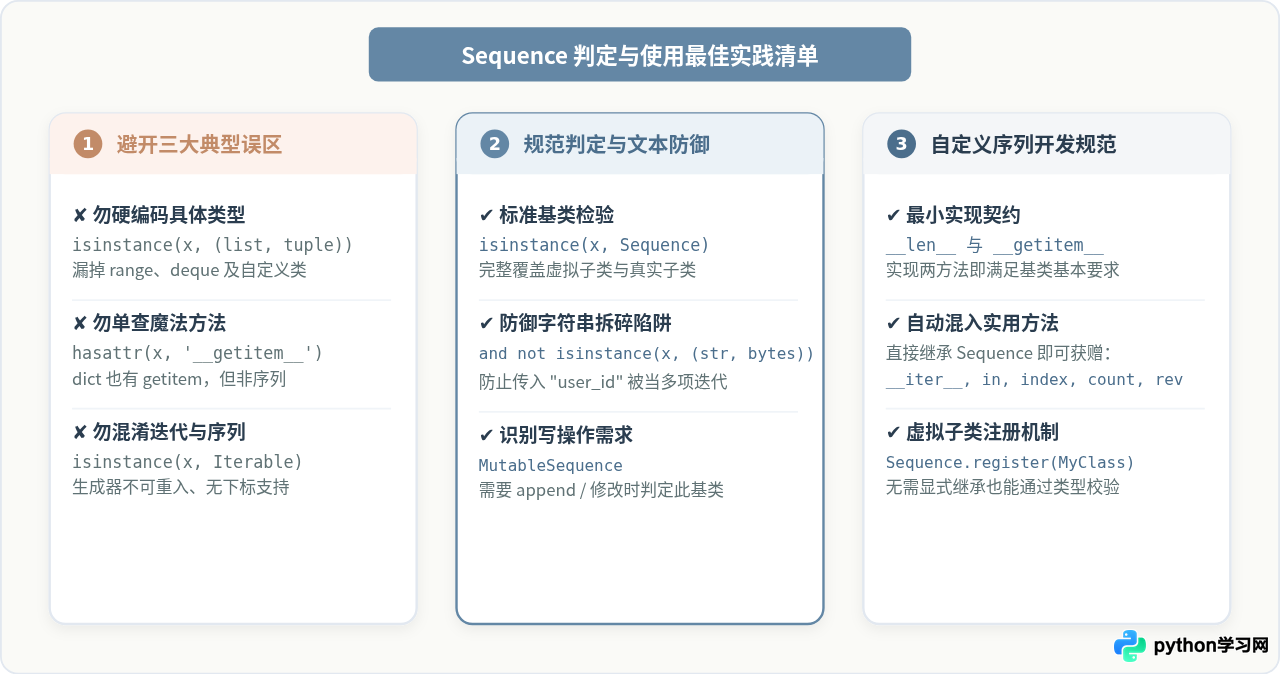
- 弃用具体元组白名单:停止在公开 API 入口使用
isinstance(x, (list, tuple)),改用isinstance(x, collections.abc.Sequence)。 - 防御单文本解析:对于入参需要当集合迭代的场景,务必追加
and not isinstance(x, (str, bytes))检查。 - 区分只读与修改:只读查询声明
Sequence,需要修改列表元素时检查MutableSequence。 - 自定义序列优先继承基类:只需实现
__len__和__getitem__即可复用基类提供的全套混入方法,减少重复代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















