


为什么Python循环中不建议用+号拼接字符串
深入解析为什么在Python循环中不建议使用+或+=运算符拼接字符串,剖析不可变对象的内存重分配与字符搬迁机制,对比O(N^2)与O(N)的底层执行流程,并提供str.join等标准化的高性能替代方案。
str)是底层不可变对象(Immutable Object)。在循环体内使用 + 或 += 拼接字符串时,解释器每次操作都必须在堆内存中重新申请一块新空间,并将前面已经累积的全部字符全量复制进去。这导致整个循环的字符复制总量呈现阶梯式累加,使时间复杂度从原本应有的线性复杂度 O(N) 退化为二次方复杂度 O(N²)。解决此问题的通用标准做法,是在循环中将各片段存入列表(list.append),循环结束后调用 ''.join(list) 进行单次聚合。
一、核心症结:Python 字符串的不可变机制
要理解为什么 + 拼接在循环中会引发性能急剧衰退,必须先看 Python 对字符串对象的内存组织方式。
在 Python(CPython)内部,字符串对应的数据结构是 PyUnicodeObject(如紧凑型 PyCompactUnicodeObject)。这类对象被设计为不可变(Immutable),其生命周期内具备三个不可修改的物理属性:
- 内存布局固定:对象头信息包含引用计数(
ob_refcnt)、类型指针、字符长度(length)以及紧随其后的连续 UTF-8/Latin-1/UCS 字符缓冲区。 - 不允许就地修改:程序无法像操作 C 语言字符数组那样直接改写某个下标位置的内存,也不支持向现有内存块末尾动态附加新字符。
- 新结果对应新对象:任何看起来像“修改”字符串的操作(如拼接、替换、大小写转换),在语言语义上都要求生成一个全新的字符串对象,并重新分配独立的堆内存。
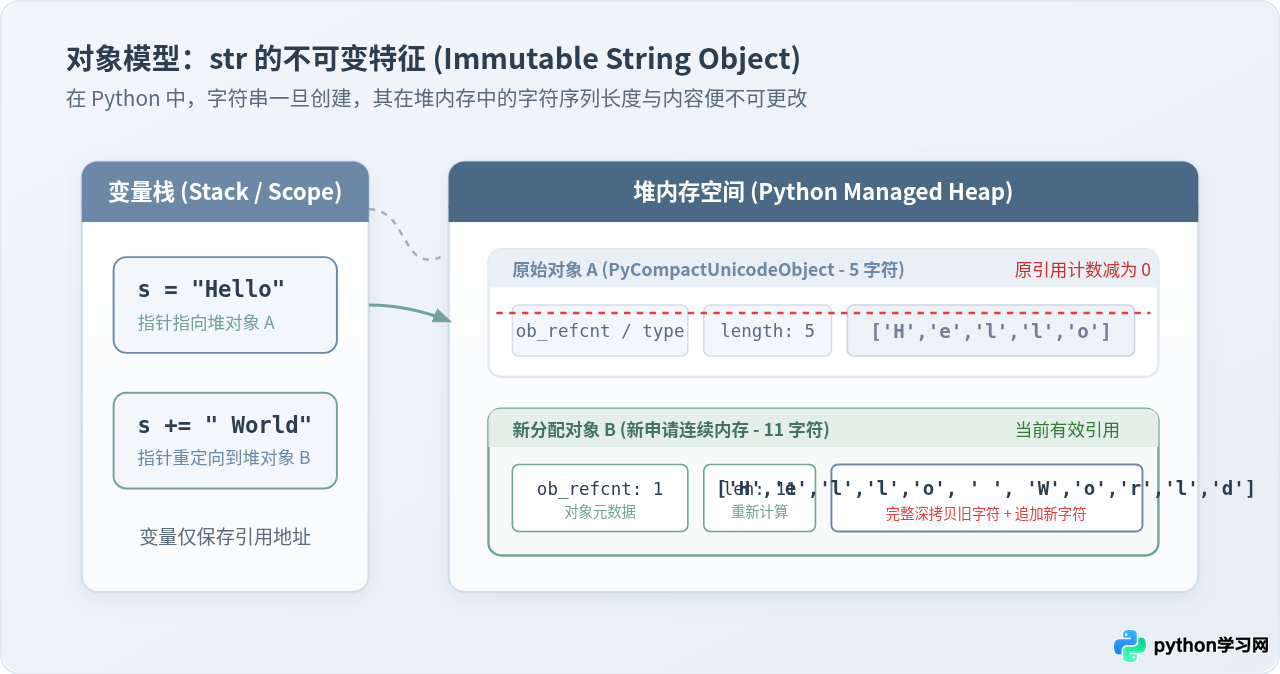
如上图所示,当执行 s += " World" 时,并不是在原有的 "Hello" 内存块尾部追加空间,而是创建了包含 11 个字符的新对象 "Hello World",变量 s 改为指向新对象,原对象由于失去了引用,将在适当时机被内存回收机制销毁。
二、性能滑坡的根源:循环中的 O(N²) 字符搬迁
在单次或极少数变量的拼接中(例如拼装一个短文件路径),重新分配一次内存的开销几乎微乎其微。但一旦把这个操作放进循环,内存重分配与字符拷贝的累积效应就会被急剧放大。
以下面这个典型的遍历数据并构造长字符串的代码为例:
# 常见的不当写法:在循环中不断使用 += 拼接
def build_string_bad(items):
    result = ""
    for item in items:
        result += str(item)
    return result
假设我们要拼接 N 个长度为 1 的字符(例如 'A' 到 'Z'...):
- 第 1 次循环:申请 1 字符内存,写入
'A'(拷贝 1 次); - 第 2 次循环:申请 2 字符内存,先拷贝旧的
'A',再追加'B'(累计拷贝 1 + 1 = 2 次); - 第 3 次循环:申请 3 字符内存,先拷贝旧的
'AB'(2 个字符),再追加'C'(累计拷贝 2 + 1 = 3 次); - 第 N 次循环:申请 N 字符内存,必须先把前 N - 1 个字符完整搬运过来,再追加第 N 个字符(累计拷贝 N 次)。
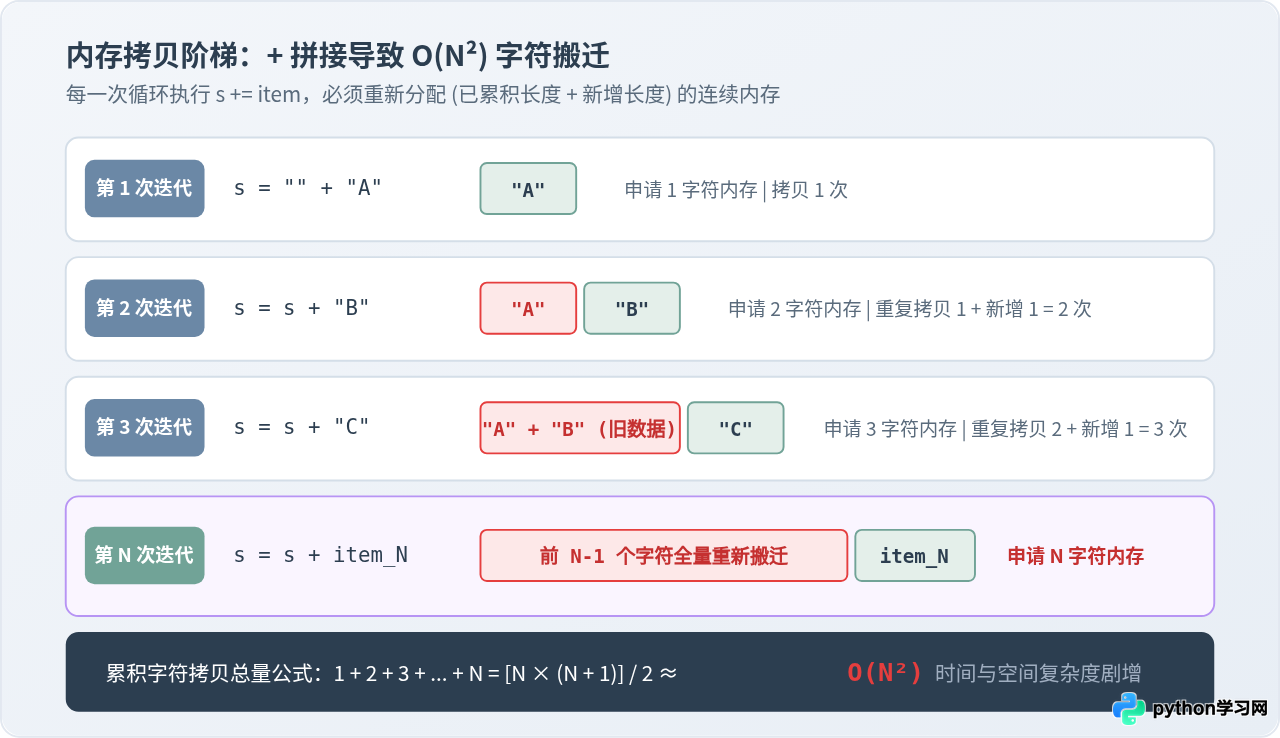
将每次迭代需要搬运的字符数量相加,其总拷贝量构成了一个等差数列:
总拷贝字符数 = 1 + 2 + 3 + ... + N = [N × (N + 1)] / 2 ≈ O(N²)这意味着:如果循环需要拼接 1,000 个片段,底层并不是只处理 1,000 次字符写入,而是搬运了大约 500,000 次字符;当片段增加到 100,000 个时,理论复制量将攀升至 50 亿次。CPU 的大量时钟周期全部浪费在反复 malloc/free 和 memcpy 历史字符上,导致程序出现肉眼可见的卡顿与高 CPU 占用。
三、底层机制对比:频繁申请 vs 单次批处理
解决这个问题的核心逻辑非常简单:把多次分散的内存重分配,合并为一次性预计算与连续写入。这正是 str.join() 所采用的工作机制。
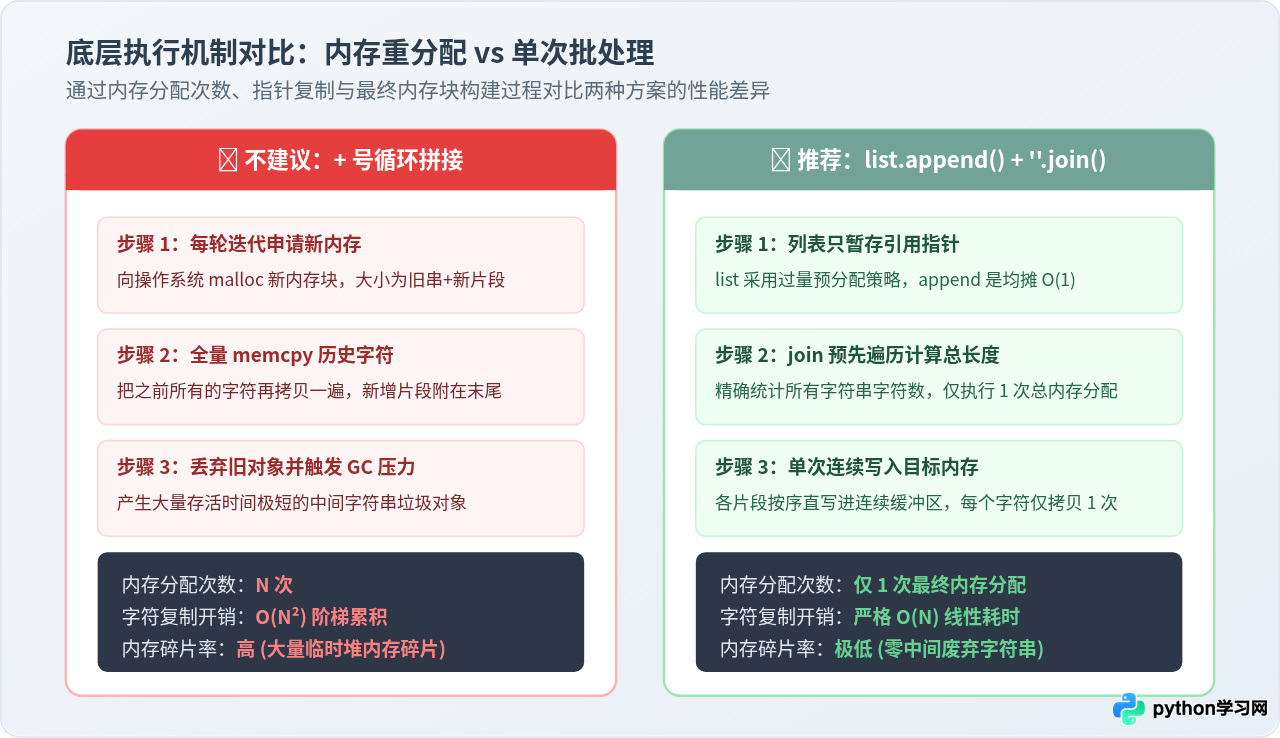
我们可以从底层执行的三个核心维度对比这两种方案的差异:
| 对比维度 | + 号循环拼接(不建议) | list.append() + str.join()(标准推荐) |
|---|---|---|
| 内存分配次数 | N 次(每轮循环均发起系统调用) | 列表扩容均摊 + 拼接时仅 1 次最终分配 |
| 字符拷贝复杂度 | O(N²)(前期字符被无意义反复重搬) | O(N)(每个字符在 join 时只写入 1 次) |
| 中间垃圾对象 | 产生 N 个临时字符串,增加 GC 压力 | 仅列表保存指针引用,零多余字符串垃圾 |
| 跨平台/环境一致性 | 受 CPython 版本与内存碎片影响极大 | 所有 Python 解释器实现均保持一致高性能 |
在推荐的方案中:
list.append()仅向动态数组末尾追加一个 8 字节的对象指针。Python 列表预留了连续的扩容槽位(Over-allocation),单次追加的均摊时间复杂度为O(1)。''.join(parts)执行时采用两阶段算法:第一遍快速遍历列表统计各个元素字符串长度的总和;第二步向操作系统一次性申请容纳总长度的目标内存块;第三步直接将各片段字符按顺序连续写入缓冲区。因此总时间严格与字符总量成正比,为O(N)。
四、为什么有时候测不出慢?CPython 的就地优化与潜在陷阱
不少开发者在编写简单微基准测试(Micro-benchmark)时会发现一个现象:在本地较新的 CPython 版本中,写一个小循环用 += 拼接几千次,耗时似乎并没有呈现夸张的二次方暴涨。这往往让人误以为“现代 Python 已经彻底解决了加号拼接问题”。
事实并非如此。这实际上源于 CPython 解释器内置的一项单引用就地扩容优化(In-place Realloc Optimization)。
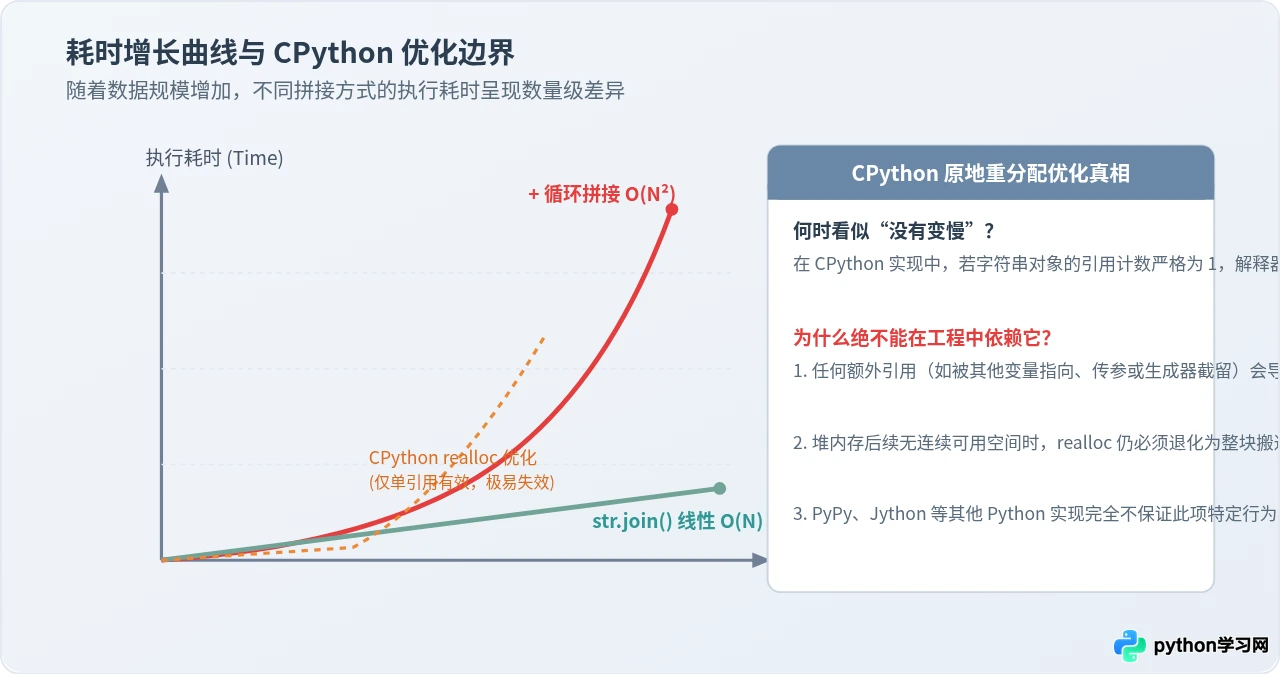
CPython 的源码在执行 PyUnicode_Concat 或 INPLACE_ADD 字节码时,会检查目标字符串的 ob_refcnt 是否严格为 1。如果仅有当前唯一引用,且宿主系统的堆管理器恰好在原内存块后方有连续空闲空间,CPython 会尝试调用 realloc 原地扩容,从而避免全量搬迁。然而这种优化极度脆弱:
- 引用泄漏即失效:如果在循环体中任何地方将该字符串传入了日志函数、赋值给了备用变量,或者被闭包捕获,其引用计数便大于 1,优化瞬间退化回
O(N²)。 - 内存碎片导致失效:当拼接内容增长到一定体积后,堆后方无法保证连续可用空间,
realloc依然必须退化为申请新空间并全量拷贝。 - 非 CPython 平台失效:在 PyPy、Jython 或微型 Python 环境(MicroPython)中,并不保证存在此项优化,相同的代码可能产生巨大的性能鸿沟。
五、标准高效替代方案与代码重构
针对不同的拼接诉求,Python 提供了多种语法清晰且性能出色的替代模式:
1. 通用模式:先收集到列表,最后用 str.join() 合并
这是绝大多数循环拼接场景的标准答案。无论循环条件多么复杂、是否有动态过滤条件,都可以平滑适配:
# 标准重构写法:list.append + join
def build_report(records):
    parts = []
    for record in records:
        # 支持复杂的过滤与多行组装
        if record.is_valid:
            parts.append(f"ID: {record.id}, Name: {record.name}\n")

    # 循环外一次性组装
    return "".join(parts)
2. 紧凑模式:列表推导式或生成器表达式
如果循环逻辑比较单纯,直接使用推导式不仅更加紧凑,可读性也更好:
# 数据转换类场景首选
data = [101, 102, 103, 104, 105]
result = ",".join(str(x) for x in data)"".join([str(x) for x in data])(列表推导式)通常会比生成器表达式 "".join(str(x) for x in data) 还要快 10%~20%。因为列表在传入 join 时长度是确定的,C 源码能够预先知道总项数;而生成器由于无法提前预知总长度,底层必须在写入过程中对缓冲结构进行数次微调扩容。
3. 流式模式:使用 io.StringIO 内存流
当拼接逻辑非常庞大,且拆分在多个辅助函数中逐步写入时,io.StringIO 是最佳选型。它模仿了文件操作接口,提供了极好的抽象能力与内存吞吐效率:
import io

def generate_large_csv(row_generator):
    buffer = io.StringIO()
    # 写入表头
    buffer.write("col1,col2,col3\n")

    for row in row_generator:
        # 像写文件一样流式写入,避免创建大量中间变量
        buffer.write(f"{row[0]},{row[1]},{row[2]}\n")

    content = buffer.getvalue()
    buffer.close()
    return content
六、方案选型决策与三步重构法
为了让不同场景下的代码兼顾简洁性、可读性与执行效率,可以参考下面的选型决策图及标准化重构步骤:
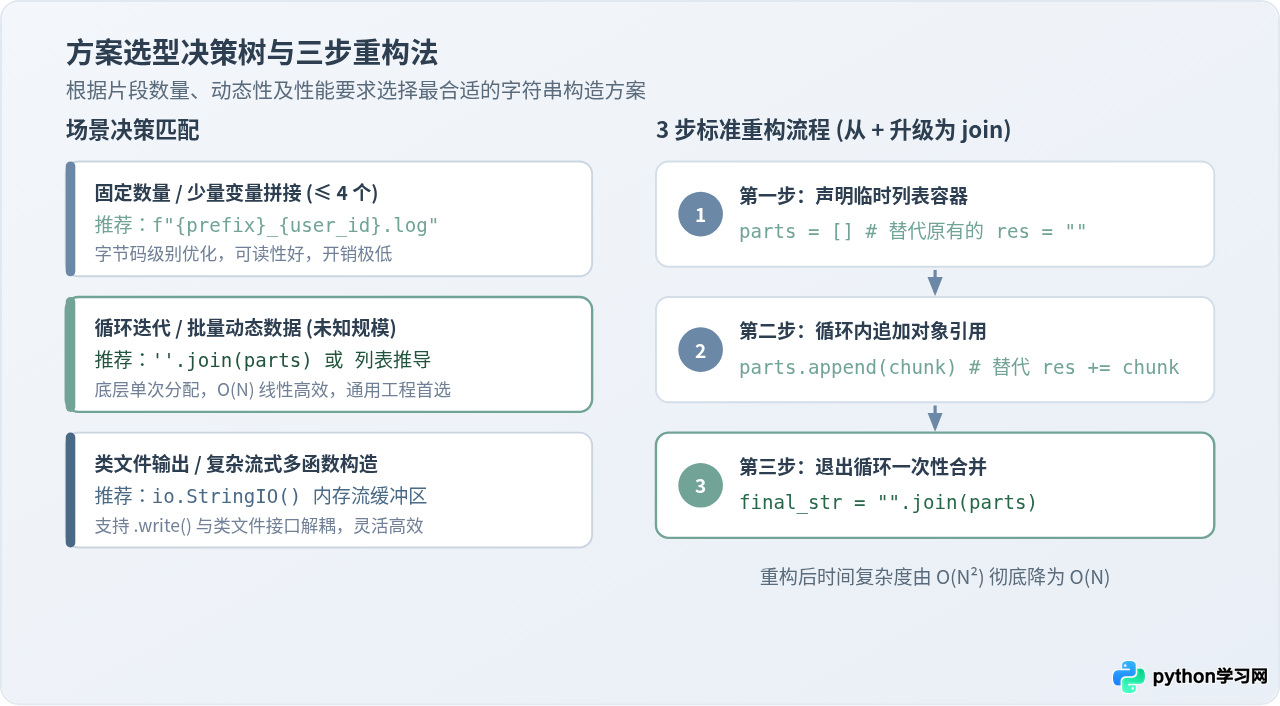
三步重构法落地步骤:
- 定位初始化变量:找到循环前声明的空字符串变量(如
res = ""),替换为空列表容器(parts = [])。 - 改造循环内赋值:将循环体内部原有的拼接语句
res += segment替换为向列表追加元素parts.append(segment)。 - 在出口处统一合并:在退出循环并需要使用该结果的地方,使用目标分隔符执行
final_result = "".join(parts)。
遵循这套规范,既能消除潜在的 O(N²) 性能隐患,又无需依赖底层脆弱的特定解释器优化,使 Python 代码在处理更大规模的数据时依然保持稳定、可靠的高吞吐能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















