


Python ctypes数组索引越界或报TypeError怎么解决
深入分析Python ctypes模块在操作数组和指针时出现TypeError与索引越界/段错误的常见场景,剖析类与实例未区分、原生列表未包装、字节编码错位及裸指针缺乏边界保护等底层原因,提供规范的转换修复代码、系统排查流程与工程防御规范。
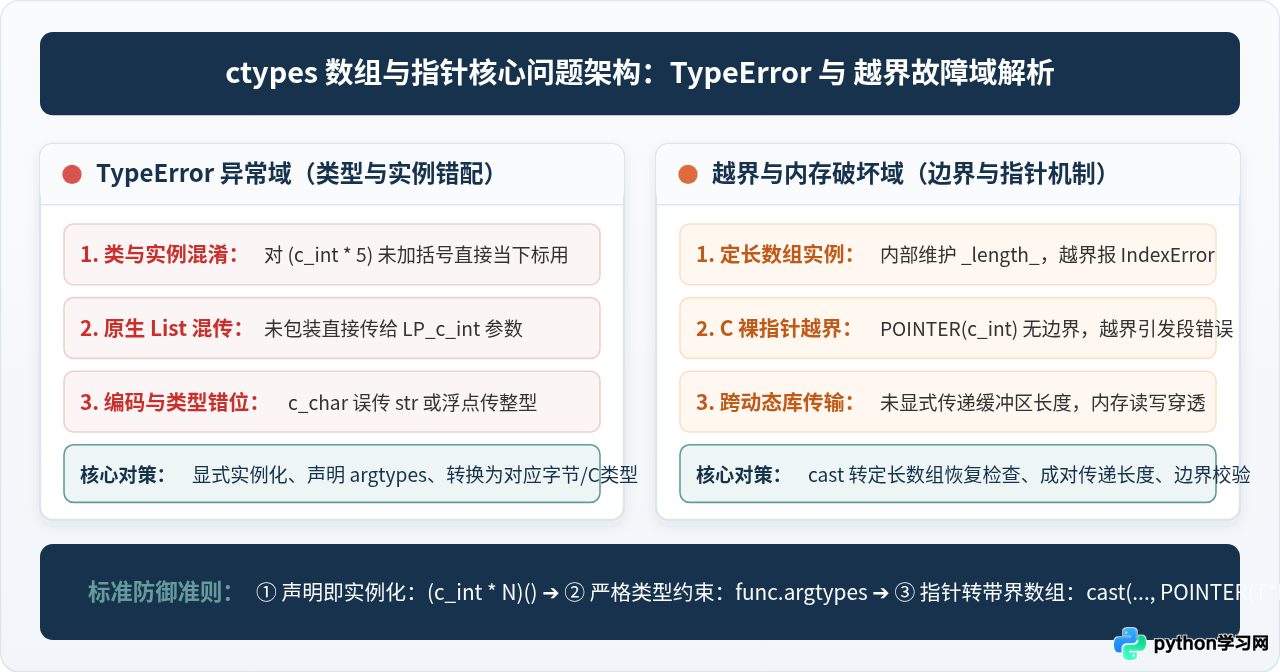
TypeError 通常是因为混淆了“数组类型定义”与“实例对象”、直接将 Python 原生列表传入 C 函数,或元素类型(如 str 与 bytes)不匹配;而处理“索引越界”,则必须分清当前操作的是定长数组实例还是 C 裸指针——定长数组内部封装了长度校验,越界会抛出明确的 IndexError,但若直接对 C 裸指针进行越界下标访问,Python 将失去拦截能力,导致静默内存破坏甚至进程段错误(Segmentation fault)。本文将逐项解析这些报错的根源,并给出准确的修复代码与防御方案。
一、常见 TypeError 的报错表现与逐一排查修复
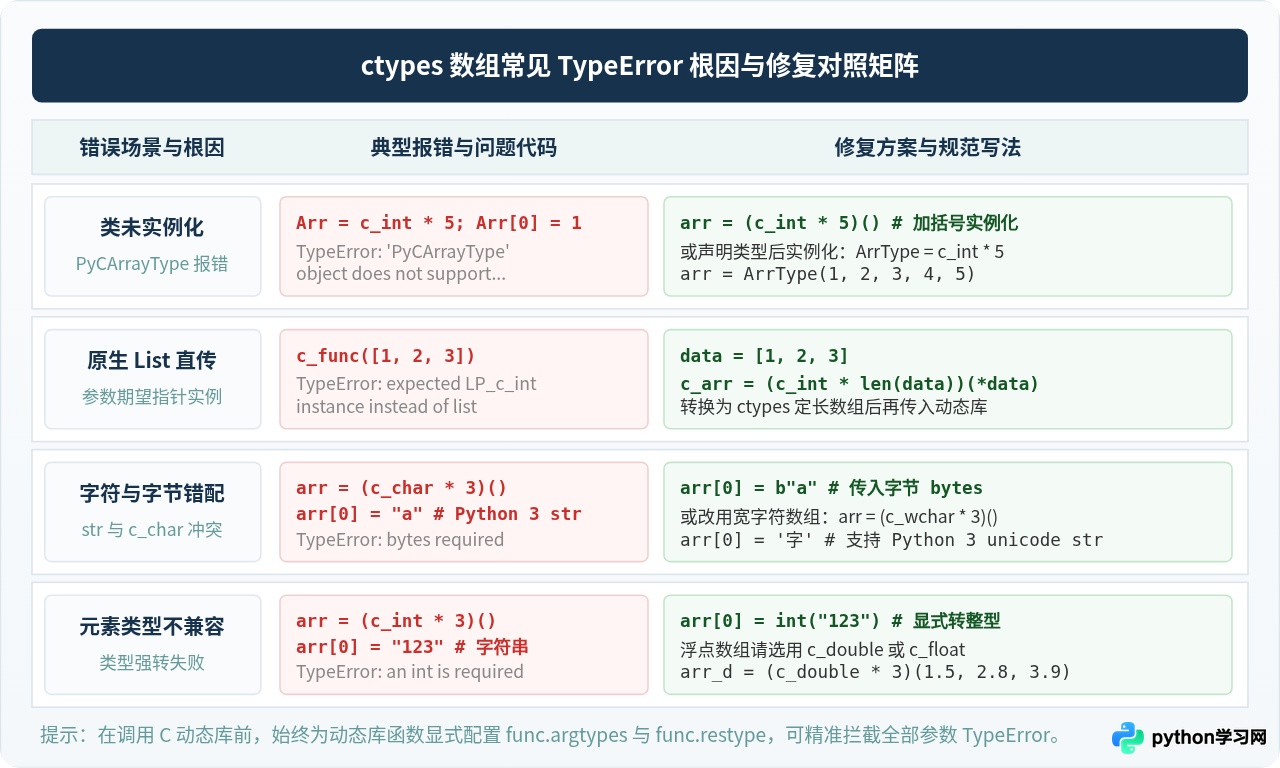
ctypes 封装了底层 C 数据类型,其类型系统与 Python 原生类型有着严格的隔离。编写代码时,以下四种情况最容易引发 TypeError。
1. 混淆“数组类型定义”与“数组实例对象”
这是初学者最容易遇到的错误。在 ctypes 中,表达式 c_int * 5 并不是创建了一个包含 5 个整数的数组,而是动态生成了一个数组类型(类),相当于 C 语言中的类型别名 typedef int IntArray[5];。
# 错误示例:试图对类型本身进行下标读取或赋值
import ctypes

IntArray5 = ctypes.c_int * 5
IntArray5[0] = 100 # 触发 TypeError解决办法:必须使用圆括号完成实例化构造。可以先定义类型再实例化,也可以直接内联实例化:
import ctypes

# 方式一:内联实例化一个长度为 5 的整数数组,默认元素清零
arr = (ctypes.c_int * 5)()
arr[0] = 100  # 正常赋值

# 方式二:定义类型后显式初始化赋值
IntArray5 = ctypes.c_int * 5
arr2 = IntArray5(10, 20, 30, 40, 50)
print(arr2[0])  # 正常输出: 10
2. 直接将 Python 原生 List 传入 C 函数
当调用 C 动态库函数时,如果 C 函数形参期望接收一个数组指针(例如 int* 或 int[]),直接传入 Python 的 list 会失败。因为 Python 列表是动态指针数组,内部保存的是散列的 PyObject* 引用,并非 C 语言所需的物理连续整数内存块。
# 错误示例:将 Python 列表直接传给需要连续内存的 C 函数
import ctypes

libc = ctypes.CDLL(None) if hasattr(ctypes, 'CDLL') else None
# 假设某 C 函数原型为 void process_data(int *arr, int len);
# 绑定参数签名:
# my_dll.process_data.argtypes = [ctypes.POINTER(ctypes.c_int), ctypes.c_int]
# 直接调用:
# my_dll.process_data([1, 2, 3], 3)解决办法:需要将 Python 列表快速解包构建为 ctypes 的连续数组实例。该数组实例在传递给 C 函数时,ctypes 会自动将其转换为指向首元素的指针:
import ctypes

py_data = [12, 34, 56, 78]
# 通过解包列表构造定长连续内存数组
c_arr = (ctypes.c_int * len(py_data))(*py_data)

# 现在 c_arr 可以无缝传给 POINTER(c_int) 类型的参数
# my_dll.process_data(c_arr, len(py_data))
3. Python 3 字符串(str)与字节流(c_char)混淆
在 Python 3 中,所有字符串都是 Unicode 编码的 str。而 ctypes.c_char 严格对应 C 语言的单字节 char。如果试图将 str 字符存入 c_char 数组,就会触发类型校验错误。
# 错误示例:向 c_char 数组赋值 unicode 字符串
import ctypes

char_arr = (ctypes.c_char * 4)()
char_arr[0] = 'A'  # 报错:'A' 是 str 不是 bytes
解决办法:存入单字节时必须使用 bytes(如 b'A');如果要保存中文字符或 Unicode 字符,应改用 ctypes.c_wchar 数组:
import ctypes

# 方案 A:针对单字节 ASCII / 二进制缓冲区,传入 bytes
byte_arr = (ctypes.c_char * 4)()
byte_arr[0] = b'A'
byte_arr.value = b"ABC"  # 直接整体赋值 bytes

# 方案 B:针对 Unicode 文本,使用宽字符 c_wchar
wchar_arr = (ctypes.c_wchar * 4)()
wchar_arr[0] = '中'
wchar_arr.value = "中文测"  # 支持标准 str
4. 元素类型不兼容与隐式转换失败
向 ctypes 数组赋值时,如果传入了无法隐式转换的数据类型(例如向整数数组传入字符串,或者传入超出整型表示范围的值),ctypes 会直接拦截并抛出 TypeError 或 OverflowError。
import ctypes

arr = (ctypes.c_int * 3)()
arr[0] = "99"  # 触发 TypeError: an integer is required (got type str)
解决办法:在写入数组前进行显式数据清洗与类型强转,例如 arr[0] = int(val)。对于浮点数据,务必声明为 ctypes.c_float 或 ctypes.c_double。
二、数组索引越界的两类场景:可捕获的 IndexError 与致命的段错误
在 ctypes 编程中,“索引越界”的表现形式完全取决于当前操作的 Python 对象底层究竟是定长数组实例(Array)还是裸指针(Pointer)。
1. 定长数组实例:Python 内部边界检查(触发 IndexError)
当使用 (c_int * N)() 创建数组实例时,ctypes 对象内部维护了属性 _length_。在 Python 层面通过 arr[i] 访问元素时,解释器会自动校验索引是否在有效区间内。有效索引范围为 [-length, length - 1]:
import ctypes

arr = (ctypes.c_int * 3)(1, 2, 3)

# 合法索引:0, 1, 2 以及负数索引 -1, -2, -3
print(arr[-1])  # 输出: 3

# 越界访问:
print(arr[3])   # 抛出 IndexError
解决办法:定长数组越界的排查非常明确,只需在访问前增加边界校验,或者使用标准的 len(arr) 进行守卫保护:
index = 5
if 0 <= index < len(arr):
    val = arr[index]
else:
    # 执行越界规避或补救逻辑
    raise IndexError(f"索引 {index} 越界,数组有效长度为 {len(arr)}")
2. C 裸指针(POINTER):静默越界与段错误(Segmentation fault)
这是使用 ctypes 最具破坏性的陷阱。当通过 ctypes.POINTER(ctypes.c_int) 接收 C 动态库返回的指针,或者通过 ctypes.cast 获取指针时,指针对象本身并不记录缓冲区长度。
虽然 ctypes 允许使用下标语法 ptr[i] 访问指针后面的数据,但底层仅仅是执行基地址偏移计算:*(ptr + i)。此时 Python 完全无法提供边界检查:
- 若访问了未分配或超出进程可读权限的内存页,操作系统会立即终止整个 Python 进程,报错
Segmentation fault: 11(Linux/macOS)或Access Violation(Windows),没有任何 Python 异常可以捕获; - 若访问的内存地址刚好可读,程序将静默读入垃圾数据,造成难以追踪的逻辑错误与计算污染。
3. 核心解法:使用 cast 将裸指针重新定界为定长数组
当从 C 接口拿到一个裸指针及其实际包含的元素个数时,最稳妥的策略是立即将其重新转换(cast)为带长度的定长数组引用。
import ctypes

# 模拟从 C 库拿到了一个裸指针 ptr 和实际元素个数 4
raw_data = (ctypes.c_int * 4)(10, 20, 30, 40)
ptr = ctypes.cast(raw_data, ctypes.POINTER(ctypes.c_int))

# 错误用法:裸指针直接读取下标,无任何边界拦截,容易产生内存崩溃
# print(ptr[999999])  -> 极可能直接 Segmentation fault 退出进程

# 正确方案:将指针重新 cast 为指向定长数组的指针,并取其 .contents
count = 4
safe_array = ctypes.cast(ptr, ctypes.POINTER(ctypes.c_int * count)).contents

# 此时 safe_array 是一个带有边界检查的合法定长数组实例!
print(safe_array[0])  # 正常输出: 10

try:
    print(safe_array[4])  # 触发 Python 保护机制
except IndexError as e:
    print("安全捕获越界异常:", e)  # 成功拦截,程序不崩溃!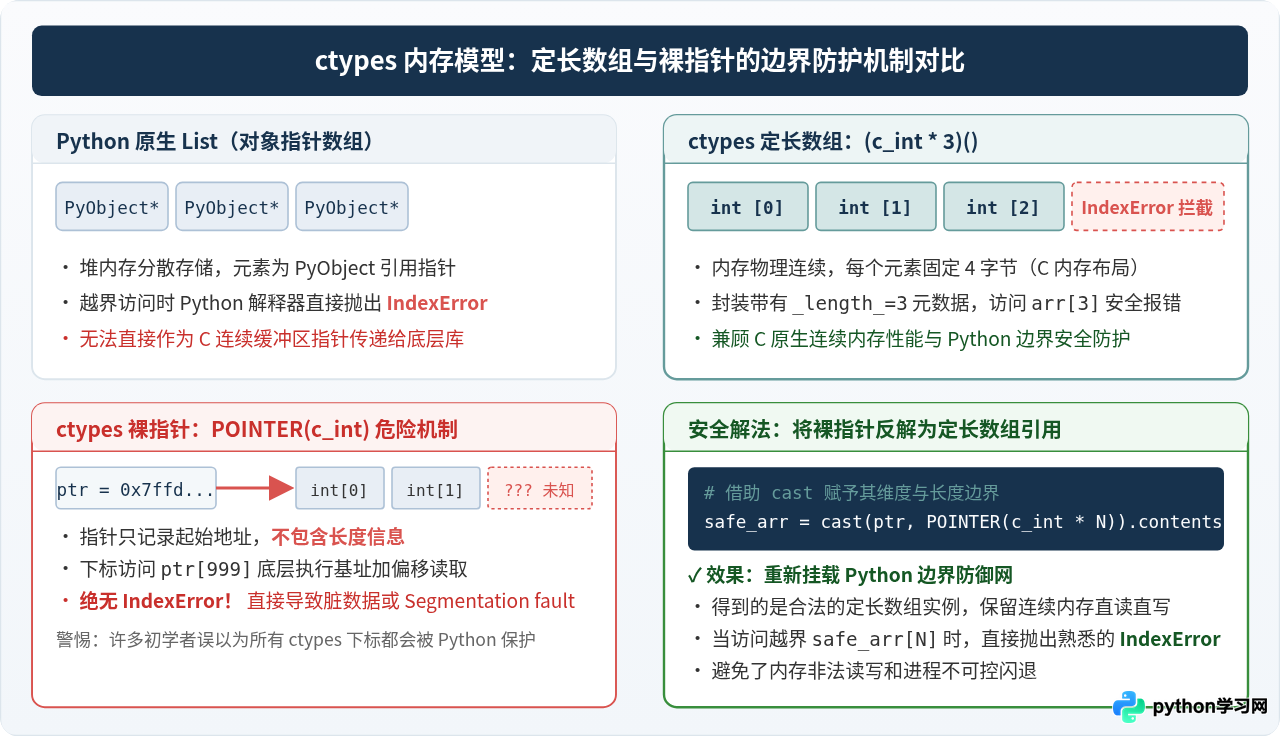
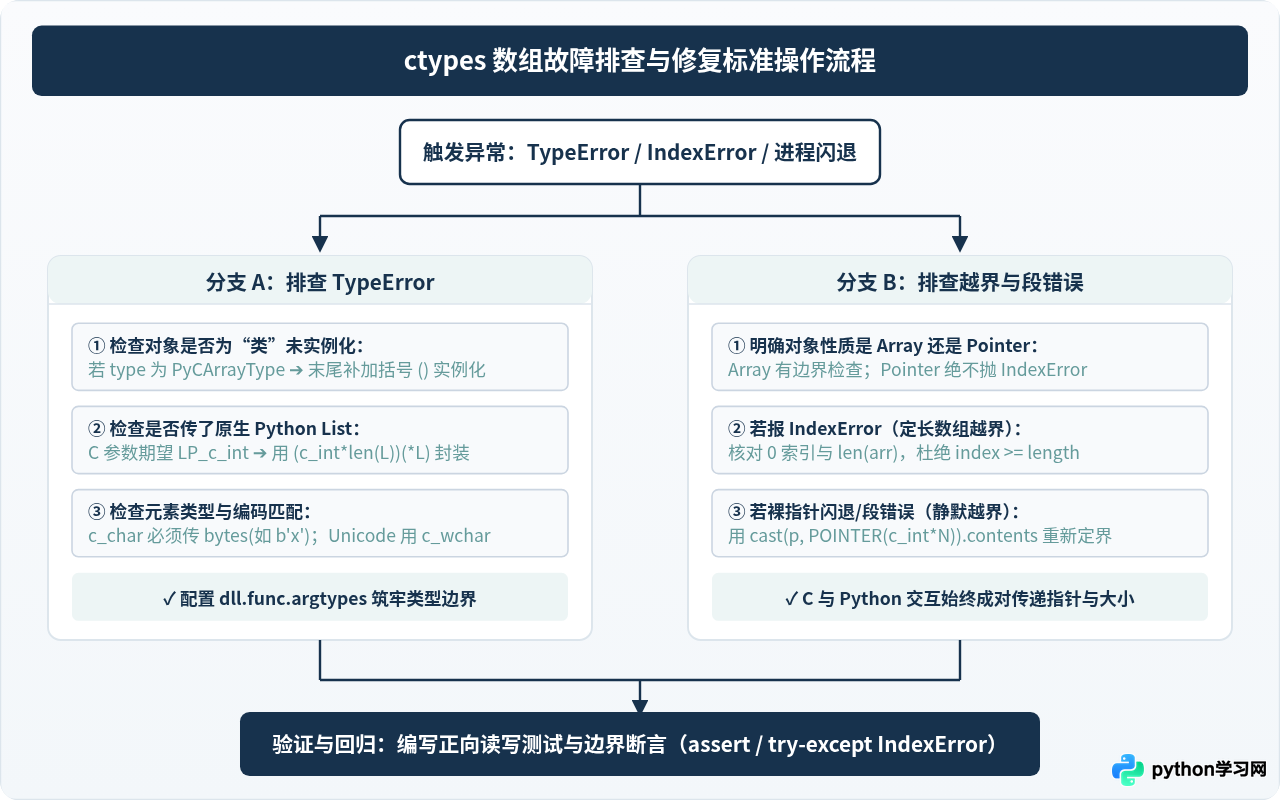
三、系统排查与定位全流程
当在运行日志中发现与 ctypes 数组相关的错误时,建议按照以下固定步骤排查,快速定位是类型错误还是边界溢出:
-
区分报错层级:
看终端是打印了 Python 堆栈追踪(如
TypeError或IndexError),还是程序直接闪退并显示Segmentation fault。如果是闪退,重点检查指针下标越界、野指针或悬空指针;如果是 Python 异常,则属于类型或定长数组越界。 -
打印对象类型(type)与是否为类:
使用
print(type(obj))查看对象。若输出类似<class '_ctypes.PyCArrayType'>,说明忘记加括号进行实例化;若输出为<class 'LP_c_int'>,说明这是一个裸指针,不可在无长度守卫下随意下标取值。 -
审查 C 动态库函数签名(argtypes):
检查是否对调用的 C 函数配置了
argtypes。如果没有配置,ctypes 只能做默认传参转换,遇到复杂类型会产生隐晦的类型不匹配或内存损坏。显式配置func.argtypes = [ctypes.POINTER(ctypes.c_int), ctypes.c_size_t]能够让绝大部分类型错误在函数调用前即被准确捕获。 -
检查数据源的编码与生命周期:
核对传入字符串是否使用了
.encode('utf-8')转为字节,确认所引用的底层 Python 内存对象在 C 异步函数执行期间未被 Python 垃圾回收机制回收。
四、防御性编码:杜绝 TypeError 与越界的工程最佳实践
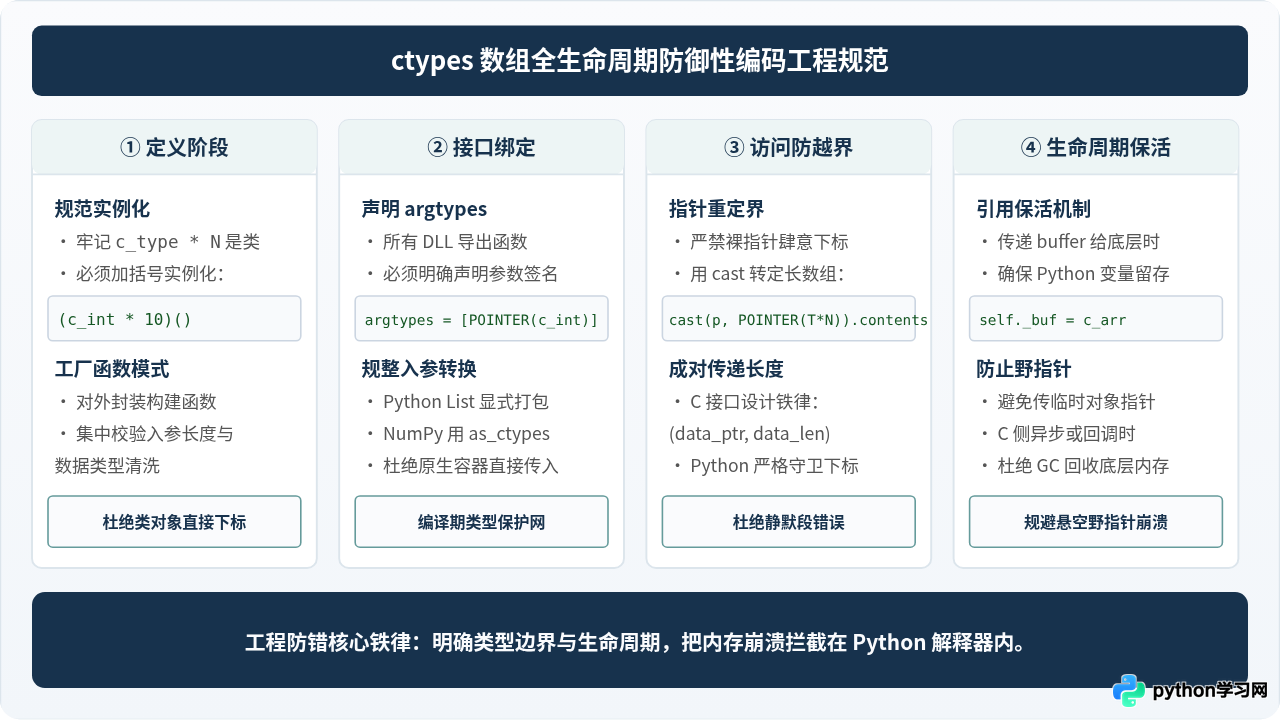
在实际生产环境中,应当遵循以下四条工程规范,彻底隔绝 ctypes 数组与指针问题:
1. 接口设计铁律:始终成对传递“指针”与“长度”
C 语言中的指针本身不携带长度信息。无论是编写供 Python 调用的 C 动态库,还是封装 Python 适配层,都必须将缓冲区首地址与缓冲区元素个数成对传入:
# 推荐的 C 函数调用签名设计
my_dll.process_buffer.argtypes = [
    ctypes.POINTER(ctypes.c_int),  # 数组指针
    ctypes.c_size_t               # 数组真实元素个数
]

def safe_process(data_list):
    n = len(data_list)
    c_arr = (ctypes.c_int * n)(*data_list)
    # 同时传递指针与长度
    my_dll.process_buffer(c_arr, n)
2. 与 NumPy 交互时的安全转换方法
在数据处理场景中,经常需要将 NumPy 连续数组传递给 ctypes。切勿先转为 Python 列表再转 ctypes 数组,这会带来严重的内存复制与性能损耗。应使用 NumPy 自带的 ctypes 接口,既能直接共享连续内存,又具备类型安全保障:
import numpy as np
import ctypes

# 创建连续连续内存数组
np_arr = np.array([1, 2, 3, 4], dtype=np.int32)

# 方式 A:通过 np.ctypeslib.as_ctypes 零拷贝映射为 ctypes 数组
c_arr = np.ctypeslib.as_ctypes(np_arr)
print(type(c_arr))  # c_int_Array_4,带 length 保护

# 方式 B:通过 ctypes.data_as 直接获取对应类型的指针
ptr = np_arr.ctypes.data_as(ctypes.POINTER(ctypes.c_int32))
3. 警惕 Python 垃圾回收:避免临时数组对象的悬空指针
如果在调用 C 函数时传入了临时创建的 ctypes 数组对象的指针,例如 my_dll.save_ptr(ctypes.byref((ctypes.c_int * 3)())),该临时对象在当前行执行完毕后可能立刻被 Python 垃圾回收回收。底层 C 库若后续继续访问该地址,将造成悬空野指针崩溃。
防范规范:必须在 Python 作用域中保留对 ctypes 数组实例的强引用变量(例如保存在类的实例属性 self._buffer 中),确保其生命周期覆盖底层 C 库的使用周期。
五、常见关联疑问解答
因为在底层架构中,POINTER(T) 对应 C 语言的裸地址指针,C 语言指针在运行时不存储自身所指向的内存块大小。因此 ctypes 指针对象没有实现 __len__ 魔法方法。试图执行 len(ptr) 会明确报 TypeError: object of type 'LP_c_int' has no len()。正确的做法是像前文所述,由函数调用方显式传递或记录元素总数 N,并通过 cast(ptr, POINTER(c_type * N)).contents 重新挂载带长度信息的定长数组实例。
支持负数索引,例如 arr[-1] 可以访问最后一个元素,其下限为 -len(arr),超出该范围同样会抛出 IndexError: invalid index。但切片操作与普通 Python 列表有所不同:ctypes 数组切片返回的是一个新的 Python 列表对象,而非视图;同时对切片进行整体赋值时,必须保证右侧数据与切片片段大小和类型完全匹配,否则会报 TypeError。
在单元测试中,应分别针对正常读取与越界场景编写断言。对于定长数组,使用 pytest.raises(IndexError) 验证在 index >= length 时能准确抛出并捕获异常;对于 C 指针封装逻辑,在测试中向其输入故意越界的测试下标,确认包装层(Wrapper)在 Python 端已成功拦截并阻断请求,未产生进程崩溃。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















