


Python文件读写操作详解:open函数与上下文管理器
全面详解Python中如何使用open函数进行安全高效的文件读写,深入剖析with上下文管理器的底层原理与资源释放机制,涵盖常用文件模式、字符编码处理、游标操作及高频踩坑避坑指南。
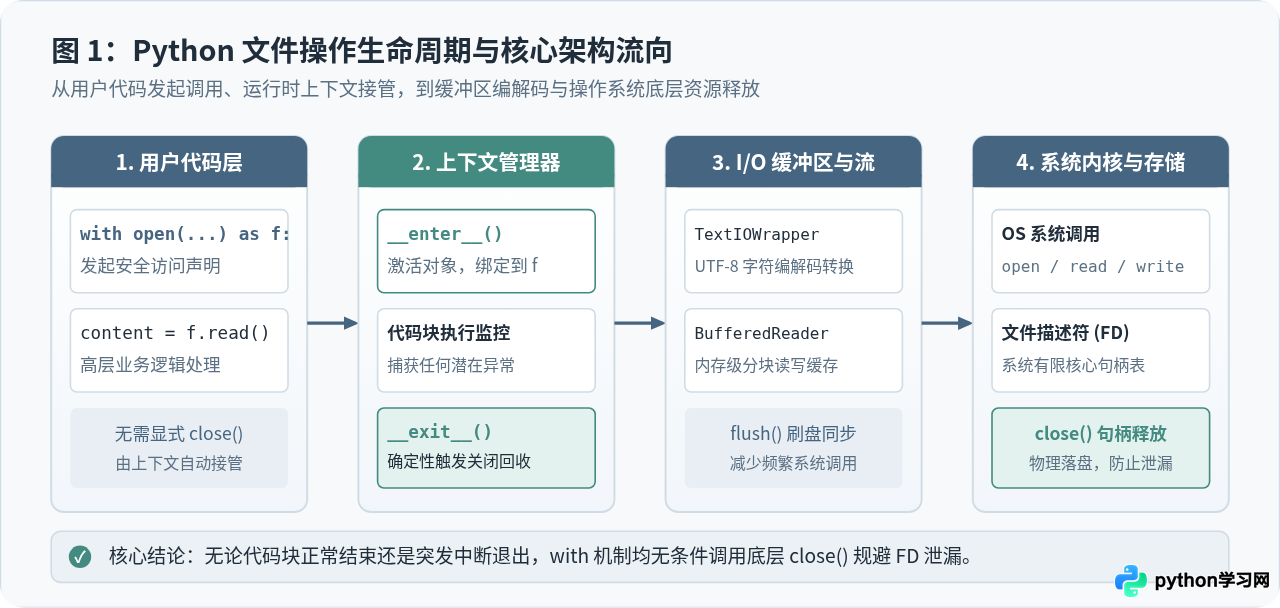
在 Python 中读写文件的标准规范是使用内置的 open() 函数配合 with 语句(上下文管理器)。这种组合不仅能精准掌控目标文件的访问模式与字符集编码,还能通过 Python 的上下文管理协议保证系统资源无论在正常执行还是异常中断时均被绝对安全释放,彻底避免文件描述符泄漏与缓冲区丢失。
一、open() 函数基础与核心参数解析
Python 内置的 open() 函数是连接用户程序与操作系统文件系统的标准接口。它负责向操作系统申请打开指定路径的文件,并返回一个可操作的文件流对象(File Object)。
open() 函数的完整签名定义如下:
open(file, mode='r', buffering=-1, encoding=None, errors=None, newline=None, closefd=True, opener=None)在日常开发中,绝大多数场景只需要关注前几个关键参数:
-
file(必需):文件路径。可以是普通的字符串路径(相对路径如"data.txt",或绝对路径如"/var/log/app.log"),也可以是标准库pathlib.Path对象。 -
mode(可选,默认为'r'):文件访问模式。控制文件是以只读、覆盖写、追加写还是独占创建的方式打开,并决定返回文本流还是二进制字节流。 -
encoding(文本模式强烈推荐显式指定):字符编码名称。如果不显式传递此参数,Python 将默认采用当前操作系统的区域编码(通过locale.getpreferredencoding(False)获取)。在 Windows 简体中文系统下,这往往是gbk或cp936,而在 macOS 与 Linux 下则是utf-8。这种隐式行为是跨平台部署时频发UnicodeDecodeError的根源,因此在处理文本文件时,强烈建议永远显式指定encoding="utf-8"。 -
errors(可选):字符编解码遇到非法字节时的处理策略。默认是"strict"(遇到解码失败立即抛出UnicodeError)。在处理来源未知或格式有轻微瑕疵的文本时,可设置为"replace"(非法字节替换为问号或占位符)或"ignore"(静默跳过非法字符)。 -
newline(可选):换行符转换策略。默认开启通用换行符模式,读取时会自动将newline=''以防止多余的空行产生。 -
buffering(可选):缓冲区策略。-1表示使用系统默认缓冲大小;0表示关闭缓冲(仅支持二进制模式);1表示文本模式下的行缓冲。
二、文件访问模式的深度区分与适用场景
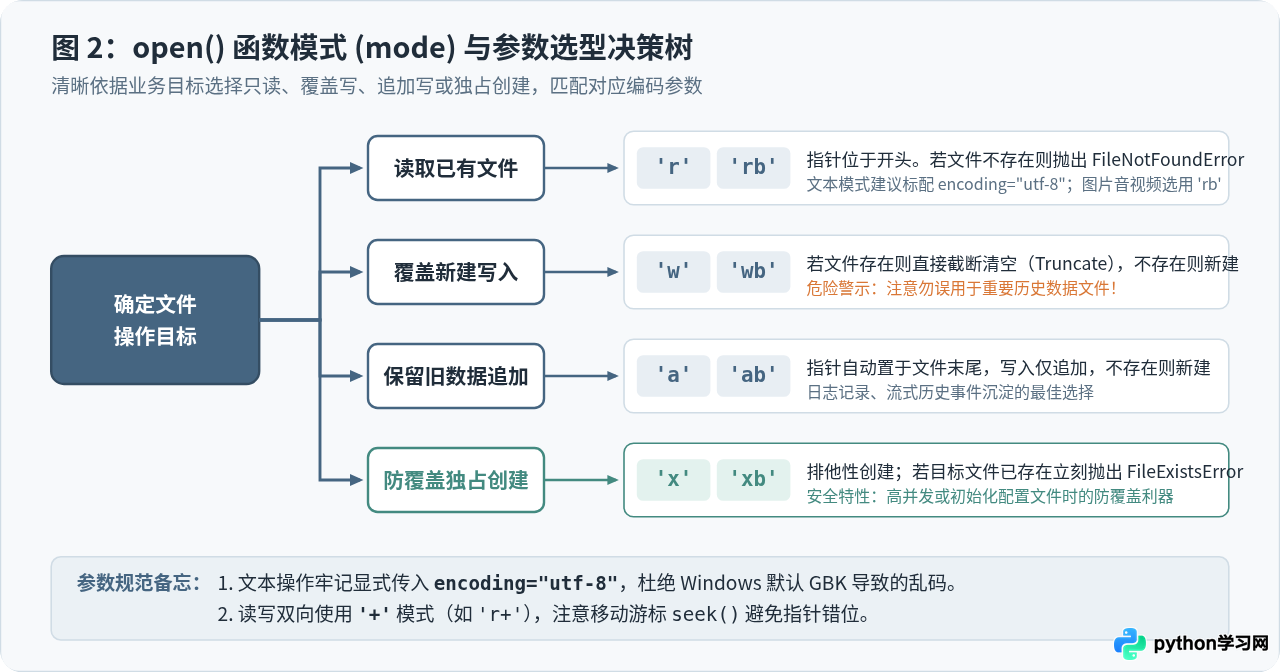
mode 参数由基础操作类型与数据类型组合而成。正确选择模式是确保业务逻辑正确与历史数据安全的前提。
| 模式字符 | 含义 | 若文件不存在 | 若文件已存在 | 初始指针位置 |
|---|---|---|---|---|
'r' |
只读文本模式(默认) | 抛出 FileNotFoundError |
正常打开,保留原内容 | 文件开头(0 偏移) |
'w' |
覆盖写入文本模式 | 自动创建新文件 | 直接截断清空(Truncate)原有内容 | 文件开头(0 偏移) |
'a' |
追加写入文本模式 | 自动创建新文件 | 保留原内容,新写入内容紧随其后 | 文件末尾 |
'x' |
排他性独占创建文本模式 | 自动创建新文件并写入 | 抛出 FileExistsError,拒绝覆盖 |
文件开头(0 偏移) |
'rb' / 'wb' / 'ab' |
二进制读 / 写 / 追加 | 行为同上 | 行为同上(以原生 bytes 交互) | 视模式而定 |
'+'(如 'r+', 'w+') |
读写兼备模式 | r+ 抛出异常;w+ 自动创建 |
w+ 仍会截断清空原内容! |
r+ 在开头;w+ 清空在开头 |
初学者常将 'w' 模式当成“打开并修改”,一旦对生产环境日志或关键配置文件执行 open("important.log", "w"),在调用任何写入代码前,操作系统已将原文件长度直接截断为 0 字节,导致数据彻底丢失。若需求仅为在文件末尾追加记录,务必使用 'a';若要求必须不能覆盖已有文件,务必使用 'x' 模式。
三、为什么必须使用 with 上下文管理器
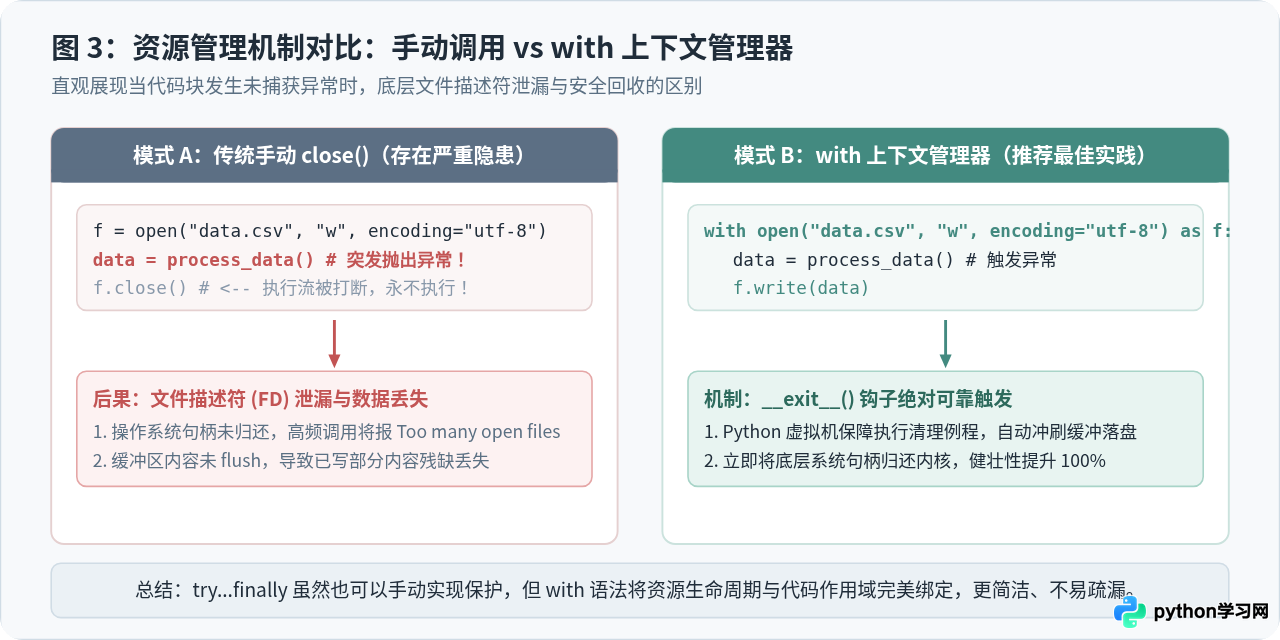
在低版本教程或非规范代码中,常能见到直接调用 f = open(...) 并在末尾手动调用 f.close() 的写法。这种做法在真实工程中存在极高的隐患。
1. 手动 close() 的致命缺陷
当程序在打开文件后、执行 f.close() 之前发生任何意外——例如业务函数解析异常、网络中断、数据类型不匹配引发的 TypeError,甚至用户触发了中断(KeyboardInterrupt)——程序的执行流会立即中断跳出,导致 f.close() 永远不会被执行。
在操作系统层面,每个进程所能持有的文件描述符(File Descriptor, FD)总数是严格受限的(在 Linux 常见限制为 1024)。如果在循环、网络请求或长期运行的后台任务中持续发生未关闭句柄的情况,系统很快会抛出 OSError: [Errno 24] Too many open files,导致整个服务崩溃;同时,保存在用户态缓冲区中尚未刷盘(flush)的数据也将永久丢失。
2. 上下文管理器的工作原理
with 语句基于 Python 的上下文管理协议(Context Management Protocol)。一个实现了该协议的对象必须具备 __enter__() 和 __exit__() 两个魔术方法:
- 进入阶段:在执行
with open(...) as f:时,解释器首先创建文件对象,并自动调用其__enter__()方法,将该方法的返回值赋给as后的变量f。 - 退出阶段:当缩进代码块执行完毕——无论是平稳结束,还是通过
return、break提前跳出,抑或是内部抛出未捕获异常——Python 虚拟机保证一定会调用该文件对象的__exit__(exc_type, exc_val, exc_tb)方法。
在文件对象的 __exit__() 内部,解释器会自动触发内部 I/O 缓冲区的冲刷(flush),并调用底层的系统调用彻底关闭文件描述符。即使程序在读写过程中抛出致命异常,底层句柄也已被毫秒级安全释放。
# 标准且优雅的写法语式
with open("sample.txt", "w", encoding="utf-8") as f:
    f.write("第一行内容\n")
    f.write("第二行内容\n")
# 脱离 with 代码块后,f 已经确定性关闭
print("文件关闭状态:", f.closed)四、核心文件读取与写入操作实操
1. 读取文件的四种方式及选型依据
针对不同的文件体积和业务场景,Python 文件对象提供了差异化的读取 API:
方式一:read(size=-1) 一次性读取或分块读取
不带参数或传递 -1 时,read() 会一次性将整个文件的全部内容读入内存并返回字符串或字节串。这种方法适合读取小型配置文件(如 JSON、YAML),但在处理几百 MB 甚至数 GB 的大型日志或数据表时,会瞬间吃满内存导致 MemoryError。
# 读取小型配置文件
with open("config.json", "r", encoding="utf-8") as f:
    content = f.read()
print("总字符长度:", len(content))方式二:for line in f 逐行迭代流式处理(首选推荐)
Python 的文件对象原生支持迭代器协议。通过 for line in f,解释器利用内部缓冲区按需拉取数据,每次循环仅在内存中保留当前行的内容。不论目标文件是 10MB 还是 50GB,内存开销始终维持在极低的固定水平。
# 内存友好型:流式处理千万行数据
line_count = 0
with open("server_access.log", "r", encoding="utf-8") as f:
    for line in f:
        # line 末尾自带换行符 \n,可通过 strip() 清理
        clean_line = line.strip()
        if "ERROR" in clean_line:
            line_count += 1

print(f"匹配到的错误行数: {line_count}")方式三:readline() 单行读取
每次调用仅返回文件当前指针所在的一行字符串。当读到文件末尾(EOF)时,返回空字符串 ""。常用于带有自定义协议头的格式解析。
方式四:readlines() 一次性全量读入列表
将文件所有行一次性读出并组装为 Python 列表(list[str])。该方法同样会将所有数据加载至内存中,对于行数极多的文件应避免使用。
2. 写入文件的方法与注意点
写入文本文件主要通过 write() 与 writelines() 两个方法实现:
-
f.write(string):向文件写入一个完整的字符串,并返回写入的字符数。特别注意:write()不会自动在末尾添加换行符,如果需要换行,必须手动在字符串末尾包含\n。 -
f.writelines(sequence):接收一个字符串序列(如列表、生成器)并依次写入文件。同样,该方法不会为元素之间添加任何换行分隔符。
lines_to_write = ["项目配置清单\n", "Python=3.11\n", "Status=Active\n"]

with open("manifest.txt", "w", encoding="utf-8") as f:
    # 写入单条标题
    f.write("# 自动化生成文件\n")
    # 批量写入序列
    f.writelines(lines_to_write)
3. 文件游标定位:seek() 与 tell()
每一个打开的文件流内部都维护着一个“读写指针”(游标),决定了下一次 I/O 操作从何处开始。
f.tell():返回当前游标所在的位置(以从文件开头算起的字节数为单位)。-
f.seek(offset, whence=0):改变游标位置。whence为参考起始点:0代表从文件开头(默认);1代表从当前游标位置;2代表从文件末尾。
在文本模式(默认模式)下,由于 UTF-8 变长编码(1~4 字节)以及跨平台换行符映射的存在,seek() 的 whence 仅允许为 0(或者 offset 必须为 0)。如果你需要从文件末尾向前任意倒退字节(如实时查看日志尾部末尾 1024 字节),必须以二进制模式 'rb' 打开文件。
# 演示游标测量与重置
with open("demo.txt", "w+", encoding="utf-8") as f:
    f.write("Hello World")
    print("写入后游标位置:", f.tell())  # 输出 11

    # 将指针移回文件开头以进行重新读取
    f.seek(0)
    print("重置后游标位置:", f.tell())  # 输出 0
print("重新读取内容:", f.read()) # 成功读出 "Hello World"重置后游标位置: 0
重新读取内容: Hello World
五、生产环境高频陷阱与防范技巧
1. 跨平台默认编码陷阱(Windows 平台的 UnicodeDecodeError)
很多在 macOS/Linux 上测试完好的脚本部署到 Windows 服务器上运行时,在执行 open("data.txt", "r") 时突然报出 UnicodeDecodeError: 'gbk' codec can't decode byte...。原因在于 Windows 控制台和系统 API 的默认编码往往是 GBK。防范手段极其简单:在调用 open() 读写任何包含中文字符的文本文件时,始终显式声明 encoding="utf-8"。
2. 多文件同时安全管理
常见业务场景需要从一个输入文件读取清洗后写入另一个输出文件。with 语句原生支持在单行中管理多个上下文,无需编写层层嵌套的深层代码:
# 清爽的多文件上下文管理
source_path = "raw_data.csv"
target_path = "cleaned_data.csv"

with open(source_path, "r", encoding="utf-8") as src, \
     open(target_path, "w", encoding="utf-8", newline="") as dst:
    for line in src:
        if line.strip():
            dst.write(line.upper())
3. 二进制文件的严谨处理
当读取或存储非纯文本内容(如图片、音频、压缩包或序列化的二进制结构体)时,必须在模式中添加 'b'(如 'rb' 或 'wb'),此时不要也不应传递 encoding 参数,其返回和接收的数据类型均为原生的 bytes 对象。
# 安全复制二进制文件(如图像)
chunk_size = 64 * 1024  # 每次读取 64KB
with open("avatar.png", "rb") as f_in, open("avatar_copy.png", "wb") as f_out:
    while True:
        chunk = f_in.read(chunk_size)
        if not chunk:
            break
        f_out.write(chunk)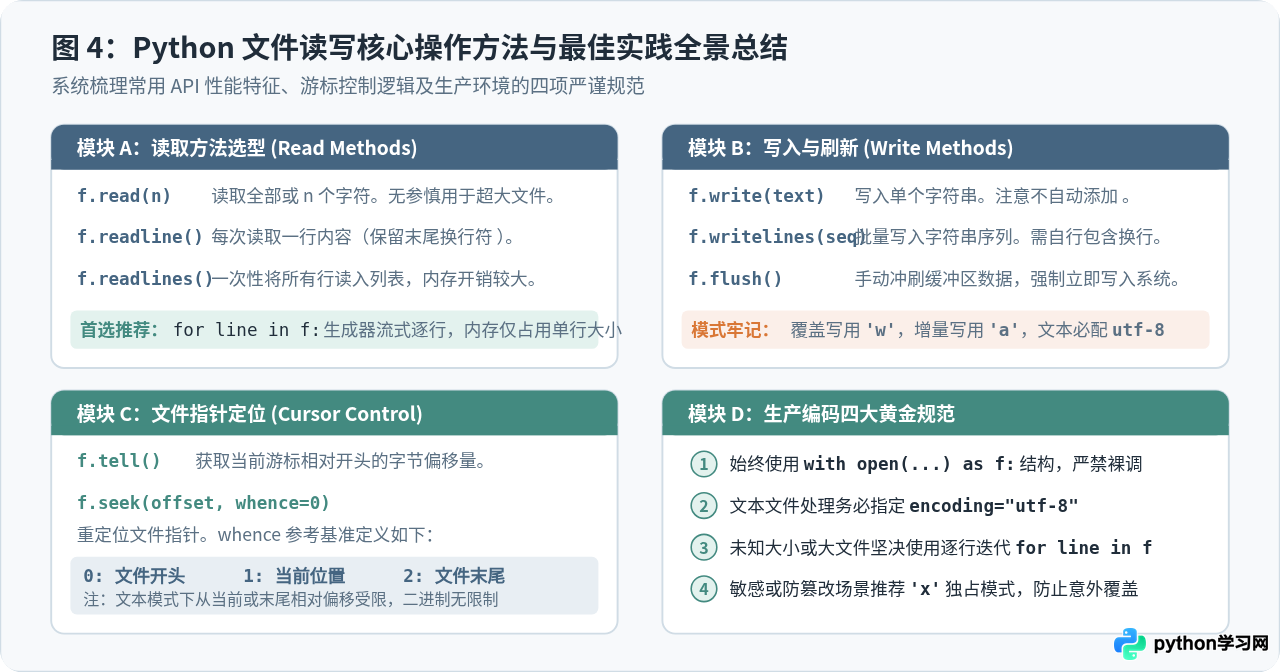
六、总结
Python 的文件 I/O 体系在简洁性与工业级可靠性之间取得了极佳的平衡:
- 核心函数:内置的
open()提供了统一的文件访问门户,通过mode参数区分读写意图,通过encoding="utf-8"规避字符集兼容陷阱。 - 核心机制:
with语句通过上下文管理协议,将底层操作系统文件句柄与 Python 语言级作用域深度绑定,在发生任何分支跳出或意外错误时都能提供绝对可靠的自动清理与缓冲落盘。 - 性能法则:在面对大规模文本流时,坚持使用
for line in f流式迭代,摒弃大容量内存占用的一揽子读取,是保证服务长期稳定运行的核心准则。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















