


Python内置函数与标准库函数有什么区别?
深入对比Python内置函数与标准库函数的本质区别,涵盖导入机制、LEGB作用域查找路径、底层实现、内存与性能权衡,以及开发中的常见踩坑防范。
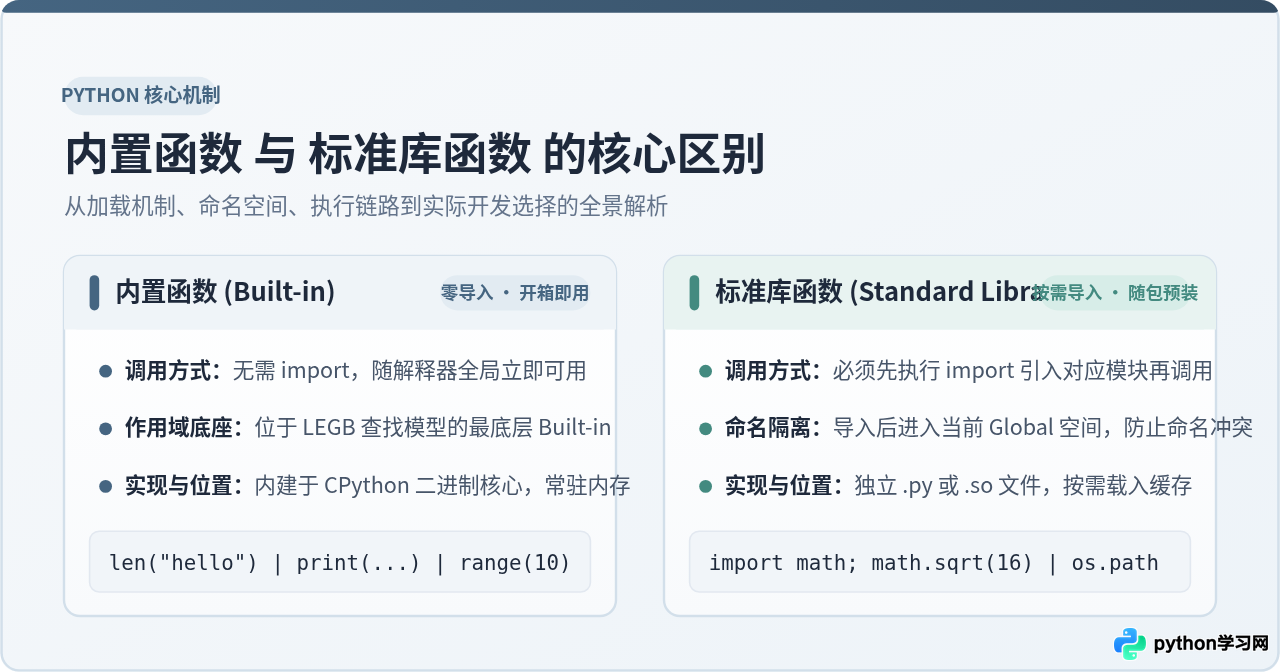
import 即可在代码任意位置直接调用(例如 len()、print()、range());而标准库函数(Standard Library Functions)则是随 Python 安装包附带、官方维护但按功能领域划分在各个独立模块中的工具集,使用前必须先执行 import 显式导入对应模块(例如 math.sqrt()、os.path.join()、json.loads())。
一、概念界定与调用语法的直观差异
很多 Python 初学者容易将“Python 自带的函数”统称为内置函数,实际上 Python 对系统自带能力的组织具有严格的层次划分。这种划分直接反映在开发者的代码书写习惯上:
1. 内置函数(Built-in Functions):它们隶属于 Python 的 builtins 模块。在 Python 进程启动时,该模块的内容就已经直接注入到了运行时的最外层全局命名空间中。这类函数解决的是最通用、最高频的基础语言操作,例如求长度 len()、打印输出 print()、类型转换 int()、构造迭代范围 range()、求和 sum() 等。
2. 标准库函数(Standard Library Functions):Python 践行“自带电池”(Batteries Included)的设计哲学,在安装 Python 环境时便附带了覆盖数学计算、操作系统交互、网络通信、数据序列化等数百个官方维护的模块。为了避免成千上万的专用函数占用无谓内存、避免与开发者自己的变量命名发生冲突,标准库函数被整齐地隔离在独立的 .py 脚本或底层动态库模块中,必须显式导入后才能调用。
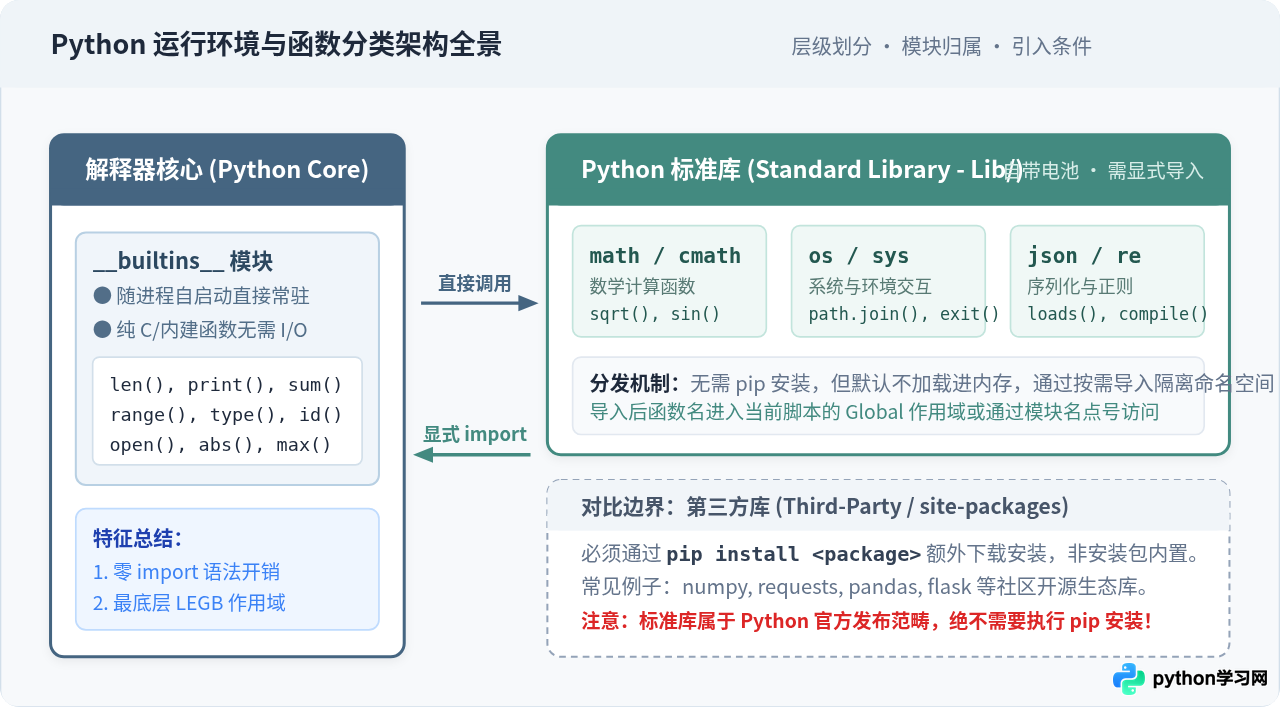
通过下方简洁的代码对比,可以直接观察到两者的使用差异:
# 示例 1:内置函数的调用(开箱即用,无需任何导入)
text = "hello, python"
total_length = len(text)          # 直接调用内置函数 len()
print(f"字符串长度为: {total_length}") # 示例输出: 字符串长度为: 13

# 示例 2:标准库函数的调用(随解释器自带,但必须先 import 才能使用)
import math                      # 第一步:显式导入标准库 math 模块

root_val = math.sqrt(16)         # 第二步:通过模块名前缀调用其函数
print(f"平方根计算结果: {root_val}")   # 示例输出: 平方根计算结果: 4.0
如果在未执行 import math 的情况下直接调用 sqrt(16),Python 解释器会立即抛出 NameError: name 'sqrt' is not defined 异常。这正是两者的首要边界。
二、作用域查找与执行链路的步骤解析
为什么内置函数可以“凭空”直接调用,而标准库函数不行?这涉及到 Python 解释器查找变量和函数的 LEGB 查找模型(Local → Enclosing → Global → Built-in)以及模块加载机制。
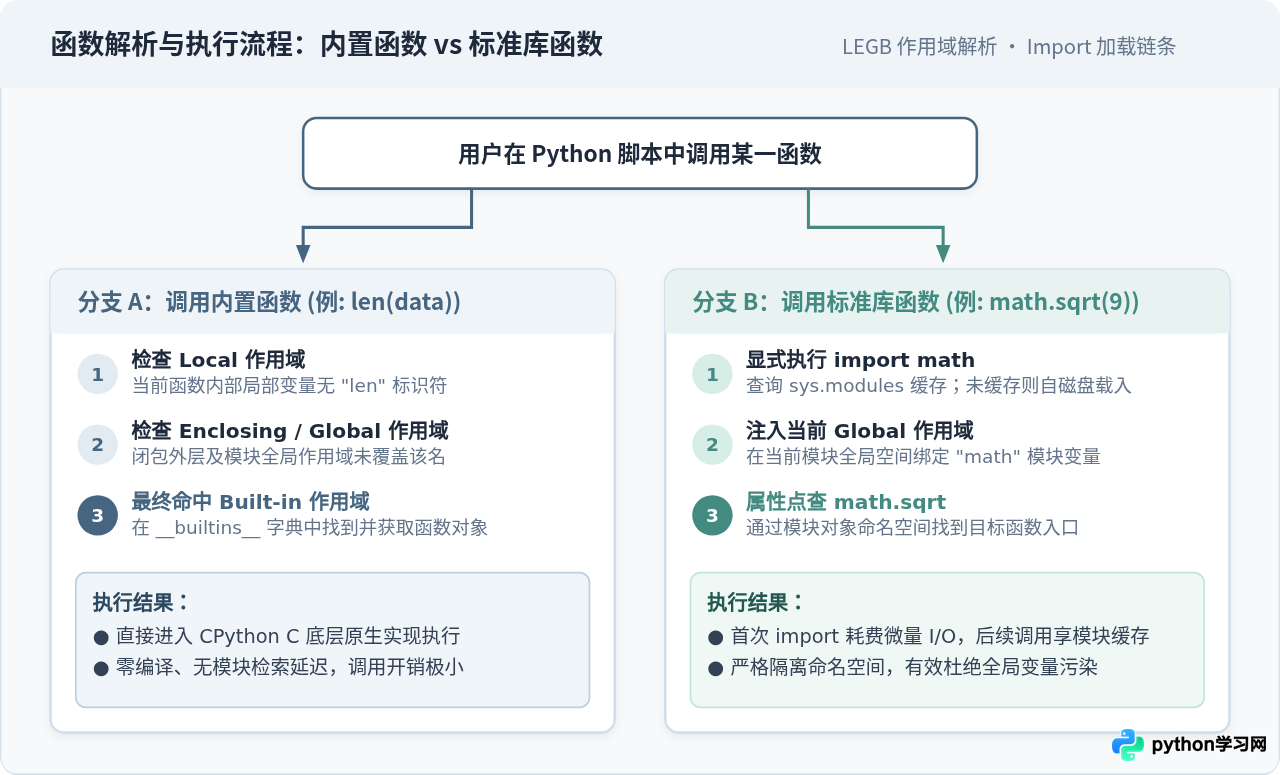
从代码执行到函数被调起,解释器分别经历以下具体步骤:
1. 内置函数的解析步骤(LEGB 兜底命中)
- 检查 Local 局部空间:当前函数栈帧内是否存在同名的局部变量或参数定义;若无,进入下一级。
- 检查 Enclosing 嵌套空间:闭包函数的外层函数作用域中是否存在该名称;若无,继续向上排查。
- 检查 Global 全局空间:当前脚本模块的全局字典(
globals())中是否存在该变量;若未定义,进入最后一级。 - 命中 Built-in 内置空间:解释器在底层的
builtins字典中进行最终检索,成功命中对应函数对象(如len)并立即由 C 底层执行。
2. 标准库函数的导入与加载步骤(Import 注册机制)
- 查询模块缓存:当执行
import math时,Python 首先在sys.modules字典中查找该模块是否已加载。 - 磁盘定位与载入:若未缓存,解释器在标准库预设目录(Python 安装路径下的
Lib/目录或编译好的动态库)中定位math文件,将其编译执行并生成模块对象。 - 注入当前作用域:在当前脚本的
globals()字典中新增一个名为math的键,值指向该模块对象。 - 属性访问调用:通过
math.sqrt(9)语法点查模块命名空间,找到sqrt函数指针并执行。若使用from math import sqrt,则是直接把sqrt符号绑定到当前脚本的 Global 命名空间中。
三、底层实现、内存占用与性能设计的深层取舍
理解了语法和作用域之后,一个自然产生的疑问是:既然标准库也是随 Python 官方发行版一起附带的,为什么官方不把所有标准库函数都做成内置函数?
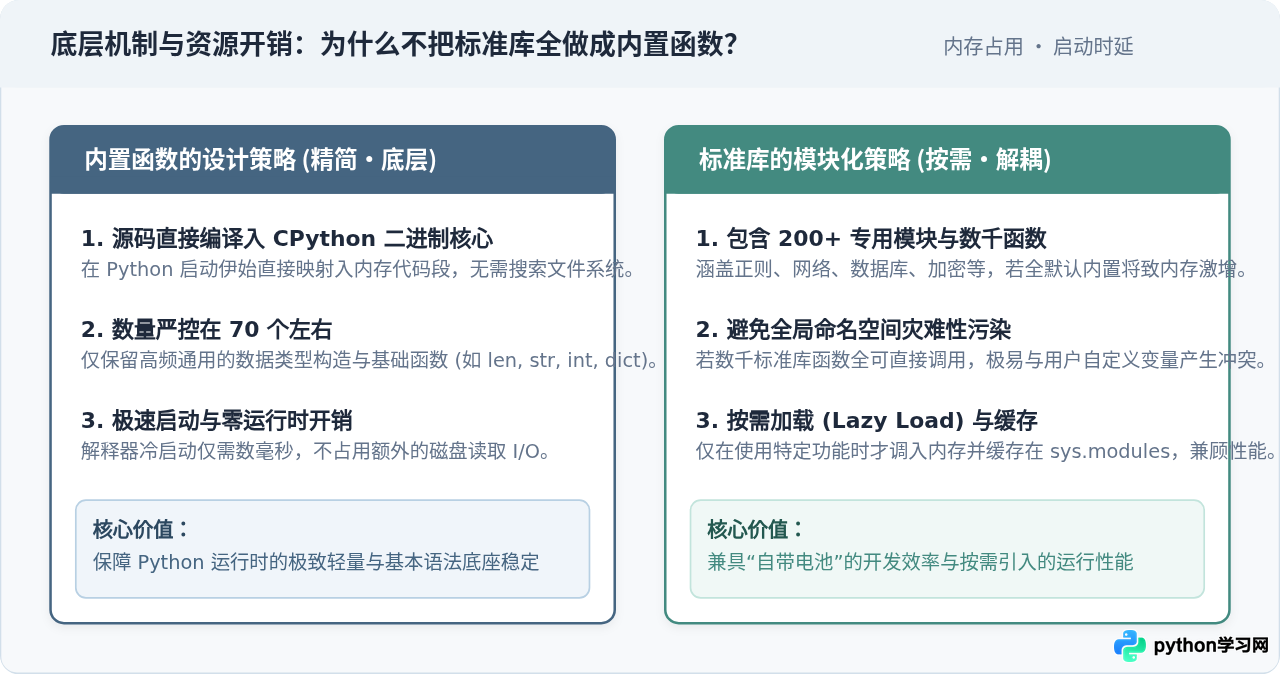
这背后是 Python 核心团队在运行性能、内存占用与命名空间纯洁性上的核心设计取舍:
1. 内存占用与冷启动时间:CPython 解释器的核心定位是“轻量快捷”。当前 Python 的内置函数大约只有 70 多个,它们直接用 C 语言编写并紧密编译在 CPython 可执行二进制文件中(例如 CPython 源码中的 Python/bltinmodule.c)。解释器启动时直接映射常驻,启动耗时仅数毫秒。相反,标准库包含了 200 多个独立模块和数千个函数(涵盖网络通信 http、数据库 sqlite3、加密 hashlib、压缩 zipfile 等)。若启动时全量载入,解释器的启动延迟将严重拖慢,进程的初始内存开销也会急剧膨胀数倍。
2. 命名空间污染(Namespace Pollution):如果在任何脚本里都能直接敲出一个函数名,数千个标准库函数将彻底淹没开发者的命名选择。例如 time、copy、random、path 等极常见词汇都将成为隐式系统函数。通过“模块名.函数名”的层级划分,使得命名冲突的概率降到了最低。
3. 底层实现方式的差异:内置函数几乎 100% 由纯 C 原生实现,直接操作底层 CPython 对象结构,执行效率处于最顶层;而标准库则是“混合实现”,部分追求性能的核心组件(如 math、json、itertools)由 C 扩展模块编写,而更多上层业务模块(如 http.server、statistics、unittest)则是用规范的 Python 纯代码写成。
四、常用函数的查看方法与开发避坑指南
在日常开发中,我们可以利用 Python 解释器自带的反射和交互能力,清晰地查看当前环境包含的内置函数与标准库模块。
1. 动态查看内置函数与标准库清单
# 查看 Python 环境中的所有内置函数和内置异常(通常包含 70 余个核心对象)
import builtins
all_builtins = [name for name in dir(builtins) if not name.startswith("__")]
print("前 8 个内置成员:", all_builtins[:8])
# 示例输出: 前 8 个内置成员: ['ArithmeticError', 'AssertionError', 'AttributeError', 'BaseException', 'BlockingIOError', 'BrokenPipeError', 'BufferError', 'BytesWarning']

# 查看 Python 3.10+ 标准库模块列表(示例前 6 个)
import sys
if hasattr(sys, "stdlib_module_names"):
    stdlib_samples = sorted(list(sys.stdlib_module_names))[:6]
    print("标准库模块样本:", stdlib_samples)
    # 示例输出: 标准库模块样本: ['__future__', '_abc', '_aix_support', '_ast', '_asyncio', '_bisect']
2. 开发中必须警惕的 3 个常见误区
由于 LEGB 规则中 Global 作用域优先于 Built-in 作用域,如果在当前作用域中给内置函数名赋值,会导致内置函数无法正常使用:
# 错误示范:自定义变量名使用了内置函数名 sum
sum = [10, 20, 30]

# 当后续尝试计算列表和时,将引发异常:
# total = sum([1, 2, 3])
# 报错示例: TypeError: 'list' object is not callable

# 正确做法:变量命名应具体明确,如 number_list,切忌使用 list, dict, str, max, min, sum 作为变量名
陷阱 2:误将标准库当作第三方库使用 pip 安装
许多初学者在处理文件路径或正则时,会下意识地在终端输入 pip install os 或 pip install json。终端会直接报错找不到相关包。记住:只要是 Python 官方标准库模块(如 os、sys、re、json、sqlite3、datetime),系统均已预装,只需在代码中写 import 即可。
陷阱 3:滥用 from 模块 import * 导入全部函数
例如执行 from math import * 会将 math 模块下的数十个函数全量复制进当前全局命名空间。这不仅破坏了模块隔离的初衷,还可能意外覆盖当前已经存在的同名变量或内置函数。推荐规范采用 import math 随后使用 math.sqrt(),或者精准导入 from math import sqrt。
五、核心特征总结矩阵与选择建议
为了方便快速回顾与对照,下表梳理了内置函数与标准库函数在核心维度的主要特征:
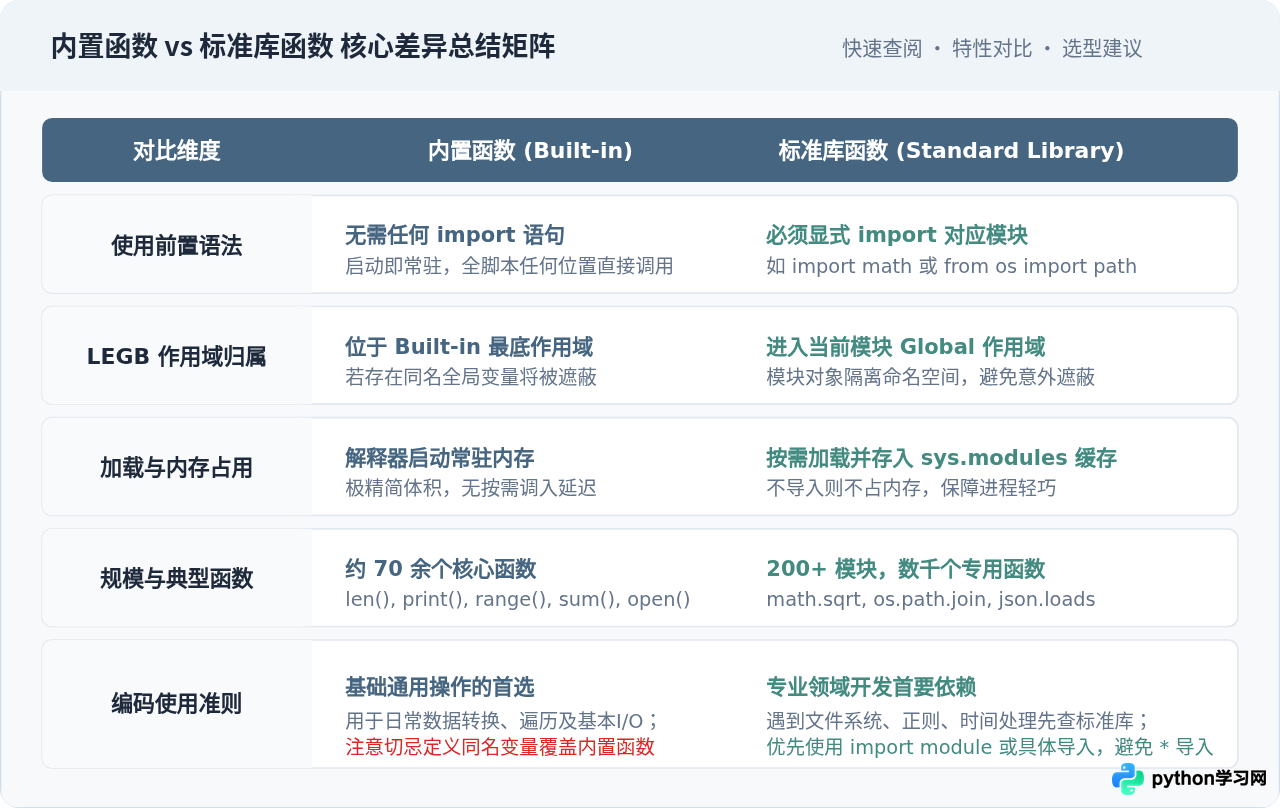
| 比较维度 | 内置函数 (Built-in Functions) | 标准库函数 (Standard Library Functions) |
|---|---|---|
| 前置语法 | 无需 import,全脚本直接可用 |
必须显式 import 模块名 后方可调用 |
| 所在作用域 | 最外层的 builtins 作用域 |
导入后进入当前脚本的 Global 作用域 |
| 底层宿主 | 直接内嵌于 CPython C 二进制核心中 | 以 Lib/ 目录下的 .py 脚本或动态链接库形式存在 |
| 安装与依赖 | 随解释器自带,零依赖 | 随 Python 发行版预装,无需 pip 安装 |
| 典型代表 | len(), print(), range(), sum(), open() |
math.sqrt(), os.path.join(), json.dumps() |
| 选型原则 | 高频基础操作首选;警惕变量名覆盖遮蔽 | 专业领域(正则/文件/数学/时间)首选,按需导入 |
在日常 Python 编程实践中,对于基本数据结构的操作和类型转换,优先使用经过极致优化的内置函数;当面对特定领域任务(例如文件与路径操作、时间计算、正则匹配、网络通信)时,首要反应应该是翻阅 Python 官方标准库文档寻找对应模块,而不是盲目通过 pip 安装冗余的第三方依赖。这样编写出的代码既轻量标准,又具备出色的跨平台稳定性与运行效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















