


不用第三方库怎么手动实现Python列表重复值检测
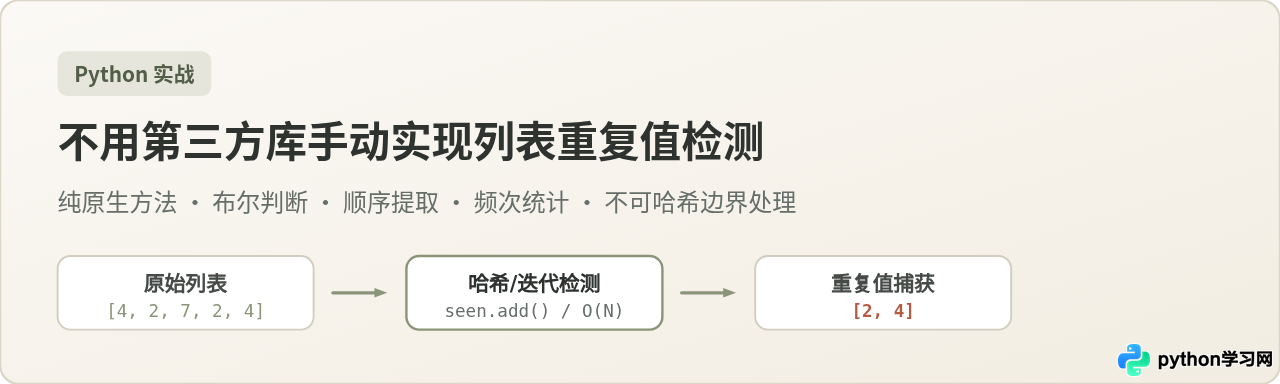
详细讲解在不借助第三方库的前提下,使用Python原生数据结构与算法手动实现列表重复值检测,涵盖快速布尔判断、顺序提取重复元素、频次统计及不可哈希复杂对象的边界处理。
在 Python 中检测列表是否存在重复元素,核心答案取决于具体的业务目标:若仅需得知“是否有重复”,利用原生 set() 的去重特性比对长度是最快的方式(平均时间复杂度为 \(O(N)\));若需要“提取具体哪些元素重复”且保持原始出现次序,应当使用遍历配合辅助集合;若还需要统计“每个重复值出现了几次”,则使用原生字典进行频次累加。对于包含嵌套列表或字典等不可哈希对象的列表,则需通过双重循环比对或键转换来规避类型错误。
一、仅判断是否存在重复(布尔值检测)
当只需要对数据进行基础校验(例如验证用户提交的 ID 列表是否完全唯一)时,并不需要耗费内存去记录每个重复值的位置。最直接且高效的方法是直接比对原列表与转换为集合后的长度:
# 布尔快速检测函数
def has_duplicates(items):
    return len(items) != len(set(items))

# 示例调用
raw_list_a = [10, 25, 30, 25, 40]
raw_list_b = [1, 2, 3, 4, 5]

print(has_duplicates(raw_list_a))  # 输出示例: True
print(has_duplicates(raw_list_b)) # 输出示例: False执行原理:Python 的集合(set)底层基于哈希表实现,集合元素具备唯一性。向集合中插入重复元素时,哈希碰撞检测会直接丢弃重复值。因此,如果原始列表包含重复项,转为集合后的元素个数必定小于原列表长度。
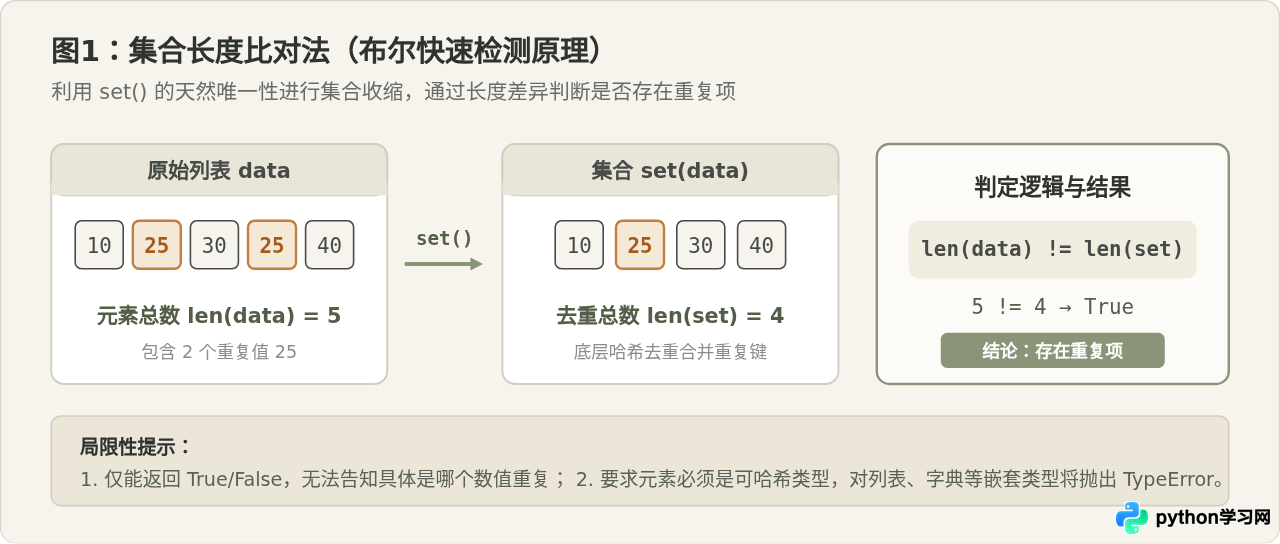
初学者常将 len(data) != len(set(data)) 视为万能方案。这种说法在元素为数值、字符串或元组等可哈希对象时确实最高效,但它存在两个不可忽视的局限:第一,它是一次性将整个列表全量载入内存构建集合,若列表在第 2 个元素处就已经出现重复,它仍会扫描完剩余的所有百万级数据,无法实现短路返回;第二,它无法告知到底哪一个值重复了;第三,一旦列表元素包含子列表(如 [[1, 2], [1, 2]]),会直接触发 TypeError: unhashable type: 'list' 异常。
如果希望在遇到第一个重复值时立即中断退出以提高超大列表的处理效率,可手动编写生成器短路逻辑:
def has_duplicates_early_stop(items):
    seen = set()
    for item in items:
        if item in seen:
            return True
        seen.add(item)
    return False
二、提取所有重复出现的元素(保持原序与唯一性)
在数据清洗场景中,往往需要确切知道究竟是哪些数据重复了,并且通常希望输出结果中每个重复项只出现一次,并尽可能保留在原列表中首次重复的次序。
实现该目标的高效方式是“单遍扫描 + 辅助集合记录”:使用一个集合 seen 记录已经遇见的元素,使用另一个列表 duplicates 记录被检测出的重复项。为了保证向 duplicates 列表中添加元素时也具备 \(O(1)\) 的查重效率,可以同时使用一个辅助集合 dup_set:
def find_duplicates(items):
    seen = set()
    dup_set = set()
    duplicates = []

    for item in items:
        if item in seen:
            # 元素已见过且尚未记录进结果列表
            if item not in dup_set:
                dup_set.add(item)
                duplicates.append(item)
        else:
            seen.add(item)

    return duplicates

# 示例调用
sample = [4, 2, 7, 2, 4, 9, 2]
result = find_duplicates(sample)
print(result)  # 输出示例: [2, 4]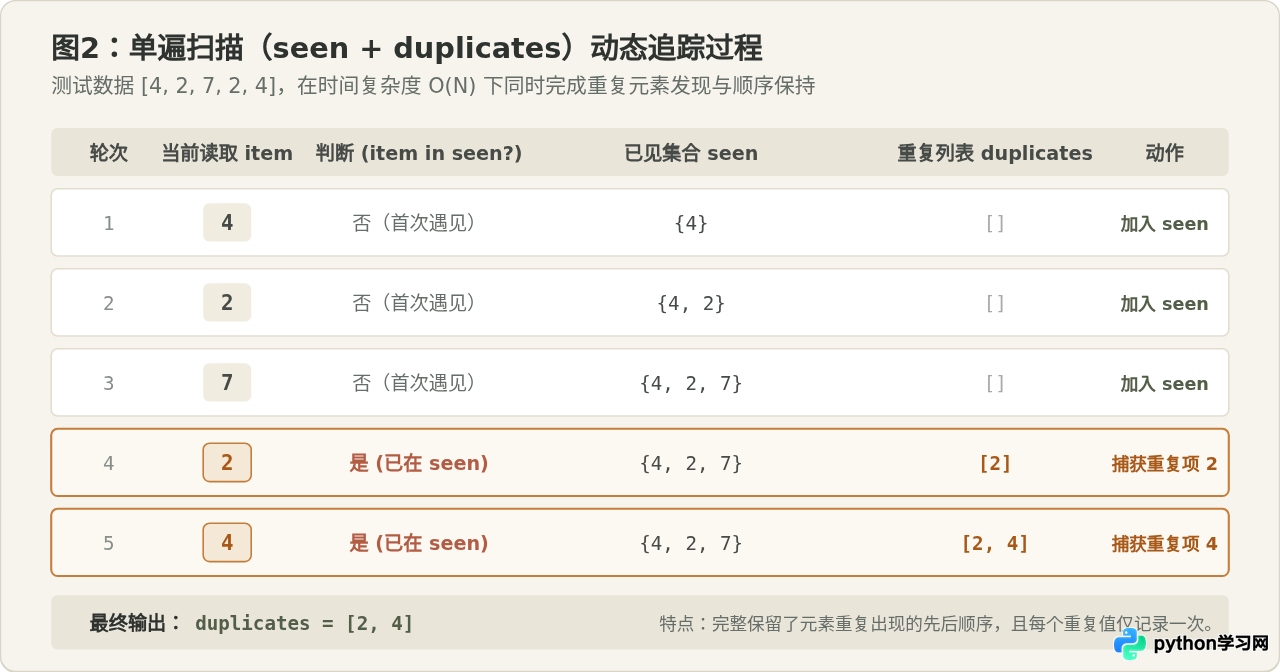
复杂度分析:该算法仅对原列表进行一次从头到尾的线性遍历(\(N\) 次迭代)。每次循环中,集合的 in 查询与 add 操作在哈希表上的平均时间复杂度为 \(O(1)\),因此整体时间复杂度为严格的 \(O(N)\);空间复杂度为 \(O(N)\),用于存储 seen 和 dup_set 中的元素引用。
三、统计每个元素的重复频次(纯原生字典实现)
如果不允许导入标准库的 collections.Counter,使用 Python 原生内置字典(dict)结合 dict.get() 方法同样能够以极精简的代码完成各元素的频次统计与重复过滤:
def count_duplicate_frequencies(items):
    counts = {}
    for item in items:
        # 若键不存在则初始值为0,随后自增1
        counts[item] = counts.get(item, 0) + 1

    # 字典推导式:只筛选频次大于1的键值对
    return {k: v for k, v in counts.items() if v > 1}

# 示例调用
data = ["apple", "banana", "apple", "orange", "banana", "apple"]
freq_result = count_duplicate_frequencies(data)
print(freq_result)  # 输出示例: {'apple': 3, 'banana': 2}
在 Python 3.7+ 规范中,原生字典已正式保证键的插入顺序。因此,通过字典推导式筛选出来的重复项字典,不仅明确给出了每个键重复出现的总次数,而且键的顺序完全契合它们在原列表中首次出现的相对位置。
四、常见陷阱:不可哈希对象(列表、字典嵌套)的处理
上述基于集合与字典的方法都依赖一个根本前提:列表中的元素必须是可哈希(hashable)对象。在实际业务中,我们经常遇到类似 [[1, 2], [3, 4], [1, 2]] 或列表内嵌字典的数据,此时直接调用 set() 会抛出经典错误:
nested = [[1, 2], [3, 4], [1, 2]]
# 触发异常:TypeError: unhashable type: 'list'
set(nested)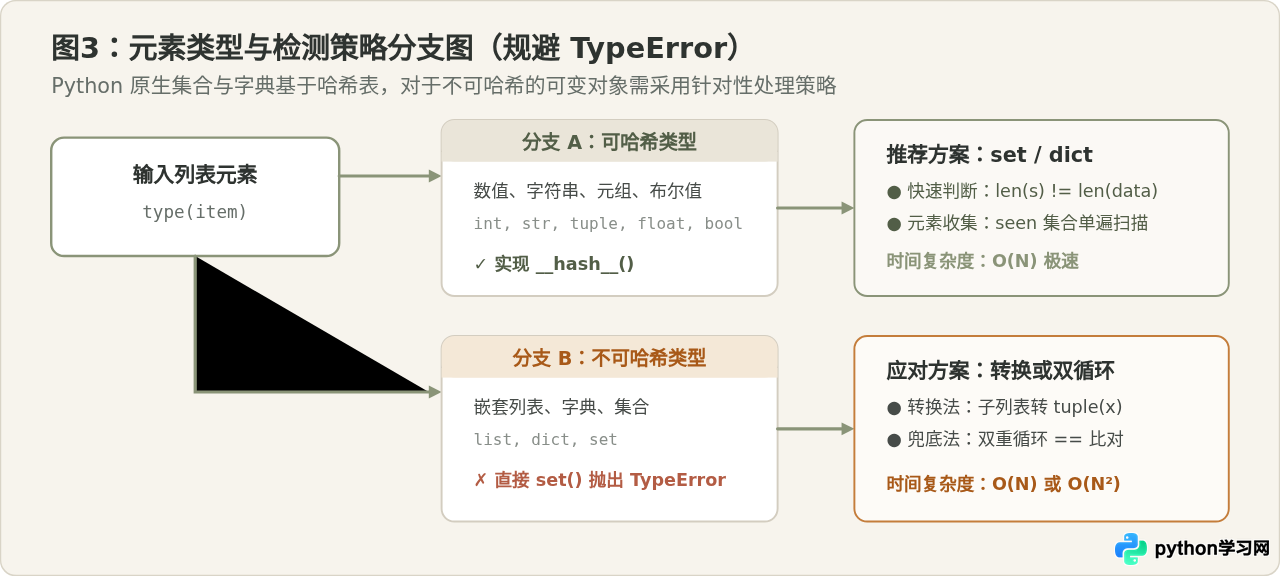
策略 1:结构可转换时的元组降维法(维持 O(N))
如果不可哈希元素是子列表或子元组嵌套,可以通过在检测时临时将其转换为不可变的 tuple:
def find_duplicates_nested_list(items):
    seen = set()
    duplicates = []
    dup_set = set()

    for sublist in items:
        # 转换为不可变元组作为哈希键
        key = tuple(sublist)
        if key in seen:
            if key not in dup_set:
                dup_set.add(key)
                duplicates.append(sublist)
        else:
            seen.add(key)
    return duplicates

nested_data = [[1, 2], [3, 4], [1, 2], [5, 6]]
print(find_duplicates_nested_list(nested_data))  # 输出示例: [[1, 2]]
策略 2:任意复杂对象的双重循环比对法(无需哈希)
当元素包含字典或无法直接简单转换为元组的多层深层嵌套结构时,可以使用纯粹的双重循环依靠 Python 对象的 == 等值比较。虽然其时间复杂度升至 \(O(N^2)\),但在无需第三方依赖、数据规模较小时(百条至千条内),通用性与稳健性最高:
def find_duplicates_unhashable(items):
    duplicates = []
    n = len(items)

    for i in range(n):
        target = items[i]
        # 检查是否已经被收入 duplicates,避免重复收集
        already_added = False
        for d in duplicates:
            if d == target:
                already_added = True
                break
        if already_added:
            continue

        # 扫描后续元素是否存在等值对象
        for j in range(i + 1, n):
            if items[j] == target:
                duplicates.append(target)
                break

    return duplicates

dict_list = [{"id": 1, "name": "alpha"}, {"id": 2, "name": "beta"}, {"id": 1, "name": "alpha"}]
print(find_duplicates_unhashable(dict_list))
# 输出示例: [{'id': 1, 'name': 'alpha'}]
五、方案选型与性能权衡全景
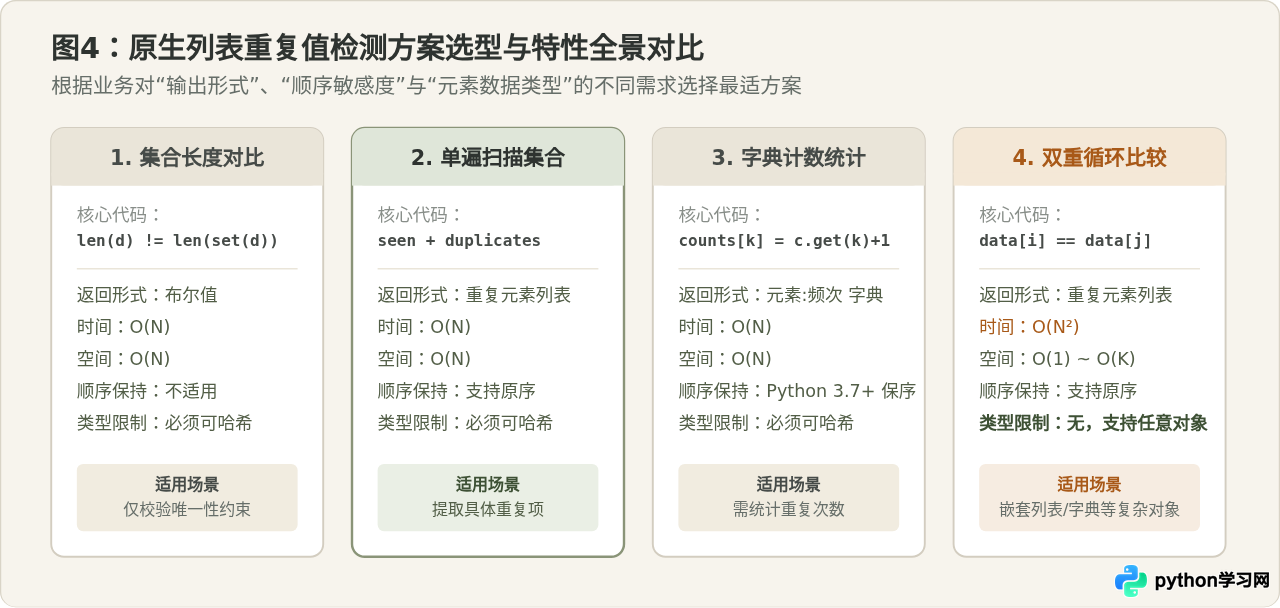
为了在实际编码中快速选择最合理的实现方式,下表对四种原生检测方案的核心维度进行了系统归纳:
| 实现方案 | 主要手段 | 时间复杂度 | 空间复杂度 | 输出形式 | 适用对象与场景 |
|---|---|---|---|---|---|
| 1. 集合长度对比 | len(data) != len(set(data)) |
\(O(N)\) | \(O(N)\) | bool |
可哈希类型;仅需判断唯一性 |
| 2. 辅助集合单遍扫描 | seen 集合 + 列表记录 |
\(O(N)\) | \(O(N)\) | list |
可哈希类型;需提取重复项且保序 |
| 3. 原生字典计数 | dict.get() 频次聚合 |
\(O(N)\) | \(O(N)\) | dict |
可哈希类型;需统计重复次数 |
| 4. 双重嵌套等值遍历 | items[i] == items[j] |
\(O(N^2)\) | \(O(1) \sim O(K)\) | list |
任意类型(含列表、字典嵌套);中小型数据 |
六、实现总结与开发建议
在不引入外部库的前提下,处理 Python 列表重复检测主要把握以下三个核心原则:
- 优先依托哈希表实现:Python 内置的
set和dict是高度优化的 C 语言层实现,只要元素类型可哈希,无论采用len()快速对比还是seen单遍收集,都能获得近乎线性的最高执行性能。 - 防御不可哈希类型:在处理外部接收到的未知结构数据(如解析 JSON 得到的列表)时,应预先预判数据项是否可能为
list或dict。若可能存在复杂结构,优先采用结构转元组或者等值双循环方案,避免线上触发TypeError。 - 克制使用低效写法:避免在遍历过程中使用
data.count(item) > 1进行过滤。因为data.count()本身每次执行都是 \(O(N)\) 扫描,外层再套循环会导致原本简单的检测退化为 \(O(N^2)\) 性能瓶颈。采用字典一次性统计后再做推导筛选,才是原生 Python 最地道、兼顾可读性与效率的实践。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















