


Python用pandas将Excel数据转为字典列表
介绍如何使用 Python 中的 pandas 库将 Excel 表格数据高效转换为字典列表(list of dicts),包含核心代码、orient 参数选择、空值 NaN 与日期处理以及结果验证。
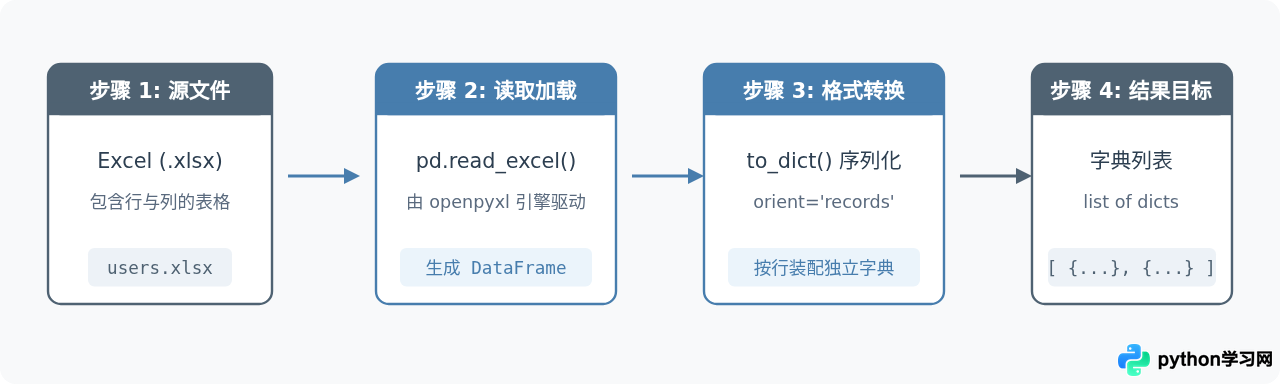
使用 Python 将 Excel 数据转为字典列表,最直接有效的路径是利用 pandas 读取工作表生成 DataFrame,随后调用 df.to_dict(orient='records')。这行代码会将表格的每一行数据映射为一个由列名作为键、单元格内容作为值的独立字典,最终组合为符合 JSON 标准格式的字典列表。
准备工作与环境依赖
pandas 默认依赖底层的解析引擎读取 .xlsx 格式的 Excel 文件。在开始转换前,需要确保运行环境中安装了 pandas 和 openpyxl。若尚未安装,可以在终端或命令行中执行以下命令:
pip install pandas openpyxl
完成依赖安装后,准备一个示例 Excel 文件(例如命名为 users.xlsx)。假定表格中包含三列:user_id、name、city。
核心操作:使用 read_excel 与 to_dict 转换
完成准备后,即可通过两行核心逻辑完成转换。以下为执行转换的基础脚本代码:
import pandas as pd

# 1. 读取 Excel 文件中的目标工作表
df = pd.read_excel('users.xlsx', sheet_name=0)

# 2. 将 DataFrame 转为字典列表
records_list = df.to_dict(orient='records')

# 打印转换结果示例
print(records_list)
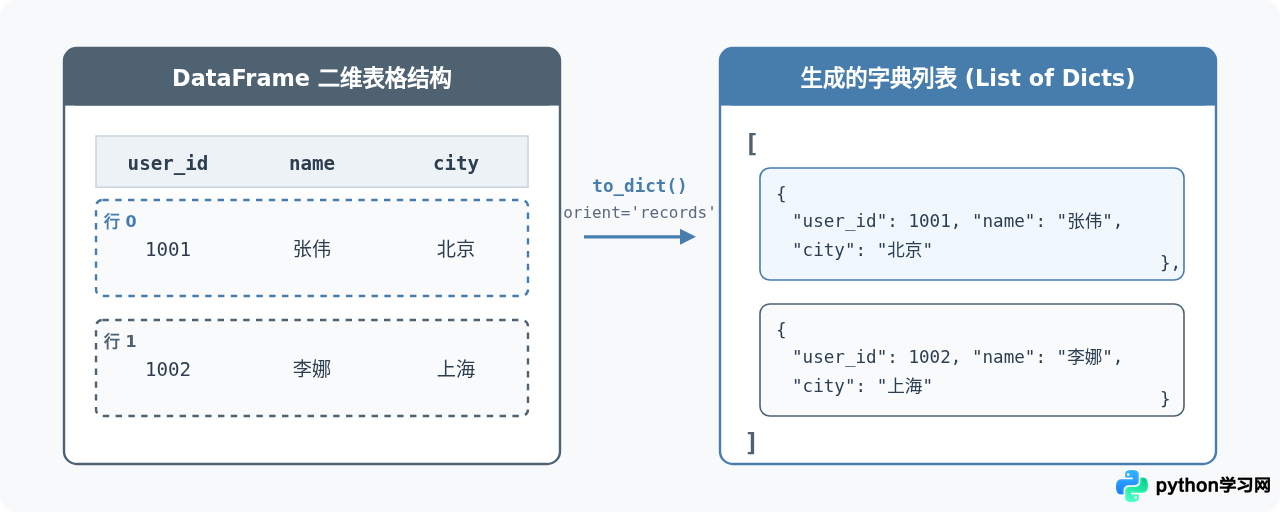
假设 users.xlsx 中有如下两行数据:
| user_id | name | city |
|---|---|---|
| 1001 | 张伟 | 北京 |
| 1002 | 李娜 | 上海 |
代码运行后输出的 records_list 结构如下:
[
    {"user_id": 1001, "name": "张伟", "city": "北京"},
    {"user_id": 1002, "name": "李娜", "city": "上海"}
]
原理剖析:orient 参数的作用与映射机制
pandas.DataFrame.to_dict 方法提供了 orient 参数,用于定义二维表格如何映射为字典。默认情况下,orient='dict' 会以列名为外层键、行索引为内层键生成嵌套字典;而当指定 orient='records' 时,pandas 才会以每行为粒度,将列名与单元格数据逐对打包成字典,并用标准 Python 列表将它们包裹起来。
进阶处理:缺失值、日期与指定列
在实际生产业务中,Excel 表格常包含空单元格、特殊时间字段或冗余列。若直接进行转换,可能会引发类型不符合预期或 JSON 序列化异常等问题。
1. 空值(NaN)的替换与兼容
Excel 中的空白单元格被 pandas 读取后,默认会标记为浮点型的 NaN(Not a Number)。在 Python 原生字典中,float('nan') 无法被标准 json.dumps() 正常转为 null,甚至在下游接口中抛出异常。常见的处理方式是在转换前进行清洗:
# 方案 A: 将所有 NaN 替换为 None(在 JSON 中对应 null)
df_clean = df.where(pd.notnull(df), None)
result = df_clean.to_dict(orient='records')

# 方案 B: 将所有 NaN 替换为空字符串
df_clean = df.fillna('')
result = df_clean.to_dict(orient='records')
2. 日期与时间格式的规范化
Excel 中的日期列读取后为 pd.Timestamp 类型。若要将数据用于 HTTP 接口或纯文本展示,建议在转换前先将其格式化为标准字符串:
# 将 'birthday' 列格式化为 YYYY-MM-DD 字符串
df['birthday'] = df['birthday'].dt.strftime('%Y-%m-%d')
result = df.to_dict(orient='records')
3. 按需读取指定列与行
当 Excel 数据量很大时,无需加载整张表。通过 usecols 参数可以在读取阶段就完成过滤,减少内存占用:
# 仅读取 'user_id' 和 'name' 两列
df = pd.read_excel('users.xlsx', usecols=['user_id', 'name'])
result = df.to_dict(orient='records')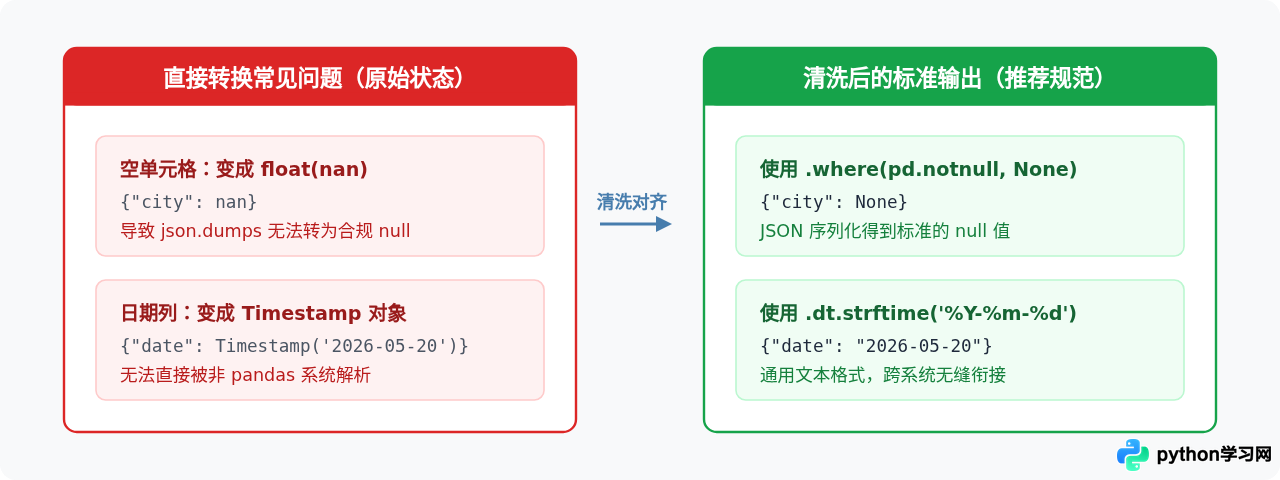
完整代码模板与结果验证
综合上述步骤与异常处理,以下是一套结构完整、可以直接运行在生产脚本中的范式代码:
import json
import pandas as pd

def excel_to_dict_list(excel_path, sheet_name=0):
    # 1. 载入 Excel 数据
    df = pd.read_excel(excel_path, sheet_name=sheet_name)

    # 2. 将缺失值替换为 Python 原生 None
    df = df.where(pd.notnull(df), None)

    # 3. 对日期类型列统一转为字符串(根据实际列名按需启用)
    for col in df.select_dtypes(include=['datetime', 'datetimetz']).columns:
        df[col] = df[col].dt.strftime('%Y-%m-%d %H:%M:%S')

    # 4. 转换并返回字典列表
    return df.to_dict(orient='records')

# 验证输出
if __name__ == '__main__':
    data = excel_to_dict_list('users.xlsx')
    # 验证列表长度及第一项的类型
    print(f"解析成功,总条数: {len(data)}")
    if data:
        print(f"首行记录类型: {type(data[0])}")
        print(f"首行内容: {json.dumps(data[0], ensure_ascii=False, indent=2)}")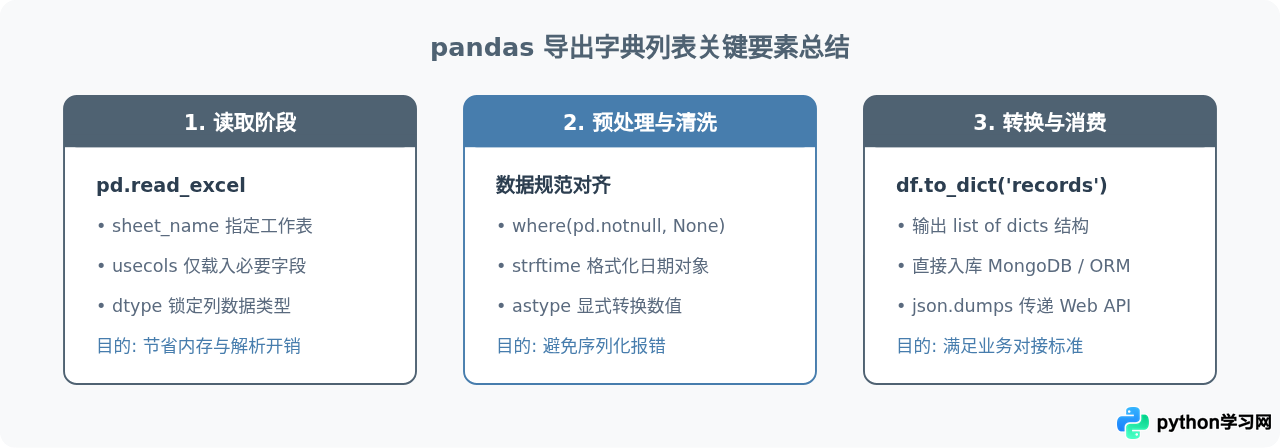
注意事项与常见误区
- 不要忽略 openpyxl 引擎依赖:从较新版本的 pandas 开始,直接调用
pd.read_excel('file.xlsx')需要底层存在openpyxl支持,否则会抛出ImportError: Missing optional dependency 'openpyxl'。 - 避免使用错误的 orient 参数:若未指定
orient='records',默认行为是生成以列名为顶层的嵌套字典({col: {idx: val}}),这将无法满足遍历单行记录的需求。 - 注意数字长整型精度与浮点表示:Excel 中的长纯数字(如身份证号、银行卡号)如果在读取时未设置
dtype=str,可能会被自动解析为浮点数并丢失精度。对于标识编号类数据,建议在read_excel中通过dtype={'user_id': str}显式指定为字符串。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















