


Python使用NumPy高效生成大量随机数数组
本文详解在Python中使用NumPy高效生成大量随机数数组的最佳实践,涵盖现代Generator接口、常见分布生成、内存与性能优化技巧及并发随机流处理。
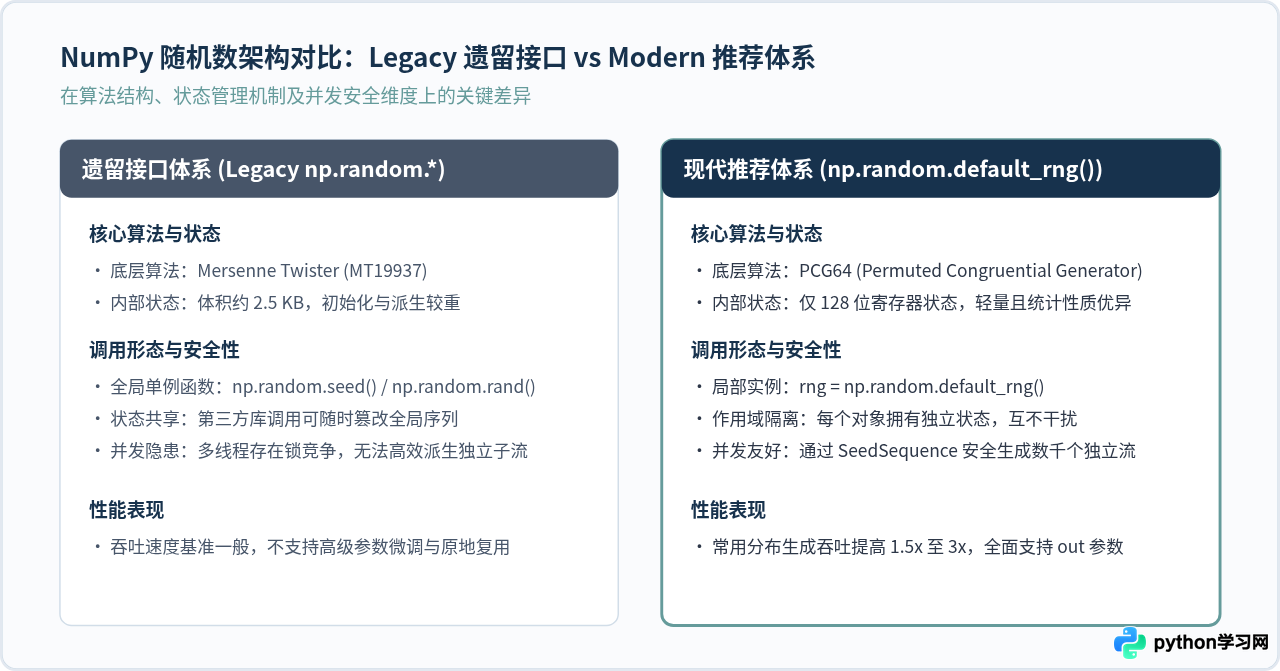
在 Python 中生成大规模随机数数组时,最高效的做法是直接使用 NumPy 的现代生成器接口 np.random.default_rng(),并一次性指定目标数组的形状。这种方式通过底层 C 语言连续分配内存并利用高吞吐的 PCG64 随机位算法,彻底消除了原生循环和列表打包的开销,生成数百万至上亿个随机元素仅需毫秒级或数秒时间。
一、现代推荐方案:default_rng 接口体系
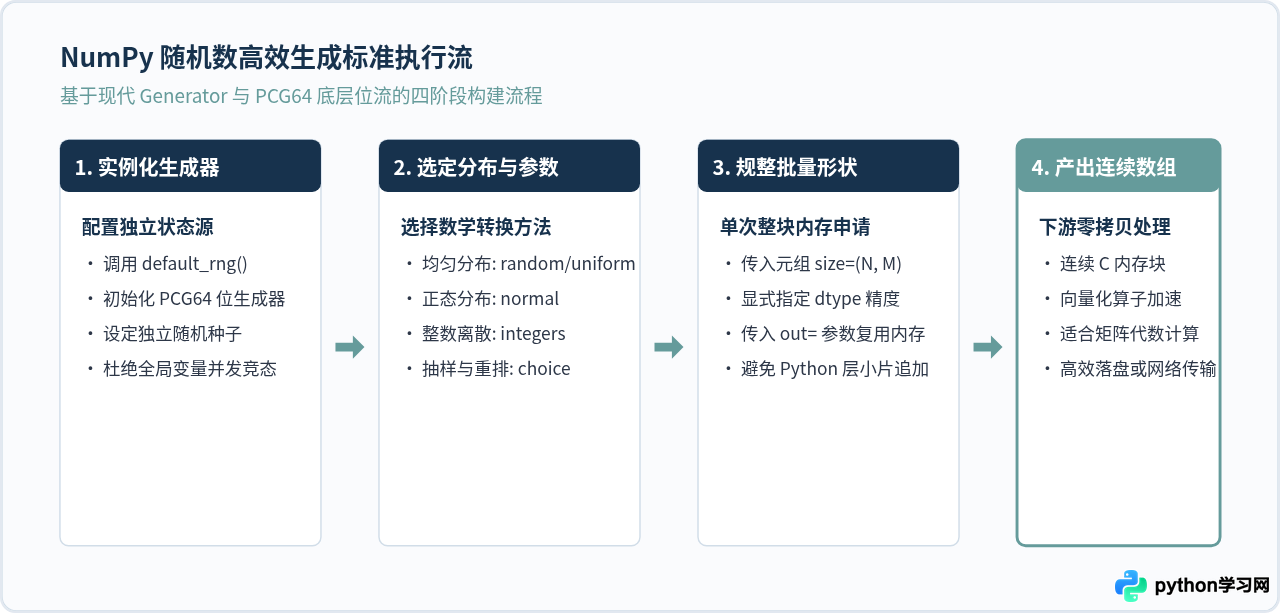
NumPy 自 1.17 版本起重构了随机数子系统,推荐采用显式实例化的 Generator 对象,而非传统的全局函数。新体系将“随机位生成器(BitGenerator)”与“概率分布算法(Generator)”解耦,默认采用 64 位 PCG 算法(PCG64),在生成速度与统计随机性上均明显超越旧版 Mersenne Twister(MT19937)。
import numpy as np

# 1. 实例化生成器对象(可指定固定种子以确保结果可复现)
rng = np.random.default_rng(seed=42)

# 2. 一次性生成包含 1000 万个浮点数的数组,区间为 [0.0, 1.0)
arr_large = rng.random(10_000_000)

print("数组形状:", arr_large.shape)
print("数据类型:", arr_large.dtype)
print("前3个元素:", arr_large[:3])上述代码中,rng.random() 在底层直接向系统申请一块连续的 C 语言内存缓冲区,并在一次底层循环中填充完毕,避免了中间对象的创建与垃圾回收负担。
二、旧接口演进与架构对比
许多早期教程常使用 np.random.seed(123)、np.random.rand() 或 np.random.randn()。这些属于 NumPy 的 Legacy(遗留)接口。虽然为了向后兼容仍被保留,但官方已明确不建议在新的代码中继续使用。
遗留接口的核心缺陷在于其共享全局状态。如果在多线程或被多个库共同引用的环境中调用 np.random.seed(),会导致全局随机序列相互干扰,无法保证实验复现性。此外,旧接口使用的 MT19937 状态体积庞大(约 2.5 KB),且无法通过高强度的现代统计随机性检验。
三、常见概率分布的大规模生成示例
在大规模计算场景中,不同的科学计算和仿真任务依赖不同的数学分布。default_rng() 提供了统一且规律的方法命名规则。
1. 均匀分布浮点数组
若需要区间在 [0.0, 1.0) 内的标准均匀浮点数,使用 rng.random(size);若需要任意区间 [low, high),则使用 rng.uniform(low, high, size)。
# 生成 shape 为 (5000, 2000) 的均匀分布二维矩阵,共 1000 万个浮点数
matrix_uniform = rng.uniform(low=-10.0, high=10.0, size=(5000, 2000))
print("占用内存大小 (MB):", matrix_uniform.nbytes / (1024 * 1024))
2. 正态分布(高斯分布)数组
正态分布在数据分析和机器学习参数初始化中极为普遍。使用 rng.normal(loc, scale, size),其中 loc 代表均值($\mu$),scale 代表标准差($\sigma$)。
# 生成均值为 0,标准差为 1 的 500 万个标准正态分布随机数
samples_normal = rng.normal(loc=0.0, scale=1.0, size=5_000_000)
3. 离散整数数组
在旧接口中生成随机整数使用 np.random.randint(),现代接口统一命名为 rng.integers(low, high, size, endpoint=False)。注意默认情况下为半开区间 [low, high),若需要闭区间 [low, high],可明确设置 endpoint=True。
# 生成范围为 1 到 100 的闭区间离散整数,共 200 万个
integers_arr = rng.integers(low=1, high=100, size=2_000_000, endpoint=True)
4. 随机抽样与重排
对已有的大规模数组进行无放回抽样或打乱顺序,可使用 rng.choice() 与 rng.permutation()。permutation() 会返回一份打乱后的新数组,而 rng.shuffle() 则直接在原数组上进行原地重排,后者能节省大规模数据的内存占用。
raw_data = np.arange(1_000_000)
# 原地打乱 100 万个数据,不产生额外的临时数组
rng.shuffle(raw_data)
四、亿级规模下的性能与内存控制
当生成的元素数量达到千万甚至上亿级别时,内存占用和硬件总线吞吐往往成为系统瓶颈。遵循以下原则能显著提升执行效率并防止内存溢出(OOM)。
for 循环中不断生成小片段并通过 np.append() 或 np.concatenate() 拼接。NumPy 的底层数组是固定大小的连续内存,每次拼接都会重新分配新内存并将全部旧数据复制过去,时间复杂度迅速恶化为 $O(N^2)$。务必在一次调用中指定最终需要的 size 元组。
1. 数据类型(dtype)与内存削减
NumPy 默认生成的浮点数是 64 位双精度(float64),每个数字占据 8 个字节。生成 1 亿个 float64 元素需要约 763 MB 连续内存。如果业务场景(如深度学习训练、图形渲染或蒙特卡洛粗测)只需要单精度 32 位浮点数,显式指定 dtype=np.float32 可立即节省 50% 的内存。
# 显式生成 float32 类型的 1 亿个随机数
# 仅需约 381 MB 内存,生成速度更快且能更好地驻留 CPU 缓存
arr_f32 = rng.random(100_000_000, dtype=np.float32)
print("float32 实际内存占用 (MB):", arr_f32.nbytes / (1024 * 1024))
2. 利用 out 参数实现零分配原地复用
在循环迭代算法或时序仿真中,如果需要反复生成相同规格的大数组,频繁向操作系统申请和释放内存会导致内存碎片并触发垃圾回收。Generator 的大部分方法都支持 out 参数,允许直接将随机数写入预先分配好的数组中。
# 预分配一块固定内存缓冲区
buffer = np.empty((1000, 1000), dtype=np.float64)

# 在仿真循环中重复刷新,不产生任何新内存分配
for step in range(5):
    rng.random(out=buffer)
    # 直接基于 buffer 执行后续计算任务...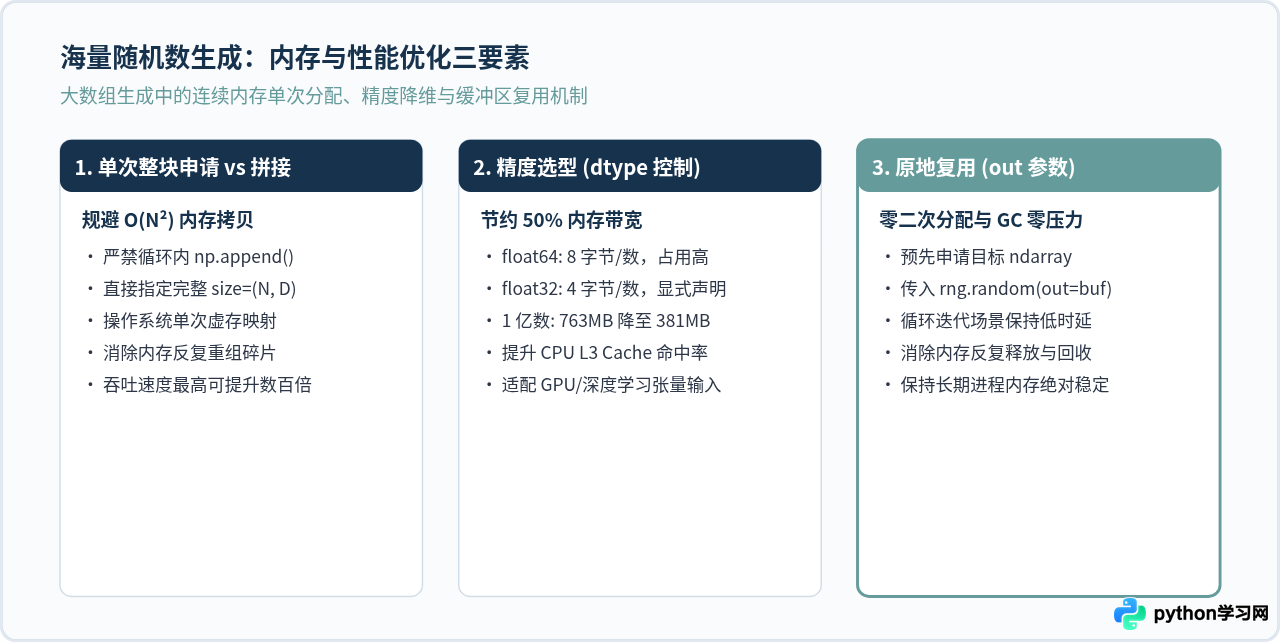
3. 多进程与多线程并行生成
单线程生成上百 GB 随机数可能受限于单一 CPU 核心的吞吐上限。利用 NumPy 的 SeedSequence,可以衍生出多个完全独立的子种子,分发给多个子线程或进程并行生成,彼此之间不会产生序列相关性或重合。
from numpy.random import SeedSequence, default_rng
from concurrent.futures import ProcessPoolExecutor

def generate_sub_array(child_seed, count):
    # 每个子进程独立根据 child_seed 构造 Generator
    local_rng = default_rng(child_seed)
    return local_rng.random(count, dtype=np.float32)

# 主流程:派生 4 个完全互不相关的子种子
ss = SeedSequence(12345678)
child_seeds = ss.spawn(4)

# 4 个任务分别生成 2500 万个数,最终汇聚为 1 亿个随机数
with ProcessPoolExecutor(max_workers=4) as executor:
    results = list(executor.map(generate_sub_array, child_seeds, [25_000_000]*4))

print("并行生成完成,块数量:", len(results))
五、选型总结与 API 速查
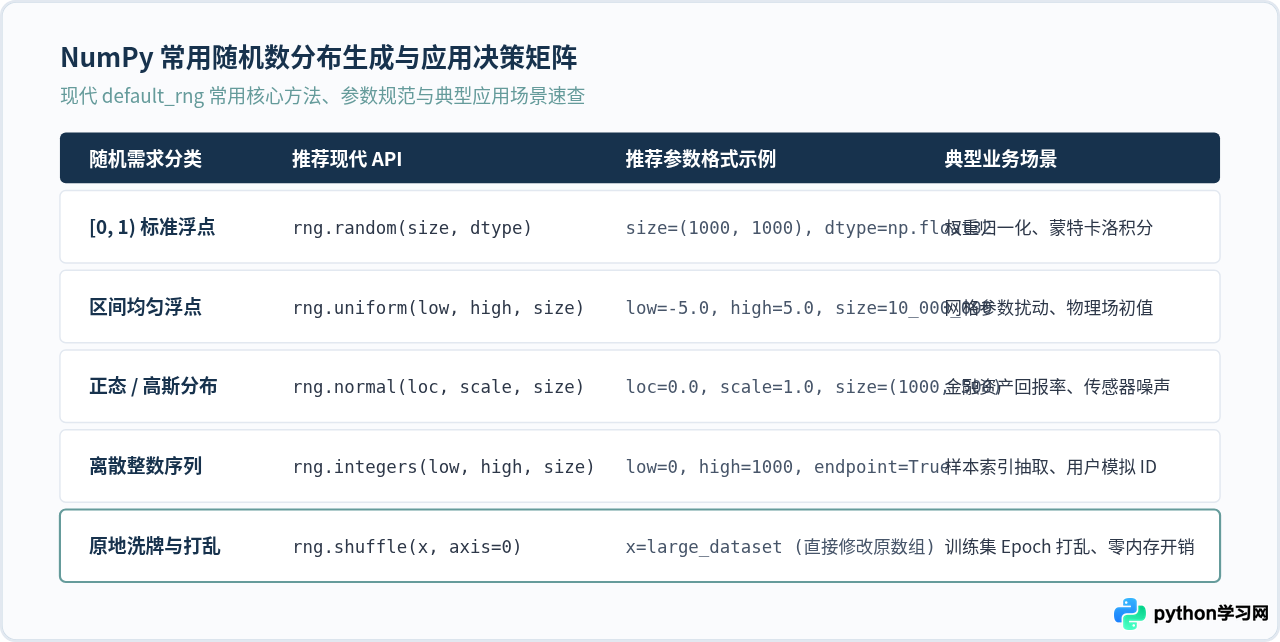
为了在实际开发中快速选用最合适的方法,下表汇总了常见随机数任务与对应的现代最佳实践:
六、常见问题排查与注意事项
- 问题一:生成结果在多进程中完全重复
如果在主进程中先创建了一个rng实例,随后在multiprocessing.Process中由各子进程继承,子进程会完全复制父进程的内存状态,从而生成一模一样的随机数。解决方法是在子进程内部使用SeedSequence.spawn()派生独立的子种子分别实例化。 - 问题二:整数生成超出边界
切记rng.integers(1, 10)默认只生成到 9(左闭右开),若需包含 10,务必显式传入endpoint=True。 - 问题三:大量随机数生成导致 MemoryError
单次生成多维大数组时,如果系统物理内存不足以一次性分配连续的内存块,操作系统将拒绝分配。此时应按块(Chunking)分批生成并流式写入磁盘(例如使用 HDF5 或 Memory-mapped 数组np.memmap),避免驻留内存超出物理上限。
综上所述,掌握 np.random.default_rng() 体系、合理指定目标规格与数据精度,并结合原地复用技巧,即可在 Python 与 NumPy 环境下以接近硬件极限的效率生成和管理海量随机数数组。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















