


Python中str()与repr()的区别及适用场景
深入解析Python中str()与repr()函数的核心差异、底层方法调用回退机制、容器元素显示规则以及在日常开发与类设计中的最佳实践。
str() 与 repr() 都用于将对象转换为字符串,但两者的设计受众与核心目标截然不同:str() 面向终端用户,侧重易读性(Readability),输出直观、简洁、符合自然阅读习惯的形式;而 repr() 面向开发人员与调试系统,侧重无二义性(Unambiguity),旨在完整呈现对象的类型、内部状态与代码结构,力求做到“所见即所得”。
一、设计哲学与表现形式的核心差异
初学者常因两者在处理简单数字(如整数 123)时返回完全相同的字符表面而忽视其本质差别。然而,一旦涉及字符串、日期时间、浮点数以及复杂嵌套对象,两者的分歧便显露无遗:
str()的目标是“可读”:过滤掉机器视角的语法标记(如引号、转义字符),只呈现对象所表达的业务文本内容。repr()的目标是“精确”:保留字面量特征,明确区分数据类型(例如区分字符串'42'与整数42),并在可能的情况下让返回值满足eval(repr(obj)) == obj的等价表达。
import datetime

now = datetime.datetime(2026, 10, 27, 17, 15, 0)
s = "Hello\nWorld"

# str() 输出:适合给人类展示
print(str(now))  # 示例输出: 2026-10-27 17:15:00
print(str(s))    # 示例输出: 换行呈现为两行

# repr() 输出:适合代码审查与调试
print(repr(now)) # 示例输出: datetime.datetime(2026, 10, 27, 17, 15, 0)
print(repr(s))   # 示例输出: 'Hello\nWorld'(保留单引号与显式转义字符)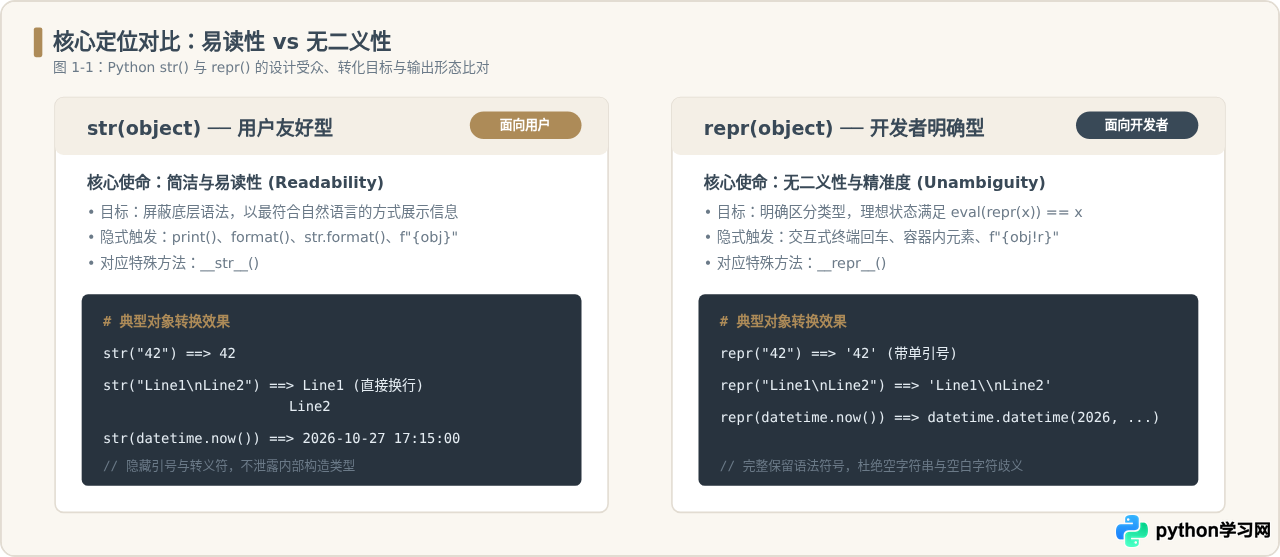
二、底层调用与方法回退(Fallback)机制
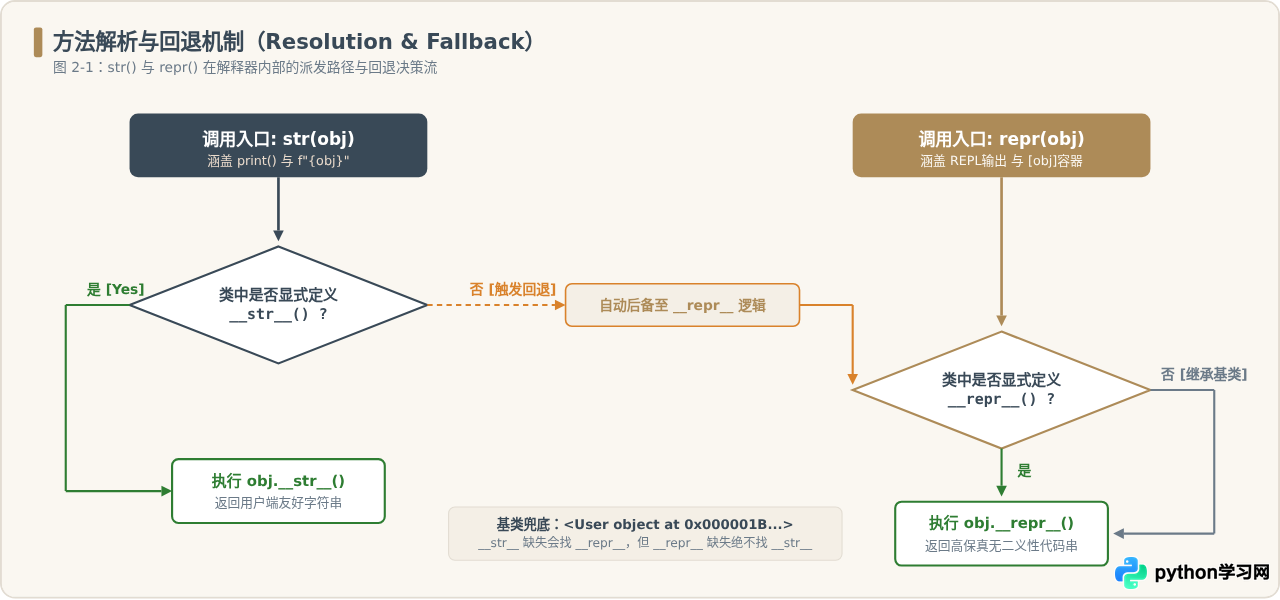
当我们在代码中对一个实例调用 str(obj) 或 repr(obj) 时,Python 解释器会查找类中对应的特殊方法(即魔术方法)__str__() 与 __repr__()。这两个方法的内部查找与回退规则构成了自定义类设计的关键基石:
str(obj)的回退链条:解释器首先检索该对象所属类是否定义了__str__()。若已定义,则直接调用并返回结果;若未定义,解释器会自动回退并尝试调用该类的__repr__()方法。若两者均未显式定义,则继承自根类object的默认object.__repr__()(输出形如<__main__.User object at 0x...>)。repr(obj)的单向规则:解释器仅且只检索__repr__()。若未显式实现,直接调用基类的object.__repr__(),绝不会向__str__()发生回退。
str() 可以无缝回退至 __repr__(),而 repr() 绝不回退至 __str__(),因此在编写自定义类时,如果只打算实现其中一个方法,务必选择 __repr__()。这样既能保证交互式调试和容器排查的清晰,又能确保普通打印拥有基本可读的文本表示。
三、实战代码:自定义类中的标准实现范例
为了直观掌握双魔术方法的配合模式,我们构建一个实际业务常见的 Product(商品)类:
class Product:
    def __init__(self, name: str, price: float, sku: str):
        self.name = name
        self.price = price
        self.sku = sku

    def __str__(self) -> str:
        """提供给普通用户或报表展示的直观文字"""
        return f"{self.name} (售价: ¥{self.price:.2f})"

    def __repr__(self) -> str:
        """提供给调试器、日志或开发人员的精准构造表达式"""
        return f"Product(name={self.name!r}, price={self.price!r}, sku={self.sku!r})"

# 实例化对象
item = Product("机械键盘", 399.0, "KB-87-PRO")

# 场景 1: 面向用户界面展示
print(item)        # 示例输出: 机械键盘 (售价: ¥399.00)
print(str(item))   # 示例输出: 机械键盘 (售价: ¥399.00)

# 场景 2: 面向系统排障与调试
print(repr(item))  # 示例输出: Product(name='机械键盘', price=399.0, sku='KB-87-PRO')
特别陷阱:容器类型(List / Dict / Tuple)的打印行为
很多开发者经常困惑于这样一个现象:明明为自定义类实现了 __str__(),可一旦将对象放入列表或字典中,使用 print([item1, item2]) 打印整个列表时,终端输出的依然不是 __str__() 所定义的美化文本,而是 __repr__() 的内容!
这是 Python 的故意设计。在集合容器内部,为了防止元素间由于缺乏引号或边界标记引发歧义(例如无法分清字符串中的逗号与容器元素分隔逗号),所有标准容器在打印自身时,一律强制对其包含的子元素调用 repr() 而不是 str()。
items = [item]

# 注意:这里外层是 print(),但列表内部元素强制调用了 __repr__()!
print(items)
# 示例输出: [Product(name='机械键盘', price=399.0, sku='KB-87-PRO')]
# 而绝不是: [机械键盘 (售价: ¥399.00)]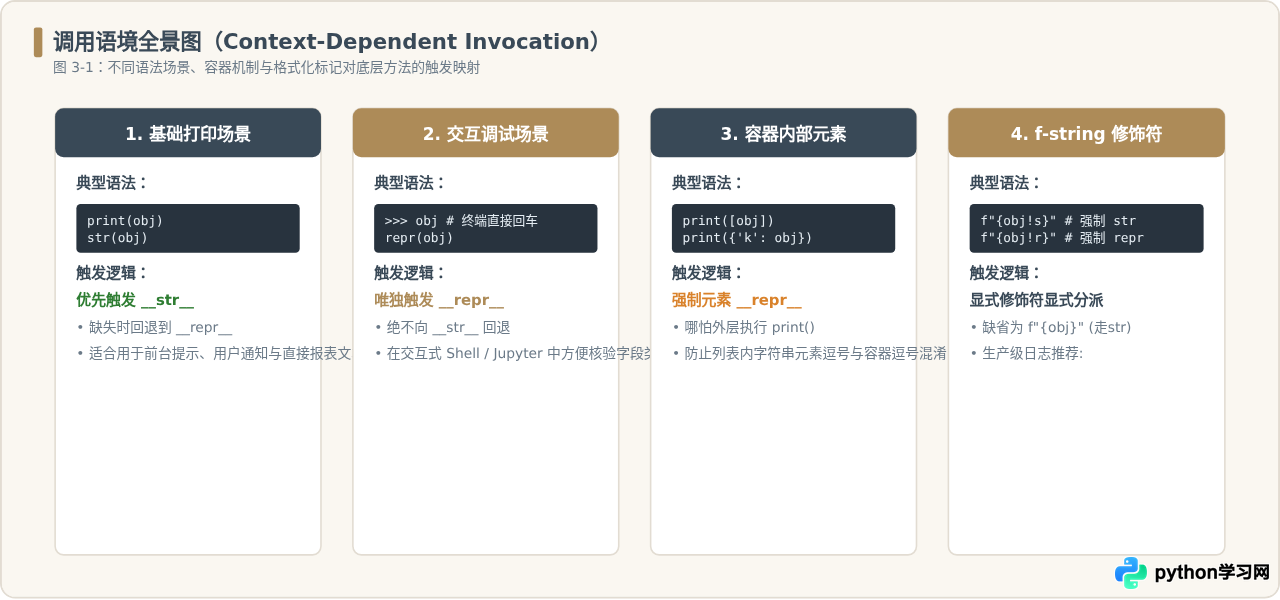
四、工程实践:选型决策与关键避坑指南
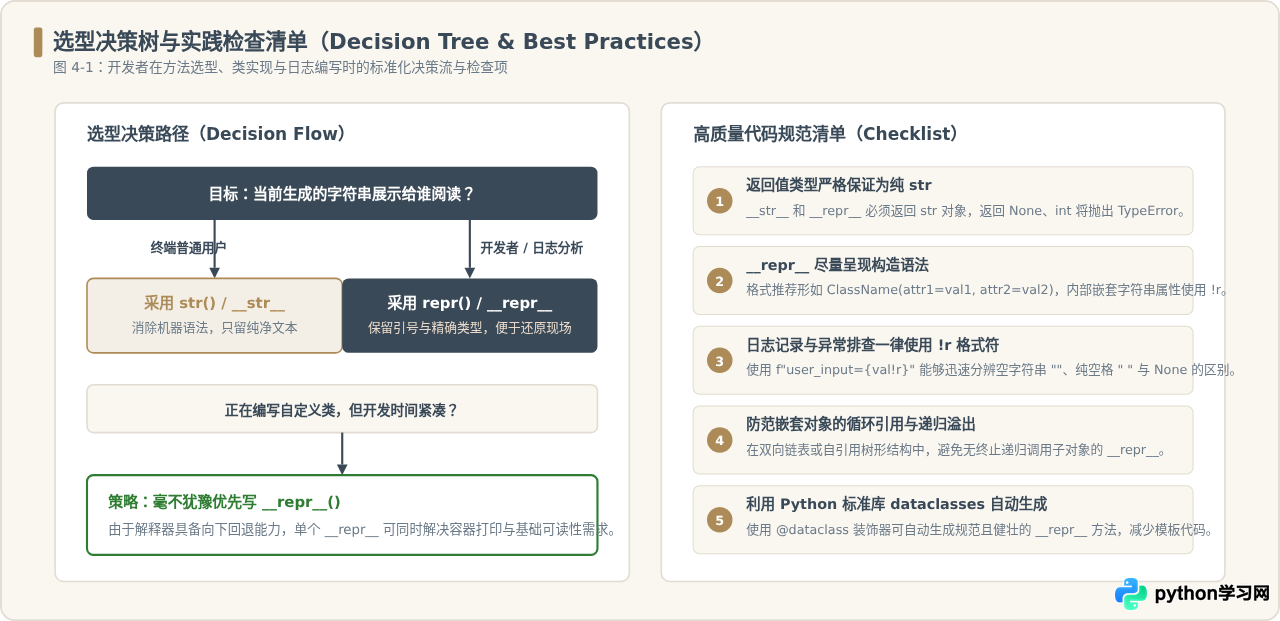
在日常业务开发与架构设计中,如何快速判定何时调用或实现哪一个函数?以下对照表与决策树可作为标准化参照:
| 对比维度 | str() / __str__ |
repr() / __repr__ |
|---|---|---|
| 首要读者 | 最终用户、外部系统客户、前台界面访问者 | 程序员、内部运维团队、自动化测试框架 |
| 输出特征 | 自然语言可读性高,隐藏引号、换行转义及对象类型 | 无二义性,清晰标注数据类型与字符边界 |
| 典型应用场景 | 生成电子邮件、CLI提示、前端文本渲染、打印报告 | 日志排障输出(logging)、断言报错信息、调试监视窗口 |
| eval 兼容性 | 通常不可执行(无法反向通过 eval 还原对象) | 理想情况下满足 eval(repr(obj)) == obj |
| 重写优先级 | 次选(根据界面展示需要决定是否额外补充) | 首选必写(任何自定义业务实体类都应具备) |
五、总结
str() 与 repr() 在 Python 中各司其职,互为补充:
str()关注的是“用户体验”,解决的是信息传递的舒适度与整洁度;repr()关注的是“开发精度”,解决的是系统运作的透明度与无二义性。
遵循“类定义优先写好 __repr__(),对外展示补充 __str__(),调试排错优先使用 !r”的工程准则,可以从根源上规避对象打印模糊、日志边界不清以及容器显示混乱等一系列常见痛点。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















