


Python怎么实现忽略大小写的字符串替换?
详细讲解在Python中如何使用标准库re模块实现忽略大小写的字符串替换,包括re.sub基础用法、转义特殊字符、保留原词大小写样式的高级技巧与性能优化建议。
在 Python 中,字符串内置的 str.replace() 方法在设计上是严格区分大小写的,并且并未提供类似 ignore_case=True 的可选参数。如果需要实现忽略大小写(Case-Insensitive)的替换操作,核心解法是利用 Python 标准库自带的正则表达式模块 re,通过 re.sub() 搭配 flags=re.IGNORECASE 标志来完成。针对包含正则特殊字符、需要保留原词大小写格式或频繁循环替换等实际业务场景,还可以结合转义函数与回调处理来实现精确控制。
一、核心基础:使用 re.sub 与 re.IGNORECASE
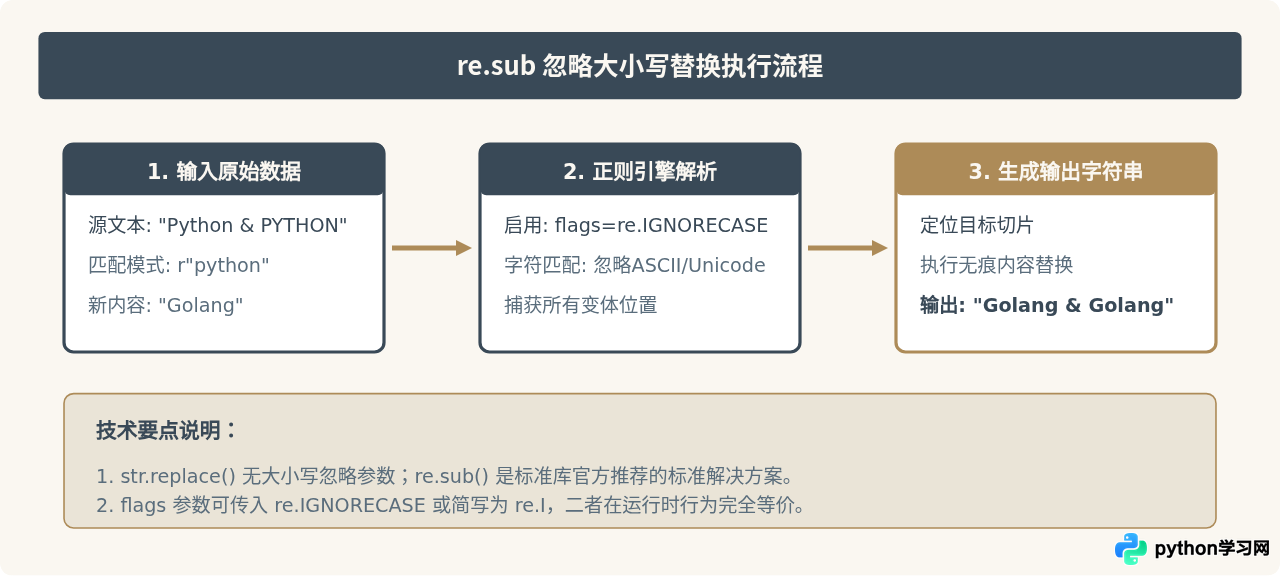
处理忽略大小写替换最直接、最标准的方式就是调用 re.sub()。该函数接受搜索模式、替换后的新文本、待处理字符串以及标志位四个关键参数。将标志位设置为 re.IGNORECASE(可简写为 re.I),即可让匹配过程不再区分英文字母的大小写。
import re

text = "Python is powerful. I love PYTHON and python scripting."

# 将无论大写、小写或首字母大写的 python 统一替换为 Golang
result = re.sub(r"python", "Golang", text, flags=re.IGNORECASE)

print("原始文本:", text)
print("替换结果:", result)
示例输出:
原始文本: Python is powerful. I love PYTHON and python scripting.
替换结果: Golang is powerful. I love Golang and Golang scripting.
在这段代码中,无论是 Python、PYTHON 还是 python,正则引擎都会将其视作符合条件的匹配项,并统一用目标字面量 "Golang" 替换。
二、关键细节:当搜索词包含特殊符号时使用 re.escape
在很多实际业务场景中,待替换的关键词是由用户输入或从配置文件中动态读取的纯文本,其中可能包含 .、*、?、+、$、(、)、[ 等正则表达式元字符。如果直接把包含元字符的字符串传给 re.sub(),正则引擎会将其作为语法指令解析,从而导致意外结果甚至抛出语法错误。
解决这个问题的标准做法是在传入模式前,先调用 re.escape() 对关键词进行转义。re.escape() 会自动在每个特殊符号前添加反斜杠,确保其被当作纯字符字面量匹配。
import re

text = "User visited http://example.com/api?id=1 and HTTP://EXAMPLE.COM/API?ID=2"
target_keyword = "http://example.com/api?id="

# 错误做法:直接传入会因 '?' 产生正则解析歧义
# safe_pattern = target_keyword  # 不安全

# 正确做法:使用 re.escape 转义特殊字符
safe_pattern = re.escape(target_keyword)
result = re.sub(safe_pattern, "https://api.internal/v1?id=", text, flags=re.I)

print(result)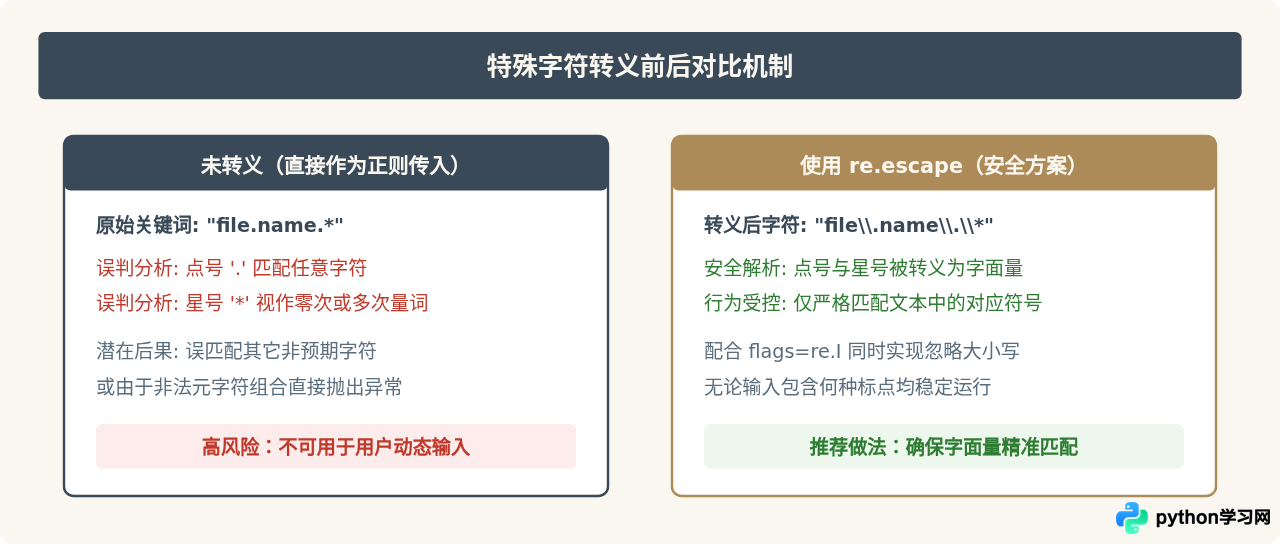
三、进阶应用:替换时保留原文的大小写格式
在简单的 re.sub(pattern, "new_word", text, flags=re.I) 中,替换后的词汇总是固定的形态。但在文章校对或自然语言处理中,我们经常希望“替换词跟随原词的大小写风格”:
- 如果原词是全大写(如
APPLE),替换后也保持全大写(如ORANGE); - 如果原词是首字母大写(如
Apple),替换后也是首字母大写(如Orange); - 如果原词是全小写(如
apple),替换后保持全小写(如orange)。
re.sub() 的第二个参数不仅支持字符串,还支持传入一个回调函数(callable)。回调函数会接收当前的 re.Match 对象,并返回替换后的字符串。
import re

def preserve_case_replace(text, word_to_find, replacement):
    # 转义搜索词并设置忽略大小写
    pattern = re.compile(re.escape(word_to_find), re.IGNORECASE)

    def repl_callback(match):
        matched_str = match.group(0)
        # 根据匹配到的原文风格,调整替换词的形态
        if matched_str.isupper():
            return replacement.upper()
        elif matched_str.istitle():
            return replacement.capitalize()
        elif matched_str.islower():
            return replacement.lower()
        else:
            return replacement

    return pattern.sub(repl_callback, text)

# 测试效果
content = "Apple, apple, and APPLE are fruits."
updated = preserve_case_replace(content, "apple", "orange")
print("测试结果:", updated)
示例输出:
测试结果: Orange, orange, and ORANGE are fruits.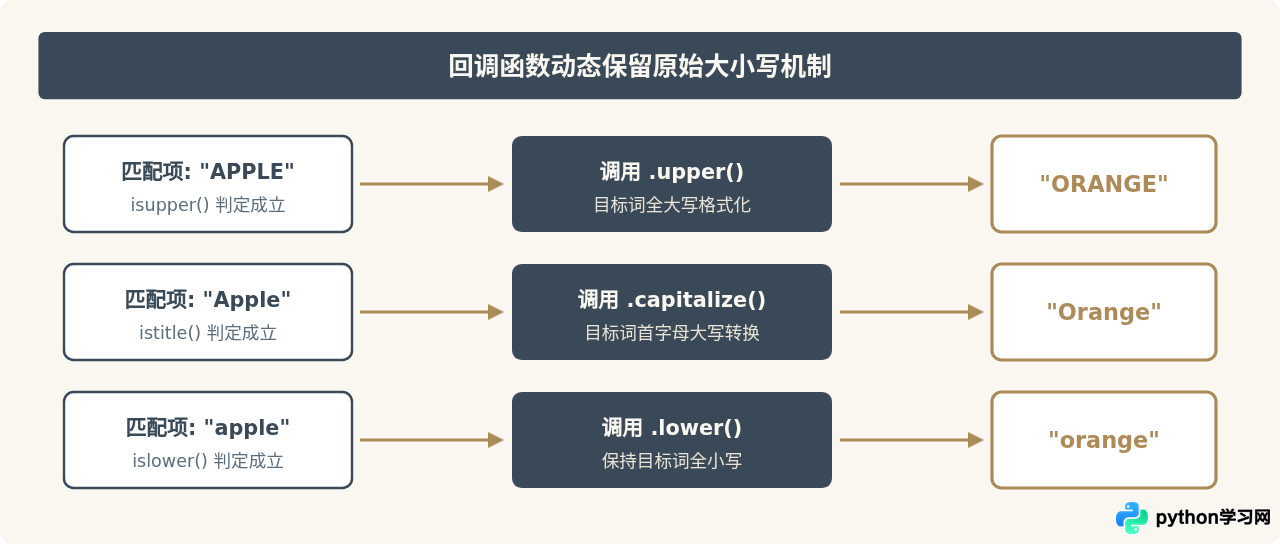
四、循环高频场景下的性能优化:re.compile
在需要遍历成千上万行日志或处理大体积文章时,每次循环都调用 re.sub(..., flags=re.I) 会导致 Python 内部频繁解析正则表达式并检查缓存。此时应当提前使用 re.compile() 将模式编译为模式对象,再通过该对象的 sub() 方法执行替换:
import re

# 提前编译,避免在循环体内重复解析正则模式
pattern = re.compile(re.escape("error"), re.IGNORECASE)

log_lines = [
    "ERROR: connection reset",
    "Warning: normal tick",
    "error: timeout occurred",
    "Info: system ok"
]

processed_lines = [pattern.sub("CRITICAL", line) for line in log_lines]
for line in processed_lines:
    print(line)
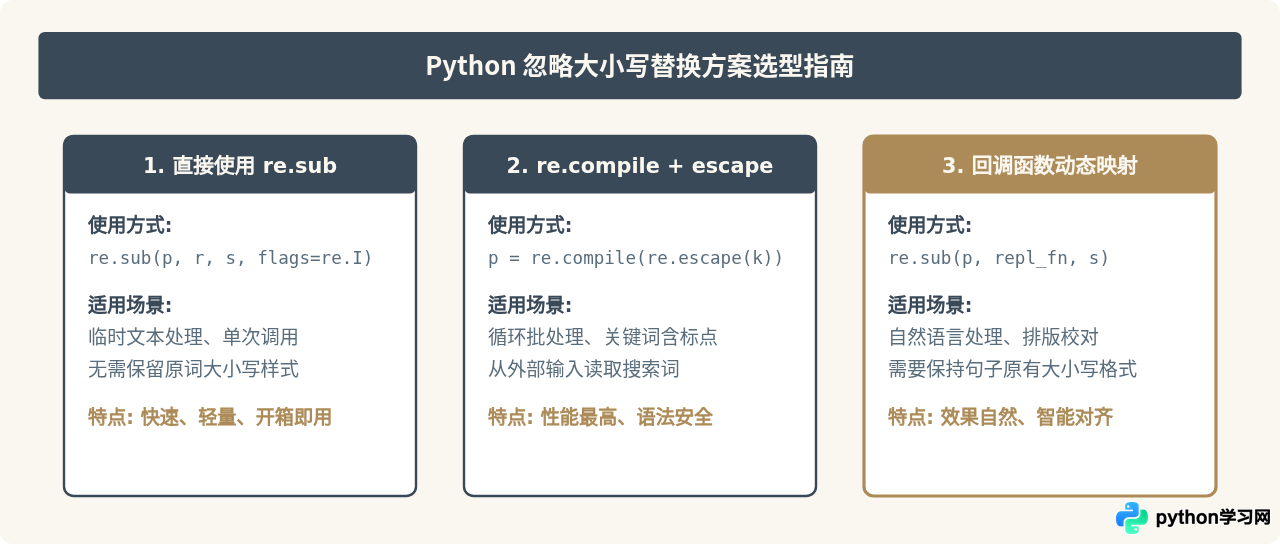
五、方案选型与总结
在 Python 中实现忽略大小写的字符串替换,可以依据具体的业务诉求选择最合适的处理策略:
- 单次简单替换:直接使用
re.sub(pattern, replacement, text, flags=re.IGNORECASE),代码简洁明了; - 动态未知词汇:必须配合
re.escape()对关键字进行转义,防止元字符干扰匹配结果; - 保留原词大小写样式:使用回调函数结合
isupper()、istitle()进行动态映射; - 批量/高频循环操作:提前使用
re.compile()固化编译对象,提升执行效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















