


Python读取CSV或JSON时报错:隐藏换行符导致的解析异常排查
针对Python解析CSV或JSON文件时由隐藏换行符引起的各类报错,系统讲解其底层破坏机理、二进制定位方法、CSV/JSON各自的规范修复方案以及防止数据错位的验证手段。
在 Python 数据处理中,读取 CSV 或 JSON 文件抛出解析异常,许多时候并非代码语法错误或字段类型不符,而是由肉眼不可见的隐藏换行符(如 Windows 的 \r\n 与 Unix 的 \n 混用、字段内部缺少转义的裸换行符等)截断了数据结构。排查的核心路径非常明确:显式暴露不可见控制字符定位异常物理行,区分是操作系统行终止符混淆还是字段内容被非法截断,最后针对性采用受控参数、引号规范化或流式清洗修复文件。
一、典型报错特征与隐藏破坏机理
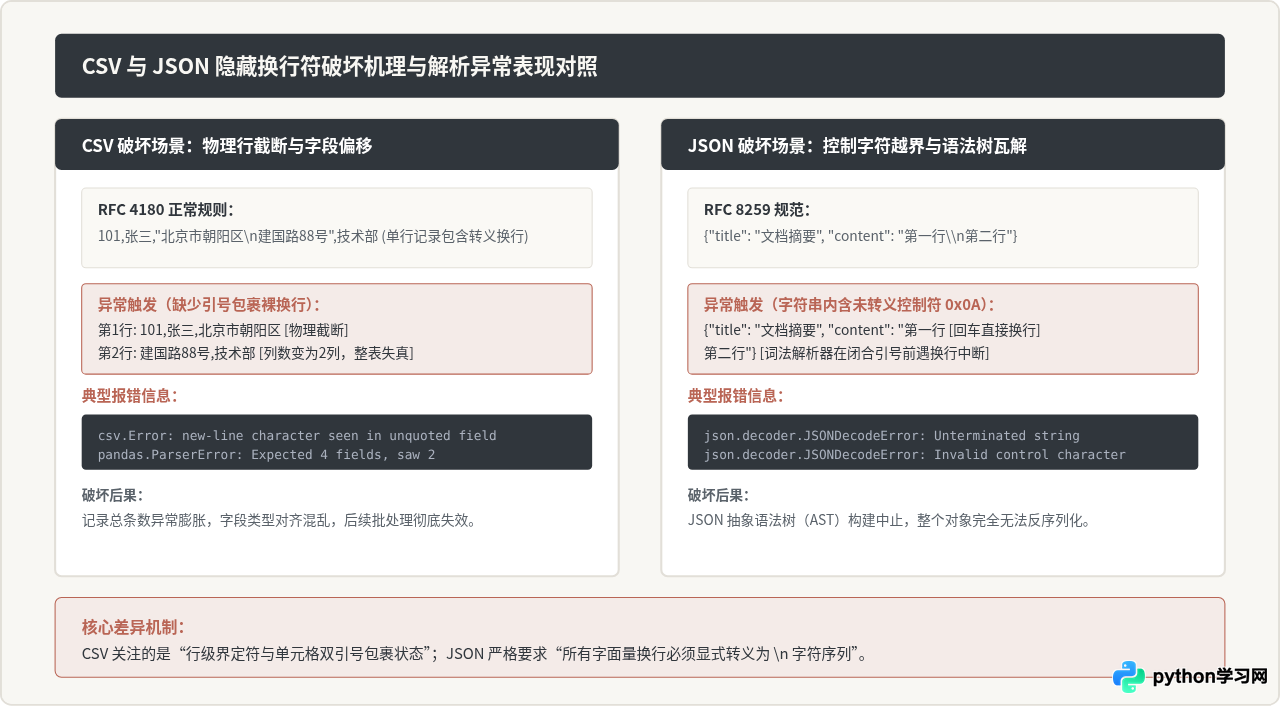
CSV 与 JSON 虽然都是纯文本传输格式,但在组织记录边界与值边界时的语法约束存在本质差异。当文本中混入非预期的换行符时,两者抛出的异常类型和破坏表现截然不同。
1. CSV 常见报错形态
标准库 csv 依赖换行符来判定单行记录的结束。如果某一列字段内包含回车或换行,但该字段没有被合法的双引号完整闭合,解析器就会将字段内的换行视作物理行终止,进而引发如下典型报错:
csv.Error: new-line character seen in unquoted field - do you need to open the file in universal-newline mode?:在未用双引号闭合的字段中检测到了换行符。pandas.errors.ParserError: Expected 6 fields in line 42, saw 3:字段内部的换行将原本完整的一行切断为两行,导致后半截自成新行并发生列数缺失。
2. JSON 常见报错形态
根据 RFC 8259 规范,JSON 字符串值中禁止直接包含未转义的 U+0000 到 U+001F 控制字符(其中包含 ASCII 10 换行符 \n 和 ASCII 13 回车符 \r)。字符串中的换行必须使用反斜杠转义序列 \n 表示。一旦原始文本中直接按下了物理回车,Python 的 json.loads() 就会在词法阶段立刻中断并报错:
json.decoder.JSONDecodeError: Unterminated string starting at line 12 column 8 (char 315):解析器在未读到字符串闭合引号前遇到了裸换行符,判定字符串未正常闭合。json.decoder.JSONDecodeError: Invalid control character at: line 4 column 21 (char 86):在非严格模式下或部分解析分支中,检测到了非法裸控制字符。
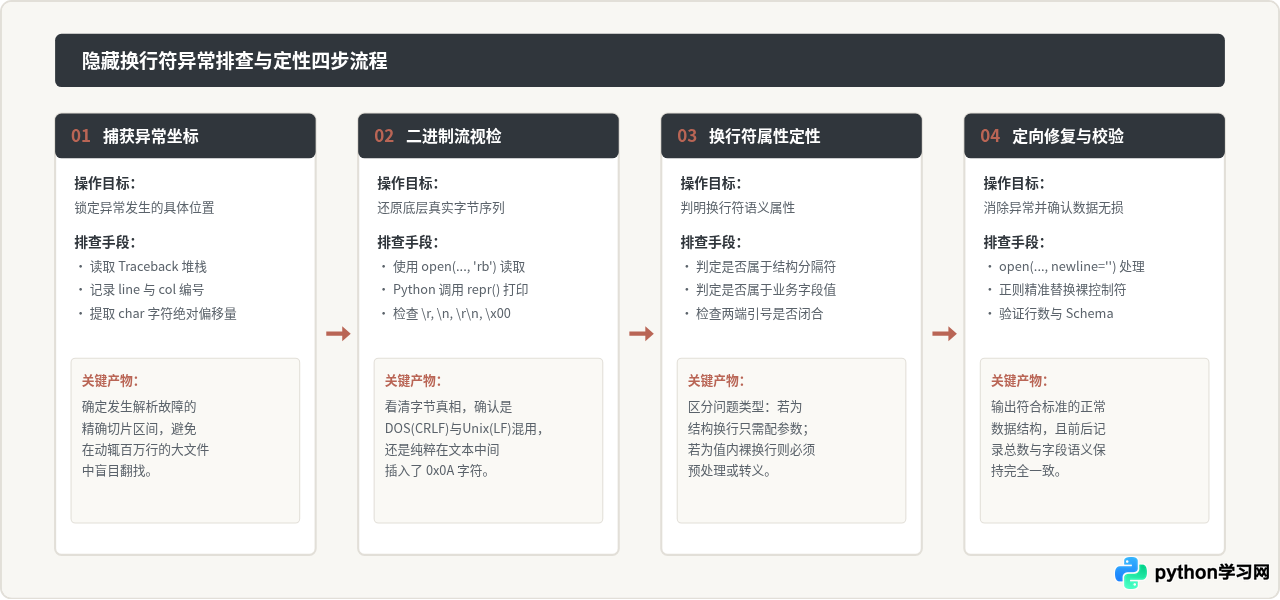
二、四步定位法:让不可见字符无所遁形
普通文本编辑器默认会将换行符渲染为视觉空行,这使得人眼极难区分某个空白行到底是一个合法换行还是一个破坏字段的裸字符。排查工作应当遵循固定的步骤流:
实操排查代码示例
遇到报错时,先不要盲目尝试正则替换。编写一段简洁的探针脚本,以二进制模式读取报错行前后的原始切片:
# inspect_bytes.py
# 针对报错位置截取原始二进制片段
def inspect_file_bytes(filepath, target_line=None, char_offset=None, window=120):
    with open(filepath, 'rb') as f:
        if char_offset is not None:
            # 根据 JSON 报错的 char 偏移量前后嗅探
            start = max(0, char_offset - window)
            f.seek(start)
            raw = f.read(window * 2)
            print(f"=== 字符偏移 {char_offset} 附近原始字节 ===")
            print(repr(raw))
        elif target_line is not None:
            # 逐行扫描定位到特定行号
            current_line = 1
            for line in f:
                if current_line == target_line:
                    print(f"=== 第 {target_line} 行原始字节 ===")
                    print(repr(line))
                    break
                current_line += 1

# 示例调用
inspect_file_bytes('dataset_fault.json', char_offset=315)在上面的输出中,\r\n 直接出现在 JSON 字符串内而没有反斜杠 \\r\\n,这就是引发 JSONDecodeError 的确凿证据。
三、CSV 隐藏换行符的专项成因与修复方案
在 Python 处理 CSV 时,引发换行符异常的根源通常集中在两个层面:文件读取模式不合规与数据源导出未对多行字段添加引号。
1. 核心原因:未遵守 newline='' 规范
Python 官方文档中明确指出:使用内置 csv 模块读取或写入文件时,open() 函数必须传入 newline='' 参数。
如果未指定 newline='',Python 的底层 I/O 层会自动启用通用换行模式(universal newline mode),将所有的 \r\n 和 \r 统一转译为 \n。这种在流底层的无感转换,会破坏 csv.reader 内置的双引号状态机识别逻辑,导致原本包裹在引号内部的 Windows 换行符与行末分隔符发生冲突,进而抛出 new-line character seen in unquoted field。
# 正确的 CSV 读取范例
import csv

def read_csv_properly(filepath):
    # 必须指定 newline='',由 csv 模块内部处理换行转译
    with open(filepath, mode='r', encoding='utf-8', newline='') as f:
        reader = csv.reader(f, delimiter=',', quotechar='"')
        records = [row for row in reader]
    return records
2. 数据源缺失引号的破坏修复
如果数据生成方在写入含换行的文本字段时,没有加上引号(例如用简单的 ','.join(fields) 拼接生成 CSV),那么文件在物理层面上已经被断行。此时如果直接用解析器读取,后半句会被当成全新的一行。
针对这种损坏数据,如果在管道流中无法要求源端重构,可以用状态机或缓冲机制进行流式修补:
# fix_broken_csv.py
# 修复因字段内换行而导致列数缺失的 CSV 文件
import csv

def repair_broken_rows(filepath, expected_columns):
    repaired_rows = []
    buffer_row = []

    with open(filepath, mode='r', encoding='utf-8', newline='') as f:
        reader = csv.reader(f)
        for line_num, row in enumerate(reader, 1):
            if not row:
                continue
            if len(buffer_row) == 0:
                buffer_row = row
            else:
                # 前一行被换行折断,将首个片段合并到前一行的最后一个字段
                buffer_row[-1] += "\n" + row[0]
                buffer_row.extend(row[1:])

            # 当累积字段数量达到预期时,压入结果集并清空缓冲
            if len(buffer_row) == expected_columns:
                repaired_rows.append(buffer_row)
                buffer_row = []
            elif len(buffer_row) > expected_columns:
                raise ValueError(f"第 {line_num} 行拼接后字段数超标 ({len(buffer_row)} > {expected_columns}),需核查分隔符")

    return repaired_rows
四、JSON 隐藏换行符的机理与规范修复
在 JSON 中,控制字符问题往往是由字符串拼接不规范或未调用标准库序列化造成的。
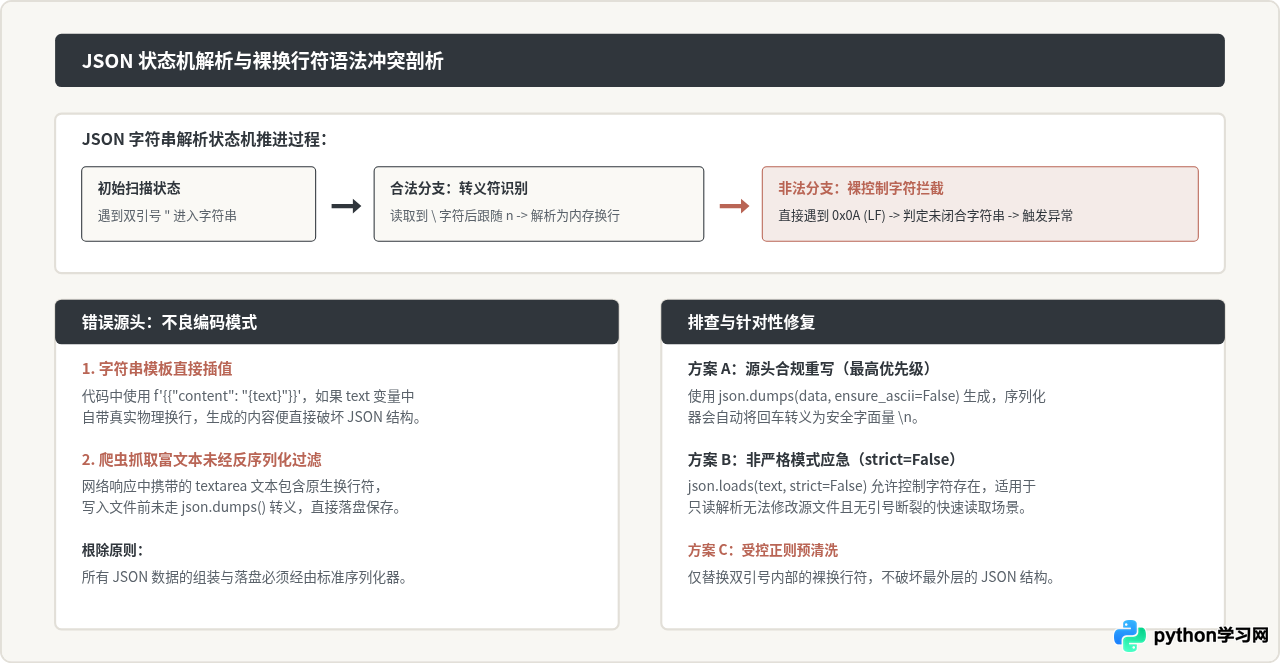
1. 应急参数 strict=False 的使用与边界
Python 标准库的 json.loads() 提供了一个 strict 参数。默认情况下 strict=True,严格禁止字符串中出现控制字符;当指定 strict=False 时,词法分析器会放行换行符:
import json

# 含有字面量裸换行的非法 JSON 字符串
raw_json = '{"name": "Alice", "bio": "First line\nSecond line"}'

# 使用 strict=False 可以放行字面量换行符
parsed = json.loads(raw_json, strict=False)
print("解析成功:", parsed["bio"])注意边界:strict=False 只能解决“合法闭合的双引号内部出现控制字符”这一特定情况。如果换行符伴随着未转义的双引号(导致字符串界定提前终止),strict=False 不仅无法解决问题,反而可能导致错误位置进一步后移,增加排查难度。
2. 静态清洗:保护性正则替换
当面对体量巨大且不可重新导出的损坏 JSON 时,可以通过正则表达式对双引号区间内的换行符进行转义:
# clean_json_newlines.py
import re
import json

def sanitize_json_newlines(corrupted_text):
    # 状态函数:仅替换双引号包裹内部的物理换行
    def replace_newlines_in_quotes(match):
        content = match.group(0)
        # 将内部的物理回车换行转义为符合 JSON 规范的 \r 与 \n
        cleaned = content.replace('\r', '\\r').replace('\n', '\\n')
        return cleaned

    # 匹配非转义双引号之间的文本区间
    pattern = r'(".*?(?<!\\)")'
    sanitized = re.sub(pattern, replace_newlines_in_quotes, corrupted_text, flags=re.DOTALL)
    return json.loads(sanitized)
五、常见排查误区与反例辨析
在排查隐藏换行符的过程中,初学者常因急于消除报错而采取全局粗暴处理,往往引发更为严重的数据隐性破坏:
| 常见做法 | 潜伏风险与反例后果 | 正确处理策略 |
|---|---|---|
text.replace('\n', '') 全局剔除 |
抹杀所有换行,导致正常的多行记录被全部拼接成一条巨型单行,整表结构彻底瓦解。 | 区分“行间分隔换行”与“字段值换行”,仅对特定字段或引号内部执行转义。 |
直接将文件扩展名改为 .txt 纯按行遍历 |
遇到被折断的行时,遍历器直接将其当成孤立行处理,导致业务关联 ID 丢失。 | 使用能够感知双引号闭合状态的状态机读取(如 csv.reader 或正则)。 |
盲目依赖 error_bad_lines=False (或 on_bad_lines='skip') |
直接丢弃报错行。若报错是由关键用户的多行备注引起的,会导致该批数据直接“人间蒸发”。 | 优先定位损坏模式并编写前置清洗器,严禁在未经业务核对前静默丢弃异常行。 |
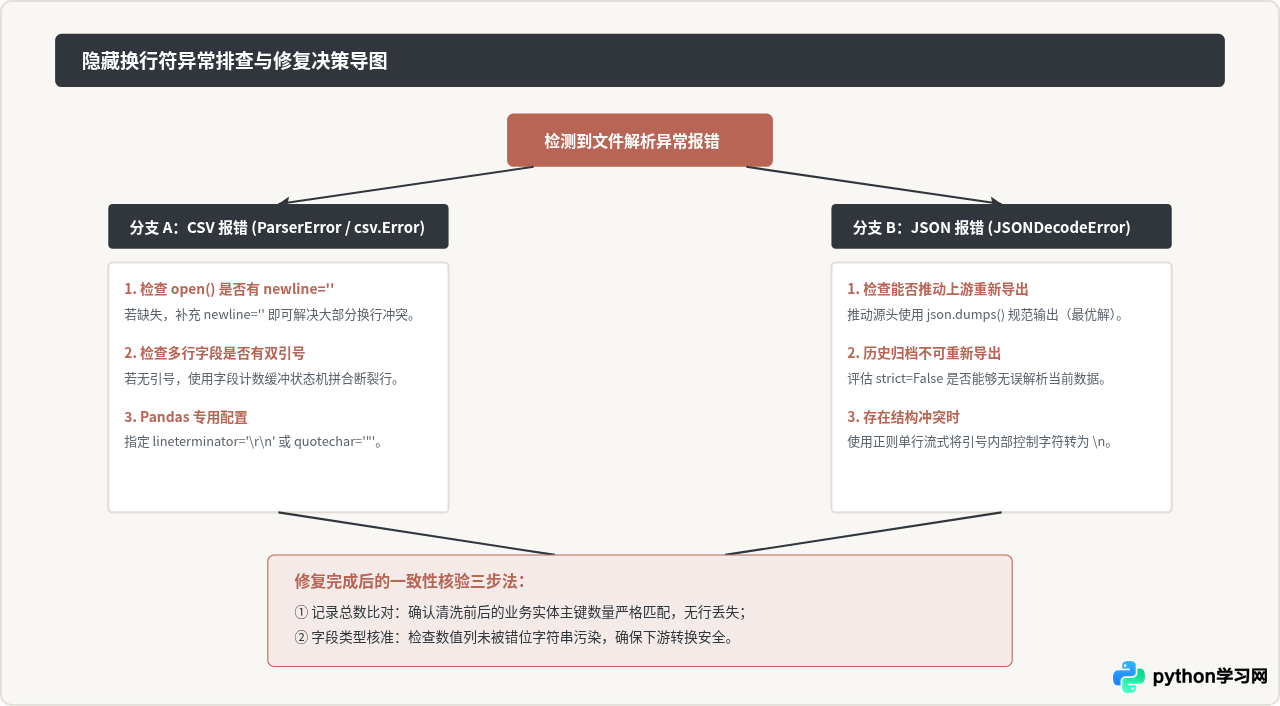
六、排查决策导图与数据验证
在面对突发的解析故障时,可依据下述决策路径快速决定采用哪种修复手段,并在修复完成后执行三道验证检查:
验证脚本示例
在批量处理完成后,通过以下核验函数确认整个解析流程闭环成功:
# verify_integrity.py
# 验证解析后的数据集完整性
def verify_records(records, expected_fields):
    print(f"[*] 开始验证,总记录条数: {len(records)}")
    for idx, row in enumerate(records):
        # 针对列表结构检查列数
        if isinstance(row, list):
            if len(row) != expected_fields:
                raise AssertionError(f"第 {idx+1} 条记录列数不匹配: 期望 {expected_fields}, 实际得到 {len(row)}")
        # 针对字典结构检查键完整性
        elif isinstance(row, dict):
            missing_keys = set(expected_fields) - set(row.keys())
            if missing_keys:
                raise AssertionError(f"第 {idx+1} 条记录缺失关键字段: {missing_keys}")
    print("[+] 所有记录字段结构校验通过,数据解析完整!")
通过“暴露二进制字节、明确换行语义、指定合规解析参数或正则受控修补、校验数据条目数”这一标准化流程,开发者能够彻底解决 CSV 与 JSON 中因隐藏换行符引发的各类解析故障,确保数据管道的高健壮性与准确性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















