


Python3 高效处理 JSON 与 CSV 数据:读取、提取与可视化

本文演示使用 Python 读取并解析 JSON 和 CSV 文件的完整流程。通过实际案例讲解如何按条件提取指定年份的国家人口数据,利用 Matplotlib 绘制气温变化图表,并将结构化 CSV 数据转换为标准 JSON 格式。掌握内置库与第三方工具的基础用法,可快速完成日常数据处理任务。
目标与准备条件
在处理结构化与半结构化数据时,Python 凭借丰富的内置模块与成熟的第三方库,能够高效完成格式转换、字段筛选与可视化呈现。开始前需确保 Python 环境已安装基础绘图依赖 matplotlib,若涉及地图或复杂标注可安装 pygal_maps_world。所有示例均基于 Python 3.x 编写,操作前建议备份原始数据文件以防误覆盖。
第一步:安装扩展库并配置国别码映射
目的:建立国家名称到两字母国别码的查找机制,便于后续数据关联。
入口:系统命令行终端。
动作:执行安装命令获取地图插件,随后在脚本中引入对应字典。
参数:pip install pygal_maps_world。
完成状态:COUNTRIES 变量可成功导入且包含完整的国家名称键值对,后续调用时无版本冲突。
'''
The i18n module was removed in pygal-2.0.0.
however, it can now be found in the pygal_maps_world plugin.
You can install that with pip install pygal_maps_world.
Then you can access COUNTRIES as pygal.maps.world.COUNTRIES:
from pygal.maps.world import COUNTRIES
Whats left of the i18n module can be imported with:
from pygal_maps_world import i18n
'''
#获取两个字母的国别码
from pygal_maps_world.i18n import COUNTRIES
def get_country_code(country_name):
    for code,name in COUNTRIES.items():
        if name==country_name:
            return code
        return None
第二步:读取 JSON 文件并按条件提取数据
目的:从多层嵌套的 JSON 结构中过滤特定年份记录,清洗类型并输出结果。
入口:包含 JSON 数据的磁盘文件(如 population_data.json)。
动作:使用 json.load() 反序列化文件流至内存列表,遍历条目匹配目标年份,进行字符串转浮点再转整数的数值清洗,最后通过映射函数补全国别码。
参数:filename='population_data.json',目标年份 '2010'。
完成状态:控制台逐行打印 国别码:人口数 格式的输出,未匹配项显示 ERROR- 前缀。
import json
from Country_codes import get_country_code

# 提取相关数据
filename = 'population_data.json'
with open(filename, encoding='utf-8') as f:
    pop_data = json.load(f)

    for pop_dict in pop_data:
        # 获得每个国家2010年的人口数量
        if pop_dict['Year'] == '2010':
            country_name = pop_dict['Country Name']
            population = int(float(pop_dict['Value']))  # 先转浮点后转整数,防科学计数法残留
            code = get_country_code(country_name)
            if code:
                print(f'{code}:{population}')
            else:
                print(f'ERROR-{country_name}')
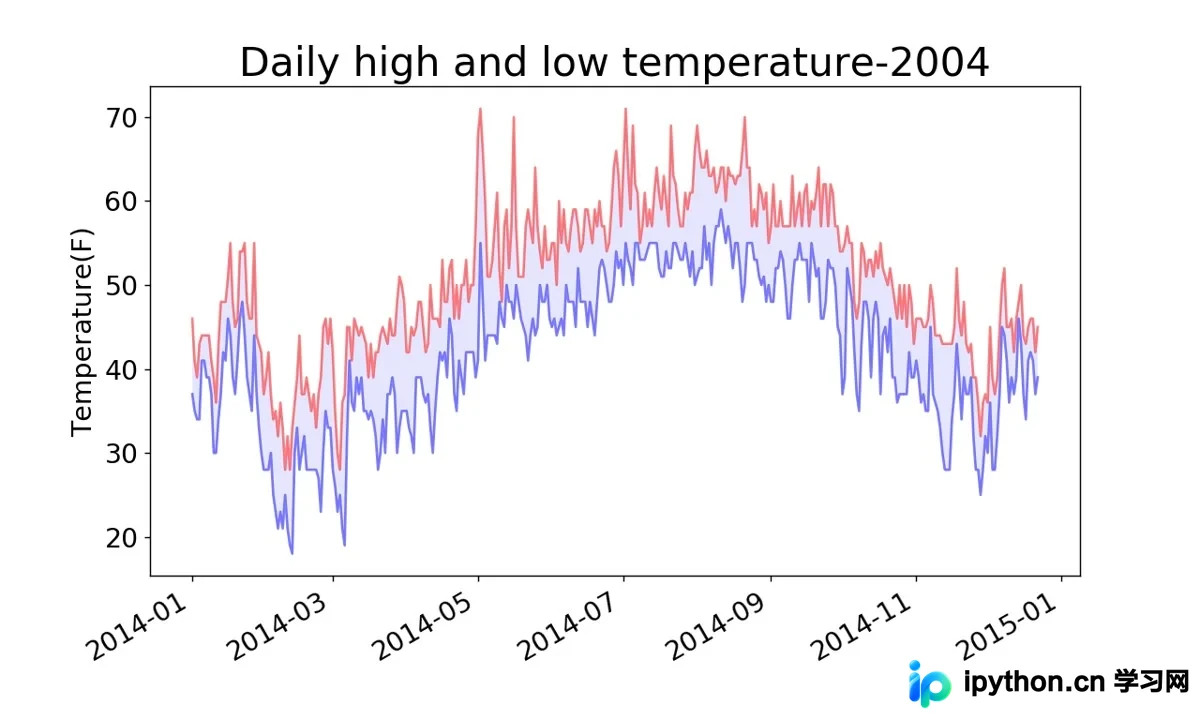
第三步:解析 CSV 气象数据并绘制折线图表
目的:将逗号分隔的原始文本转化为有序时间序列,渲染高低温度趋势及波动区间。
入口:CSV 源文件(如 sitka_weather_2014.csv)。
动作:通过 csv.reader 创建迭代器,跳过表头后按索引切片读取日期与温湿度列,使用 datetime.strptime 统一时间格式,最后调用绘图接口设置线条颜色、透明度与填充区域。
参数:dpi=128, figsize=(10,6), 图例色块 alpha=0.5 与 alpha=0.1。
完成状态:弹窗或静态文件展示带有斜向日期轴的平滑曲线,高低温差区域被蓝色半透明渐变覆盖。
import csv
from matplotlib import pyplot as plt
from datetime import datetime

# 读取CSV文件数据
filename = 'sitka_weather_2014.csv'
with open(filename, encoding='utf-8') as f:
    reader = csv.reader(f)
    header_row = next(reader)
    dates, highs, lows = [], [], []

    for row in reader:
        current_date = datetime.strptime(row[0], '%Y-%m-%d')
        dates.append(current_date)
        highs.append(int(row[1]))
        lows.append(int(row[3]))

# 根据数据绘制图形
fig = plt.figure(dpi=128, figsize=(10, 6))
plt.plot(dates, highs, c='red', alpha=0.5)
plt.plot(dates, lows, c='blue', alpha=0.5)
plt.fill_between(dates, highs, lows, facecolor='blue', alpha=0.1)
plt.title('Daily High and Low Temperature - 2014', fontsize=24)
plt.xlabel('', fontsize=16)
plt.ylabel('Temperature (°F)', fontsize=16)
plt.tick_params(axis='both', which='major', labelsize=16)
fig.autofmt_xdate()
plt.show()
第四步:将 CSV 表格批量转换为 JSON 对象
目的:将面向人工阅读的行列文本重构为键值对结构,适配前端传输或数据库入库。
入口:任意 CSV 文件路径及对应的表头字段列表。
动作:逐行读取并清理换行符,按分隔符切分字符串,使用 zip 将字段名与单元格值配对生成字典列表,最终通过 json.dumps 序列化写入新文件。
参数:需提前核对 keys 列表顺序与 CSV 列顺序严格一致,编码建议使用 GB232 或 utf-8 匹配源文件。
完成状态:目标路径下生成格式规范的 .json 文件,打开后呈现缩进整齐的树状结构。
import json

f = open("D:/文件/资料/GT.csv", "r", encoding='utf-8')
data_lines = f.readlines()
f.close()
data_lines.pop(0)  # 剔除表头行

values = []
for line in data_lines:
    line = line.replace("\n", "")
    values.append(line.split(","))

# 请根据实际数据列名替换下方 keys 列表,保持顺序一致
keys = ["stamp_sec", "obj_stamp_sec", "frame_num", "source", "id", "track_id",
        "lane_id", "center_x", "center_y", "center_z", "closest_point_x",
        "closest_point_y", "closest_point_z", "velocity_x", "velocity_y",
        "type", "is_tracked", "height", "length", "width"]

# 构建字典列表并导出
fw = open("output_data.json", "w", encoding='utf-8')
dict_re = [dict(zip(keys, row)) for row in values] if values else None
a = json.dumps(dict_re, indent=4, ensure_ascii=False)
fw.write(a)
fw.close()
print("CSV已成功转换为JSON格式。")
排错与注意事项
UnicodeDecodeError:若读取 CSV 或 JSON 时报编码错误,请显式指定 encoding='gbk' 或 encoding='latin1' 重试。
索引越界:CSV 示例中使用硬编码索引(如 row[1]),实际项目中建议先读取表头计算列序号,避免因格式变更导致错位。
日期格式化:不同地区 CSV 可能使用 %Y/%m/%d 或带空格的时间戳,需同步调整 strptime 模板。
绘图中文乱码:若标题或坐标轴显示方块,可在代码顶部添加 plt.rcParams['font.sans-serif'] = ['SimHei'] 并配合 plt.rcParams['axes.unicode_minus'] = False 修复。
简要总结
通过原生 json 与 csv 模块的组合,Python 能够快速打通从磁盘文件到内存对象的转换链路。筛选逻辑依靠字典遍历与类型断言,可视化环节借助 matplotlib 的链式 API 实现细节控制,格式迁移则依赖 zip 与序列化方法保证键值对齐。规范使用上述模式,可有效支撑日志分析、报表生成与数据交接等常规工程场景。以上就是使用 Python3 高效处理 JSON 与 CSV 数据的详细内容,更多关于 Python 数据解析与可视化分析的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















