


《Python3网络爬虫开发实战》与Scrapy相关书籍对比:哪本更适合进阶?
深度对比《Python3网络爬虫开发实战》与Scrapy专著的知识体系、技术侧重点与进阶场景,从反爬攻防到高并发采集架构,帮助爬虫开发者精准选书。
如果你的进阶瓶颈在于“目标网站反爬严重,经常拿不到数据或逆向解不开”,那么涵盖 JavaScript 逆向、AST 混淆、App 逆向与自动化攻防的《Python3网络爬虫开发实战》是更直接有效的进阶指南;如果你的瓶颈在于“单机吞吐受限、中间件扩展困难、调度器需要重写或千亿级抓取调度不稳”,那么深入讲解 Twisted 事件驱动机制与框架微内核定制的 Scrapy 专著则是更扎实的工程底座。
一、进阶诉求与书籍核心定位差异
很多开发者在完成基础爬虫(使用 Requests 发起请求、BeautifulSoup 或 XPath 解析数据、基础多线程入库)后,都会产生强烈的“进阶”需求。但在实际工作中,“进阶”至少包含两个截然不同的技术演进方向:
- 攻防对抗与全栈逆向方向:核心关注点是“如何突破防线拿到数据”。这包括破解前端 JS 混淆、还原动态签名加密参数(如 Token、Signature)、绕过 TLS/JA3 指纹检测、突破滑块或行为验证码,以及对移动端 App 执行脱壳、Hook(Frida/Xposed)与协议抓包。
- 高并发采集架构与框架微内核方向:核心关注点是“如何在复杂分布式环境下稳定高效地采集海量数据”。这包括理解异步非阻塞 I/O 机制、深度定制调度优先级、重构 Pipeline 持久化逻辑、开发自定义 Downloader Middleware 处理动态代理与会话,以及构建高可用监控与故障自愈系统。
在这两个方向上,《Python3网络爬虫开发实战》(以崔庆才第2版为代表)与市面上的 Scrapy 专著(如刘硕的《精通Scrapy网络爬虫》等)给出了完全不同的侧重点与知识布局。
二、技术内容深度对比:不同层面的技术壁垒
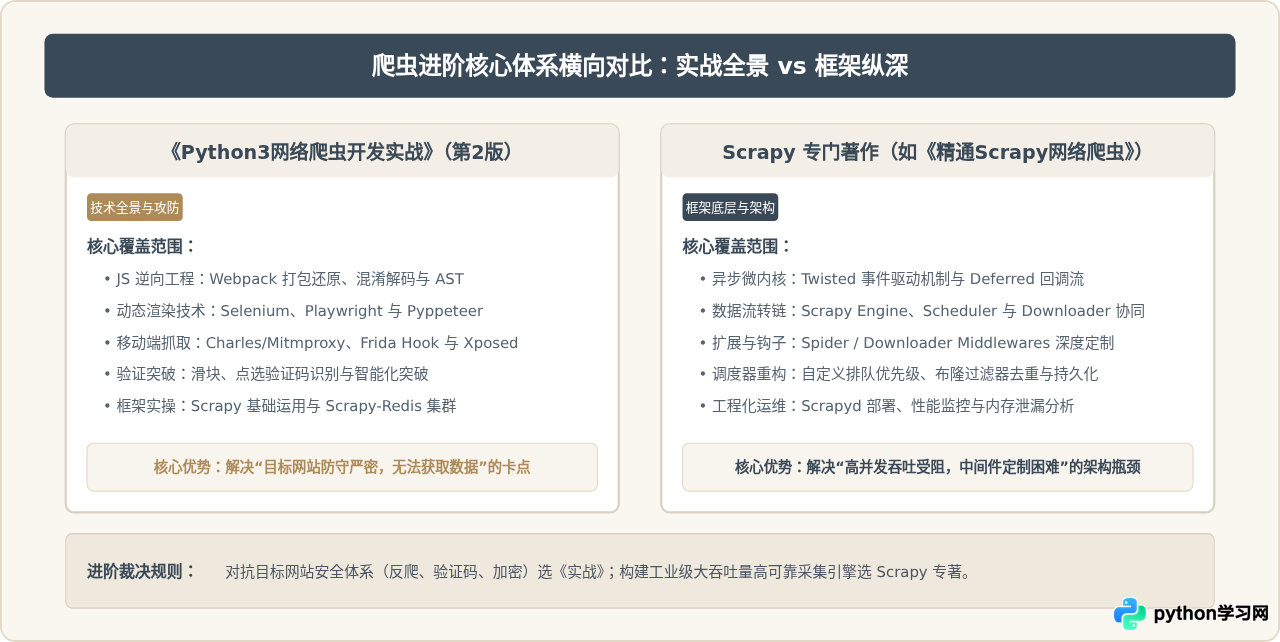
为了清楚评估哪本书适合当前的你,需要拆解两者在内容组织、核心技术讲解上的具体深度差异。
| 对比维度 | 《Python3网络爬虫开发实战》(第2版) | Scrapy 深度专著(如《精通Scrapy网络爬虫》) |
|---|---|---|
| 内容组织模式 | 以爬虫生命周期与反爬攻防为主线,由浅入深覆盖现代采集的全部技术拼图。 | 以 Scrapy 框架架构为单一主轴,自底向上彻底剖析组件通信与内部扩展机制。 |
| 逆向与反爬深度 | 极深。从浏览器断点调试、AST 语法树还原,到 Frida Hook 与 RPC 远程调用,实操性极强。 | 涉及较浅。通常仅在下载器中间件中演示如何更换 User-Agent 或接入代理 IP,不深入前端加解密。 |
| 框架底层原理 | 偏重实用。重点介绍 Scrapy 各组件的常规用法及与 Redis 结合实现分布式爬虫。 | 极深。彻底剖析 Twisted 异步 Reactor、线程池与协程、信号分发机制及核心调度算法。 |
| 并发与性能调优 | 讲解基于多进程、异步库 aiohttp 以及分布式部署的宏观扩展方法。 | 精细剖析并发请求数(CONCURRENT_REQUESTS)、下载延迟、连接池管理及内存泄漏排查。 |
| 技术时效敏感度 | 高。前端反爬手段和工具链更新迭代极快,部分案例需要读者具备独立排查和抓包演进能力。 | 稳定。Scrapy 框架内核机制相对稳定,核心架构理念(微内核+管道+中间件)长期通用。 |
1. 逆向工程:爬虫工程师的分水岭
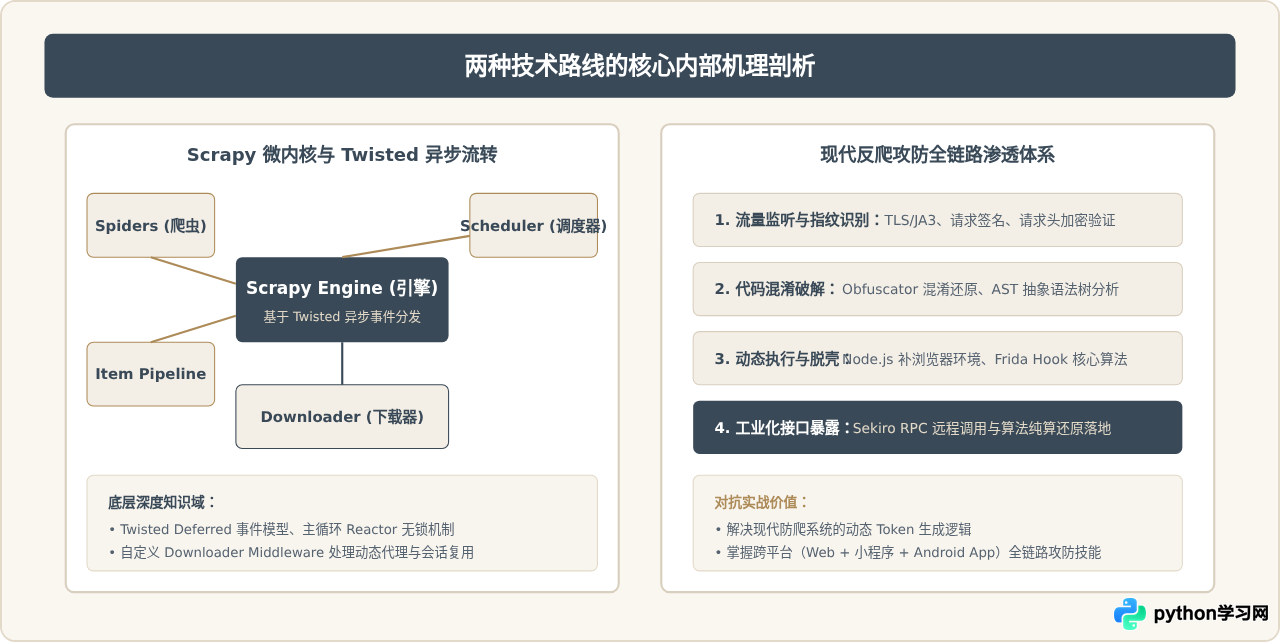
在当前实际业务中,超过 70% 的商业网站和主流 App 均采用了不同程度的前端混淆与接口防护。例如常见的时间戳混淆签名、AES/RSA 请求体加密、Canvas 指纹采集以及基于 Webpack 的模块化打包。《Python3网络爬虫开发实战》花费了大量篇幅讲解如何利用 Chrome 开发者工具进行 XHR 断点、代码单步调试、补齐 Node.js 执行环境,以及通过 Babel 操作 AST 对被混淆的代码进行变量还原。
而这一部分,恰恰是几乎所有 Scrapy 专著都不会深入探讨的领域。Scrapy 的假设前提是“给出一个 Request 就能获得 Response”,它的设计哲学专注于“如何以最高吞吐量调度并处理这些请求”。如果你的日常开发卡在“不知道接口的 _signature 是怎么算出来的”,那么翻阅 Scrapy 专著是无法直接得到答案的。
2. 框架内核:从“会用框架”到“驾驭框架”
许多开发者虽然在简历上写着“熟练使用 Scrapy”,但一旦遇到复杂场景往往束手无策:
- 遇到需要根据响应动态调整特定域名的请求并发度,而不是全局降速;
- 遇到内存占用随时间单调递增,无法定位是未释放的 Response 引用还是闭包泄漏;
- 需要编写一个支持优先级动态插队的自定义 Scheduler,替代默认的 FIFO/LIFO 队列;
- 需要让 Scrapy 支持特定协议的非标准传输层加密。
Scrapy 专著的不可替代性正在于此。它会详细向你解释:Scrapy 不是多线程,而是基于 Twisted 的单线程事件循环。Engine 是如何通过 Deferred 链式回调与 Downloader 协作的?各个 Middlewares 的 process_request、process_response 和 process_exception 是如何按顺序形成责任链模式的?只有理解了这些,你才能真正拥有修改框架、编写通用企业级中间件的能力。
三、具体代码与落地模式的差异
为了更清晰地说明这种技术差异,我们可以通过一个实际的业务场景进行对比:当目标网站的详情页接口需要携带动态计算的加密参数 sign 时,两本书所指导的技术落地路径完全不同。
1. 逆向攻防视角(《Python3网络爬虫开发实战》路径)
重点在于通过前端断点定位加密函数,利用 Node.js 补齐 window、document、navigator 等浏览器环境后,通过 RPC 或本地算法提取 sign 的生成逻辑:
# 典型的逆向还原落地:Python 与 JavaScript 算法层交互
import execjs
import requests
import time

# 读取通过 AST 还原或环境补齐后的核心加密逻辑 JS 文件
with open('decrypt_sign.js', 'r', encoding='utf-8') as f:
    js_code = f.read()

ctx = execjs.compile(js_code)

def fetch_protected_data(page):
    timestamp = int(time.time() * 1000)
    # 调用逆向解析出来的动态签名函数
    sign = ctx.call('getSignature', page, timestamp)

    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36',
        'X-Sign': sign,
        'X-Timestamp': str(timestamp)
    }
    url = f'https://api.example.com/items?page={page}'
    resp = requests.get(url, headers=headers)
    return resp.json()
2. 框架微内核视角(Scrapy 专著路径)
重点在于将加密逻辑解耦并封装进定制的 Downloader Middleware,让整个抓取过程自动化接入调度队列,同时结合 Twisted 异步特性避免在主线程中阻塞事件循环:
# Scrapy 内部机制落地:自定义下载器中间件与请求预处理
import time
from scrapy.exceptions import IgnoreRequest

class SignatureMiddleware:
    def __init__(self, signer_service):
        self.signer = signer_service

    @classmethod
    def from_crawler(cls, crawler):
        # 深度绑定 Scrapy 配置中心与爬虫生命周期信号
        signer = crawler.settings.get('SIGNER_INSTANCE')
        return cls(signer)

    def process_request(self, request, spider):
        # 拦截所有外发请求,根据 Spider 属性动态注入加密头
        if not request.meta.get('skip_sign', False):
            ts = int(time.time() * 1000)
            token = self.signer.compute(request.url, ts)
            request.headers['X-Sign'] = token
            request.headers['X-Timestamp'] = str(ts)
        return None  # 继续流转至下一个下载器中间件或底层下载引擎
getSignature 算法逆向出来,然后通过 Scrapy 专著中的中间件与事件驱动架构,把这个算法无缝装配进高并发采集集群中。
四、进阶选书决策指南:你该如何选择?
选择哪本书更适合你当前的进阶,取决于你现阶段的技术短板和团队任务目标。请根据以下决策逻辑进行自我诊断:
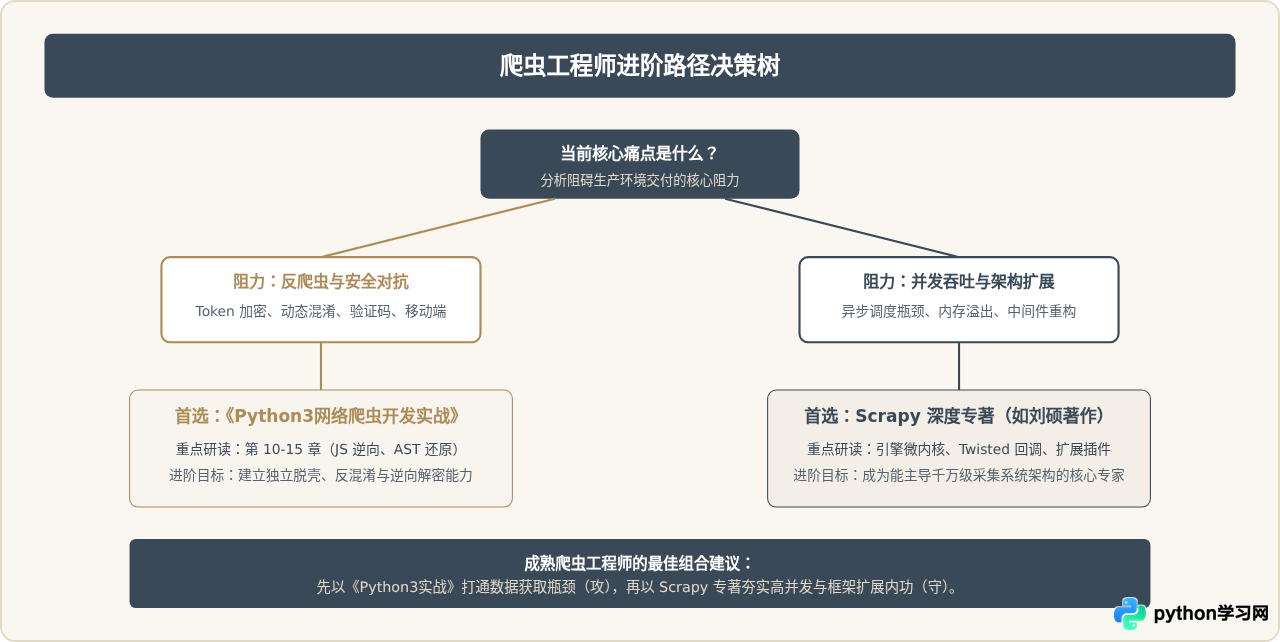
场景一:优先选《Python3网络爬虫开发实战》(第2版)
- 你当前面临的真实困境:打开网页能看到内容,但抓包发现请求全是密文;或者接口返回的内容是一串类似 AES/DES 加密后的 base64 字符串;又或者目标页面带有极强的反调试手段(如无限 debugger、内存溢出陷阱)。
- 需要解决的业务类型:涉及电商价格监控、短视频数据抓取、舆情平台监测、移动端专用 API 抓取等强对抗场景。
- 获得的能力跃迁:不再依赖易被封禁的无头浏览器自动化硬爬,而是能够定位 JS 原生函数、进行本地补环境执行(Node.js vm/vm2)、利用 AST 还原混淆代码,并在移动端通过 Frida 进行函数 Hook 与内存抓包。
场景二:优先选 Scrapy 深度专著
- 你当前面临的真实困境:已经掌握了基本的抓包和解密,但编写的爬虫脚本结构松散;单机爬虫遇到成百上千万 URL 时,调度容易丢失、状态难以持久化;或者多机协同抓取时去重效率极低、内存消耗难以控制。
- 需要解决的业务类型:构建垂直搜索引擎索引、海量公开政务或文献库全量抓取、搭建企业内部标准化的爬虫基础设施。
- 获得的能力跃迁:深入理解底层 Twisted 异步驱动模型,能够编写通用的 Downloader Middleware、Spider Middleware 和 Extension;掌握基于布隆过滤器(Bloom Filter)的分布式海量去重算法;能够对爬虫运行状态进行实时监控并在节点崩溃时平滑恢复。
五、进阶阅读与落地注意事项
在选定书籍进行进阶学习时,还有几个关键的工程陷阱和认知误区需要提前规避:
- 不要死记书中的具体网站案例:《Python3网络爬虫开发实战》中的部分案例网站由于前端更新迭代,原有的 DOM 结构或加密参数可能已经变化。学习该书时,务必将重点放在分析方法与工具链使用(例如如何找调用栈、如何设置 XHR 条件断点、如何用 AST 进行变量重命名),而不是生搬硬套某个具体的加密 key。
- 区分业务代码与框架代码:在阅读 Scrapy 专著时,不要只满足于学会
scrapy crawl myspider。重点要研读框架源码中crawler.py、engine.py、scheduler.py的交互逻辑。尝试自己从零编写一个极简版的“异步事件调度循环”,这才是真正吸收了框架的核心价值。 - 避免过度依赖无头浏览器:许多初学者在遇到动态渲染或反爬时,习惯性全面转向 Selenium/Playwright。虽然《实战》一书也介绍了自动化工具,但书中明确指出了其性能缺陷(高 CPU/内存占用、易被浏览器指纹识别)。真正的进阶应当是以协议级还原(纯算逆向或 RPC)为主,自动化渲染仅作为验证兜底手段。
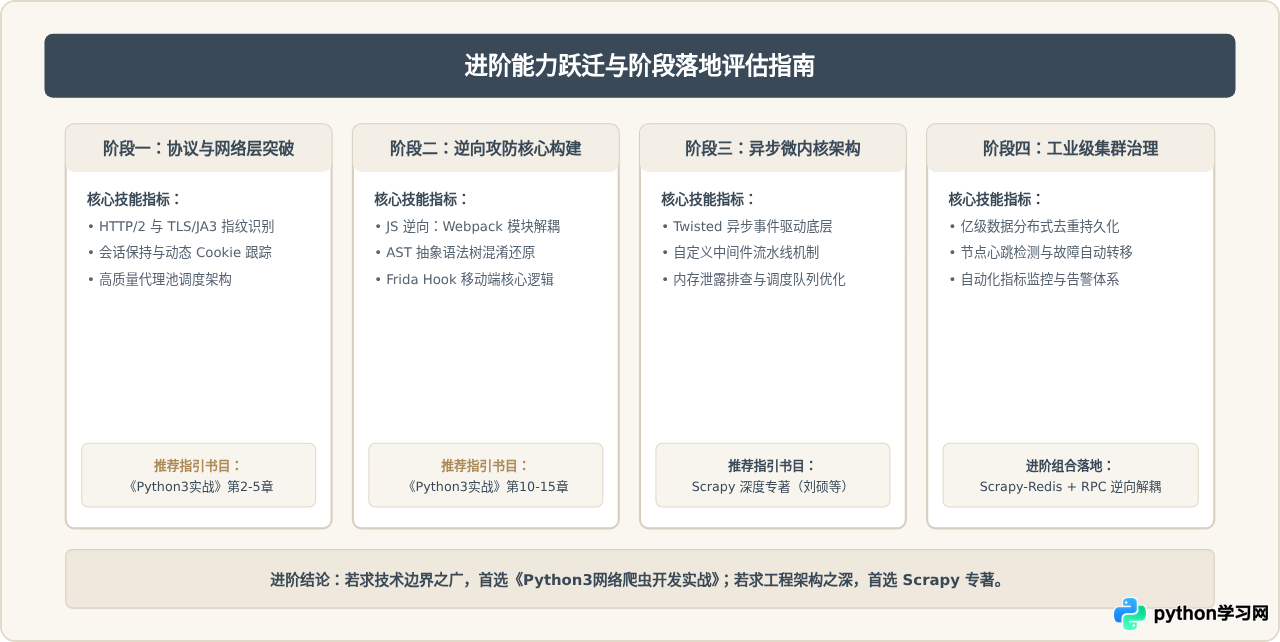
六、总结
《Python3网络爬虫开发实战》与 Scrapy 专著并不存在绝对的高下之分,它们分别对应了现代爬虫工程师在成长路径上的两条核心支柱:
- 如果你目前最渴望突破的是“数据抓取成功率”,经常被各种前端签名、JS 加密混淆、滑块验证或 App 抓包困住,请毫不犹豫地选择《Python3网络爬虫开发实战》作为进阶读物,它能帮你迅速补齐现代反爬攻防所需的全套工具箱;
- 如果你目前负责的是“大规模企业级采集系统”,业务面临海量请求调度、内存优化、中间件高度定制和高并发稳定性的挑战,请认真研读一本 Scrapy 深度专著,它能带你穿透 API 的表层,真正建立起对事件驱动底层机制与工业级框架架构的深刻理解。
最理想的进阶路径,是以《Python3网络爬虫开发实战》中的逆向工程攻克数据输入端的技术防御,再以 Scrapy 专著中的异步框架和微内核设计构建健壮稳定的数据流转中枢,从而真正成为具备全链路攻防与大型架构能力的资深爬虫工程师。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















