


大模型去哪里下载?Hugging Face、ModelScope与Ollama渠道对比
本文对比Hugging Face、ModelScope与Ollama三大主流大模型获取渠道。指出前两者侧重完整权重与开发资料,后者侧重本地运行体验。强调在下载前应明确使用场景(微调研究或本地对话),核对发布来源、文件格式及许可证,避免盲目下载导致环境配置失败或资源浪费。
在电脑上尝试运行大语言模型时,搜索结果往往令人困惑:一边是庞大的模型权重文件列表,一边是简洁的一键安装程序,中间还夹杂着各种量化版本和在线服务。名字看起来都像“下载入口”,点进去才发现,有的只提供原始数据,有的下载后仍需复杂的环境配置,还有的其实根本没有把模型放到本地硬盘。
这里更值得先问的不是哪个网站速度最快,而是你下一步准备拿这个模型做什么。是要研究原始权重、进行微调训练,还是仅仅想在 Windows 电脑上开始一次私密的本地对话?这两种目标所需的“下载”动作截然不同。
**Hugging Face 和 ModelScope 本质上是模型的图书馆与档案室,而 Ollama 则是把借书和阅读过程简化后的阅读器。**它们并非互斥选项,真正的难点在于统一发布来源、文件版本和运行方式,而不是把同一个模型在三个地方各下载一遍。
需要完整资料时,仓库比“下载按钮”更重要
假设你准备把一个模型接入现有的推理框架,或者进行二次开发,首先需要的不仅仅是一个几 GB 的文件,而是完整的模型架构、配置文件、分词器、权重文件以及许可证说明。在这种场景下,Hugging Face 的优势在于它将所有内容组织在标准的模型仓库中。
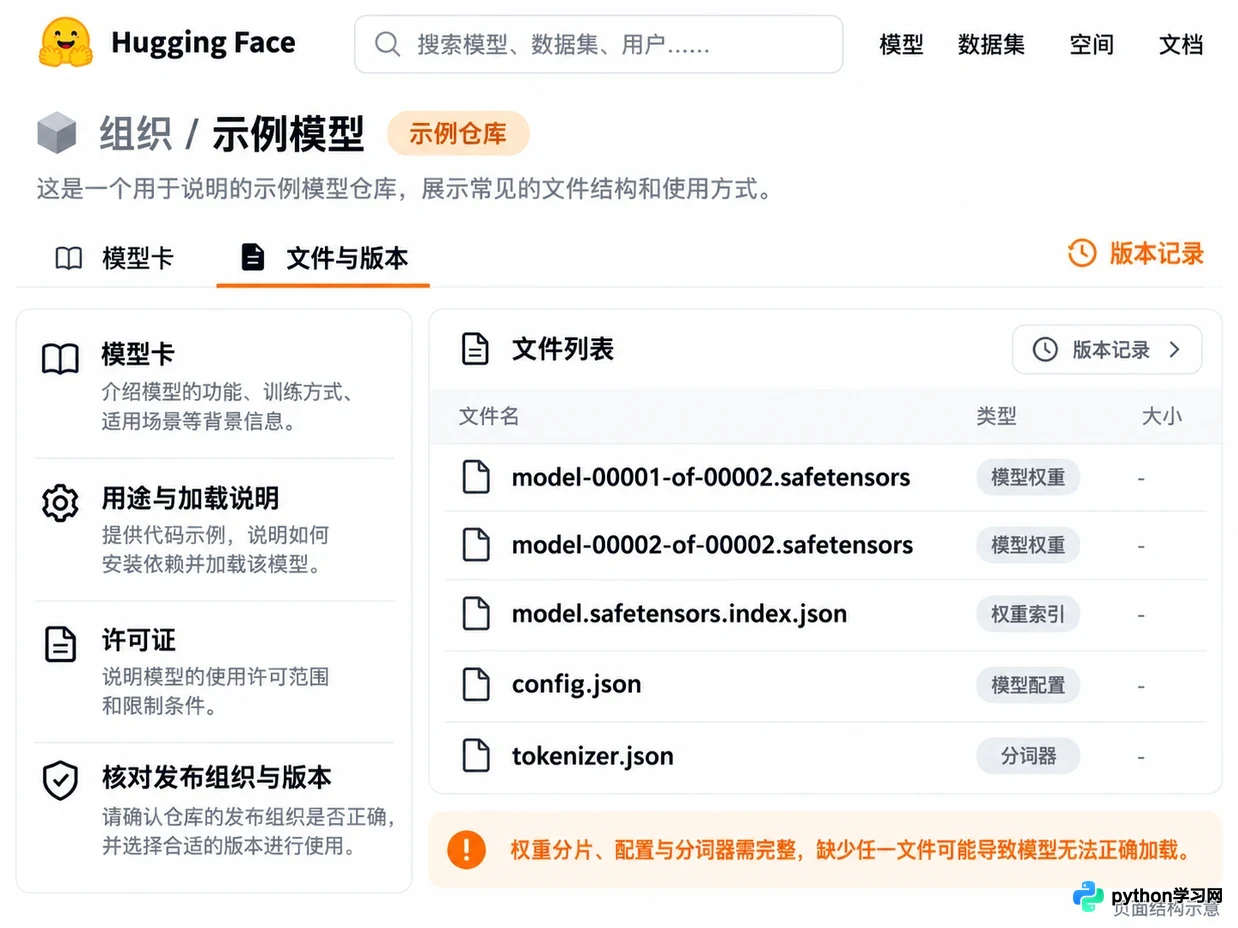
Hugging Face 模型页展示模型卡、文件列表与版本信息
在 Hugging Face 上,模型卡(Model Card)、文件列表、版本记录与所使用的代码库相互关联。在下载之前,你就可以通过阅读模型卡判断它是否适合当前任务。实际查找时,不应只搜索一个模型家族名称,而应先核对发布组织,确认具体仓库是基础版、指令微调版,还是第三方量化版本。
对于开发者而言,按仓库给出的对应库用法下载完整依赖,比手动只抓取一个最大的权重分片更可靠。当模型存在多个分片时,少下载一个文件就可能导致加载失败,不能仅凭已下载文件占用了大量空间就判断其完整性。此外,部分高质量模型需要登录并申请访问权限,遇到这类限制时,应按发布者要求完成授权,切勿寻找来历不明的转存包绕过安全机制。
更熟悉中文资料时,ModelScope可以减少来回切换
另一种常见场景是跟随中文社区的教程或论文复现项目。ModelScope(魔搭社区)的模型页面同样提供详细的模型介绍、文件列表和下载入口,并给出 SDK 或 Git 等获取方式,适合从同一处查看说明并取得对应文件。
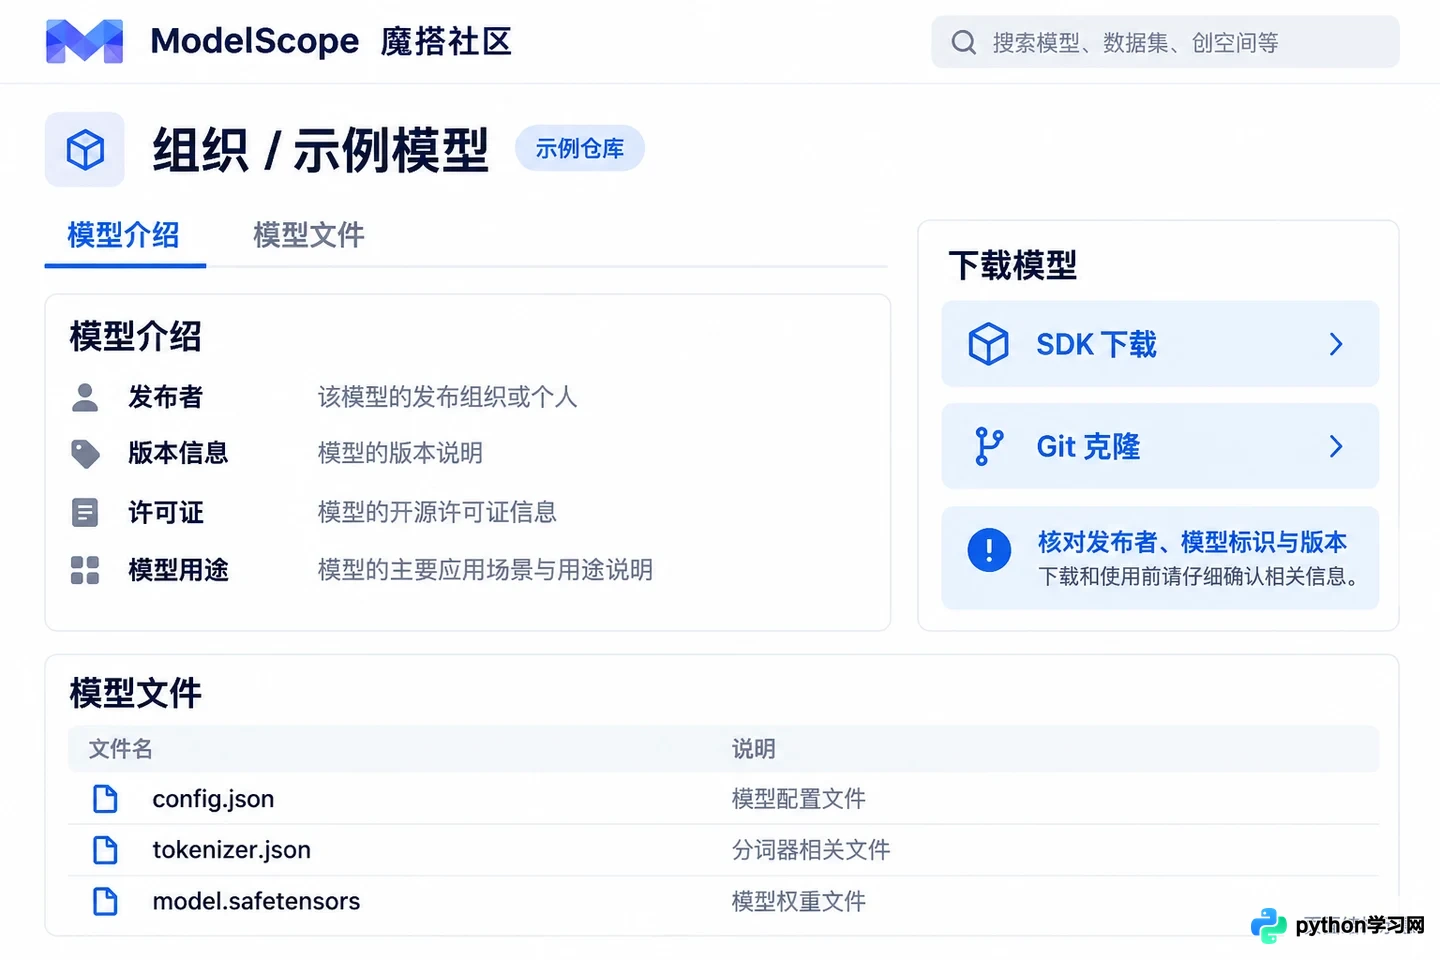
ModelScope 模型页提供中文介绍与多种下载方式
但需要注意的是,“在国内平台找到同名模型”不代表它自动就是原发布方的实时同步副本。在使用 ModelScope 时,应仔细核对组织名称、发布者、更新信息和文件说明,确认这究竟是原模型、转换版本还是社区再发布的内容。如果需要复现某次特定实验,还应记录具体的版本号或修订哈希,不要把滚动更新的主分支当成永远不变的内容。
使用页面提供的下载方法时,必须确保模型标识与你正在查看的仓库一致,保存位置也要明确。尤其是复制社区文章中的示例代码时,不能只替换模型显示名称,却留下另一套仓库标识或旧目录路径。下载完成之后,依然需要与你选择的推理框架、模型架构和依赖版本进行匹配。至于下载速度,受网络环境、文件体积和服务状态影响较大,更实用的策略是先在可信发布者的页面确认所需版本是否齐全,再选择自己能够稳定访问的路径。
只想先本地对话,Ollama把运行准备放到前面
如果目标是让电脑尽快开始一次本地对话,而不是研究完整的训练权重,Ollama 的模型库与运行环境衔接得更为直接。Windows 用户可以直接安装原生应用,安装后在终端或图形界面中选择受支持的模型版本,即可按自己的硬件能力准备本地运行。
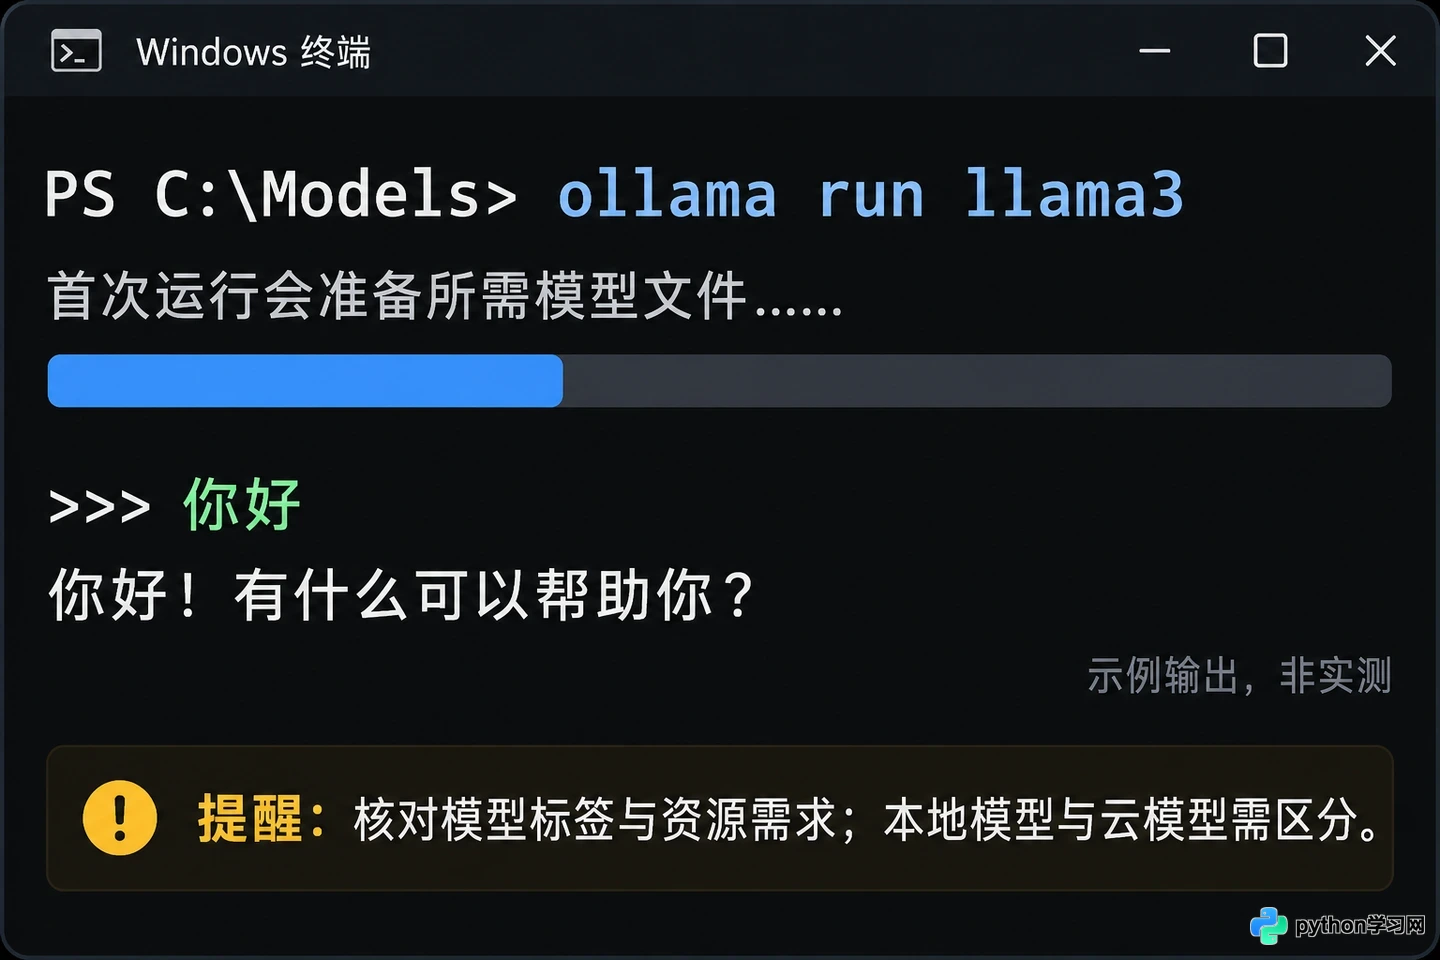
Ollama 在 Windows 终端中拉取并运行本地模型
这种便利性也有其边界。Ollama 中的模型标签并不是“同一家族所有文件”的总称,不同的参数规模、量化方式与上下文配置,会直接影响存储占用和运行资源。选择时先看具体标签的说明与文件大小,再对比电脑的内存、显存及可用磁盘空间,不要因为某个模型名字听起来更强大就直接下载。
如果你手中已有 GGUF 或受支持架构的 Safetensors 权重文件,也可以按 Ollama 官方导入方式进行处理。但不能认为任何后缀相同的文件都能直接运行,GGUF 文件可能存在分片,导入时需要完整保留对应文件;适配模板和量化状态也应按模型说明核对。导入功能不会自动把所有不兼容架构变成可用模型。
还要特别区分本地模型与云模型。Ollama 也提供云端运行方式,使用同一个应用或终端不等于计算一定发生在你的电脑上。若需求是离线使用或不把提示词发送到远端,应明确选择本地模型,并检查云功能设置,而不是只看界面有没有“Ollama”字样。
真正省事的是少下载错一次,而不是少看一页说明
无论选择哪条渠道,都应先把“文件要给谁加载”这个问题说清楚。专业推理框架可能需要完整的配置和分词器,轻量级运行工具可能使用转换或量化后的特定格式,而 LoRA 等适配文件则不一定能脱离对应基础模型独立工作。把这些对象统称为“大模型文件”,很容易导致下载任务做完了,却没有可用的运行组合。
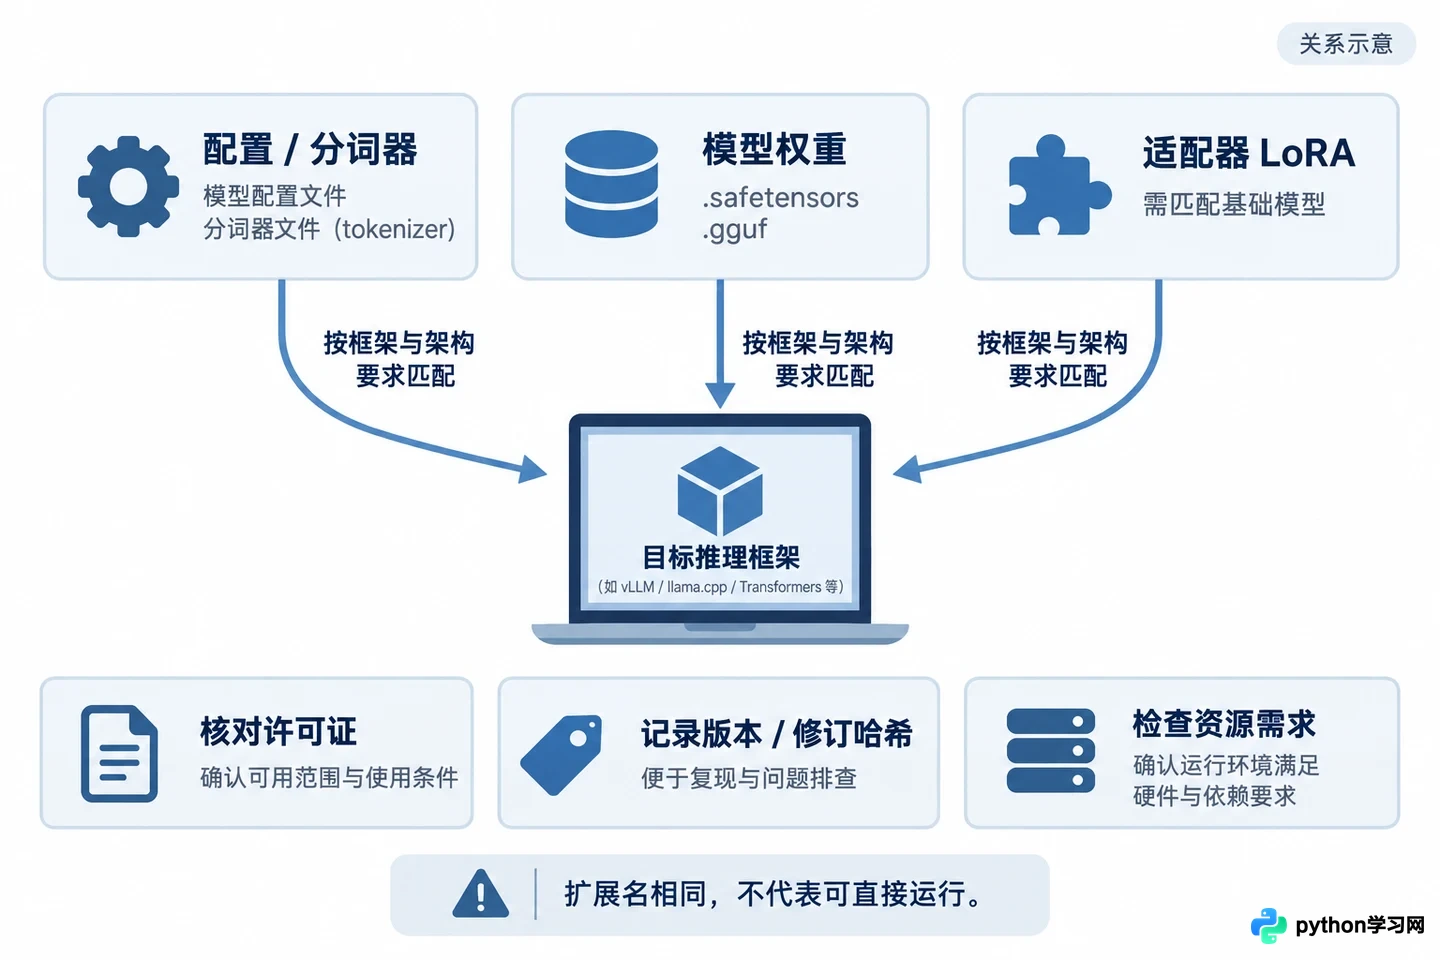
下载前需确认的文件要素与运行环境匹配关系
建议在下载前记下几项关键信息:发布组织与仓库、具体版本或标签、文件格式、目标使用框架、许可证类型以及预估资源需求。这些信息不是为了写文档而存在,而是让你在遇到加载错误、同名版本差异或更换电脑时,清楚地知道自己究竟拿到了什么。
安全方面也不能只看权重文件的扩展名。模型仓库可能附带自定义代码、启动脚本和额外依赖,运行前应检查来源与行为,不随意允许未知仓库执行远程代码。访问令牌只保留必要权限,不放进公开截图或分享脚本中,更不要把第三方打包的一键启动器当成模型发布者本身。
如果只是想尝试一次对话,先在 Ollama 支持的本地模型里选一个资源合适的版本;如果准备开发、微调或精确复现,就从 Hugging Face、ModelScope 的可信仓库获取完整说明与文件。需要时再把仓库里的合适模型导入运行工具,这比争论哪个渠道“最好”更接近真正能用起来的路径。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















