


Python异步爬虫实战:利用aiohttp提升数据采集并发效率
深入讲解如何使用Python的asyncio与aiohttp构建高并发异步爬虫,剖析事件循环原理、ClientSession连接池复用、信号量并发控制及阻塞排查实战方案。
在网络爬虫的实际开发中,数据采集效率往往受限于高延迟的网络 I/O。传统的同步爬虫使用多线程或多进程模型虽然能提升并发,但在面对成千上万个请求时,线程上下文切换的开销和内存消耗会呈指数级上升。基于 Python 内置的 asyncio 协程机制与专为异步 HTTP 设计的 aiohttp 库,可以用单线程事件循环支撑起数千个并发网络请求,在极低系统开销下将采集效率提升数倍至数十倍。本文将从底层工作原理、核心客户端用法、信号量限流控制到避坑排查,完整展开异步爬虫的工程实践。
一、同步阻塞与异步事件循环的本质区别
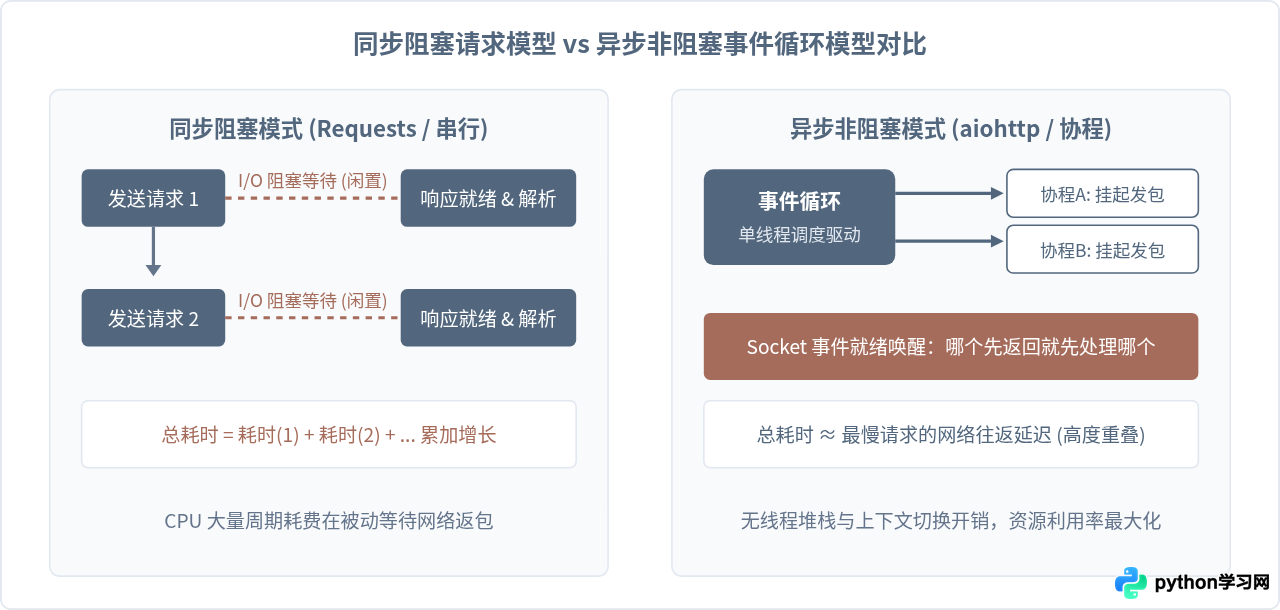
理解异步爬虫效率提升的关键,在于看清网络请求期间 CPU 到底在做什么。标准的 requests 库是完全阻塞式的:当发出一个 GET 请求后,当前执行线程就会被操作系统挂起,直到目标服务器返回响应字节流或超时,这期间 CPU 几乎处于闲置状态。若采集 1000 个网页且每个页面往返耗时 0.5 秒,串行执行就需要整整 500 秒。
而 aiohttp 运行在 asyncio 的事件循环(Event Loop)之上。当协程执行到网络请求并通过 await 挂起时,底层并不会卡死线程,而是向操作系统的非阻塞 Socket 注册事件监听。事件循环会立即把 CPU 控制权交给其他已经准备就绪的协程。当网络数据包抵达网卡并触发 I/O 事件时,事件循环再唤醒对应的协程继续处理响应。这意味着,所有网络延迟都在并发等待中被互相掩盖。
二、aiohttp 基础操作与生命周期规范
在环境准备阶段,只需通过 pip 安装 aiohttp 即可:
pip install aiohttp编写 aiohttp 代码时,最核心的对象是 ClientSession。初学者常犯的一个严重错误是:在每一个请求函数内部都新建并销毁一次 ClientSession。这会导致无法复用底层的 TCP 连接池,反复进行 TCP 三次握手与 TLS 协商,彻底丧失异步性能优势,甚至很快耗尽操作系统的临时端口(TIME_WAIT 堆积)。
规范的做法是:在整个爬虫应用的生命周期内,只维护一个全局或单次批处理上下文的 ClientSession,并通过参数传递给各个子任务协程。
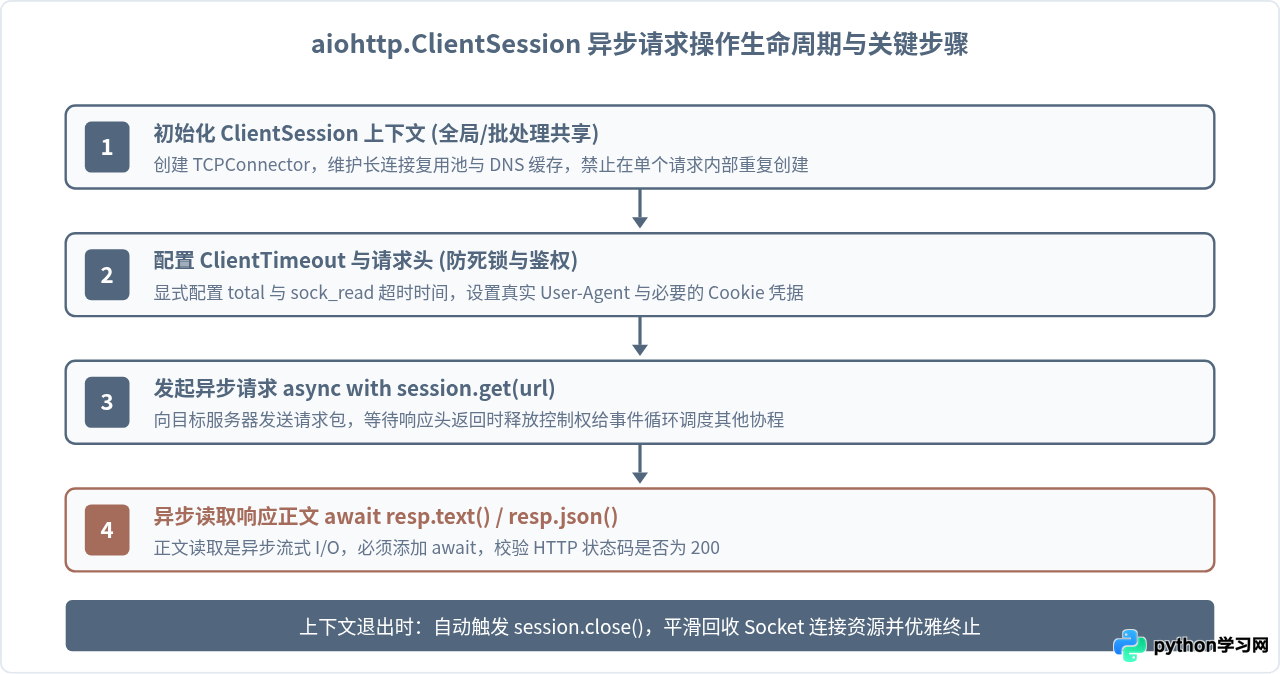
下面是一个标准的单个异步请求函数模板:
import asyncio
import aiohttp

async def fetch(session: aiohttp.ClientSession, url: str) -> str:
    # 设置单次请求超时,避免网络僵死
    timeout = aiohttp.ClientTimeout(total=10)
    try:
        async with session.get(url, timeout=timeout) as response:
            if response.status == 200:
                # 注意:text() 读取响应体也是异步操作,必须加 await
                return await response.text()
            else:
                return ""
    except asyncio.TimeoutError:
        print(f"请求超时: {url}")
        return ""
    except aiohttp.ClientError as e:
        print(f"网络客户端异常: {url}, 错误: {e}")
        return ""
三、核心实战:利用 Semaphore 精确控制高并发
掌握了单个请求的发起方法后,初学者很容易直接将几千个 URL 打包进 asyncio.gather(*tasks) 一瞬间全部发出去。这种“无节制并发”在生产环境中是非常危险的:
- 本地资源耗尽:操作系统对进程能够打开的最大文件描述符(File Descriptors / Sockets)有严格限制(Linux/Mac 下通常默认 1024)。一次性发起数千个请求会直接触发
OSError: Too many open files。 - 目标站点风控拉黑:瞬间千级 QPS 的洪峰流量会直接触发目标站点的 WAF 熔断或限流策略,返回大量
429 Too Many Requests或403 Forbidden,甚至导致测试 IP 被封禁。
解决高并发控制的标准方案是使用 asyncio.Semaphore(异步信号量)。信号量相当于一个并发令牌桶,只有拿到令牌的协程才能发起网络请求;请求完成后归还令牌,等待中的协程才能继续执行。
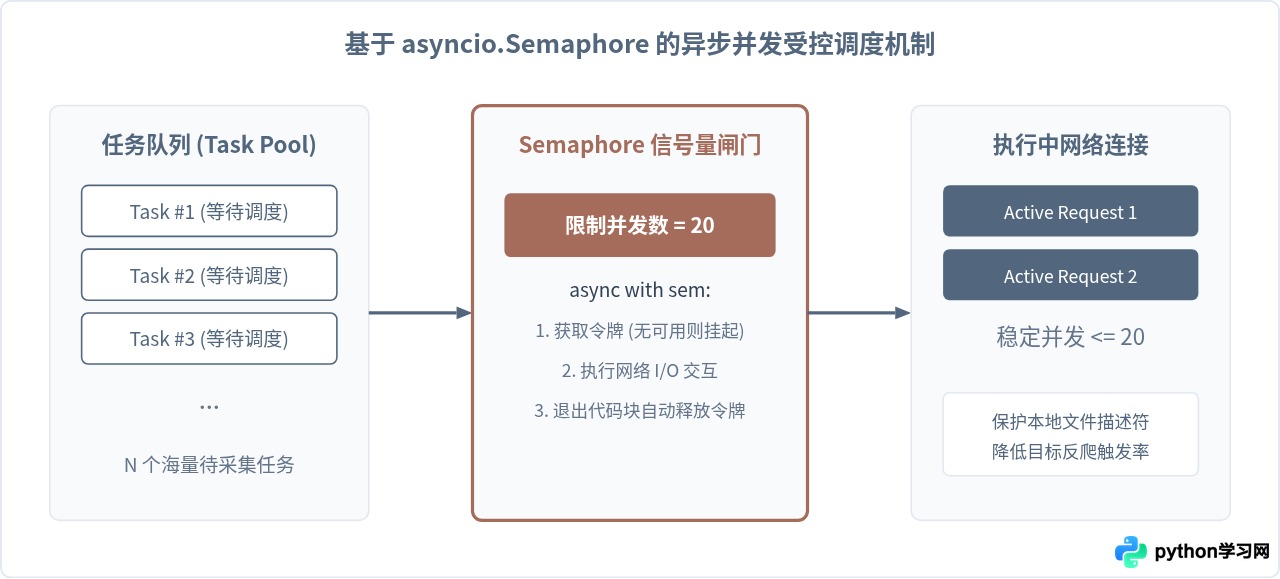
完整实战代码示例
以下为一个可直接执行的生产级采集结构模板,包含 Session 复用、Semaphore 控频、批量任务分发及异常隔离:
import asyncio
import aiohttp
from typing import List

# 限制最大并发数为 20
CONCURRENCY_LIMIT = 20
sem = asyncio.Semaphore(CONCURRENCY_LIMIT)

async def fetch_with_semaphore(session: aiohttp.ClientSession, url: str) -> str:
    async with sem:
        # 获取令牌后发起请求
        timeout = aiohttp.ClientTimeout(total=8)
        try:
            async with session.get(url, timeout=timeout) as response:
                if response.status == 200:
                    data = await response.text()
                    print(f"成功采集: {url} (长度: {len(data)})")
                    return data
                else:
                    print(f"状态码异常 {response.status}: {url}")
                    return ""
        except Exception as e:
            print(f"采集失败: {url}, 错误: {e}")
            return ""

async def main(urls: List[str]):
    # 配置 TCPConnector 参数
    connector = aiohttp.TCPConnector(limit=100, ssl=False)
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
    }

    async with aiohttp.ClientSession(connector=connector, headers=headers) as session:
        # 组装任务列表
        tasks = [fetch_with_semaphore(session, url) for url in urls]
        # 并发执行并等待全部返回
        results = await asyncio.gather(*tasks, return_exceptions=True)

        valid_results = [r for r in results if isinstance(r, str) and r]
        print(f"全部采集结束,有效返回: {len(valid_results)}/{len(urls)}")

if __name__ == "__main__":
    test_urls = [f"https://httpbin.org/get?id={i}" for i in range(100)]
    asyncio.run(main(test_urls))
四、常见陷阱与避坑排查
在异步爬虫开发中,许多代码语法上能通过,但在实际运行时却出现了“虽然写了 async,速度却依然像同步一样慢”或者“程序突然卡死假死”的情况。以下是三项最容易踩中的陷阱:
1. 混入同步阻塞调用导致事件循环被冻结
在协程内部绝对不能调用任何同步阻塞的 I/O 函数,例如 time.sleep()、requests.get() 或是密集的文件本地读写 open().write()。由于所有协程都运行在同一个线程中,一旦某个协程调用了 time.sleep(1),整个线程都会被操作系统冻结,这会导致事件循环停止轮询,其他的 1000 个网络请求也全部停滞。
await asyncio.sleep();若有必须调用的同步 CPU 密集型函数或阻塞库,必须使用 loop.run_in_executor(None, sync_func, *args) 将其扔进后台线程池执行,切勿直接在协程主路径中调用。
2. 大文件直接 await response.read() 导致内存爆仓
采集图片、PDF 或超大文本时,一次性 await response.read() 会把全部数据载入内存。当有数百个并发时,内存会被瞬间撑爆。此时应使用流式异步迭代器:
async with session.get(file_url) as resp:
    with open("local_file.dat", "wb") as f:
        async for chunk in resp.content.iter_chunked(1024 * 64):
            f.write(chunk)
3. Windows 环境下的 EventLoopPolicy 兼容问题
在 Python 3.8+ 的 Windows 平台上,默认的事件循环实现为 ProactorEventLoop。在爬虫执行完毕关闭循环时,有时会抛出 RuntimeError: Event loop is closed 异常。这通常是因为底层传输层关闭尚未彻底完成。可以在程序入口处显式设置事件循环策略:
import sys
if sys.platform.startswith("win"):
    asyncio.set_event_loop_policy(asyncio.WindowsSelectorEventLoopPolicy())
五、异步爬虫架构调优与选型总结
要构建一个高可靠、高效率的 Python 异步爬虫系统,必须在架构设计上形成体系。下方的总结图概括了工业级 aiohttp 爬虫的四层核心调优维度与最佳工程实践:
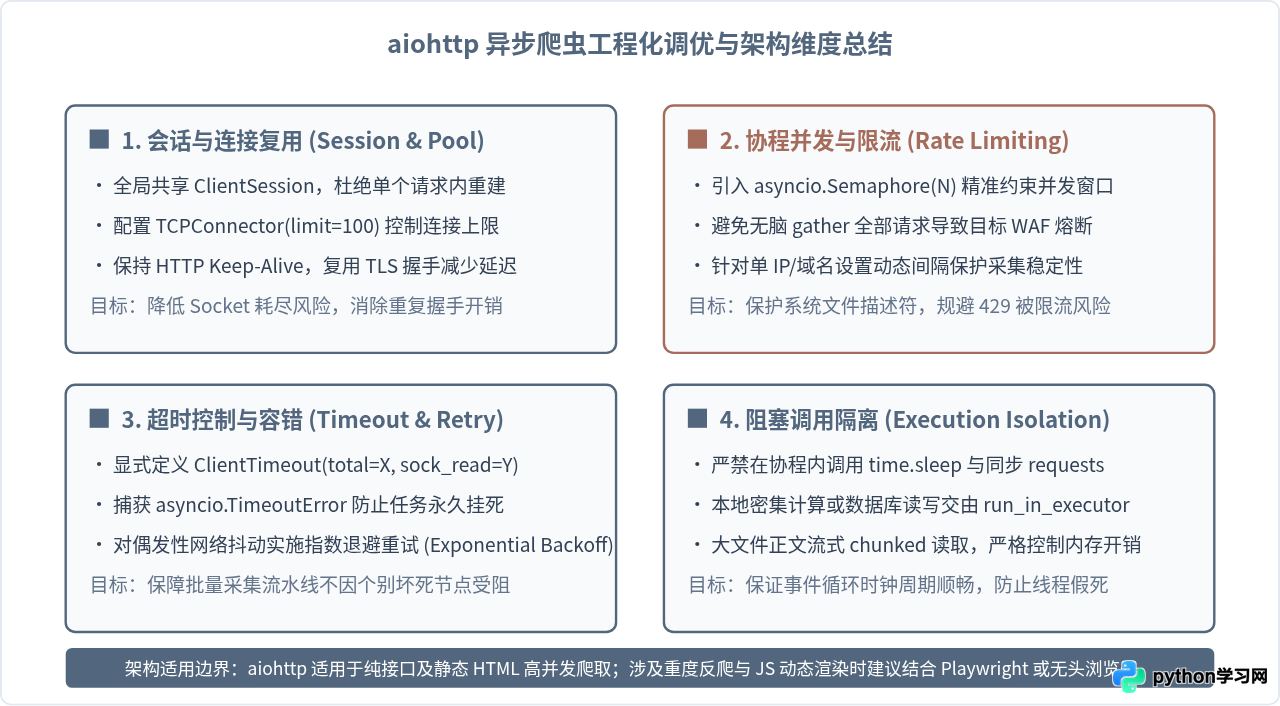
综上所述,利用 aiohttp 提升爬虫采集效率,本质上是用单线程内的非阻塞协程调度替代低效的线程等待与线程切换。在实际工程中,唯有结合 ClientSession 的持久复用、asyncio.Semaphore 的平滑限流以及严格的阻塞隔离,才能在保障本地与远程服务器安全稳定的前提下,真正释放出数倍乃至数十倍的并发采集性能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















