


使用aiohttp和asyncio实现Python异步高并发数据抓取
深入解析如何利用Python的asyncio标准库与aiohttp异步HTTP客户端构建高性能网络数据抓取系统,涵盖事件循环原理、连接池优化、并发限流与异常重试机制。
asyncio 提供了事件循环与协程机制,结合专为异步设计的 HTTP 客户端 aiohttp,可以在单线程内同时挂起并轮询海量并发请求,将网络抓取吞吐量提升十倍至数十倍。本文将围绕异步底层机制、标准开发步骤、并发限流控制以及容错保障展开具体讲解。
一、为什么同步抓取慢:理解异步 I/O 核心机制
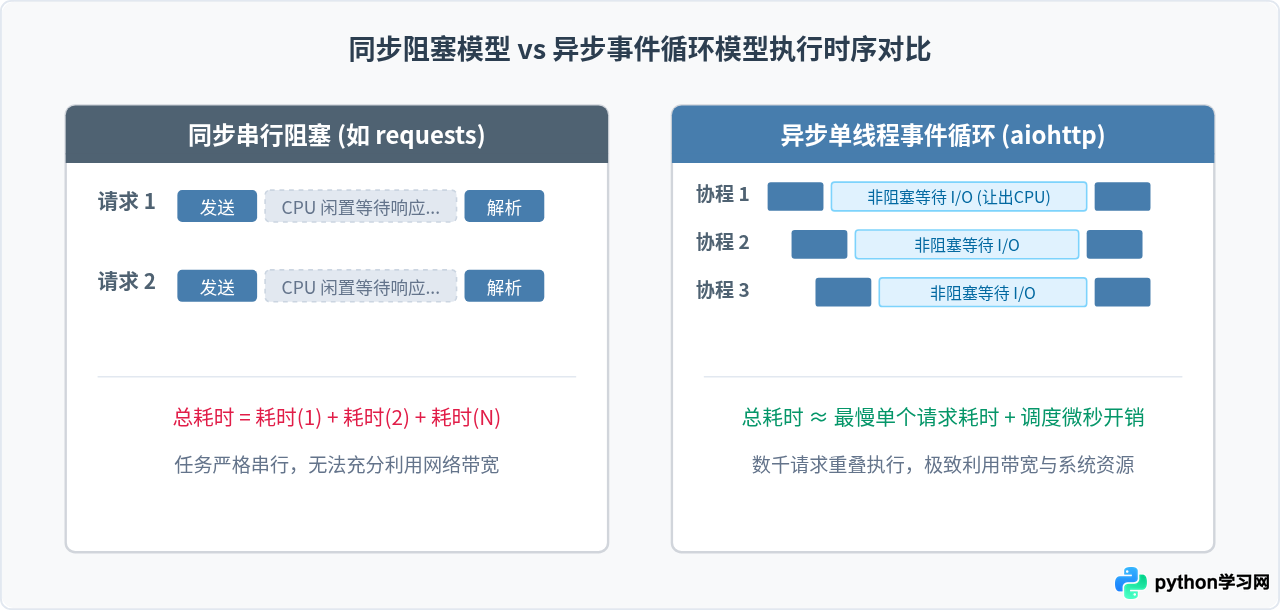
网络数据抓取本质上是典型的 I/O 密集型任务。在传统的同步模式下,程序发出 HTTP 请求后,CPU 会一直处于闲置状态,直到目标服务器返回响应字节或超时断开。如果抓取 1000 个页面,每个页面耗时 0.5 秒,串行执行便至少需要 500 秒。即使使用多线程或多进程,也会受限于操作系统线程切换开销与内存占用,无法支撑上千规模的高并发。
异步模式的核心是“事件循环(Event Loop)”与“协程(Coroutine)”。当某个请求发出后,底层套接字处于等待状态,协程通过 await 主动让出 CPU 控制权;事件循环立即切换去触发下一个请求。当某个套接字接收到响应就绪信号时,事件循环再唤醒对应的协程继续读取数据。整个过程在单个系统线程中运行,没有锁争用和线程上下文切换的损耗,能够用极低的硬件开销维持高吞吐。
二、核心操作步骤:从单请求到任务批处理
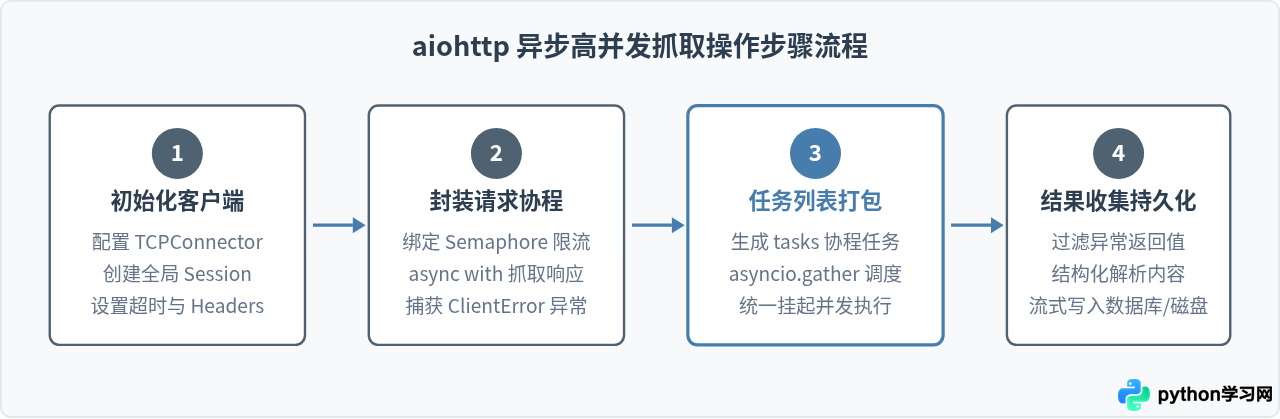
实现异步抓取主要分为四个关键步骤:配置运行环境、封装基于 Session 的下载协程、构造任务清单并交给事件循环并发调度、统一收集解析结果。
1. 环境安装与基础依赖
在终端中安装 aiohttp,推荐同时安装 aiodns 以获得更快速的异步域名解析支持:
pip install aiohttp aiodns2. 正确维护 ClientSession 的生命周期
初学者常犯的一个错误是:在每个抓取函数内部都调用 aiohttp.ClientSession()。这会导致频繁创建和销毁底层 TCP 连接池,失去连接复用(Keep-Alive)的优势,甚至触发系统文件句柄耗尽错误。
正确做法是:在整个主任务中维持单一全局 ClientSession,将其作为参数传递给各个下载子协程,或者在异步上下文管理器中统一调度。
三、并发控制:信号量(Semaphore)与连接池限制
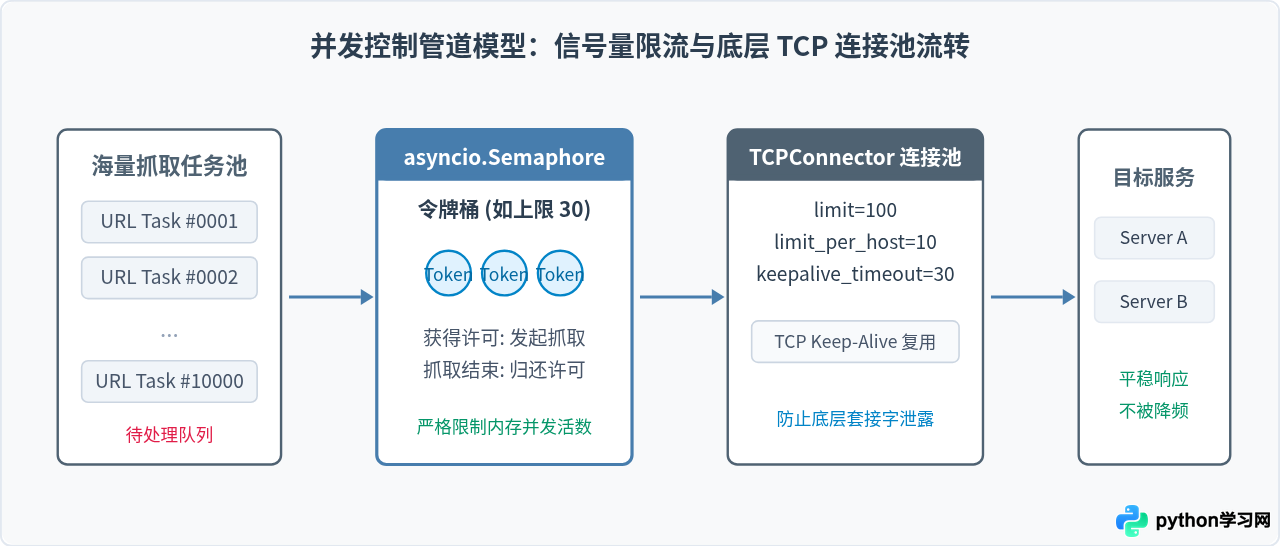
如果不加节制地把 10000 个请求同时丢给 asyncio.gather,程序会瞬间尝试建立一万条 TCP 连接。这不仅容易导致本机操作系统抛出 OSError: [Errno 24] Too many open files,还会直接击垮目标服务器或触发防爬防火墙的 429 封禁策略。
控制并发需要两道防线:
- 第一道防线:asyncio.Semaphore(应用层并发控制):限制同时处于活动状态的抓取协程总数。只有拿到令牌的协程才能发起请求,其余协程在门外排队等待。
- 第二道防线:TCPConnector(底层连接池参数):配置
limit(总连接数上限)和limit_per_host(针对单一目标域名的连接数上限),防止单个域名压力过载。
四、完整可运行示例:包含超时与重试逻辑
在实际生产环境中,网络波动、DNS 抖动与目标服务暂时不可用屡见不鲜。构建高可用抓取程序必须引入超时配置(ClientTimeout)与退避重试机制。以下是一个包含完整并发控制与异常处理的示例代码:
import asyncio
import logging
from typing import Optional
import aiohttp

# 日志输出配置
logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

# 限制最大活跃并发数为 20
CONCURRENCY_LIMIT = 20
semaphore = asyncio.Semaphore(CONCURRENCY_LIMIT)

async def fetch_url(
    session: aiohttp.ClientSession,
    url: str,
    max_retries: int = 3
) -> Optional[dict]:
    """
    带信号量与重试机制的异步下载函数
    """
    async with semaphore:
        for attempt in range(1, max_retries + 1):
            try:
                # 针对单次请求设置更细致的读取超时
                async with session.get(url) as response:
                    if response.status == 200:
                        content = await response.text()
                        logging.info(f"成功抓取: {url} (长度: {len(content)})")
                        return {"url": url, "status": 200, "content_len": len(content)}
                    else:
                        logging.warning(f"状态码异常 [{response.status}]: {url}")
            except (aiohttp.ClientError, asyncio.TimeoutError) as err:
                logging.warning(f"请求失败 ({attempt}/{max_retries}) {url}: {err}")
                if attempt < max_retries:
                    # 指数退避等待,避免短时间内连续冲击服务器
                    await asyncio.sleep(attempt * 0.8)
                else:
                    logging.error(f"放弃抓取 (已超重试限制): {url}")
        return None

async def main():
    # 模拟抓取目标列表
    target_urls = [
        f"https://httpbin.org/delay/{i % 2}"
        for i in range(1, 41)
    ]

    # 配置连接池与总体超时
    connector = aiohttp.TCPConnector(limit=100, limit_per_host=10, ssl=False)
    timeout = aiohttp.ClientTimeout(total=20, connect=5)

    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }

    async with aiohttp.ClientSession(connector=connector, timeout=timeout, headers=headers) as session:
        # 封装所有任务列表
        tasks = [fetch_url(session, url) for url in target_urls]

        # 并发调度并汇总结果
        results = await asyncio.gather(*tasks, return_exceptions=False)

        # 统计有效结果
        valid_results = [item for item in results if item is not None]
        logging.info(f"采集完成!总目标: {len(target_urls)}, 成功获取: {len(valid_results)}")

if __name__ == "__main__":
    asyncio.run(main())
async with semaphore:确保同一时刻只有最多 20 个请求在执行底层网络 I/O,其余排队。return_exceptions=False:当捕获逻辑已在任务内部完成时,直接返回提取好的字典或None,便于后续快速过滤。asyncio.sleep(attempt * 0.8):必须使用异步的asyncio.sleep,千万不能使用同步的time.sleep,否则会导致整个线程的所有协程全部挂起!
五、生产实践避坑与性能优化总结
为了保证异步抓取系统长期稳定运行,需要综合考虑内存保护、DNS 解析与异常隔离等维度。
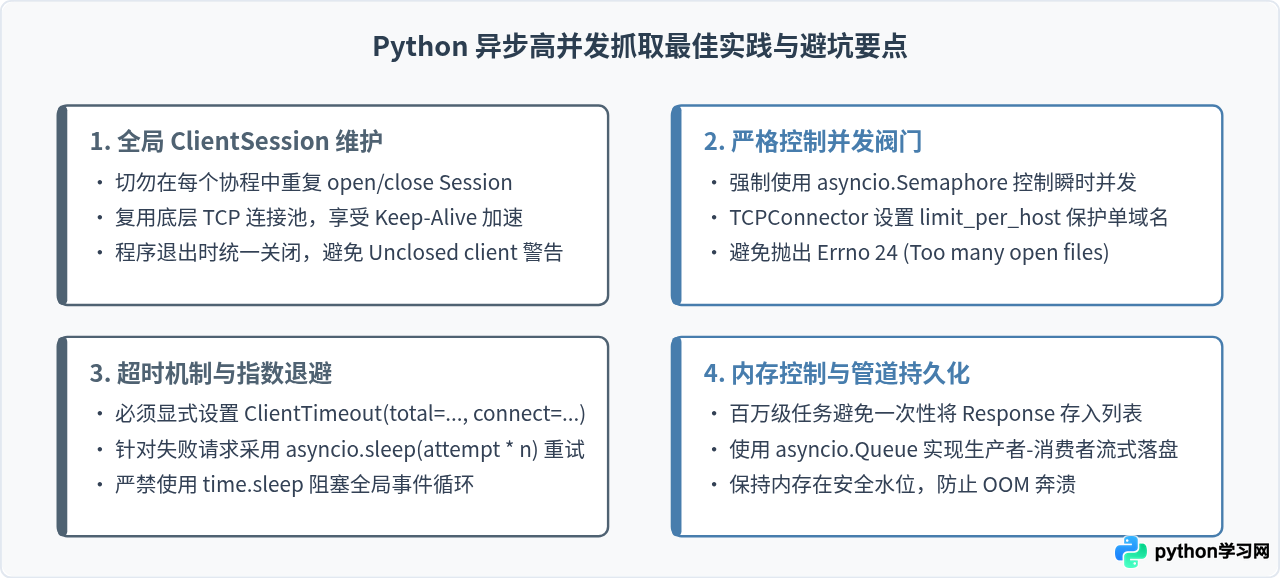
掌握 asyncio 与 aiohttp 的组合是处理大规模网络 I/O 任务的基石。在实际应用中,只要坚持“单例 Session 复用、Semaphore 精细限流、显式超时保护、异步流式处理”这四大准则,即可在极低硬件占用下打造出每秒处理数百次请求的高稳定性爬虫体系。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















