


怎么在Python嵌套列表或字典值中正确使用append?
深入解析在Python多维嵌套列表与以列表为值的字典中正确使用append方法的核心技巧、常见内存引用陷阱及三种字典初始化模式。
一、理解 append 的底层逻辑与常见误区
初学者在使用嵌套数据结构时,经常遇到代码运行后数据变成了 None,或者本想给某一行添加数据,结果所有行都被同步篡改的情况。要正确使用 append,首先需要明确它的两个基本行为特征:
- 原地修改(In-place mutation):
append()是列表的方法,它会直接在列表原有的连续内存块末尾增加一个指向新元素的引用,不会创建新列表。 - 返回值为 None:在 Python 的设计规范中,就地修改容器的方法默认不返回新对象。因此执行
result = my_list.append(10)会导致result的值为None。
# 典型初学者错误:试图链式接收 append 返回值
data = [1, 2]
data = data.append(3)  # 致命错误:此时 data 变成了 None!
print(data) # 输出: None当外层是多维列表或者以列表为值的字典时,append 必须直接作用于内部具体的列表子对象,而不是外层容器本身。
二、在嵌套列表中正确使用 append
嵌套列表(Nested List)即“列表的列表”,在算法、二维矩阵及层级数据中极为普遍。向嵌套列表追加内容分为两种情况:一是向外层追加新的整行列表;二是向已有的某一行列表追加新元素。
2.1 二维矩阵元素追加语法
要向嵌套列表的某个子列表中追加单个元素,必须通过多重索引定位到内层列表,然后对其调用 append:
# 初始化一个包含3个子列表的二维列表
matrix = [
    [10, 20],
    [30, 40],
    [50, 60]
]

# 正确:定位到索引为 1 的子列表,向其末尾追加 45
matrix[1].append(45)

# 打印验证结果
print(matrix)
# 示例输出: [[10, 20], [30, 40, 45], [50, 60]]matrix[3].append(70),而 matrix 当前的最大索引仅为 2,Python 会抛出 IndexError: list index out of range。追加现有行必须确保行索引存在;若要新增整行,应使用外层追加:matrix.append([70])。
2.2 核心陷阱:乘号初始化的浅拷贝引用灾难
这是 Python 编程中最具迷惑性的隐蔽错误之一。很多开发者为了省事,使用 [[]] * 3 来快速构建一个包含 3 个空列表的二维矩阵:
# 错误示范:使用乘号复制内部列表
bad_matrix = [[]] * 3
print(bad_matrix)  # 看似正常: [[], [], []]

# 试图只给第 0 行追加数字 99
bad_matrix[0].append(99)

# 灾难发生:所有子列表都被添加了 99!
print(bad_matrix)
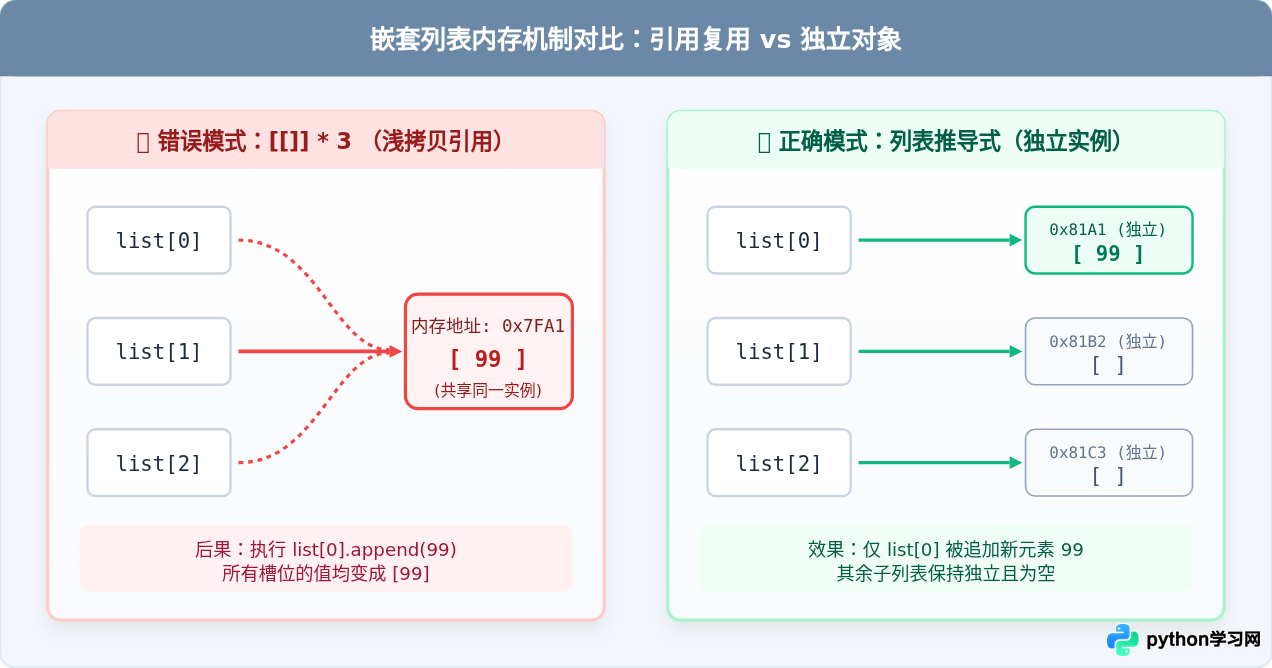
# 实际输出: [[99], [99], [99]]产生这一现象的原因是:* 3 并不是创建 3 个独立的新列表,而是将同一个空列表对象的内存引用复制了 3 份。外层列表中所有槽位实际上指向内存中的同一块地址。只要通过其中任何一个索引修改该对象,其他索引观察到的内容都会随之改变。
2.3 正确解法:利用列表推导式初始化
要生成包含多个空列表且互不干扰的嵌套列表,必须使用列表推导式(List Comprehension)。推导式在每次迭代时都会执行一次 [] 语法,从而在堆内存中开辟独立的对象:
# 正确初始化:每个元素都是独立的 list 实例
matrix = [[] for _ in range(3)]

matrix[0].append(99)
print(matrix)
# 示例输出: [[99], [], []] -> 符合预期!
三、在字典值中使用 append 的三种可靠模式
字典的值是列表(例如 dict[str, list])是数据聚合、分组和倒排索引中最常见的结构。例如我们要将属于同一类别或同一用户的记录归拢在一起。此时直接执行 d[key].append(value) 会遇到最大的阻碍:如果 key 尚未存在,直接取值会抛出 KeyError。
scores = {}
# 错误示范:键 "Alice" 还不存在
scores["Alice"].append(95)
# 抛出异常: KeyError: 'Alice'
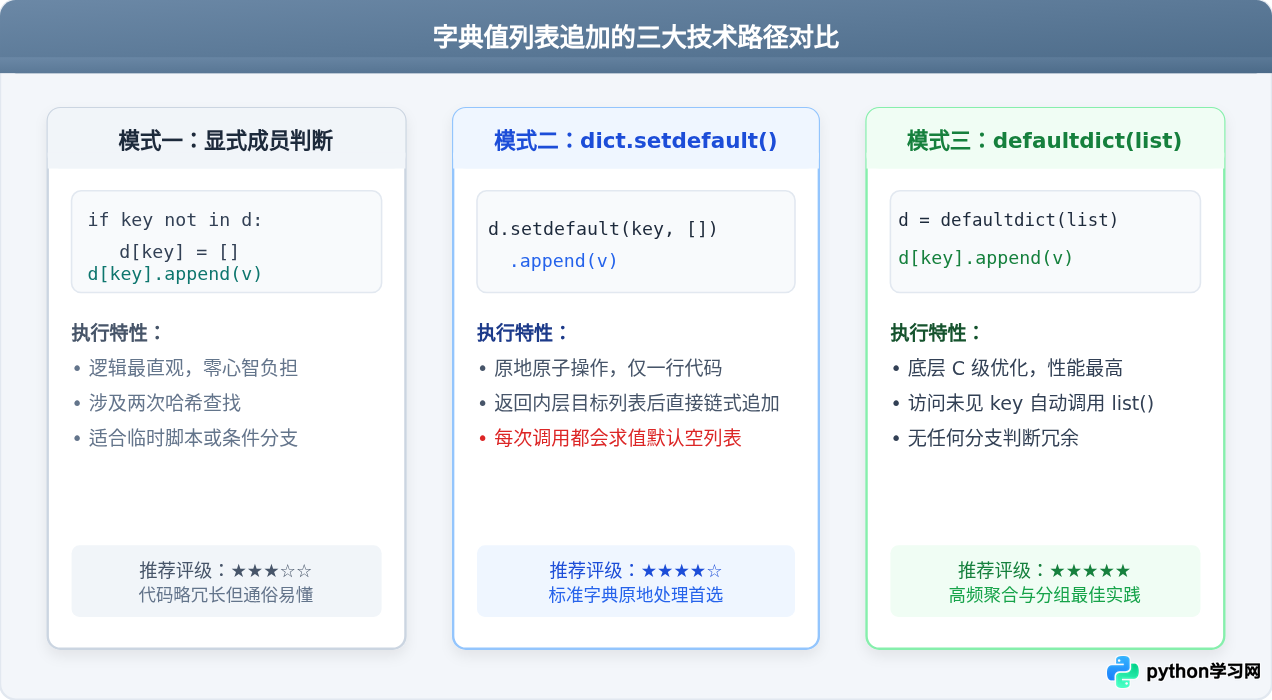
针对这一问题,Python 提供了三种层次清晰的解决方案,读者可以根据具体业务场景选择:
3.1 模式一:显式判断键是否存在
这是最符合直觉的方案。在向字典中的列表追加值之前,使用 if key not in dict 检查;若不存在则先赋一个空列表:
categories = {}
items = [("fruit", "apple"), ("fruit", "banana"), ("veg", "spinach")]

for cat, item in items:
    if cat not in categories:
        categories[cat] = []  # 初始化空列表
    categories[cat].append(item)

print(categories)
# 示例输出: {'fruit': ['apple', 'banana'], 'veg': ['spinach']}
3.2 模式二:使用 setdefault() 消除分支
字典内置的 setdefault(key, default) 方法兼具“获取”与“设值”双重功能:如果 key 在字典中,它直接返回对应的已有值;如果不在,它会将 key: default 写入字典并返回该 default 对象。由于返回的就是目标列表本身,我们可以直接紧跟 .append():
categories = {}
# 一行完成:如果不存在则建空列表,随后立即追加元素
categories.setdefault("fruit", []).append("apple")
categories.setdefault("fruit", []).append("banana")

print(categories)
# 示例输出: {'fruit': ['apple', 'banana']}setdefault() 让代码非常紧凑,但需要注意:每次执行该语句时,Python 解释器都会在内存中先创建一个临时的 [] 作为实参传递。如果在一个包含数百万次迭代的循环中,这种微小的内存开销可能会影响性能。这时更推荐使用模式三。
3.3 模式三:使用 collections.defaultdict(工程首选)
在处理日志分析、频次统计或批量分组时,标准库 collections.defaultdict 是最优雅且高效的工程化方案。通过给它传入工厂函数 list,任何缺失的键在首次被访问时都会自动生成一个全新的空列表,开发者可以直接调用 .append():
from collections import defaultdict

# 声明默认工厂为 list
grouped_data = defaultdict(list)

# 无需任何键检查或 setdefault,直接追加
grouped_data["users"].append("Alice")
grouped_data["users"].append("Bob")
grouped_data["admins"].append("Root")

print(dict(grouped_data))
# 示例输出: {'users': ['Alice', 'Bob'], 'admins': ['Root']}
四、多层混合嵌套中的安全追加与防御性编程
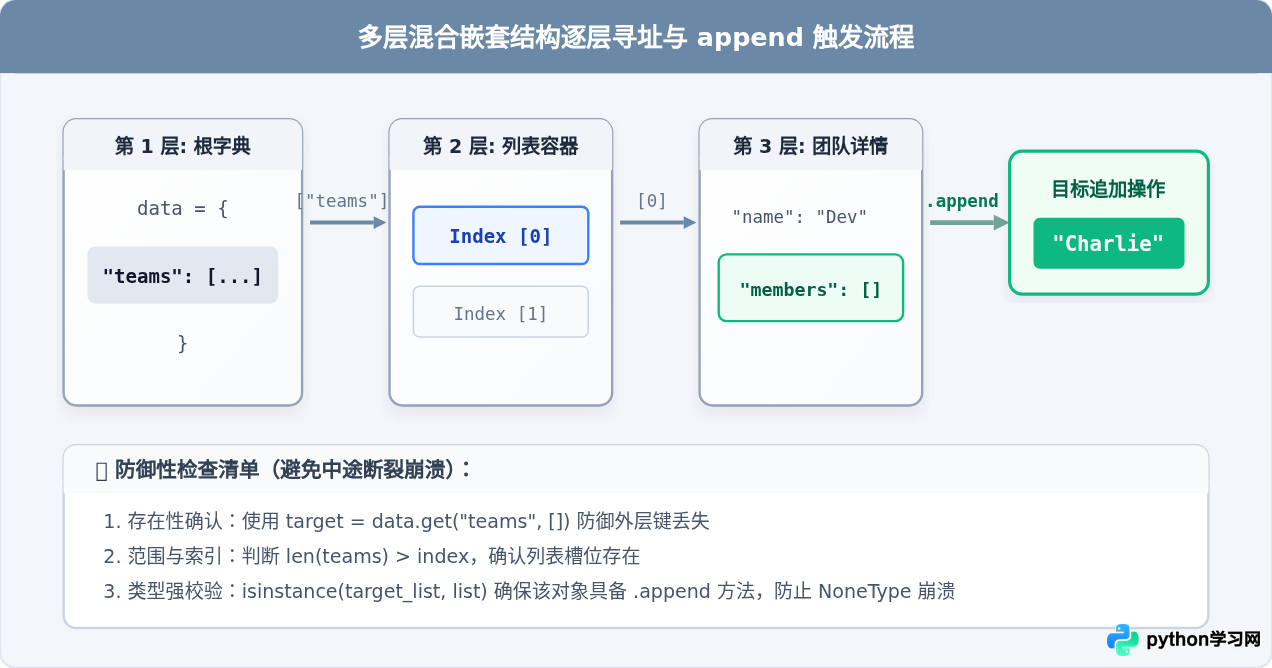
在实际开发中(如解析复杂的 JSON 报文、API 响应或配置项),我们经常会面对字典嵌套列表、列表中又包含字典的多层复杂结构。例如:payload["users"][0]["tags"].append("vip")。
在这种长调用链中,只要中间任何一个节点出现以下情况,代码就会直接崩溃:
- 中间字典缺少某个 key(引发
KeyError) - 中间列表越界(引发
IndexError) - 末端字段存在,但值是
None或字符串而非list(引发AttributeError: 'NoneType' object has no attribute 'append')
4.1 编写高容错的防御追加辅助函数
面对动态不确定的多层数据,不建议直接书写过长的属性访问链。可以通过简短的辅助函数,先确保内层为列表,再执行追加:
def safe_append_tag(user_dict, tag):
    # 1. 确保 tags 键存在,且类型必须是列表
    if "tags" not in user_dict or not isinstance(user_dict["tags"], list):
        user_dict["tags"] = []  # 容错重建
    # 2. 安全调用 append
    user_dict["tags"].append(tag)

# 示例数据
user = {"name": "Bob", "tags": None}  # 脏数据:tags 误填为 None
safe_append_tag(user, "developer")

print(user)
# 示例输出: {'name': 'Bob', 'tags': ['developer']}
五、核心规则总结与决策选型
为了在编写代码时迅速做出最合理的选择,读者可以参考以下决策速查表:
| 嵌套场景 | 典型语法 | 推荐解决方案 | 核心避坑点 |
|---|---|---|---|
| 二维矩阵 / 嵌套列表 | matrix[i].append(val) |
列表推导式 [[] for _ in range(n)] |
绝不能使用 [[]] * n 浅拷贝初始化 |
| 普通字典分类聚合 | d[key].append(val) |
d.setdefault(key, []).append(val) |
避免未判断直接 d[key].append() 引发 KeyError |
| 批量、高频数据分组 | d[key].append(val) |
defaultdict(list) |
性能最优,但需注意直接查询不存在的键会生成空列表 |
| 多层动态嵌套 JSON | d["a"][0]["b"].append(val) |
逐层判空 + isinstance(..., list) |
防止中间字段为 None 引发 AttributeError |
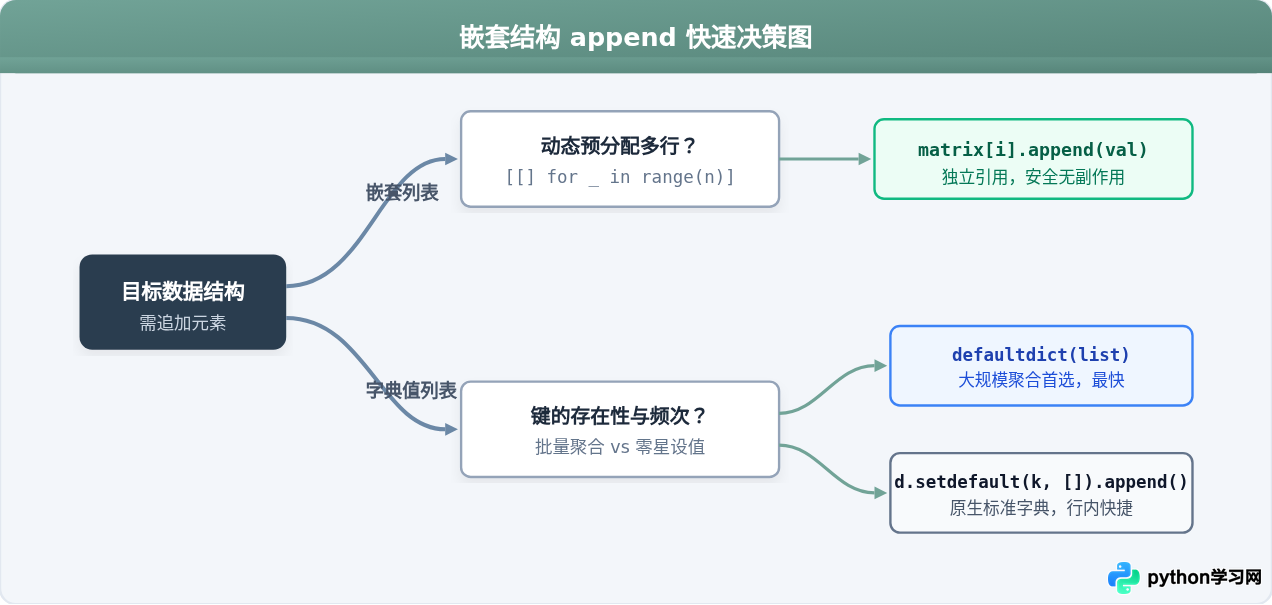
牢记这三句核心要诀:“列表推导绝不乘,字典聚合找默认,原地追加莫赋值”。掌握了内部实例的寻址机制与内存独立性,便能从容应对任意复杂的 Python 嵌套数据操作。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















