


Python原生列表与NumPy数组输入矩阵的区别

在 Python 中构建和输入二维矩阵时,开发者通常有两种基础选择:使用语言内置的嵌套列表(List of Lists),或使用科学计算库 NumPy 提供的二维数组(ndarray)。虽然两者均可用 [[1, 2], [3, 4]] 的直观形式录入数据,但它们在数据结构约束、底层内存布局、切片索引机制以及数学运算语义上有着本质的区别。理解这些差异,是避免浅拷贝陷阱、优化计算性能以及正确编写数值算法的前提。
一、数据输入与形状约束:松散集合 vs 严格规则网格
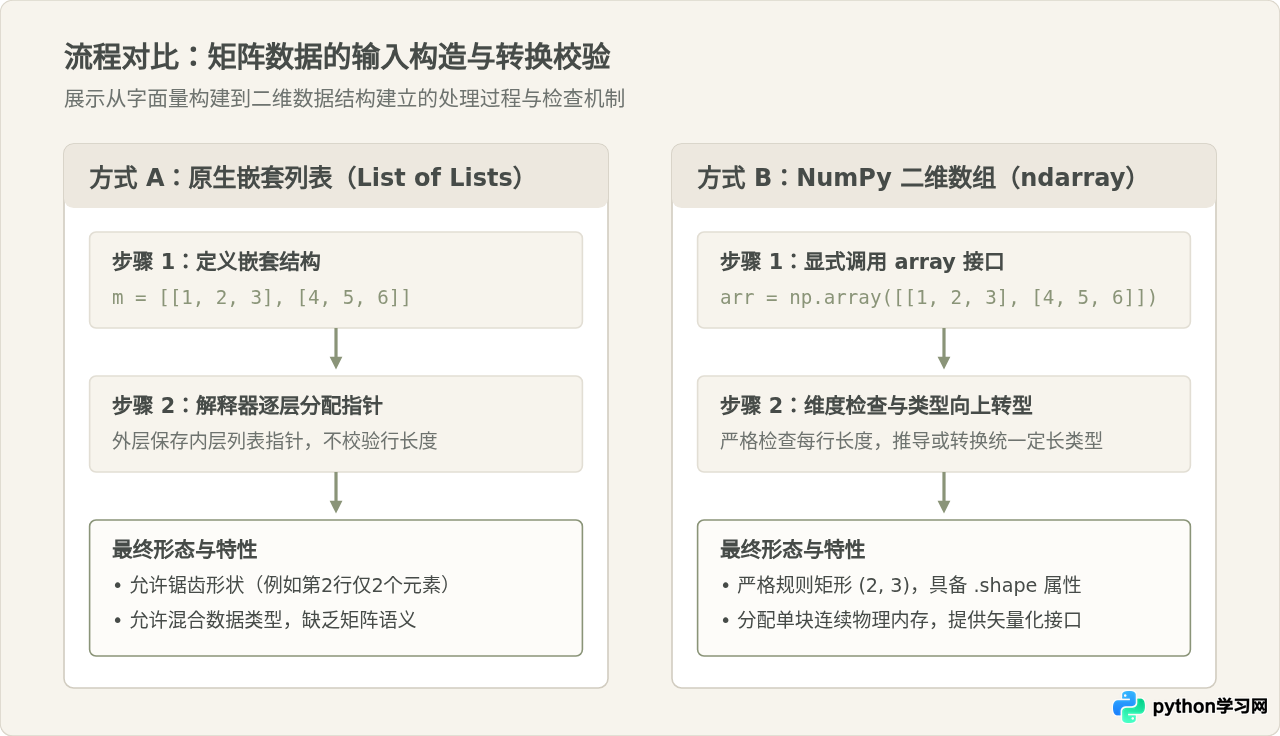
从代码输入形式来看,Python 列表是通用对象的容器,嵌套列表仅仅是在一个列表中放入多个子列表。这种设计意味着 Python 解释器不会对子列表的长度或内部元素的类型施加任何矩阵意义上的几何约束。
# 示例 1:原生嵌套列表输入非规则数据(Jagged/Ragged List)
matrix_list = [
    [1, 2, 3],
    [4, 5],          # 行长度不同:允许存在
    ["a", 7.5, None] # 元素类型混杂:允许存在
]
上述代码在 Python 中完全合法,解释器视其为普通的分层容器。然而在数学和几何计算中,矩阵必须具有严格的行数与列数($M \times N$)。若使用原生列表,开发者必须自行编写逻辑校验每一行的长度是否一致、数据类型是否为数值。
相比之下,NumPy 的 np.array() 构造接口专为多维规则阵列设计。当输入嵌套列表时,NumPy 会自动扫描所有子维度的长度,并要求各行具有统一的几何形状,同时将内部元素统一转换(Upcasting)为同质的数值类型:
import numpy as np

# 示例 2:NumPy 矩阵输入与规范化
matrix_np = np.array([
    [1, 2, 3],
    [4, 5, 6]
], dtype=np.float64)

print(matrix_np.shape)  # 输出示例: (2, 3)
print(matrix_np.dtype)  # 输出示例: float64
如果尝试向现代 NumPy 输入长短不一的子列表构建高维数组,NumPy 会显式抛出 ValueError,强制阻止这种非几何结构的产生。这种早期的形状校验保证了后续线性代数运算的数学确定性。
二、底层内存布局:多级指针链 vs 单块连续内存
两者在性能和行为上的巨大反差,根源在于 CPython 与 NumPy 底层的内存管理机制不同。
1. Python 原生嵌套列表的指针离散模型
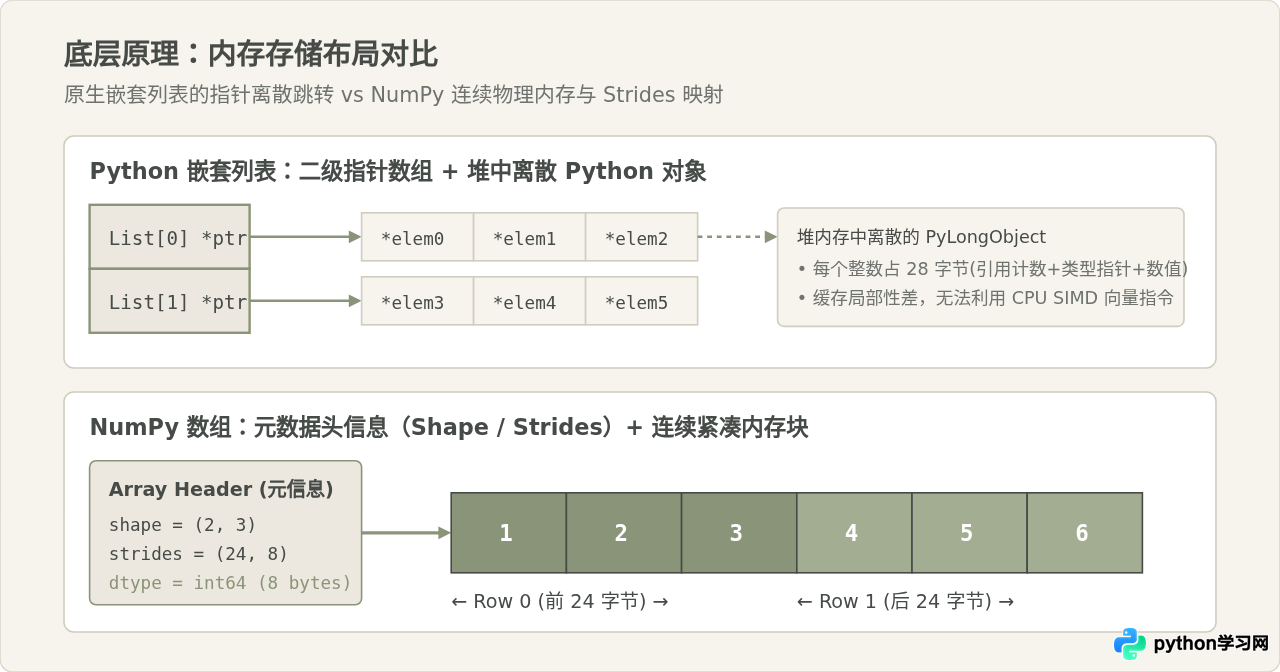
Python 的 list 实际上是一个动态指针数组(PyListObject)。对于一个二维嵌套列表 m = [[1, 2], [3, 4]]:
- 外层
m是一个数组,内部存储的是指向子列表对象的两个内存地址(指针)。 - 每个子列表又是独立的
PyListObject,各自维护一组指向具体数字对象的指针。 - 具体的整数(如
1)在 CPython 中是完整的PyLongObject,每个数字对象除了数值本身,还携带引用计数、对象类型指针等元数据(在 64 位系统下通常占用 28 字节)。
这意味着数据散落在堆内存的不同位置。CPU 遍历矩阵时,每次访问都需要沿着指针地址跳转,极易发生 CPU 缓存未命中(Cache Miss),无法进行 SIMD 向量化加速。
2. NumPy ndarray 的紧凑缓冲区与 Strides 跨步机制
NumPy 的 ndarray 结构极其纯粹:它由一个轻量的元数据头(Header)与一块**单义、连续的原始数据缓冲区(Data Buffer)**组成。对于一个 $2 \times 3$ 的 int64 矩阵:
- 6 个整数依次连续存放在一段 $6 \times 8 = 48$ 字节的物理内存中。
- 数据头部维护
shape = (2, 3)以及strides = (24, 8)。跨步信息(Strides)告诉解释器:行与行之间跳跃 24 个字节,列与列之间跳跃 8 个字节。 - 定位元素
arr[i, j]仅需一次简单的基地址偏移运算:data_ptr + i * 24 + j * 8,直接读取纯二进制字节。
三、索引与切片:链式提取 vs 多维视图(View)
内存模型的差异直接投射到了两者的语法与行为上,尤其在提取矩阵的行、列与子区域时体现得尤为明显。
1. 单元素访问语法
对于原生列表,获取第 1 行第 2 列的元素必须采用链式中括号 matrix[1][2]。其执行过程是:先对外部列表执行索引,取出一个完整的子列表对象,再对该子列表执行二次索引。
而 NumPy 支持坐标元组语法 matrix[1, 2],通过 C 级别的单一指令直接定位内存偏移量,避免了创建中间临时列表对象的开销。
2. 切片维度与列提取
当需要从 $3 \times 3$ 矩阵中提取第 1 列的所有元素时:
# 原生列表无法使用 matrix[:, 1],否则报 TypeError
# 必须使用列表推导式遍历每一行:
col_list = [row[1] for row in matrix_list]

# NumPy 原生支持多维切片:
col_np = matrix_np[:, 1]
3. 浅拷贝副本 vs 共享内存视图(View)
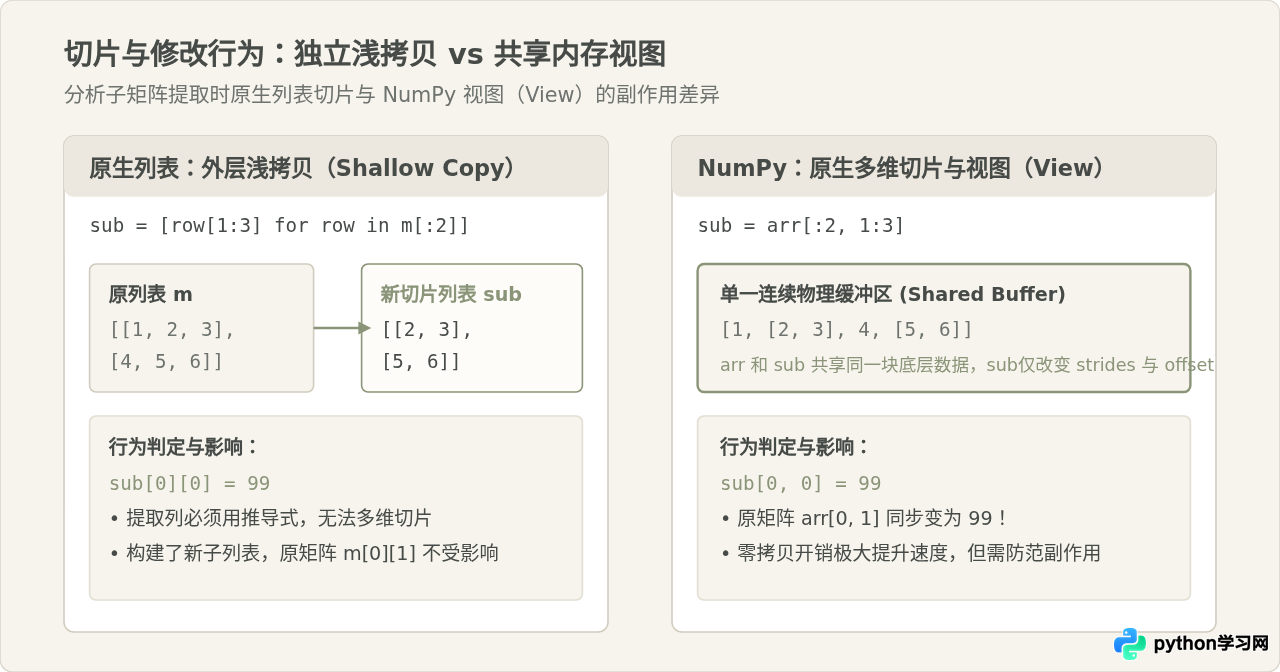
这是两者最关键的行为差异之一。在对原生列表切片(如 m[:2])时,Python 会生成一个包含原元素指针的新列表。改变新列表自身的结构不会改变原列表结构。
而在 NumPy 中,基本切片(如 sub = arr[:2, 1:3])**不拷贝任何数据**,它只是生成了一个新的 ndarray 头部,指向原数组的同一块内存,仅仅调整了 shape、strides 与 offset。这种设计在处理数千兆数据时能达到极速且极省内存,但必须警惕副作用:
# 示例 3:NumPy 切片视图修改影响原矩阵
arr = np.array([[10, 20], [30, 40]])
sub = arr[:, 0]    # 提取第 0 列作为视图
sub[0] = 999       # 修改切片中的元素

print(arr[0, 0])   # 输出: 999!原矩阵被同步修改
若需要与原矩阵完全隔离,NumPy 要求显式调用 sub = arr[:, 0].copy()。
四、常见混淆陷阱与认知辨析
陷阱 1:“用乘法快捷构建全零矩阵”的引用复制陷阱
许多初学者试图通过 [[0] * 3] * 3 快速生成一个 $3 \times 3$ 的零矩阵。这种看似优雅的做法隐藏着严重的引用复用 Bug:
# 错误方式:内层列表被引用了 3 次
m = [[0] * 3] * 3
m[0][0] = 1
print(m)
# 实际输出: [[1, 0, 0], [1, 0, 0], [1, 0, 0]]
# 原因:外层列表的 3 个元素其实指向内存中的同一个子列表对象!

# 正确的原生写法(推导式新建对象):
m_correct = [[0] * 3 for _ in range(3)]

# NumPy 中的推荐做法(直接分配连续零内存):
arr_zeros = np.zeros((3, 3), dtype=int)
陷阱 2:“加号与乘号”的运算语义混淆
在 Python 原生列表中,+ 代表**序列拼接**,* 代表**序列重复**;而在 NumPy 数组中,基本算术运算符全部重载为**元素级(Element-wise)矩阵数学运算**:
[1, 2] + [3, 4]得到的是[1, 2, 3, 4](长度变长,非矩阵加法)。np.array([1, 2]) + np.array([3, 4])得到的是array([4, 6])(对应位置矢量相加)。- 真正的数学矩阵乘法(内积),NumPy 提供了专门的
@运算符或np.matmul()/np.dot(),而原生列表完全不具备该能力,必须编写双重甚至三重for循环手动累加。
陷阱 3:“NumPy 只是给原生列表加了一层语法糖外壳”
这种说法看似合理,但并不符合底层事实。NumPy 并非简单的包装器,它的底层核心计算逻辑完全由 C 和 Fortran 编写,底层数据绕过了 Python 的对象分配机制(GIL 之外可释放),且原生支持**广播机制(Broadcasting)**。例如将标量加到整个矩阵上,NumPy 可以在 C 循环内通过跨步步长为 0 的虚假维度直接广播运算,而无需真实复制内存。
五、特性对比与技术选型总结
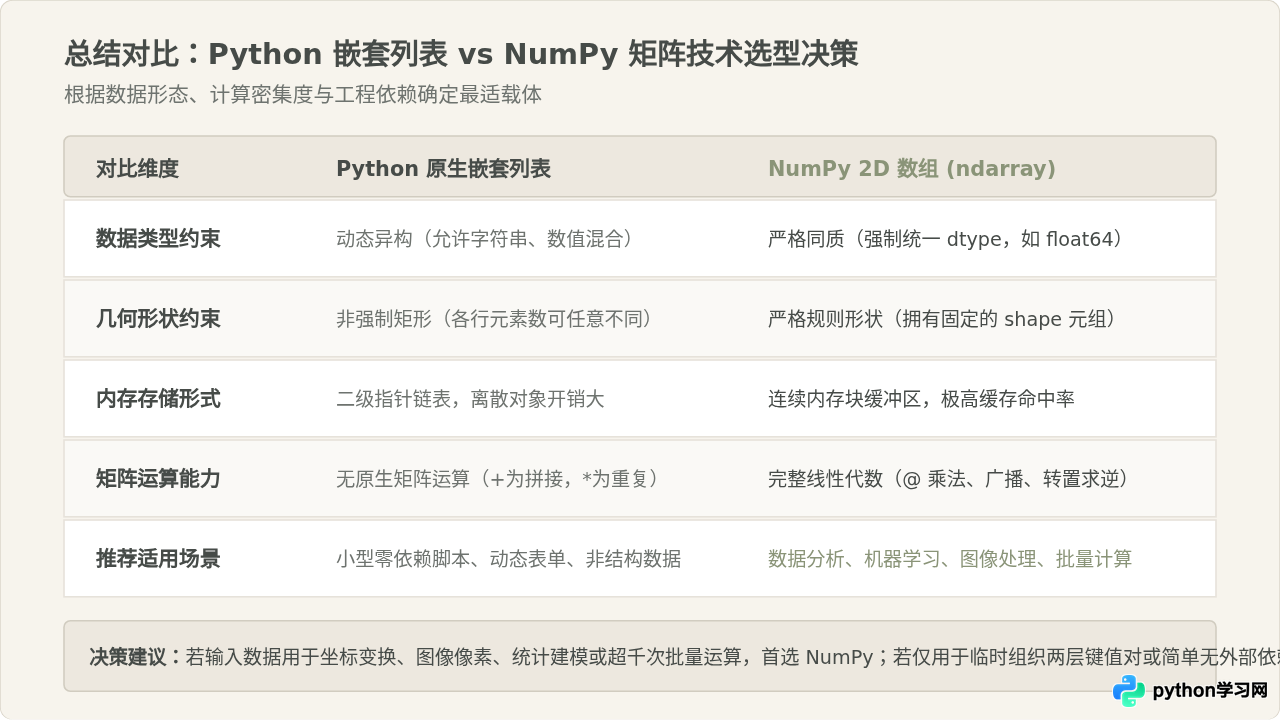
在实际工程和算法开发中,选用哪种载体应基于具体的场景需求:
总结建议:
1. 如果你的任务属于零第三方依赖脚本、配置文件读取,或者需要存储异构对象(例如每行第 0 列是字符串名称,第 1 列是对象指针),且各行长度可能动态调整,使用Python 原生嵌套列表更为自然灵活。
2. 一旦输入数据的物理含义为几何矩阵、坐标系、图像像素或统计特征表,需要频繁进行行列切片、转置、点乘或元素级加减,必须首选 NumPy 数组。它不仅能将内存消耗降低数倍至数十倍,更能依托连续内存块和 BLAS 线性代数底层加速库,带来两个数量级以上的执行效率提升。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















