


Python多变量赋值与序列解包技巧
深入解析Python多变量赋值与序列解包机制,涵盖基础平行赋值、变量就地互换、嵌套序列解包、带星号不定长解包以及实际开发中的避坑与性能优化技巧。
一、多变量赋值基础与就地互换机制
Python支持在一行语句中为多个变量同时赋予不同值,常见语法形式为 a, b = 1, 2。这种语法并非简单的语法糖,其本质是右侧隐式构建了一个不可变元组 (1, 2),随后Python虚拟机(CPython)通过解包操作将元组内的元素依次关联到左侧的标识符。
借助这一机制,变量值互换可以优雅地写为 a, b = b, a。在传统编程语言中,交换两个变量通常需要借用第三个中间变量 temp,而在Python中,执行引擎会先计算右侧所有表达式并压入堆栈生成临时元组,随后在赋值阶段才解包写入左侧变量名。
# 传统语言中的变量互换方式
temp = a
a = b
b = temp

# Python中的优雅解包互换
a = 10
b = 20
a, b = b, a
print(a, b)  # 示例输出: 20 10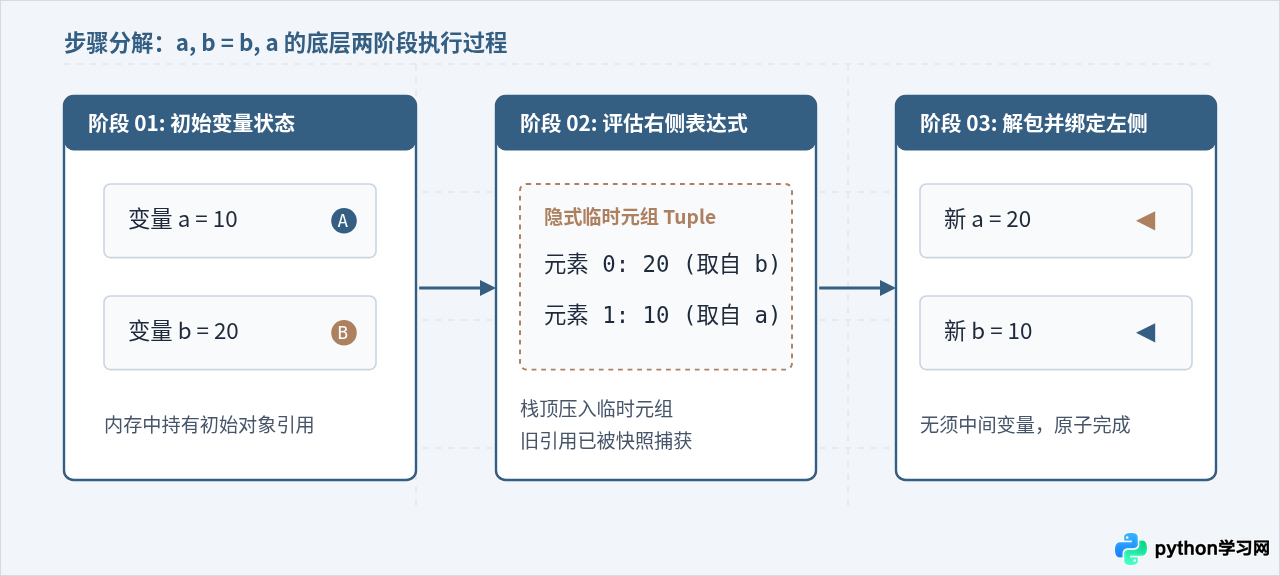
二、序列解包的核心规则与结构对齐
解包操作适用于任意支持迭代协议的对象(Iterable),包括元组(tuple)、列表(list)、字符串(str)、集合(set)及字典(dict)。标准解包的核心前提是:左侧接收变量的数量必须与右侧可迭代对象中的元素个数完全一致。
1. 元素数量必须严格对称
若变量数与元素数不匹配,解释器将直接抛出 ValueError。在编写代码时,这是一种极佳的结构断言机制:
# 正常解包
point = (100, 200)
x, y = point  # 成功,x=100, y=200

# 变量数量少于元素
a, b = (1, 2, 3)
# 报出异常: ValueError: too many values to unpack (expected 2)

# 变量数量多于元素
x, y, z = [10, 20]
# 报出异常: ValueError: not enough values to unpack (expected 3, got 2)
2. 嵌套数据结构的分层解包
当处理具有层级的数据(例如数据库查询结果、地理坐标、RPC返回元组)时,左侧变量可以通过括号嵌套直接映射右侧的内层结构。解包引擎会递归解开内层容器,免去逐层按索引切片提取的冗余代码。
# 嵌套配置解包
server_entry = ("web-master", (192, 168, 1, 10), 8080)

# 使用嵌套括号结构精确匹配
host_name, (net_a, net_b, net_c, host_id), port = server_entry

print(host_name)  # 示例输出: web-master
print(host_id)    # 示例输出: 10
print(port)       # 示例输出: 8080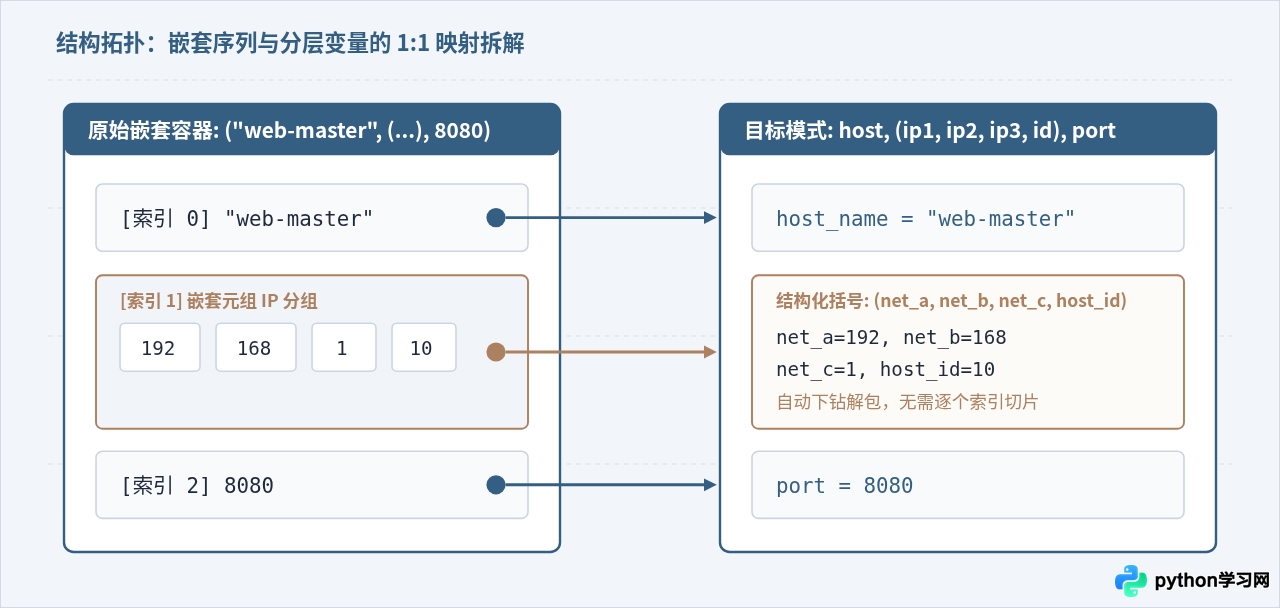
三、扩展解包:星号表达式(*rest)的高级应用
在PEP 3132中,Python引入了扩展序列解包(Extended Iterable Unpacking)。通过在变量名前增加星号(*),该变量可以自动收集剩余未被匹配的元素,并始终以列表(list)形式返回。
1. 捕获头部、尾部或中间部分
星号表达式的位置非常灵活,可以放置在序列解包表达式的任意位置:
- 捕获剩余尾部:
head, *tail = data—— 提取首元素,其余元素存入tail。 - 捕获剩余头部:
*body, last = data—— 提取末尾元素,前面全部元素存入body。 - 捕获中间切片:
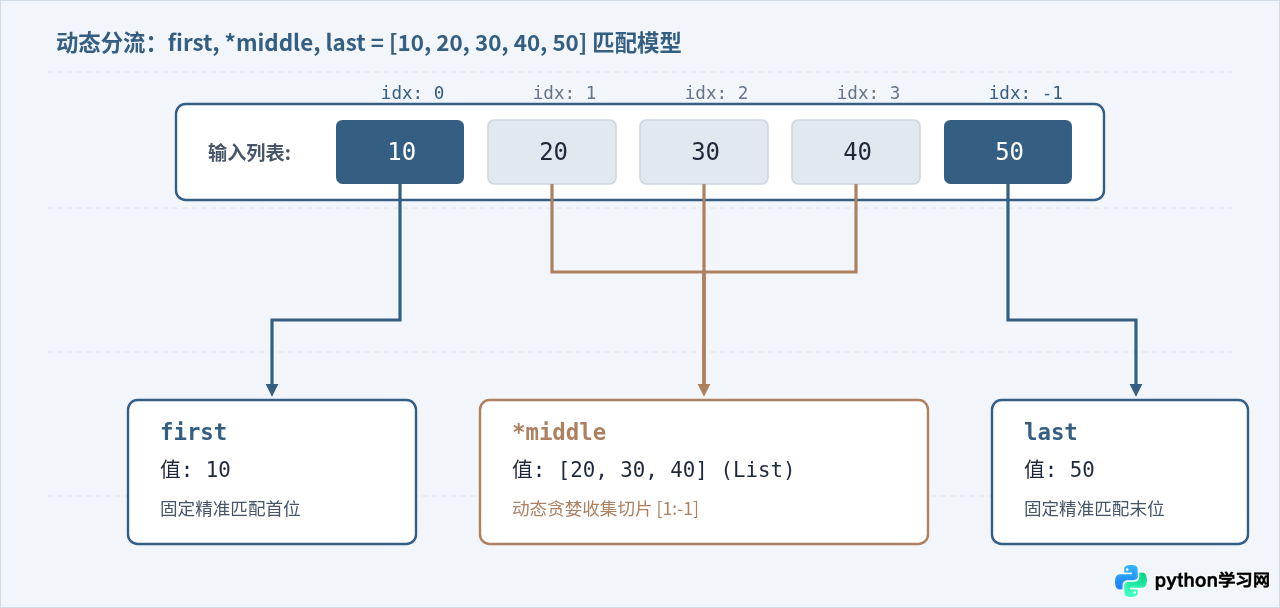
first, *middle, last = data—— 提取首尾,中间任意长度元素均汇入middle。
records = [10, 20, 30, 40, 50]

# 提取首个与末尾,其余聚合
first, *middle, last = records

print(first)   # 示例输出: 10
print(middle)  # 示例输出: [20, 30, 40]
print(last)    # 示例输出: 50

# 极端情况:当元素数量刚好满足非星号变量时,星号变量将被赋值为空列表
a, *b, c = [1, 2]
print(a)  # 示例输出: 1
print(b)  # 示例输出: []
print(c)  # 示例输出: 2
例如,first, *mid1, *mid2, last = data 是非法语法,在编译解析时会直接抛出 SyntaxError: two starred expressions in assignment。解释器无法在没有固定长度约定的情况下推断两个贪婪通配符的分流边界。
四、实际工程中的常见使用场景
1. 惯用下划线丢弃无关数据
在处理数据管道、日志切分或CSV文本行时,通常只关心其中的关键字段。Python中惯用单个下划线 _ 标记不打算使用的单个变量,用 *_ 吞掉后续全部无用列:
log_line = "2026-10-28 15:30:00 ERROR Database connection timeout (retry 3)"

# 只提取时间戳与错误等级,后续详情统一丢弃
date, time, level, *_ = log_line.split()
print(f"日志等级: {level}, 时间: {date} {time}")
# 示例输出: 日志等级: ERROR, 时间: 2026-10-28 15:30:00
2. 遍历循环中的原地解包
在 for 循环中,解包不仅限于 dict.items() 的键值对遍历,也可以与 enumerate()、zip() 联合使用,直接规避繁琐的下标操作:
users = [("Alice", 28, "Engineer"), ("Bob", 32, "Manager")]

# 循环中同时解包索引与嵌套元组
for idx, (name, age, role) in enumerate(users, start=1):
    print(f"[{idx}] {name} ({role}) - {age}岁")

# 字典解包遍历
configs = {"timeout": 30, "retries": 3}
for param, val in configs.items():
    print(f"配置项 {param} 设置为 {val}")
3. 函数多返回值解包
Python函数返回多个以逗号隔开的变量时,实际上返回的是单一元组。调用端通过解包能直观捕获各个业务返回值:
def get_status_report():
    code = 200
    msg = "OK"
    latency_ms = 14.2
    return code, msg, latency_ms  # 隐式打包为 (code, msg, latency_ms)

# 调用处解包
status, message, latency = get_status_report()
五、常见陷阱与避坑指南
1. 链式赋值的可变对象引用共享陷阱
很多开发者容易混淆“多变量解包赋值”与“多变量链式赋值”。如下代码:
# 链式赋值陷阱
list_a = list_b = []
list_a.append(100)
print(list_b)  # 输出: [100]!list_b 被同步修改!
原因解释:list_a = list_b = [] 是将同一个空列表对象的内存地址同时赋给两个名字。若需要两个独立的空列表,必须使用独立赋值或解包形式:list_a, list_b = [], []。
2. 迭代器与生成器的单次耗尽性
对生成器对象进行解包时,解释器会立即驱动迭代器执行到底,这会导致生成器被瞬间耗尽。后续再次尝试从该生成器迭代将获取不到任何数据:
gen = (x * 2 for x in range(3))
a, b, c = gen  # 成功解包: 0, 2, 4
# 此时 gen 已耗尽,list(gen) 将得到 []
3. 解包模式速查对照表
| 语法模式 | 示例代码 | 核心特性与适用场景 | 潜在风险与防护措施 |
|---|---|---|---|
| 基本平行赋值 | a, b = 10, 20 |
静态定长绑定,左右数量必须完全一致 | 数量不对称抛出 ValueError |
| 就地变量交换 | a, b = b, a |
依赖临时元组栈评估,无需 temp 变量 |
无,推荐标准写法 |
| 分层嵌套解包 | x, (y, z) = data |
直接对齐复杂JSON/数据库嵌套结果 | 数据结构若变动将导致解包崩溃 |
| 星号不定长解包 | head, *tail = items |
捕获动态长度尾部/中间,总是返回列表 | 同一语句中不能出现两个 * 表达式 |
| 占位忽略解包 | name, _, role = row |
下划线语义显式标识丢弃无关数据列 | 避免在同一作用域内读取 _ 的值 |
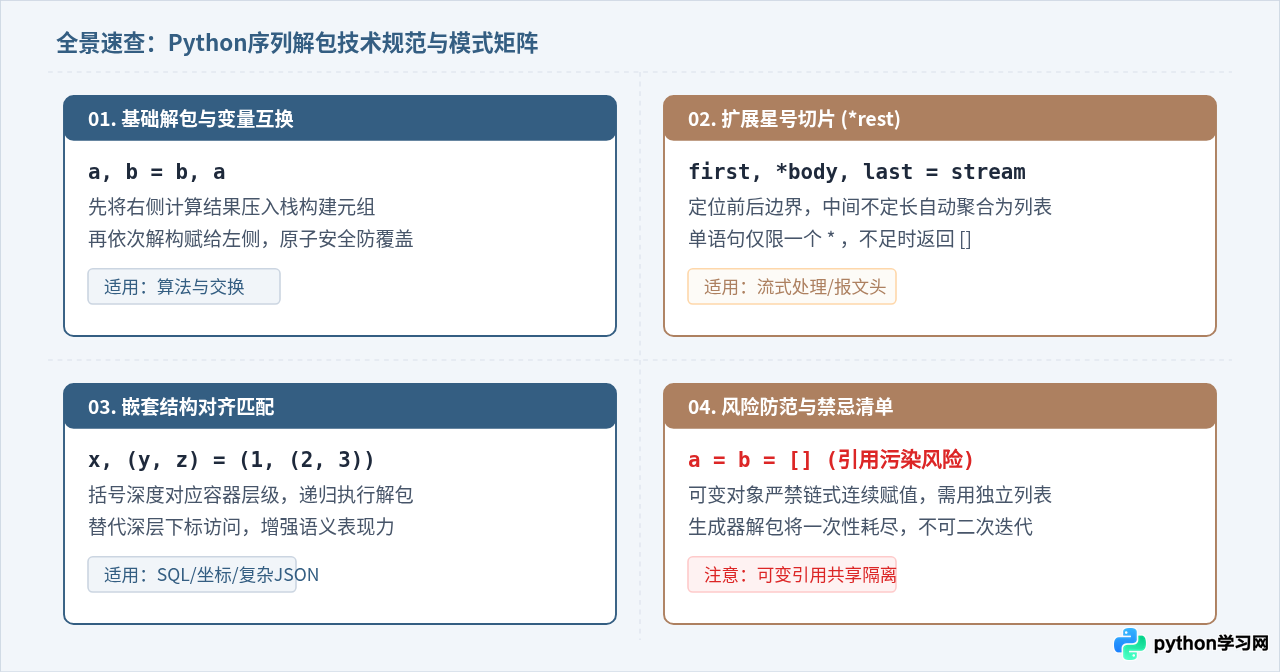
六、总结与开发建议
多变量赋值与序列解包不仅是书写简洁Pythonic代码的重要工具,更是解耦数据结构与提取业务参数的关键手段。在日常实践中建议遵循以下准则:
- 优先用于明确语境:在函数返回多个相关指标、坐标解析或字典遍历时,优先采用解包,提升变量语义。
- 限制解包字段数量:当单行解包变量超过4个时,可读性会迅速下降,此时应考虑改用
dataclass或namedtuple。 - 警惕可变容器引用:时刻区分
a, b = [], []与a = b = []的本质差异,杜绝在生产中引入隐蔽的数据污染缺陷。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















