


Python元组解包技巧:简化变量赋值与函数返回
深入讲解Python元组解包(Tuple Unpacking)核心技巧与底层机制,涵盖基础赋值、变量优雅交换、函数多值返回、星号扩展解包以及常见报错避坑指南。
元组解包(Tuple Unpacking)是 Python 中一种优雅且高效的赋值语法,它允许开发者直接将可迭代对象中的元素一次性拆解并指派给一组变量。熟练掌握这一特性,不仅能够彻底摆脱冗长重复的数字下标索引,还能在交换变量、接收函数多返回值以及拆分动态数据结构时大幅简化代码逻辑。
一、元组解包的基本机制与求值时序
在 Python 中,逗号是构建元组的核心符号(圆括号通常仅起到明确优先级的辅助作用)。当赋值运算符 = 右侧是一个序列或逗号分隔的多个值,而左侧由相同数量的变量名承接时,Python 会自动执行解包操作:
# 基础解包示例
coordinates = (120.19, 30.26)
longitude, latitude = coordinates

print("经度:", longitude)  # 示例输出:经度: 120.19
print("纬度:", latitude)   # 示例输出:纬度: 30.26
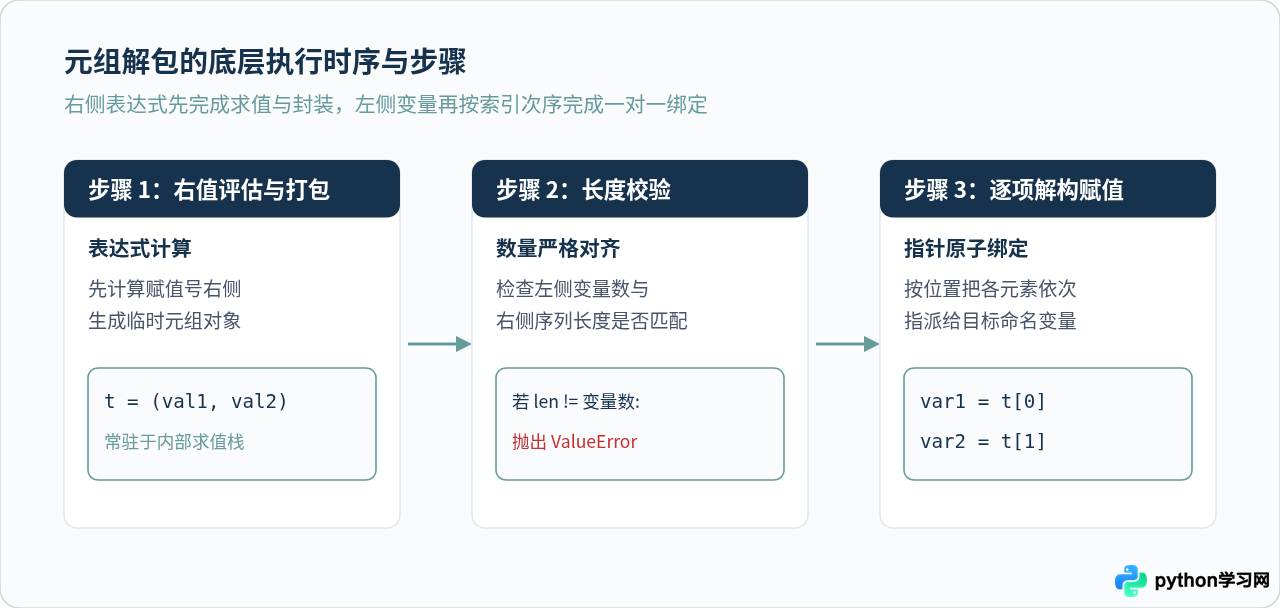
在底层实现中,Python 解释器遵循严格的“先求值右侧、再绑定左侧”的原则。当执行 var1, var2 = expr1, expr2 时,解释器会先在求值栈上构建一个只读元组,验证两端元素个数是否一致,最后通过指针原子性地将值分配给左侧的变量名。
二、常规索引访问与元组解包的代码对比
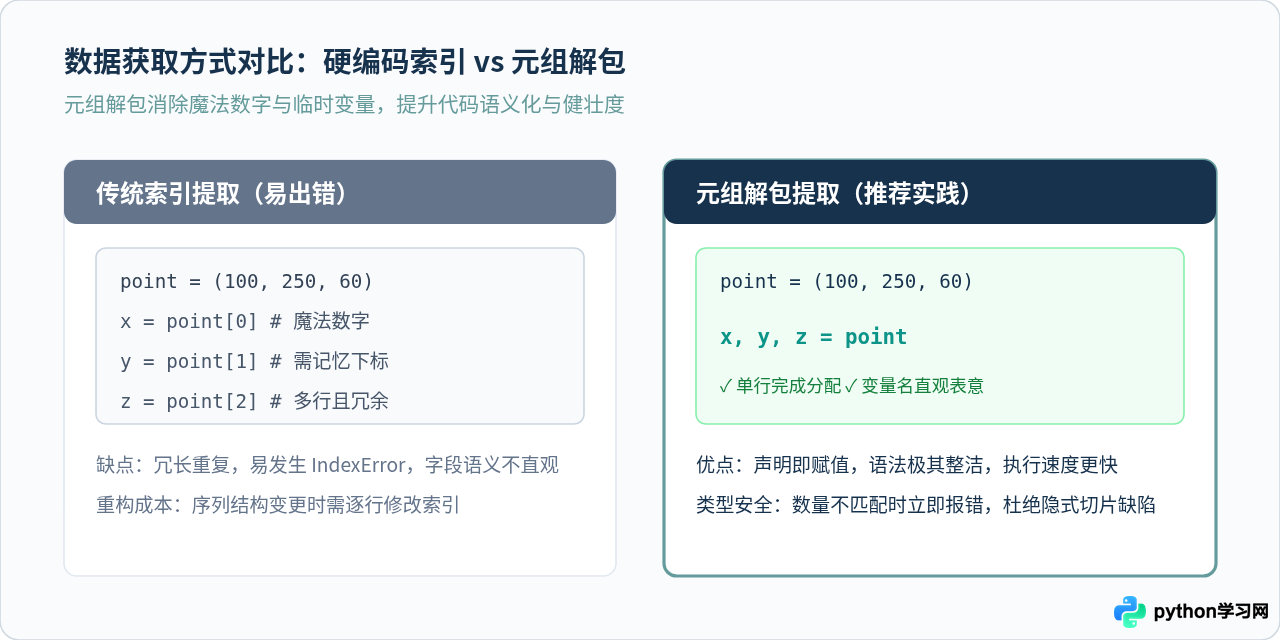
在没有使用元组解包之前,开发者常常习惯使用 data[0]、data[1] 这样的硬编码数字索引逐个获取属性值。这种方式不仅代码冗长,而且隐藏着极易出错的“魔法数字”(Magic Numbers)。一旦上游数据结构调整了字段排列,所有相关索引都必须逐行重构,极易产生下标越界异常。
三、技巧一:无需临时变量的原子化变量交换
在很多传统语言(如 C 或 Java)中,交换两个变量需要引入中间变量 temp:
# 传统语言中的交换模式
temp = x
x = y
y = temp
在 Python 中,通过元组解包可以在单行内完成原子交换:
# Pythonic 的优雅写法
x, y = y, x
这并非什么特殊的编译器魔法,而是元组打包与解包配合的自然结果:首先右侧的 y, x 在内存中生成了一个临时元组 (当前y的值, 当前x的值);紧接着该元组被解包给左侧的 x, y。这种机制还非常适合用于状态机的多步迭代计算,例如经典斐波那契数列的前进过程:
# 斐波那契数列的状态流转
a, b = 0, 1
for _ in range(5):
    print(a, end=" ")
    a, b = b, a + b
# 示例输出:0 1 1 2 3
四、技巧二:优雅接收函数的多项返回值
Python 函数本身在底层只能返回一个对象。当我们在 return 后书写多个以逗号分隔的值时,Python 会自动将它们打包为一个元组返回。在调用该函数时,我们可以直接在接收端使用解包语法:
def calculate_stats(numbers):
    total = sum(numbers)
    count = len(numbers)
    mean = total / count if count > 0 else 0
    return total, mean, count  # 实际返回一个三元组

# 直接通过解包获取对应字段
sample_data = [10, 20, 30, 40]
total_sum, avg_value, item_count = calculate_stats(sample_data)

print(f"总和: {total_sum}, 平均值: {avg_value}, 数量: {item_count}")
# 示例输出:总和: 100, 平均值: 25.0, 数量: 4dataclass 或 typing.NamedTuple,避免接收方因变量位置记错而引发隐蔽的数据赋值错位。
五、技巧三:星号表达式(*)捕获动态与变长序列
在 Python 3 中引入的扩展解包(Extended Iterable Unpacking)允许在变量名前加上星号 *。带星号的变量会贪婪地收集所有多余的元素,并将其封装为一个独立的 list(列表),无论源数据是元组还是其他可迭代对象。
records = (101, "Alice", "Developer", "Beijing", "Active")

# 提取头部 ID,末尾状态,中间属性统一收集
user_id, *profile_data, status = records

print("用户ID:", user_id)        # 示例输出:用户ID: 101
print("属性列表:", profile_data)   # 示例输出:属性列表: ['Alice', 'Developer', 'Beijing']
print("状态:", status)           # 示例输出:状态: Active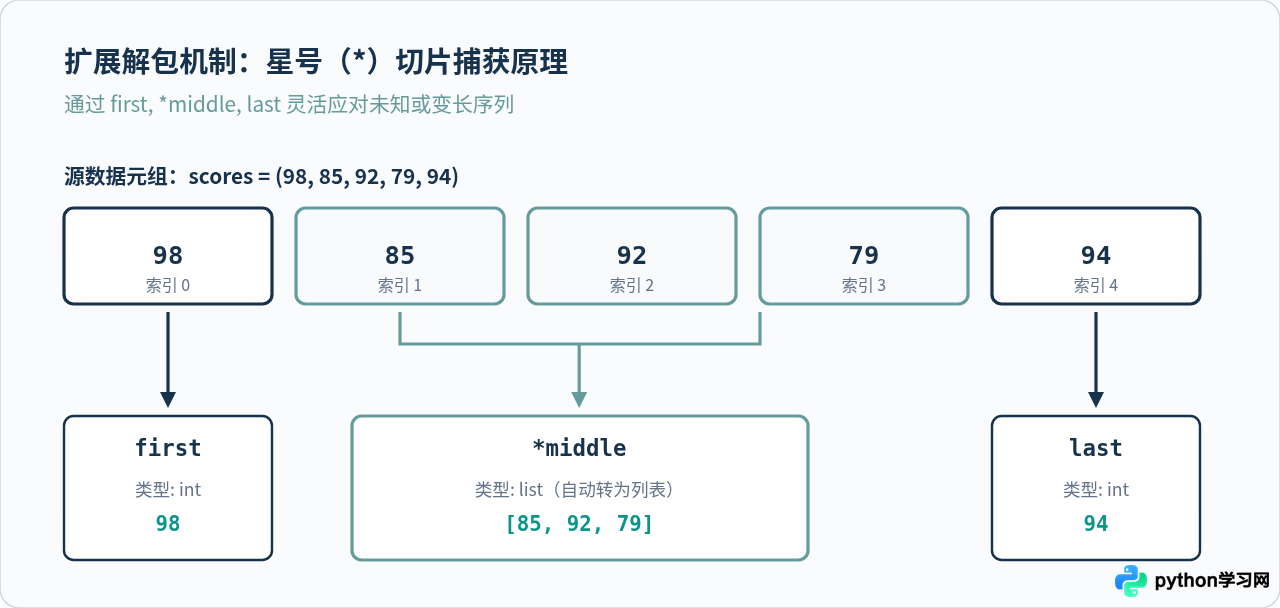
六、技巧四:循环迭代与嵌套结构解包
解包语法在 for 循环中尤为常见。除了遍历字典键值对的 for key, val in dict.items() 外,它还能无缝支持多层嵌套元组的深度拆解:
# 带有嵌套结构的地理数据
locations = [
    ("北京分部", (116.40, 39.90), "主力运营"),
    ("上海分部", (121.47, 31.23), "研发中心"),
]

# 直接在循环头完成深层嵌套解包
for branch_name, (lng, lat), role in locations:
    print(f"[{branch_name}] 角色: {role}, 坐标: E{lng}, N{lat}")

# 示例输出:
# [北京分部] 角色: 主力运营, 坐标: E116.4, N39.9
# [上海分部] 角色: 研发中心, 坐标: E121.47, N31.23
七、技巧五:惯用占位符与无用字段忽略
当解包的目标数据中包含我们不关心的冗余信息时,Python 社区的标准约定是使用单下划线 _ 作为占位符变量。配合星号语法,还可以写作 *_ 批量跳过多余项:
http_response = (200, "OK", "Content-Type: text/html", "Server: nginx", b"<html>...</html>")

# 只关注状态码和响应体,忽略中间的报头字段
code, _, *_, content = http_response

print("响应状态:", code)     # 示例输出:响应状态: 200
print("正文长度:", len(content)) # 示例输出:正文长度: 15
八、常见报错与避坑指南
在编写元组解包代码时,有两种最常见的运行时异常需要注意防范:
ValueError: not enough values to unpack:左侧变量数量多于右侧元素。例如a, b, c = (1, 2)。ValueError: too many values to unpack:左侧变量数量少于右侧元素,且未使用*进行收集。例如a, b = (1, 2, 3)。SyntaxError: two starred expressions in assignment:一个赋值表达式中只允许出现至多一个星号变量。形如*a, *b = sequence会在语法解析阶段直接报错。
九、总结
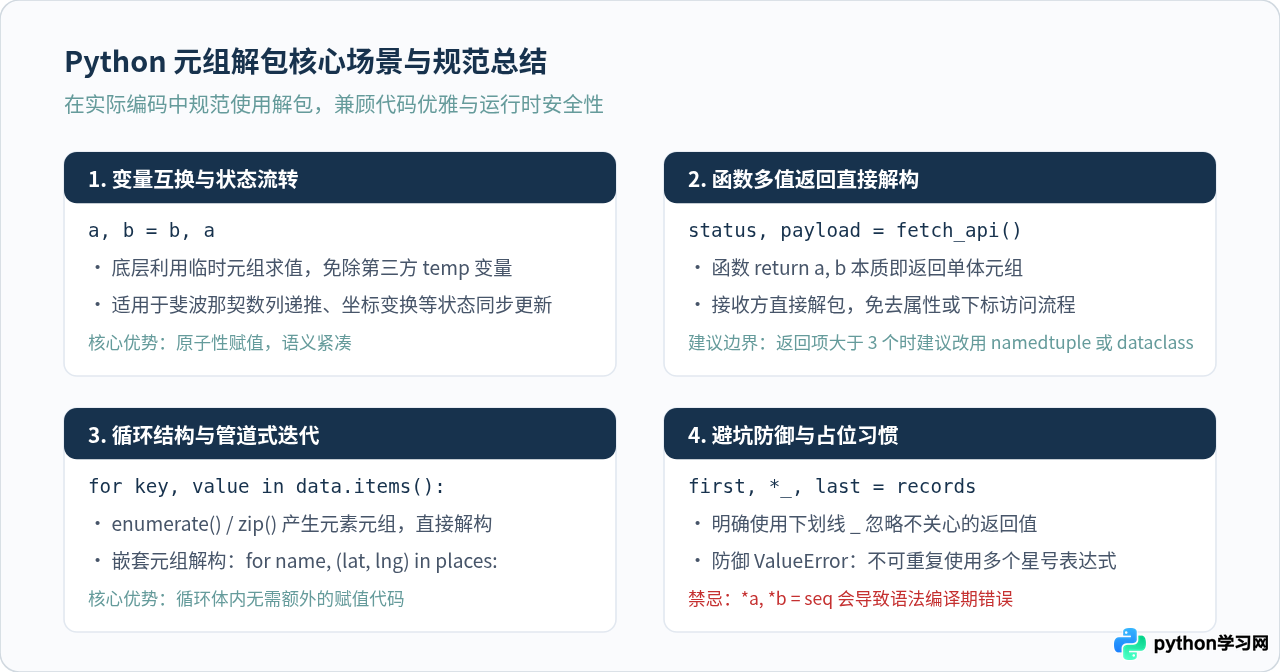
元组解包不仅是书写简洁 Python 代码的语法糖,更是一种强调语义明确与类型安全的设计模式。通过以声明式语法对齐变量与序列元素,元组解包消除了魔法索引、简化了函数返回值处理,并在状态轮转中保障了原子性。在实际工程中,建议遵循“小规模返回值优先解包、中大规模复杂结构使用数据类承载”的原则,从而兼顾编码效率与系统的可维护性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















