


Python 3面向对象进阶:元类、描述符与设计模式应用
深入解析Python 3面向对象高级特性,全面讲解描述符协议查找机制、元类生命周期拦截原理,并结合单例模式与轻量ORM模型展示设计模式的落地实践。
一、描述符协议:重构属性访问与验证控制
在常规面向对象代码中,实例的属性通常直接保存在其实例字典 __dict__ 中。但在需要实施类型约束、延迟加载、范围校验或跨字段依赖控制时,反复编写 @property 会导致类体膨胀且逻辑难以复用。描述符协议正是 Python 提供的一套将属性存取逻辑封装为独立类的底层协议。
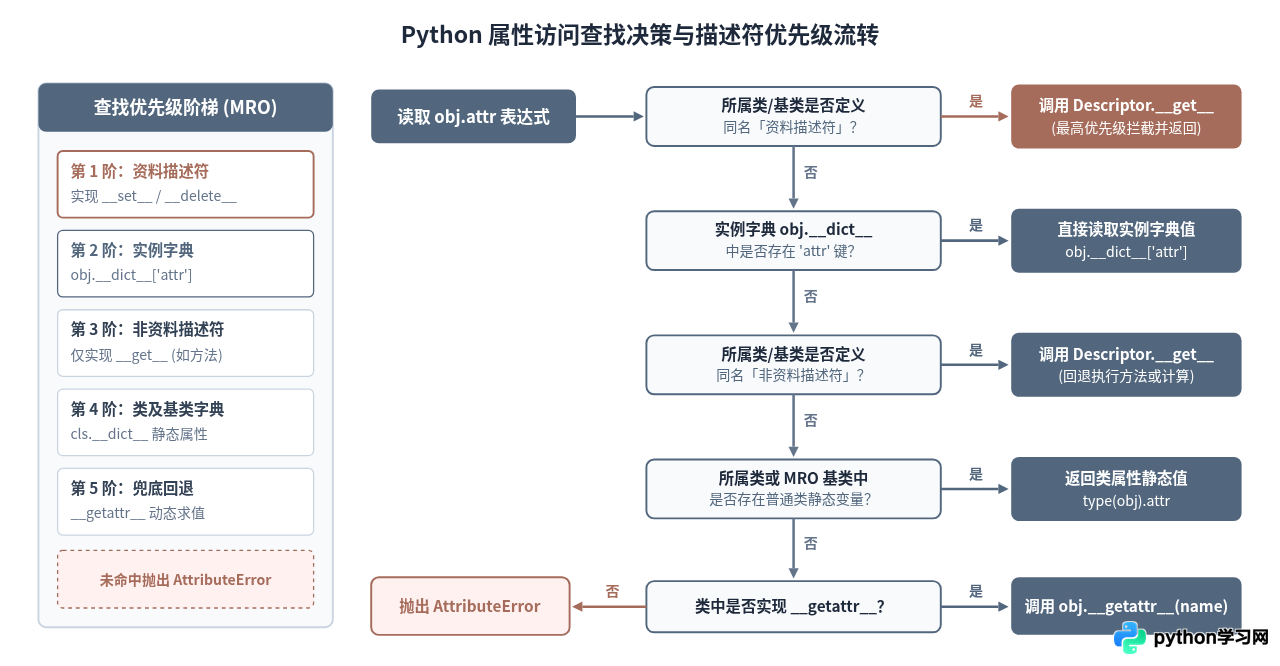
一个描述符只需在类中实现 __get__、__set__、__delete__ 或 Python 3.6 新增的 __set_name__ 方法中的任意一个。依据实现方法的不同,描述符分为两类:
- 资料描述符(Data Descriptor):实现了
__set__或__delete__(通常也包含__get__)。在 Python 的属性查找机制中,资料描述符的优先级高于实例自身的__dict__。 - 非资料描述符(Non-data Descriptor):仅实现了
__get__(例如常规的方法函数与@classmethod)。如果实例字典中存在同名键,其实例字典优先级更高。
描述符实战:类型安全与边界检查字段
下面是一个基于 Python 3.6+ 特性的通用数据校验描述符。借助 __set_name__ 回调,描述符无需显式传入字段名,即可自动推导并在宿主实例的底层字典中保存带前缀的独立私有属性,完全规避了命名碰撞与递归调用死循环问题:
class TypedField:
    """带类型检查与可选边界验证的资料描述符"""
    def __init__(self, expected_type, min_value=None, max_value=None):
        self.expected_type = expected_type
        self.min_value = min_value
        self.max_value = max_value

    def __set_name__(self, owner, name):
        # Python 3.6+ 自动在类创建时回调,绑定属性名称
        self.public_name = name
        self.private_name = f"_field_{name}"

    def __get__(self, instance, owner=None):
        if instance is None:
            # 通过类对象访问时(如 User.age),返回描述符对象本身
            return self
        return getattr(instance, self.private_name, None)

    def __set__(self, instance, value):
        # 1. 类型断言
        if not isinstance(value, self.expected_type):
            raise TypeError(
                f"属性 '{self.public_name}' 预期类型为 {self.expected_type.__name__},"
                f"实际接收为 {type(value).__name__}"
            )
        # 2. 数值边界断言
        if self.min_value is not None and value < self.min_value:
            raise ValueError(f"属性 '{self.public_name}' 不能小于 {self.min_value}")
        if self.max_value is not None and value > self.max_value:
            raise ValueError(f"属性 '{self.public_name}' 不能大于 {self.max_value}")

        # 3. 将合法数据写入实例的专用内部字段
        setattr(instance, self.private_name, value)

    def __delete__(self, instance):
        raise AttributeError(f"受保护字段 '{self.public_name}' 不允许被物理删除")
应用该描述符构建业务实体类:
class Employee:
    name = TypedField(str)
    age = TypedField(int, min_value=18, max_value=65)
    salary = TypedField(float, min_value=0.0)

    def __init__(self, name: str, age: int, salary: float):
        self.name = name
        self.age = age
        self.salary = float(salary)

# 验证测试代码
if __name__ == "__main__":
    emp = Employee("张工", 28, 18500.0)
    print(f"员工信息有效:{emp.name}, {emp.age}岁, 薪资 {emp.salary}")

    # 示例输出:
    # 员工信息有效:张工, 28岁, 薪资 18500.0

    try:
        emp.age = 15  # 触发 ValueError
    except ValueError as err:
        print(f"校验拦截成功:{err}")
    # 示例输出:
    # 校验拦截成功:属性 'age' 不能小于 18
二、元类(Metaclass):控制类的构建生命周期
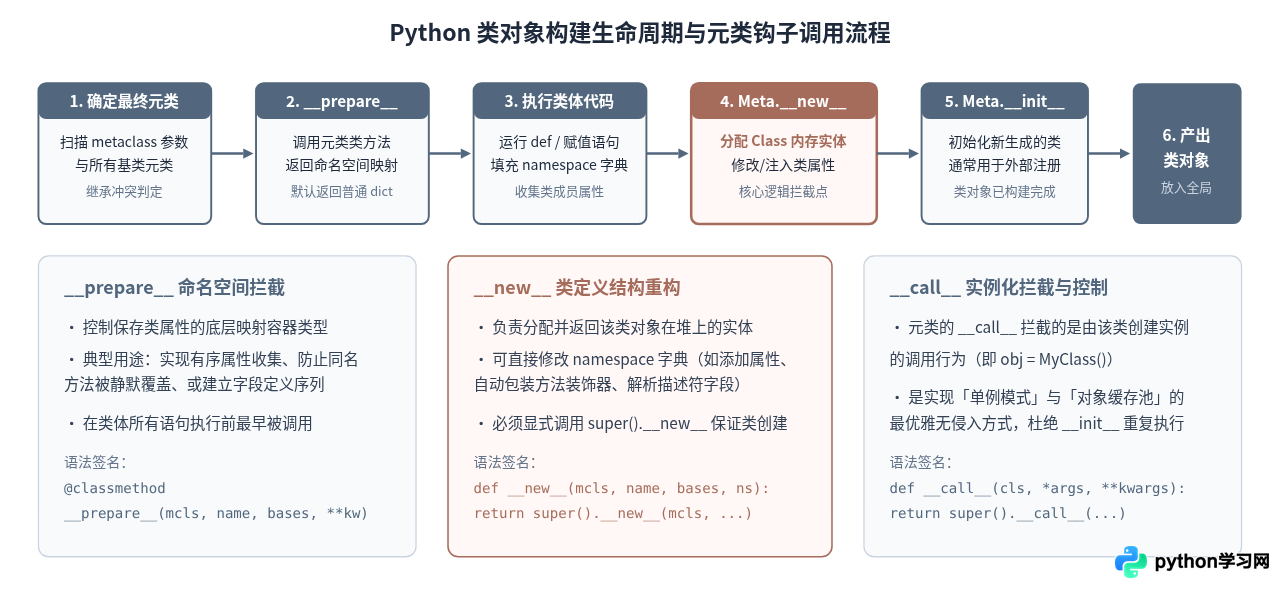
如果说类是创建实例对象的蓝图,那么元类就是创建类对象的蓝图。在 Python 中,“一切皆对象”,类本身也是一个由其元类(默认是内置的 type)在模块加载时实例化出的对象。
当 Python 解释器扫描到一个 class Foo(Base, metaclass=Meta): 声明块时,并不会立刻将它作为成品类抛入全局命名空间,而是遵循一套严谨的构建流水线:
三、设计模式深度实战:元类与描述符的优雅结合
1. 线程安全的元类单例模式(Singleton Pattern)
常见单例写法通常重写类的 __new__ 方法。但其致命缺陷在于:即使 __new__ 返回了已经存在的缓存实例,Python 运行时仍旧会再次无条件触发该实例的 __init__ 初始化函数,导致对象状态被意外重置。
而通过在元类的 __call__ 方法中拦截类的实例化过程,可以从源头上决定是否执行类的创建与初始化逻辑:
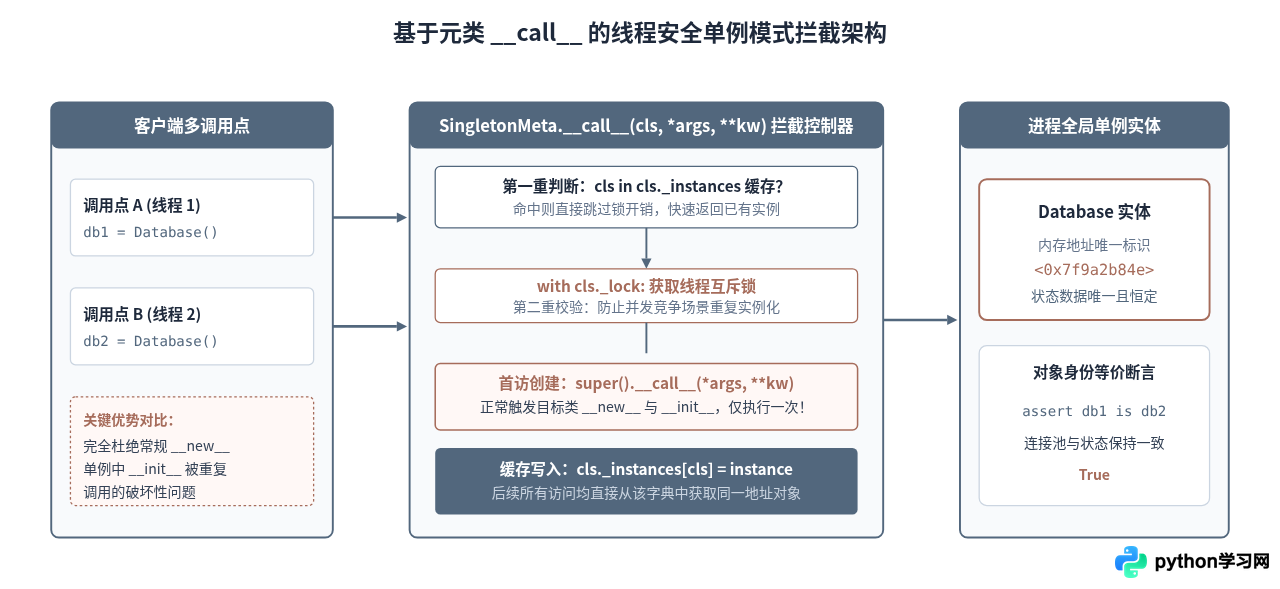
以下为完整的生产级单例元类实现:
import threading

class SingletonMeta(type):
    """线程安全的单例元类,统一控制类实例化入口"""
    _instances = {}
    _lock = threading.Lock()

    def __call__(cls, *args, **kwargs):
        # 第一次判定:读操作无需加锁,保障高并发下的读取性能
        if cls not in cls._instances:
            with cls._lock:
                # 第二次判定:加锁后再次校验,防止并发写入产生多个实例
                if cls not in cls._instances:
                    # 仅在真正需要实例化时调用父类的 __call__
                    instance = super().__call__(*args, **kwargs)
                    cls._instances[cls] = instance
        return cls._instances[cls]

class DatabasePool(metaclass=SingletonMeta):
    def __init__(self, host="127.0.0.1", port=5432):
        self.host = host
        self.port = port
        self.connection_count = 0
        print(f"执行数据库连接池初始化 -> {self.host}:{self.port}")

    def acquire(self):
        self.connection_count += 1
        return f"Conn-{self.connection_count}"

# 测试验证代码
if __name__ == "__main__":
    p1 = DatabasePool()
    p2 = DatabasePool(host="192.168.1.100") # 传参不会重复触发 __init__

    print(f"p1 与 p2 是否指向同一个物理对象:{p1 is p2}")
    # 示例输出:
    # 执行数据库连接池初始化 -> 127.0.0.1:5432
    # p1 与 p2 是否指向同一个物理对象:True
2. 声明式轻量 ORM:元类与描述符的抽象工厂落地
像 Django ORM 或 SQLAlchemy 这样优秀的框架,核心结构均是元类 + 描述符的协同工作:描述符充当模型表的字段(Column),负责单字段的合法性约束与存取转换;元类在类加载时扫描所有描述符成员,并将其归拢进统一的模型元数据(_fields)中,构造出一个自动组装的抽象建造工厂。
class Field:
    """ORM 字段基础描述符"""
    def __init__(self, data_type, required=True, default=None):
        self.data_type = data_type
        self.required = required
        self.default = default

    def __set_name__(self, owner, name):
        self.name = name
        self.storage_key = f"_val_{name}"

    def __get__(self, instance, owner=None):
        if instance is None:
            return self
        return getattr(instance, self.storage_key, self.default)

    def __set__(self, instance, value):
        if value is None:
            if self.required:
                raise ValueError(f"必填字段 '{self.name}' 不能为空")
            setattr(instance, self.storage_key, self.default)
            return

        if not isinstance(value, self.data_type):
            raise TypeError(f"字段 '{self.name}' 必须为 {self.data_type.__name__} 类型")
        setattr(instance, self.storage_key, value)


class ModelMeta(type):
    """ORM 模型元类:自动收集字段元数据并生成表配置"""
    def __new__(mcls, name, bases, namespace):
        fields = {}
        # 扫描类命名空间中所有属于 Field 描述符的属性
        for key, value in list(namespace.items()):
            if isinstance(value, Field):
                fields[key] = value

        # 注入统一元信息字典
        namespace["_fields"] = fields
        namespace["_table_name"] = namespace.get("__table__", name.lower())

        return super().__new__(mcls, name, bases, namespace)


class BaseModel(metaclass=ModelMeta):
    """业务数据模型基类"""
    def __init__(self, **kwargs):
        # 依据元类收集的 _fields 字段清单,统一填充并校验传入参数
        for field_name, field_obj in self._fields.items():
            value = kwargs.get(field_name, field_obj.default)
            setattr(self, field_name, value)

    def to_dict(self):
        """序列化输出为字典"""
        return {name: getattr(self, name) for name in self._fields}

    def generate_insert_sql(self):
        """基于元类扫描的表名与字段动态生成 SQL 语句"""
        columns = list(self._fields.keys())
        placeholders = [f":{c}" for c in columns]
        return f"INSERT INTO {self._table_name} ({', '.join(columns)}) VALUES ({', '.join(placeholders)});"


# 业务声明式定义
class UserAccount(BaseModel):
    __table__ = "t_user_account"

    id = Field(int, required=True)
    username = Field(str, required=True)
    is_active = Field(bool, required=False, default=True)

# 测试执行
if __name__ == "__main__":
    user = UserAccount(id=1001, username="admin_dev")
    print("序列化字典:", user.to_dict())
    print("生成SQL:", user.generate_insert_sql())

    # 示例输出:
    # 序列化字典: {'id': 1001, 'username': 'admin_dev', 'is_active': True}
    # 生成SQL: INSERT INTO t_user_account (id, username, is_active) VALUES (:id, :username, :is_active);
四、选型边界与技术体系总结
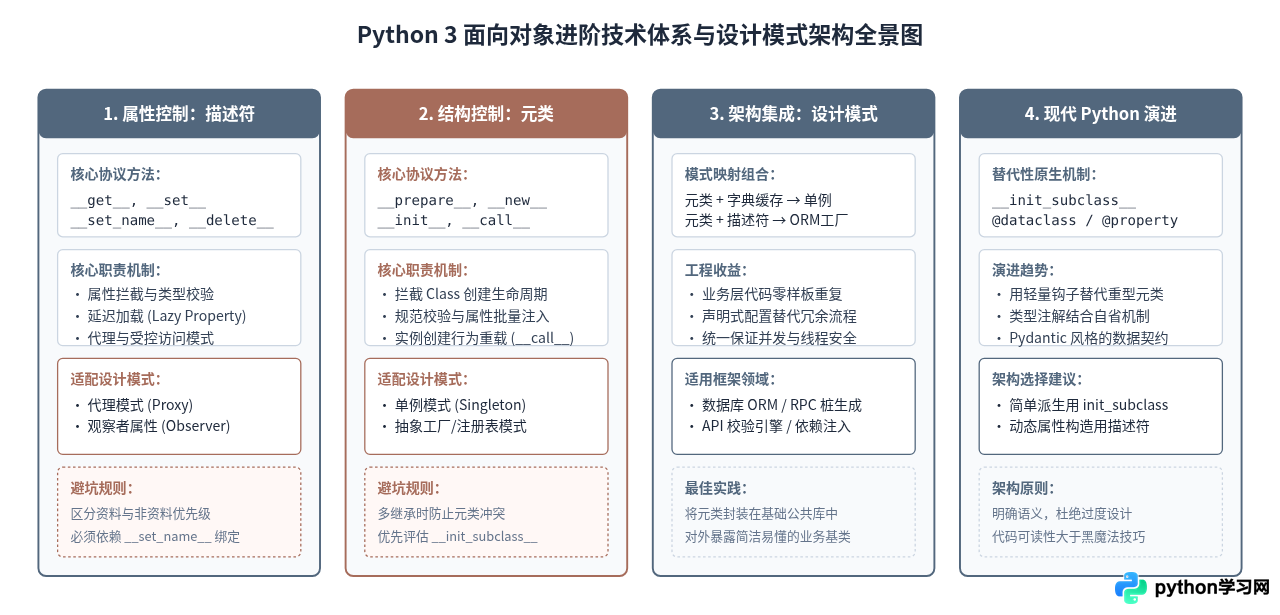
元类与描述符虽然赋予了 Python 极高的动态表达力,但在实际工程架构中应恪守“最小作用域原则”。正如 Python 核心开发者 Tim Peters 所述:“元类深奥至极,99% 的开发者永远不需要担心它”。在决定使用底层进阶特性前,应对比不同技术手段的成本与边界:
| 技术方案 | 介入生命周期 | 作用范围 | 典型应用场景 | 工程维护成本 |
|---|---|---|---|---|
| 普通装饰器 | 函数/类定义后 | 单一函数或单个类 | 日志拦截、鉴权切面、缓存 | 低(最优先推荐) |
| 描述符协议 | 属性访问阶段 | 类的某个特定属性 | 数据校验、惰性计算、受限字段 | 中(需处理好 __set_name__) |
| __init_subclass__ | 子类派生时 | 继承树直接子类 | 简单子类注册、插件式结构检测 | 中低(Python 3.6+ 推荐) |
| 元类 (Metaclass) | 类对象构建全流程 | 类本身及其全部后代 | ORM 引擎、单例模式、全自动类注册 | 高(需谨慎处理元类冲突) |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















