


Python实现定时任务的5种常用方案对比与选型
深入对比Python实现定时任务的5种常用方案:内置sleep/sched、schedule库、APScheduler框架、Celery Beat分布式调度以及系统级Crontab,涵盖完整代码示例、架构原理与企业级选型指南。
在开发 Python 应用程序时,定时执行特定的业务逻辑是普遍存在的技术诉求,例如每日凌晨的报表聚合、定时抓取外部数据、定期清理过期文件以及高频微批次的数据同步。不同场景对调度的精度、并发能力、故障自愈和分布式支持有着截然不同的指标要求。本文系统梳理 Python 生态中 5 种最主流的定时任务实现方案,拆解其实现代码与内部机制,并提供清晰的选型决策依据。
一、标准库方案:time.sleep 与 sched 模块
对于单次运行的小型脚本或临时维护脚本,最轻量级的做法是直接使用 Python 内置的标准库,完全无需引入任何第三方模块。
1. while 循环配合 time.sleep
这种方案通过死循环搭配休眠函数实现固定周期的重复执行。代码直观易懂,但属于硬阻塞模式:
import time
from datetime import datetime

def job():
    print(f"[{datetime.now()}] 执行周期性清理任务...")

def run_loop(interval_seconds=60):
    while True:
        job()
        time.sleep(interval_seconds)

if __name__ == "__main__":
    # 示例输出:每60秒触发一次
run_loop(60)局限性:如果 job() 执行耗时较长(例如单次执行花费 15 秒),那么实际触发周期就会变成 75 秒,导致累积时间漂移;此外,主线程被完全阻塞,无法响应外部调度命令。
2. sched 模块通用事件调度器
Python 标准库提供了 sched 模块,它基于优先级队列管理延迟事件,能够支持多任务的按时调度:
import sched
import time
from datetime import datetime

scheduler = sched.scheduler(time.time, time.sleep)

def task(name):
    print(f"[{datetime.now()}] 任务执行: {name}")
    # 重新注入自身实现周期调度
    scheduler.enter(5, 1, task, argument=(name,))

if __name__ == "__main__":
    # 参数含义:延迟5秒,优先级1,执行目标函数及参数
    scheduler.enter(5, 1, task, argument=("监控数据采集",))
    print("调度器启动...")
scheduler.run()适用场景与边界:适用于无外置依赖的纯本地脚本、单元测试或极简单的监控检查。由于任务全部保存在内存中,一旦 Python 进程退出或机器重启,所有未触发的任务将彻底丢失,且不支持多进程并发执行。
二、轻量级声明式工具:schedule 库
schedule 是一个追求极简与人性化 API 设计的第三方定时任务库,采用类似领域特定语言(DSL)的链式语法,极大地提升了代码的可读性。
# 安装方式
# pip install schedule

import schedule
import time

def send_daily_report():
    print("正在发送每日业务报表...")

def ping_health_check():
    print("正在执行心跳检测...")

# 声明任务执行规则
schedule.every(10).seconds.do(ping_health_check)
schedule.every().day.at("09:30").do(send_daily_report)
schedule.every().monday.at("10:00").do(send_daily_report)

if __name__ == "__main__":
    print("schedule 任务驱动中...")
    while True:
        # 检测并执行所有到期任务
        schedule.run_pending()
        time.sleep(1)
技术要点与避坑提醒:
- 主循环驱动:
schedule自身不包含后台线程,必须依靠显式的while True循环配合schedule.run_pending()来驱动执行。 - 执行阻塞问题:默认情况下任务是在驱动线程中按序串行执行的。如果某个任务抛出未捕获的异常,会导致后续周期受到干扰,生产环境中应在任务外部包装装饰器或单独放入子线程执行。
三、企业级单机全功能框架:APScheduler
APScheduler(Advanced Python Scheduler)是 Python 生态中最完备、工业级成熟度最高的任务调度框架。它支持基于日期(Date)、固定间隔(Interval)以及类 Unix Cron 表达式(Cron)的复杂调度逻辑,并原生支持线程池、进程池以及 AsyncIO 异步驱动。
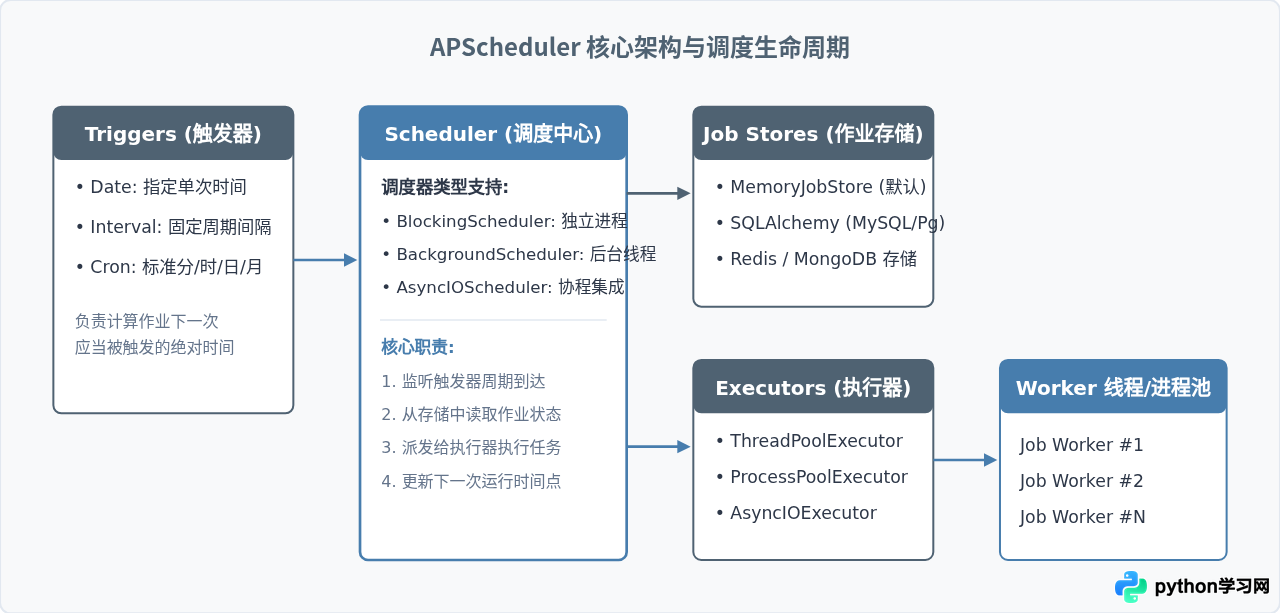
APScheduler 生产级实战示例
from apscheduler.schedulers.background import BackgroundScheduler
from apscheduler.jobstores.sqlalchemy import SQLAlchemyJobStore
from apscheduler.executors.pool import ThreadPoolExecutor
import time
from datetime import datetime

# 配置作业持久化存储与执行线程池
jobstores = {
    'default': SQLAlchemyJobStore(url='sqlite:///jobs.sqlite')
}
executors = {
    'default': ThreadPoolExecutor(max_workers=10)
}
job_defaults = {
    'coalesce': True,            # 如果短时间内错过了多次运行,只补跑一次
    'max_instances': 3,          # 同一任务最大并发实例数
    'misfire_grace_time': 30     # 任务错过触发时间的容忍窗口(秒)
}

scheduler = BackgroundScheduler(
    jobstores=jobstores,
    executors=executors,
    job_defaults=job_defaults
)

def sync_data(source_id):
    print(f"[{datetime.now()}] 正在同步数据源: {source_id}")

# 添加基于 Cron 语法的定时任务:每周一至周五 08:30 执行
scheduler.add_job(
    sync_data,
    trigger='cron',
    day_of_week='mon-fri',
    hour=8,
    minute=30,
    args=['SOURCE_A'],
    id='sync_job_001',
    replace_existing=True
)

if __name__ == "__main__":
    scheduler.start()
    print("APScheduler 生产后台调度服务已启动...")
    try:
        while True:
            time.sleep(2)
    except (KeyboardInterrupt, SystemExit):
        scheduler.shutdown()
四、分布式与高并发异步任务:Celery + Celery Beat
当业务进入大型微服务体系、任务需要跨多台机器分布式调度、或者定时任务需要消耗大量 CPU/内存资源时,单进程内部的调度器已无法支撑。此时标准的行业解决方案是基于消息中间件的 Celery + Celery Beat。
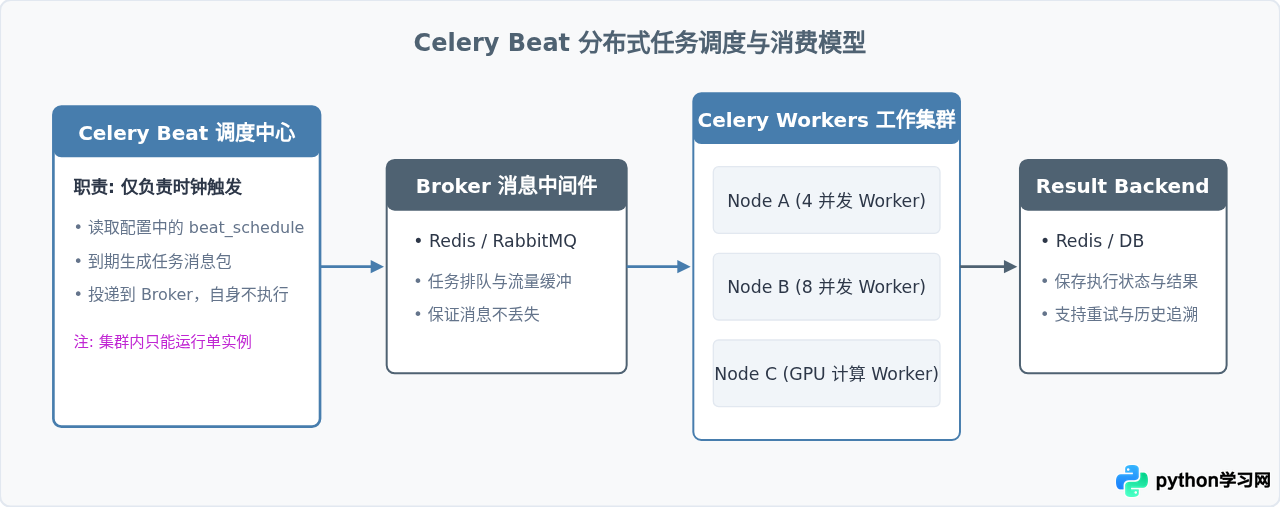
Celery 配置与调度定义
# tasks.py
from celery import Celery
from celery.schedules import crontab

app = Celery('proj_tasks', broker='redis://localhost:6379/0', backend='redis://localhost:6379/1')

# 调度计划配置
app.conf.beat_schedule = {
    'execute-every-midnight': {
        'task': 'tasks.clean_cache_task',
        'schedule': crontab(hour=0, minute=0),
        'args': (True,)
    },
    'refresh-token-interval': {
        'task': 'tasks.refresh_token_task',
        'schedule': 300.0,  # 每5分钟执行一次
    }
}

@app.task
def clean_cache_task(force_clean):
    print(f"正在分布式节点执行缓存清理, 强制模式: {force_clean}")
    return "SUCCESS"

@app.task
def refresh_token_task():
    print("刷新三方平台 AccessToken...")
return "REFRESHED"celery -A tasks worker --loglevel=info;启动调度触发器:celery -A tasks beat --loglevel=info。切忌同时启动多个 Beat 实例,否则同一时刻会向消息队列中重复投递相同任务。
五、操作系统级调度:Linux Crontab 与 Systemd Timers
将定时任务的管理权直接交给操作系统内核,由底层系统守护进程按计划拉起独立的 Python 脚本。这种方案在运维体系中极受推崇,尤其适合低频、重批处理或对内存常驻有顾忌的独立任务。
1. Linux Crontab 配置范式
通过执行 crontab -e 编辑定时列表。为避免环境变量缺失,必须显式书写虚拟环境中的 Python 绝对路径:
# 每天凌晨 02:00 运行数据归档脚本,并将标准输出与错误重定向到日志
0 2 * * * /opt/venv/bin/python /var/www/project/scripts/archive_data.py >> /var/log/archive.log 2>&1

# 每隔15分钟检查一次服务器连通性
*/15 * * * * /opt/venv/bin/python /var/www/project/scripts/check_nodes.py >> /var/log/check.log 2>&1
核心优势与代价:
- 零运行时内存开销:任务在不执行时不占用服务器任何 Python 内存。
- 故障隔离彻底:单次执行崩溃退出完全不影响系统下一次触发,天然具备防内存泄漏属性。
- 缺点:精度受限于分钟级,无法感知毫秒与秒级;跨机器分布式集群调度维护繁琐,且任务状态无法被应用主进程直观感知。
六、工程落地实操流程与排查步骤
在生产环境中引入定时任务,不仅是编写几行调度代码,还需要按照标准的工程化规范做好生命周期管理。
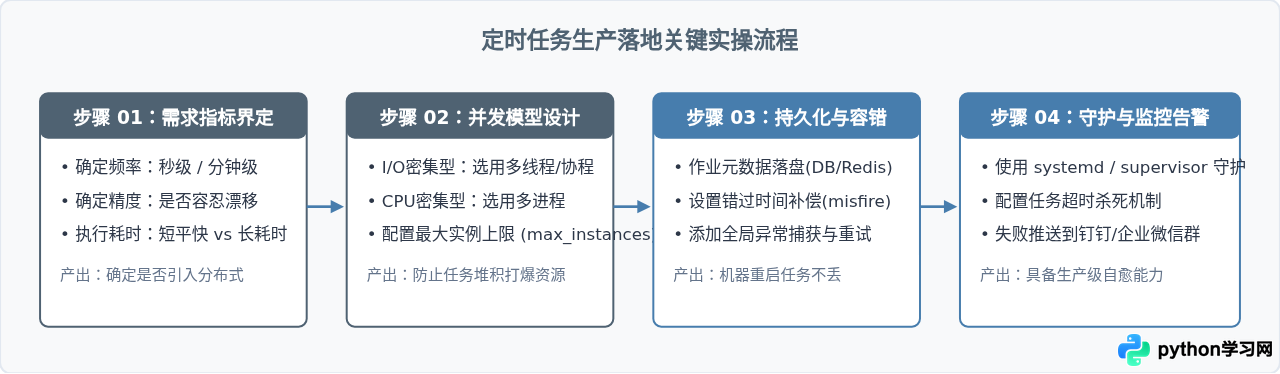
七、5种方案横向对比与技术选型决策
为了让架构师和开发者在面对实际需求时能够快速做出精准选择,下表将5种方案在关键维度上的特性进行了横向汇总:
| 方案名称 | 外部依赖 | 调度语法支持 | 持久化与容灾 | 分布式高可用 | 主要适用场景 |
|---|---|---|---|---|---|
| time.sleep / sched | 无(标准库) | 仅支持固定秒数延迟 | 无(纯内存) | 不支持 | 单元测试、单次小脚本、临时调试 |
| schedule 库 | 需安装第三方库 | 链式自然语言(天/周/时间点) | 无(纯内存) | 不支持 | 中小型脚本、内部工具、语法易读优先 |
| APScheduler | 需安装第三方库 | Date、Interval、标准 Cron | 原生支持 (SQLAlchemy/Redis) | 单机主备 / 共享存储 | Flask/FastAPI/Django 后台任务、复杂单机系统 |
| Celery Beat | 依赖 Redis/RabbitMQ | 秒/Cron/相对调度 | 强(依赖中间件落盘) | 原生支持分布式集群扩展 | 大型分布式微服务、耗时长与高负载计算 |
| Crontab / Systemd | 宿主操作系统 | 标准 Cron 语法(分钟级) | 系统级配置持久化 | 单机系统级维护 | 独立数据批处理脚本、离线数据备份、内存敏感型任务 |
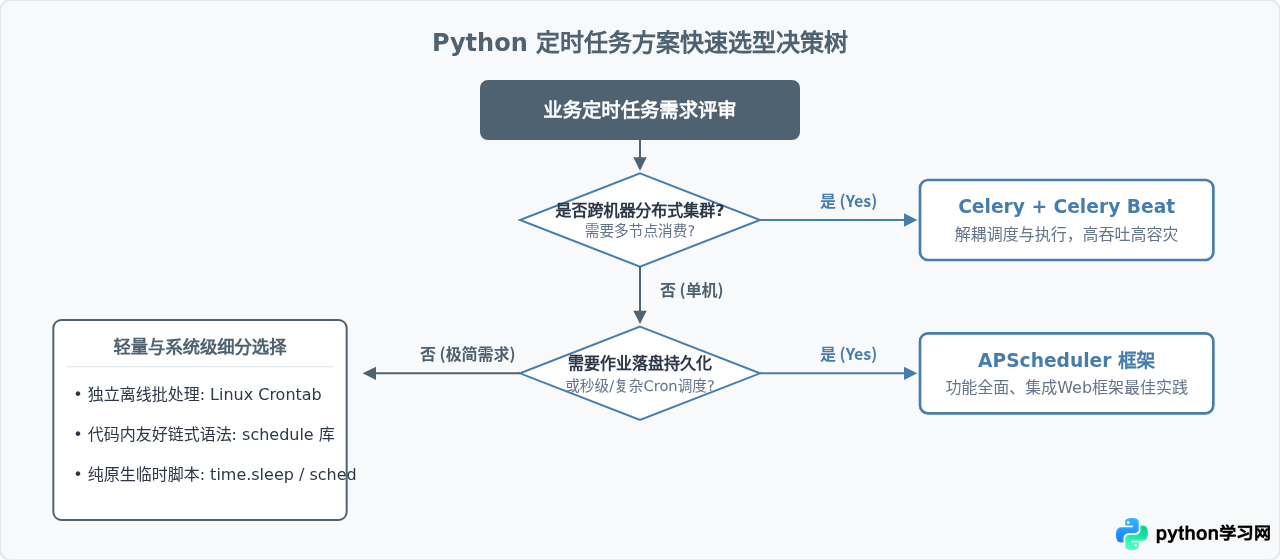
核心选型总结
- 如果是独立批处理或数据归档脚本:优先采用
Linux Crontab,利用系统级守护实现天然的内存清理与崩溃重置。 - 如果是与 Web 框架(FastAPI / Flask / Django)深度融合的单机业务系统:毫不犹豫选用
APScheduler,它能精准控制线程池、动态向数据库注入/删除作业,并支持完备的 Cron 表达式。 - 如果是大型分布式微服务、需要消费海量高并发异步任务:选择
Celery + Celery Beat,让调度端与工作节点在物理上彻底解耦,保障单点故障不会引起整体系统瘫痪。 - 如果是个人玩具项目、轻量级爬虫或开发辅助工具:
schedule提供的极简可读性能够以最低的开发心智成本满足诉求。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















