


怎么解决Python定时任务因执行耗时导致的2秒间隔误差

在编写周期性为2秒的Python定时任务时,最直接的写法通常是在循环末尾调用 time.sleep(2)。然而,如果任务本体执行需要0.4秒,单次周期的实际耗时就会变成2.4秒。随着运行次数增加,任务触发点会迅速向后推迟,产生累积漂移。解决这个问题的核心,是将“固定休眠2秒”改为“动态扣除执行耗时”,或者使用基于固定绝对时间轴调度的异步并发机制。
1. 误差产生的根源:串行阻塞与固定休眠
使用 while True 搭配 time.sleep(2) 时,整个程序的执行流是严格串行的。每个周期的总时长等于“业务耗时”与“休眠耗时”之和。只要业务函数存在网络请求、磁盘读写或数据计算,耗时就必然大于0,导致每个周期的起点被不断后延。
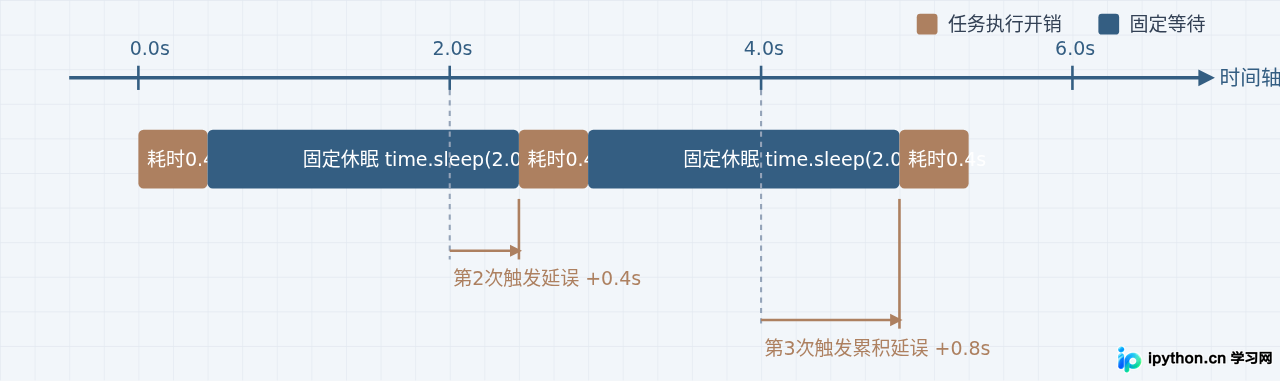
图 1:使用固定 sleep 产生的时间轴累积漂移原理
典型错误代码如下:
import time

def task():
    # 模拟耗时 0.4 秒的业务操作
    time.sleep(0.4)

while True:
    task()
    time.sleep(2.0)  # 每次实际间隔为 2.4 秒
为了保持严格的2秒节拍,程序必须采用动态补偿或绝对时钟对齐方案。
2. 实施方案:从单线程补偿到高精度调度
方法一:基于 time.monotonic() 动态扣除耗时(单任务推荐)
在单线程场景下,最轻量的修正方式是在任务执行前记录高精度的单调时钟,执行后计算花费了多长时间,休眠剩余的 2.0 - 耗时 秒。使用 time.monotonic() 代替 time.time(),可以避开系统时间校对或夏令时调整带来的时间突变风险。
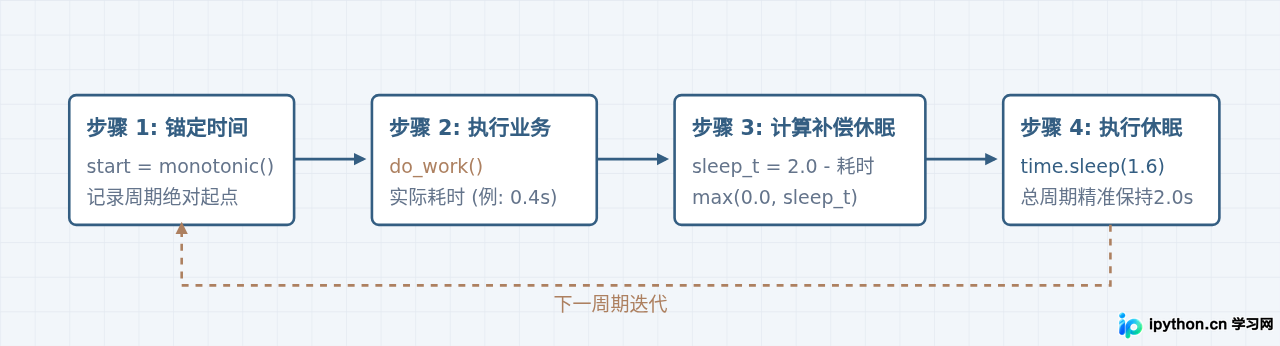
图 2:单线程动态扣除执行耗时的操作步骤
完整代码实现如下:
import time

INTERVAL = 2.0

def do_work():
    # 模拟耗时波动的业务任务
    time.sleep(0.35)

def run_loop():
    # 记录初始基准点
    next_time = time.monotonic()

    for i in range(5):
        next_time += INTERVAL

        # 执行业务逻辑
        start_exec = time.monotonic()
        do_work()
        cost = time.monotonic() - start_exec

        # 计算距离目标触发点还需休眠多久
        delay = next_time - time.monotonic()
        if delay > 0:
            time.sleep(delay)
        else:
            # 业务耗时超过了2秒,跳过本次休眠直接进入下一轮
            print(f"警告: 周期超时,单次执行耗时 {cost:.2f} 秒")

if __name__ == "__main__":
run_loop()[Tick 2] 触发点距启动时刻: 4.0003 秒
[Tick 3] 触发点距启动时刻: 6.0002 秒
[Tick 4] 触发点距启动时刻: 8.0004 秒
sleep(2.0 - cost),而是使用了累加的 next_time。这种写法能将单次 sleep 自身的系统级调度微小误差(通常在 1-2 毫秒)也在下一次循环中自动消除,防止微小误差长期累加。
方法二:使用 asyncio 异步解耦(I/O密集型任务推荐)
如果任务主要由网络请求或异步I/O构成,可以通过 asyncio.create_task() 将任务派发至事件循环后台运行,主循环仅负责严格每2秒发出一次执行信号,使耗时完全与计时解耦。
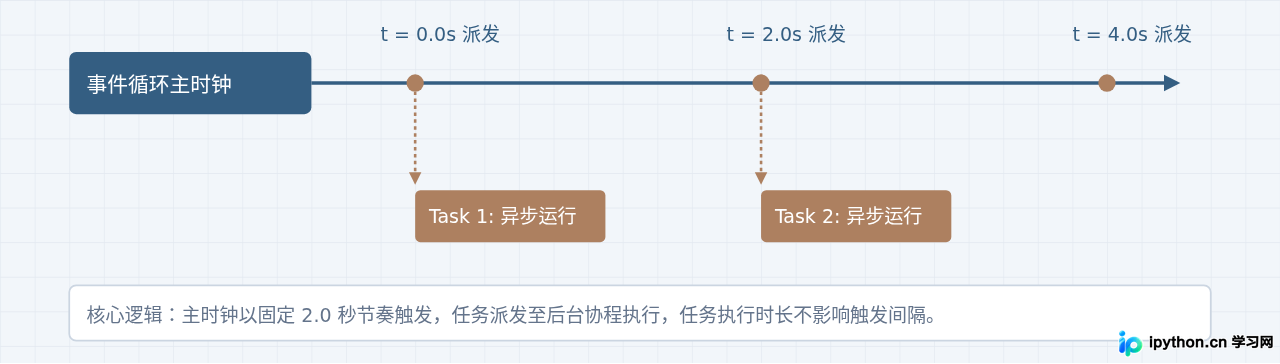
图 3:异步事件循环派发机制原理
异步实现代码:
import asyncio

async def async_job(job_id):
    # 模拟耗时 0.6 秒的网络请求
    await asyncio.sleep(0.6)

async def main():
    interval = 2.0
    while True:
        loop_start = asyncio.get_running_loop().time()

        # 派发到后台并发运行,不阻塞当前定时器
        asyncio.create_task(async_job("job_task"))

        # 计算下一次触发所需等待的绝对差值
        elapsed = asyncio.get_running_loop().time() - loop_start
        await asyncio.sleep(max(0.0, interval - elapsed))

if __name__ == "__main__":
    asyncio.run(main())
方法三:借助成熟调度库 APScheduler(工程项目推荐)
在复杂的生产环境中,手动编写时间补偿可能会遇到线程重入、异常中断、错过触发等边界问题。使用成熟的定时框架 APScheduler,它内置了时间戳对齐算法和线程池执行机制。
# 需要先安装依赖: pip install apscheduler
from apscheduler.schedulers.blocking import BlockingScheduler
import datetime
import time

def periodic_job():
    print(f"触发时刻: {datetime.datetime.now().strftime('%H:%M:%S.%f')[:-3]}")
    time.sleep(0.4)  # 模拟耗时

if __name__ == '__main__':
    scheduler = BlockingScheduler()
    # 使用 interval 触发器,每 2 秒一次
    # max_instances 避免上一次没执行完时发生意外阻塞
    scheduler.add_job(periodic_job, 'interval', seconds=2, max_instances=2)

    try:
        scheduler.start()
    except (KeyboardInterrupt, SystemExit):
        pass
3. 关键边界问题与注意事项
在实际修复因耗时引起的误差时,需要关注以下两处核心限制:
- 单次执行耗时超过2秒(任务重叠风险):如果任务因网络慢卡顿了2.5秒,而设定的执行周期是2秒,无论如何计算,单线程都已经不可能维持2秒间隔。此时必须确定业务策略:是允许并发(使用多线程/协程立即开启下一个任务),还是丢弃落下的周期(跳过该点),或者排队顺序执行。
- 操作系统休眠精度的限制:Python标准库的
time.sleep()依赖于底层操作系统的时钟中断频率。在Windows平台上,默认的时钟精度通常在10到15毫秒左右;在Linux上通常可达1毫秒以内。因此,对于2秒周期的任务,动态补偿方案可以将误差控制在几毫秒以内,这足以满足绝大多数网络、数据拉取及监控需求。
4. 三种方案的适用场景对比
| 方案 | 代码依赖 | 时间漂移控制 | 任务耗时超过2秒时的表现 | 推荐使用场景 |
|---|---|---|---|---|
| 单调时钟动态扣除 | 纯标准库 | 优(通过基准点自校准) | 无法重叠,会导致后续节拍向后推延 | 单一轻量脚本、单线程无外部依赖环境 |
| asyncio 异步派发 | 纯标准库 | 极佳(后台协程并发) | 自动并行执行,触发间隔恒定为2秒 | I/O密集型任务、爬虫抓取、异步微服务 |
| APScheduler 框架 | 需第三方库 | 极佳(内置调度器自校准) | 可通过 max_instances 和并发策略精细控制 |
中大型系统、后台常驻服务、多任务混合调度 |
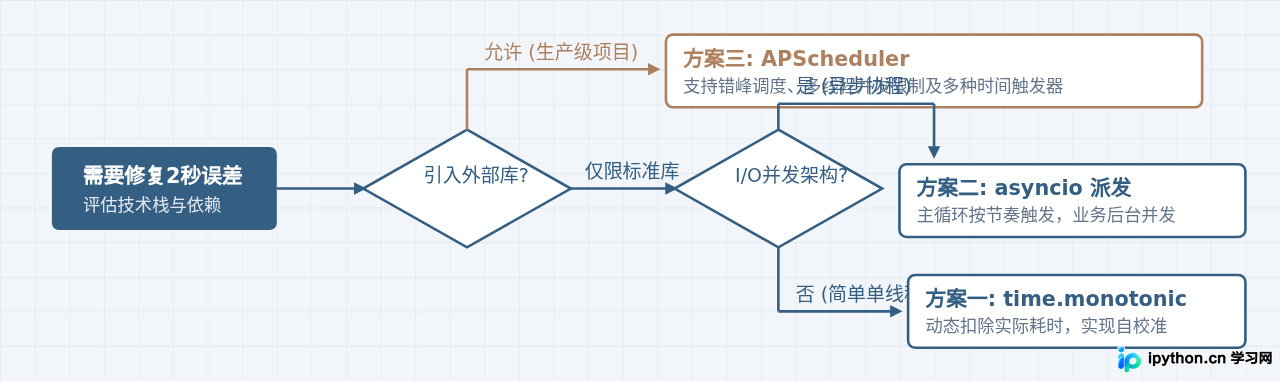
图 4:解决定时任务误差的技术选型路径总结
对绝大多数单脚本场景,将循环结构改造为基于 time.monotonic() 的基准点扣除方式,是改动最小、效果最明显的方案;而当单次任务耗时有概率触碰或突破2秒阈值时,应及时转向 asyncio 派发或 APScheduler 等并发调度机制。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















