


Python中文字符串切片注意事项:避免截断乱码问题
深入解析Python中文字符串切片机制,对比str与bytes切片行为,剖析UTF-8多字节截断导致乱码的根本原因,并提供按字节安全截断算法与工程实战方案。
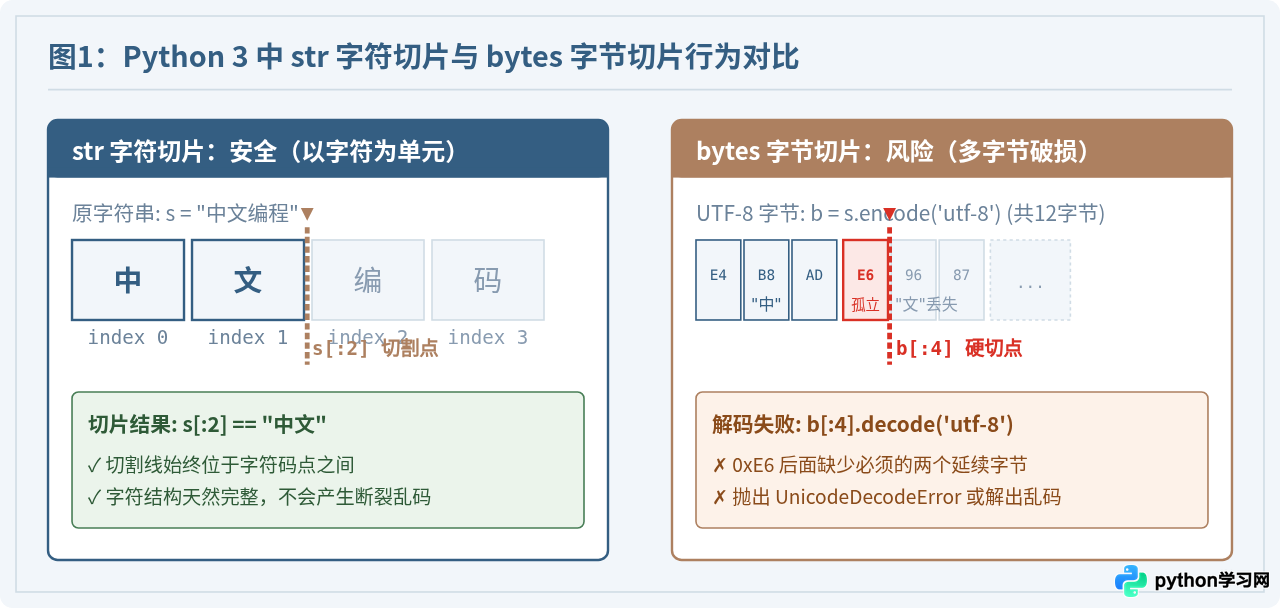
str 类型的字符串进行切片是完全以 Unicode 字符为单位的,绝不会发生把单个中文字符劈裂导致乱码的情况。切片截断乱码的真正元凶,发生在将字符串转换为 bytes(字节流)之后、或者与数据库限制、网络包大小及固定长度缓冲交互时,在多字节编码边界上执行了硬截断。掌握字符与字节的差异、理解 UTF-8 变长编码的边界特征,是彻底消除截断乱码的关键。
一、核心机制:str 切片与 bytes 切片的本质差异
在初学 Python 时,很多开发者容易把“字符长度”与“字节长度”混淆。Python 3 的字符串模型在语言层面严格区分了文本类型(str)与二进制序列(bytes)。
str 对象在 Python 内存中由 Unicode 码点构成。无论是一个英文英文字母 'A'、一个中文字符 '中',还是一个 Emoji 符号 '👍',在 str 的维度中均被视作长度为 1 的独立字符。因此,当使用 s[:3] 切取 str 时,切片索引表示的是字符数量,截取点永远落在字符与字符的边界上。
与此相对,bytes 代表不可变的原始字节序列。在常见的 UTF-8 编码下,一个中文字符通常占用 3 个字节。如果在 bytes 层次上指定切片长度(例如限制最多取 5 个字节),切片位置就有很大几率破坏多字节中文字符的完整结构,从而留下残缺字节。
二、底层机理:UTF-8 编码与半字符截断破坏
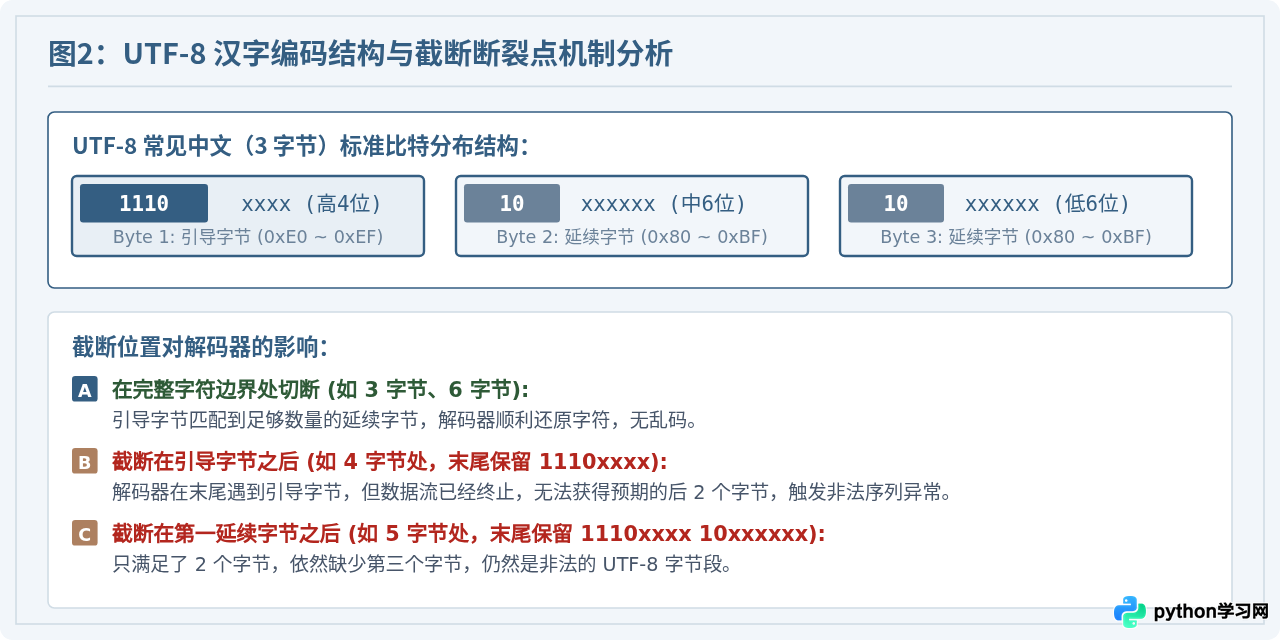
为了透彻理解为什么会产生乱码,我们需要观察 UTF-8 的二进制比特布局。UTF-8 是一种变长字符编码标准,它根据字符的 Unicode 码点大小,动态分配 1 到 4 个字节:
- 1 字节字符(ASCII 范围 0x00~0x7F):首位为
0,二进制格式形如0xxxxxxx。 - 2 字节字符(0x80~0x7FF):引导字节为
110xxxxx,后续跟随 1 个10xxxxxx延续字节。 - 3 字节字符(大部分常用汉字 0x800~0xFFFF):引导字节为
1110xxxx,后续跟随 2 个10xxxxxx延续字节。 - 4 字节字符(Emoji 及扩展平面汉字 0x10000 以上):引导字节为
11110xxx,后续跟随 3 个10xxxxxx延续字节。
UTF-8 的核心设计原则是前缀自同步:任意一个延续字节(Continuation Byte)都严格以 10 作为最高两位(即数值范围 0x80 至 0xBF)。如果一个引导字节(例如代表 3 字节汉字的 1110xxxx)被写入了流中,解码器在读完后续两个延续字节之前,绝不能完成解码。
我们可以通过一段简明的 Python 代码直接观察到这种断裂:
# 演示:bytes 盲目切片导致的 UnicodeDecodeError
text = "你好世界"
byte_data = text.encode("utf-8")

print(f"完整字节长度: {len(byte_data)}")
# 输出中文字符各自的 UTF-8 十六进制表示
for ch in text:
    print(f"{ch}: {ch.encode('utf-8').hex(' ').upper()}")

# 尝试切取前 5 个字节
truncated_bytes = byte_data[:5]
print(f"前5字节内容: {truncated_bytes.hex(' ').upper()}")

try:
    result = truncated_bytes.decode("utf-8")
except UnicodeDecodeError as err:
print(f"解码报错: {err}")完整字节长度: 12
你: E4 BD A0
好: E5 A5 BD
世: E4 B8 96
界: E7 95 8C
前5字节内容: E4 BD A0 E5 A5
解码报错: 'utf-8' codec can't decode bytes in position 3-4: unexpected end of data
如输出所示,"你好世界" 编码后共 12 字节(每个汉字 3 字节)。当我们截取前 5 个字节时,包含了完整的中文字符 "你"(3 字节:E4 BD A0)以及 "好" 的前 2 个字节(E5 A5),但丢弃了第三个字节(BD)。当执行 decode("utf-8") 时,Python 解码器发现末尾数据残缺,直接抛出 unexpected end of data 异常。
三、业务场景:哪些地方会遇到按字节截断需求?
既然 str 的切片天然安全,为什么在日常开发中还会频繁遭遇截断乱码呢?这是因为许多底层存储和通信协议的限制并非以字符数为衡量标准,而是以物理字节大小为准:
- 数据库字段限制:部分老旧系统或特定配置(例如 Oracle 的
VARCHAR2(N CHAR)与VARCHAR2(N BYTE)、MySQL 在特定版本和编码下的列限制),超长字节写入会报数据溢出错误。 - 短信与特定通信接口:经典短信网关协议通常规定单条报文长度不能超过 140 字节;许多微服务之间的二进制私有通信协议在包头中保留了定长(如 64 字节)的摘要或备注字段。
- 固定 Buffer 分块传输:在处理大文件流式解密、Socket 传输或分块哈希计算时,读取通常以
chunk_size=4096字节为批次。分块边界不可避免会切割到中文字符。
truncated_bytes.decode('utf-8', errors='ignore') 或 errors='replace' 来压制报错。这样做虽然不会导致程序崩溃,但 ignore 会悄悄丢弃半个汉字,造成字面意思失真;而 replace 则会在文末生成突兀的黑色问号乱码符 \ufffd(),在生产界面中极不美观,更无法在后续拼包时复原。
四、解决方案:安全按字节截断的算法与实现
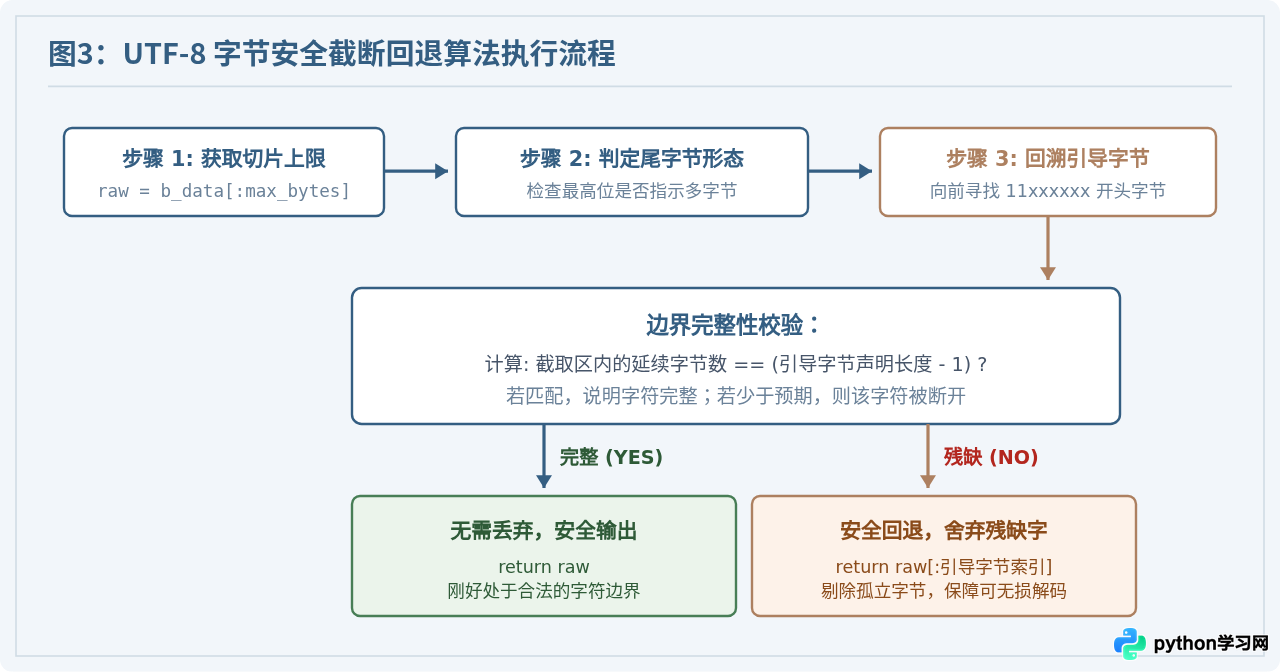
要实现在满足最大字节数 max_bytes 的前提下,既不抛出异常、也不出现乱码字符,最好的策略是:向前扫描回退,舍弃不完整的孤立多字节序列。
1. 回退截断算法的核心判断逻辑
依据 UTF-8 的二进制特征,如果一个截取位置切在了多字节字符的中间,我们只需从截取末尾向前检查:
- 如果当前末尾字节是 ASCII 字节(最高位为
0),说明此处正好是字符完整结尾,无需回退。 - 如果当前末尾字节最高两位是
10,说明这是一个延续字节。我们继续向前寻找,找到它的引导字节(11xxxxxx)。 - 一旦找到引导字节,根据其前缀判断该字符总共需要多少字节。如果当前截取的长度不足以容纳该字符全部字节,说明该字符被破坏,截取点应当回退到该引导字节之前。
2. 生产级截断实现函数
下面提供一个无需任何第三方依赖、基于原生位运算编写的高性能安全截断工具函数:
def truncate_utf8_by_bytes(text: str, max_bytes: int) -> str:
    """
    将中文字符串按指定的最大字节数安全截断,确保截取后的字节序列是合法的 UTF-8,
    绝不出现乱码或半字符,最终返回解码后的完整文本。
    """
    if max_bytes <= 0:
        return ""

    encoded = text.encode("utf-8")
    if len(encoded) <= max_bytes:
        return text

    # 初步按字节切取
    sliced = encoded[:max_bytes]

    # 从切片末尾向前扫描,寻找最近的非延续字节(引导字节或单字节)
    # UTF-8 延续字节的特征是: (b & 0xC0) == 0x80 (即二进制 10xxxxxx)
    index = max_bytes - 1
    while index >= 0 and (sliced[index] & 0xC0) == 0x80:
        index -= 1

    if index < 0:
        # 如果整个切片全为延续字节(极为罕见的非法边界),直接清空
        return ""

    lead_byte = sliced[index]

    # 根据引导字节判断该字符应有的总字节数
    if (lead_byte & 0x80) == 0:
        # 0xxxxxxx:单字节 ASCII 字符
        expected_len = 1
    elif (lead_byte & 0xE0) == 0xC0:
        # 110xxxxx:2 字节字符
        expected_len = 2
    elif (lead_byte & 0xF0) == 0xE0:
        # 1110xxxx:3 字节字符(大部分汉字)
        expected_len = 3
    elif (lead_byte & 0xF8) == 0xF0:
        # 11110xxx:4 字节字符(Emoji、罕见字)
        expected_len = 4
    else:
        # 不合法的引导字节,直接截断到该字节前
        return sliced[:index].decode("utf-8", errors="ignore")

    # 判断当前截取的实际长度是否满足字符完整长度
    actual_len = max_bytes - index
    if actual_len < expected_len:
        # 字符不完整,回退丢弃该引导字节及其残缺延续字节
        safe_bytes = sliced[:index]
    else:
        # 字符恰好完整
        safe_bytes = sliced

    return safe_bytes.decode("utf-8")
我们通过实际测试用例来验证该函数在各种字节边界下的稳定表现:
# 测试不同边界下的截断效果
sample = "Python中文切片避坑"
# 编码后长度: 'Python'(6) + 6个汉字*3(18) = 24 字节

test_limits = [5, 6, 7, 8, 9, 10, 11, 12]
for limit in test_limits:
    res = truncate_utf8_by_bytes(sample, limit)
    res_bytes_len = len(res.encode('utf-8'))
print(f"限制 {limit:2d} 字节 -> 结果: '{res:<10}' (实际字节: {res_bytes_len})")限制 5 字节 -> 结果: 'Pytho ' (实际字节: 5)
限制 6 字节 -> 结果: 'Python ' (实际字节: 6)
限制 7 字节 -> 结果: 'Python ' (实际字节: 6) [注: 第7字节只拿到'中'的1/3,主动回退]
限制 8 字节 -> 结果: 'Python ' (实际字节: 6) [注: 第8字节只拿到'中'的2/3,主动回退]
限制 9 字节 -> 结果: 'Python中 ' (实际字节: 9) [注: 刚好容纳'中'的完整3字节]
限制 10 字节 -> 结果: 'Python中 ' (实际字节: 9) [注: '文'字缺字节,主动回退]
限制 11 字节 -> 结果: 'Python中 ' (实际字节: 9)
限制 12 字节 -> 结果: 'Python中文' (实际字节: 12)
3. Python 标准库方案:IncrementalDecoder 增量流式处理
如果你正在编写底层网络 Socket 监听或分块文件流读取,除了手动回退之外,Python 标准库提供的 codecs.getincrementaldecoder 是最为标准的官方解决方案。
增量解码器内部维护了一个小型的状态缓冲区。当传入的字节块在末尾处断开时,解码器会自动把残缺的 1~2 个字节暂存在内部,先返回已经成功解码的字符。当下一个数据块到达并调用 decode(chunk) 时,它会自动拼合前一次暂存的字节继续解析,直到流结束(final=True)。
import codecs

# 模拟网络分包:每个包只能接收 5 个字节
decoder = codecs.getincrementaldecoder("utf-8")()
packet_stream = [byte_data[:5], byte_data[5:10], byte_data[10:]]

full_received_text = []
for i, packet in enumerate(packet_stream, 1):
    # final=False 表示数据流尚未结束,半字符自动缓存
    decoded_part = decoder.decode(packet, final=False)
    full_received_text.append(decoded_part)
    print(f"收到数据包 {i}: {packet.hex().upper()} -> 成功解出: '{decoded_part}'")

# 数据流彻底结束时通知解码器
final_part = decoder.decode(b"", final=True)
full_received_text.append(final_part)

print(f"最终完整拼接文本: '{''.join(full_received_text)}'")收到数据包 1: E4BDA0E5A5 -> 成功解出: '你' [注: E5A5 被自动缓存在解码器内]
收到数据包 2: BDE4B896E7 -> 成功解出: '好世' [注: 前包缓存的 E5A5 与当前 BD 拼出'好']
收到数据包 3: 958C -> 成功解出: '界'
最终完整拼接文本: '你好世界'
五、综合防御策略与场景决策
在实际工程项目中,遇到中文字符串截取需求时,应根据具体的业务侧重点采用不同的应对策略:
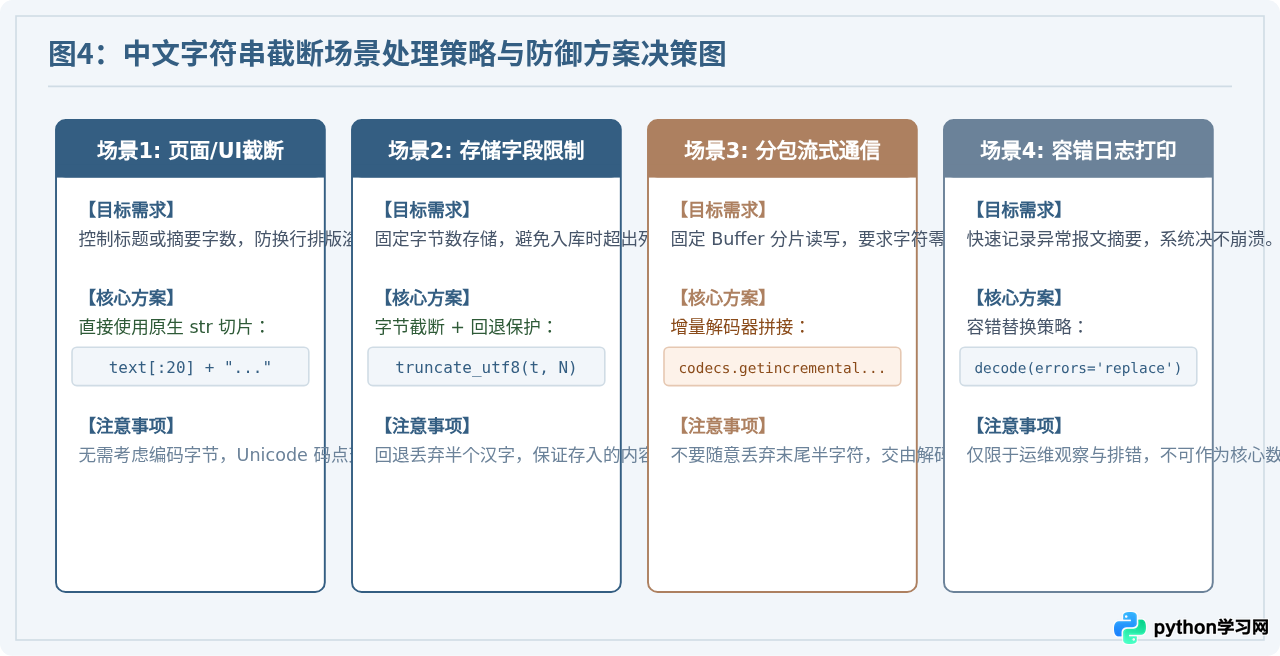
六、总结与避坑清单
| 截取对象 | 索引单位 | 是否存在乱码风险 | 最佳实践建议 |
|---|---|---|---|
str 类型字符串 |
Unicode 字符 (Code point) | 无风险 | 直接使用原生切片 text[:n],简单且高效。 |
bytes 字节序列 |
8 位原始字节 (Byte) | 高风险(多字节破坏) | 使用回退算法 truncate_utf8_by_bytes 剥除残缺字符。 |
| Socket / 文件分块读取 | 固定大小 Buffer | 极高(跨分包切割) | 使用 codecs.getincrementaldecoder 进行有状态增量拼包。 |
| 老旧协议 / 外部接口 | GBK / GB2312 编码 | 高风险(2 字节破坏) | GBK 为 2 字节编码,高位为 1 代表汉字,切片须判断双字节对齐。 |
在 Python 中处理中文字符串,只要牢记“显示与业务逻辑走字符,存储与传输走字节”的边界隔离原则,并在不可避免的字节切片场景下引入字符边界回溯与增量解码,即可彻底杜绝乱码与解码异常的发生。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















