


Python 多系列数据雷达图对比展示技巧
介绍如何使用 Python 绘制多系列数据雷达图,解决多维数据对比中的重叠遮挡、量纲不一和图例混乱问题,涵盖数据归一化、首尾闭合、视觉透明度与分面小多图等实用技巧与完整代码。
在对比多款产品、团队能力或模型评测指标时,雷达图(Radar Chart)因能直观展现多维特征的均衡度而被广泛使用。但在实际业务中,一旦需要对比 3 个甚至更多的系列,雷达图极易出现线条缠绕、色块互相覆盖以及量纲失衡等问题,导致图表失去可读性。本文将直接介绍多系列雷达图的核心优化路径,涵盖数据归一化、首尾闭合算法、半透明层叠控制以及小多图分面展示等实用技巧,并给出可直接运行的 Python 示例代码。
一、多系列雷达图面临的核心痛点与实施路径
在绘制单系列雷达图时,只需连接各维度顶点即可。然而当系列数量增加到两个以上时,读图体验会迅速劣化。常见的问题主要集中在三个方面:第一,各维度量纲差异巨大,大数值维度拉扯多边形,掩盖小数值维度的真实差异;第二,多个系列的大面积纯色填充导致底层数据被完全覆盖;第三,系列数量超过 4 个后,轴线与边框过度密集,读者无法快速锁定关键对象。
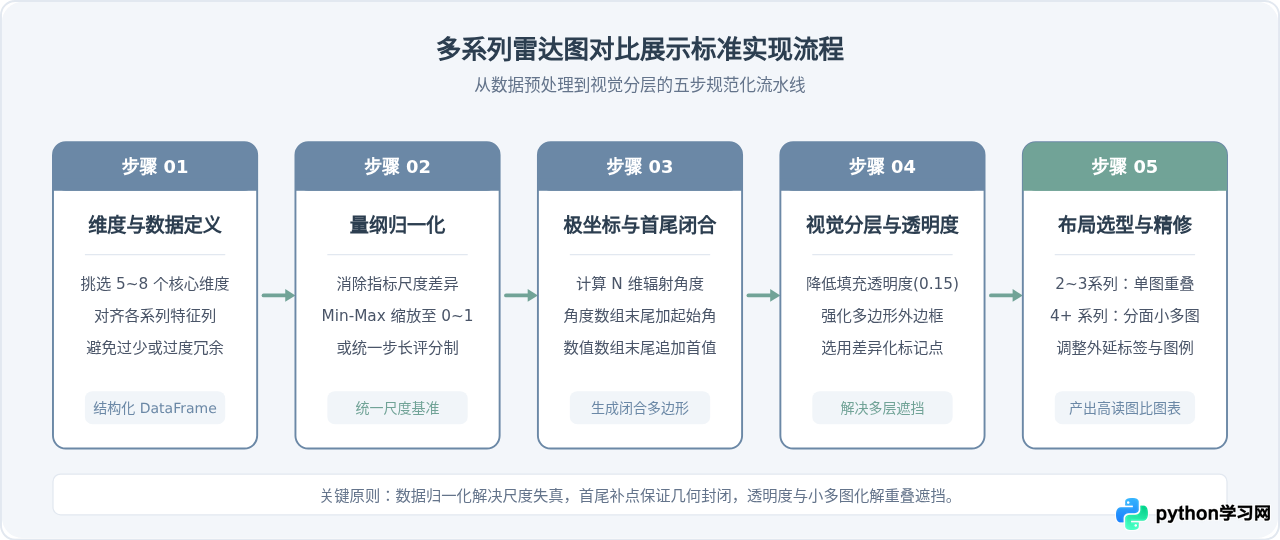
解决上述问题的标准实施路径分为五个步骤:明确比较维度与数据收集、特征尺度归一化、极坐标角度均匀划分与首尾闭合追加、视觉通道(描边与透明度)分层设计,以及根据系列总数选择单图层叠或分面小多图布局。
二、极坐标角度计算与数据首尾闭合机制
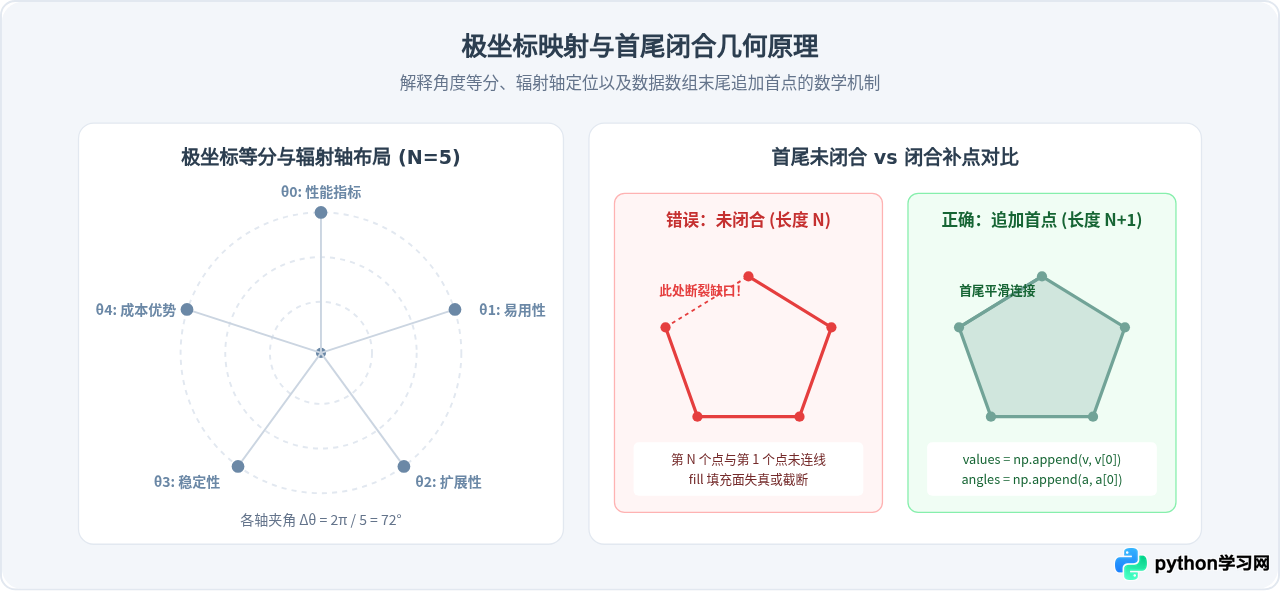
在 Python 的 Matplotlib 中,雷达图本质上是运行在极坐标系(polar=True)下的多边形。许多初学者常犯的一个错误是:直接将 $N$ 个维度的数值绘制出来,导致最后一个点与第一个点之间留有明显缺口,多边形无法闭合。
完整的闭合算法包含两个平行动作:
- 角度等分并追加起点:利用
np.linspace(0, 2 * np.pi, N, endpoint=False)将圆周等分为 $N$ 份,并在数组最后拼接一个初始角度angles = np.concatenate((angles, [angles[0]]))。 - 数据向量追加起点:针对每个系列的数据向量,同样在数组末尾追加第一个维度的值:
values = np.concatenate((values, [values[0]]))。
三、单图多系列(2~3个系列)层叠对比实战
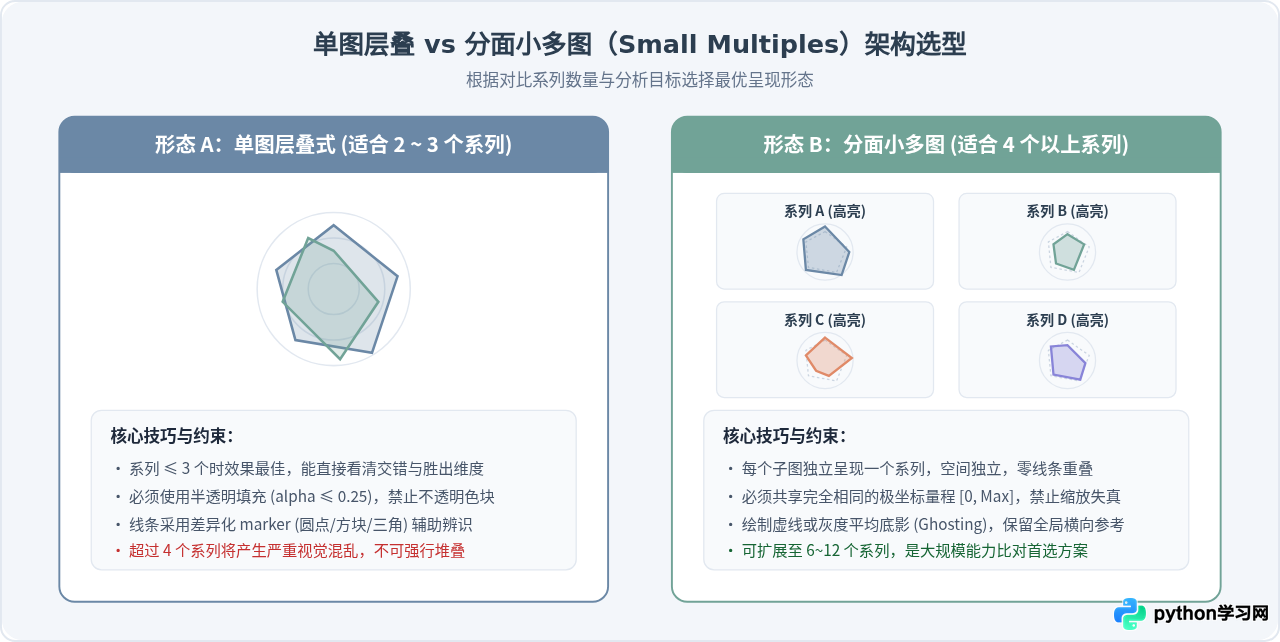
当待对比的系列数量在 2 到 3 个时,将它们放置在同一个雷达图内进行重叠对比是最高效的方式。此时的核心目标是避免上层多边形完全掩盖下层。实现该效果的技巧包括:
- 低透明度面填充(Alpha 0.15~0.25):填充区域仅用于辅助感知面积与重心,不要使用不透明的高饱和色块。
- 加粗轮廓描边(Line Width 2.0~2.5):人眼对闭合边界线条的分辨率远高于大面积重叠的半透明色。
- 差异化顶点标记(Marker):为不同系列分配圆形(
o)、方形(s)或三角形(^),使灰度打印或色弱读者也能准确分辨。 - 设置起始角度与方向:通过
ax.set_theta_offset(np.pi / 2)将首个指标置于正上方,符合通常的阅读直觉。
以下是使用 Matplotlib 绘制 3 个产品对比雷达图的完整代码:
import numpy as np
import matplotlib.pyplot as plt

# 1. 基础数据准备 (5个维度)
categories = ['性能响应', '系统易用性', '功能丰富度', '运行稳定性', '成本性价比']
series_data = {
    '产品 A': [88, 92, 75, 95, 60],
    '产品 B': [70, 85, 90, 78, 85],
    '产品 C': [95, 65, 82, 80, 92]
}

N = len(categories)
# 计算各维度角度 (并在最后追加首点)
angles = np.linspace(0, 2 * np.pi, N, endpoint=False).tolist()
angles += angles[:1]

# 设置中文字体与画布
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

fig, ax = plt.subplots(figsize=(7, 7), subplot_kw=dict(polar=True))

# 顺时针旋转,首个维度设在正上方
ax.set_theta_offset(np.pi / 2)
ax.set_theta_direction(-1)

# 设置刻度轴标签
plt.xticks(angles[:-1], categories, size=11, color='#2C3E50')

# 设置径向网格范围与刻度
ax.set_rlabel_position(0)
plt.yticks([20, 40, 60, 80, 100], ["20", "40", "60", "80", "100"], color="#64748B", size=9)
plt.ylim(0, 100)

# 定义调色盘 (主色、辅色与点缀色)
colors = ['#6B88A6', '#71A397', '#E08A68']
markers = ['o', 's', '^']

# 循环绘制各个系列
for (name, values), color, marker in zip(series_data.items(), colors, markers):
    val_closed = values + values[:1]
    # 绘制高辨识度外描边
    ax.plot(angles, val_closed, linewidth=2.2, linestyle='solid', label=name, color=color, marker=marker, markersize=5)
    # 半透明填充
    ax.fill(angles, val_closed, color=color, alpha=0.18)

# 添加图例并优化位置
plt.legend(loc='upper right', bbox_to_anchor=(1.25, 1.1), frameon=True, facecolor='#FFFFFF', edgecolor='#CBD5E1')
plt.title("三款核心产品综合多维能力对比", size=14, weight='bold', pad=25, color='#1E293B')
plt.tight_layout()
plt.show()
四、应对复杂多系列(4个以上)的分面小多图(Small Multiples)技巧
当对比系列达到 4 个或更多时(例如对比 6 个竞品或 8 位候选人能力),单图堆叠会产生不可逆的视觉混乱。此时最专业的展示方式是采用小多图(Small Multiples / Faceting)。
小多图的核心设计准则是:为每个系列分配一个独立的子雷达图,保持完全统一的坐标轴范围与维度顺序,并在每个子图背景中绘制一条浅灰色的“全员基准线”或“平均值轮廓”(Ghosting / Benchmark)。这样,读者既能聚焦单个系列的独特轮廓,又能随时与总体水平进行对比。
下面给出生成 4 系列分面小多图的完整 Python 实现。代码通过计算全系列平均值作为每个子图的背景基准轮廓,有效平衡了个体特征与整体分布:
import numpy as np
import matplotlib.pyplot as plt

# 1. 模拟 4 款模型在 6 个维度上的评测得分
categories = ['推理能力', '代码生成', '长文本理解', '事实问答', '响应速度', '指令遵循']
data = {
    '模型 Alpha': [92, 88, 76, 95, 65, 90],
    '模型 Beta':  [80, 94, 85, 78, 88, 82],
    '模型 Gamma': [75, 70, 95, 88, 92, 79],
    '模型 Delta': [85, 80, 80, 82, 80, 86]
}

N = len(categories)
angles = np.linspace(0, 2 * np.pi, N, endpoint=False).tolist()
angles += angles[:1]

# 2. 计算基准均值 (作为背景参考层)
all_values = np.array(list(data.values()))
mean_values = np.mean(all_values, axis=0).tolist()
mean_closed = mean_values + mean_values[:1]

# 3. 创建 2x2 子图网格
fig, axes = plt.subplots(2, 2, figsize=(10, 10), subplot_kw=dict(polar=True))
axes = axes.flatten()

colors = ['#6B88A6', '#71A397', '#D97706', '#6366F1']

for i, ((name, vals), color) in enumerate(zip(data.items(), colors)):
    ax = axes[i]
    ax.set_theta_offset(np.pi / 2)
    ax.set_theta_direction(-1)

    # 统一刻度范围
    ax.set_ylim(0, 100)
    ax.set_xticks(angles[:-1])
    ax.set_xticklabels(categories, fontsize=9, color='#334155')
    ax.set_yticks([25, 50, 75, 100])
    ax.set_yticklabels(["25", "50", "75", "100"], fontsize=7, color='#94A3B8')

    # 绘制背景均值参考虚线 (Ghost Line)
    ax.plot(angles, mean_closed, color='#94A3B8', linestyle='dashed', linewidth=1.2, label='行业基准均值')
    ax.fill(angles, mean_closed, color='#E2E8F0', alpha=0.3)

    # 绘制当前主体系列
    val_closed = vals + vals[:1]
    ax.plot(angles, val_closed, color=color, linewidth=2.2, label=name)
    ax.fill(angles, val_closed, color=color, alpha=0.25)

    ax.set_title(name, fontsize=12, fontweight='bold', pad=15, color='#1E293B')
    if i == 0:
        ax.legend(loc='lower left', bbox_to_anchor=(-0.25, -0.2), fontsize=8)

plt.suptitle("各模型多维能力评测小多图 (含基准均值对比)", fontsize=16, weight='bold', y=0.98, color='#0F172A')
plt.tight_layout()
plt.show()
五、指标量纲归一化与外延标签防遮挡技巧
在实际工程中,不同维度的量级往往不统一。例如某服务器评测指标中,“并发数”是数万级别,而“错误率”是百分比(0~1 之间),“响应时间”是毫秒(数十至数百)。如果直接使用原始数据绘图,较小量级的维度会在中心挤成一个点,彻底失去对比价值。
常见的解决方案是实施 Min-Max 归一化,将所有维度统一映射至 $[0, 1]$ 或 $[0, 100]$ 的相对区间:
import pandas as pd
from sklearn.preprocessing import MinMaxScaler

# 原始多维指标数据 (量纲差异极大)
df = pd.DataFrame({
    '并发连接数': [12000, 25000, 18000],
    'P99延迟(ms)': [150, 45, 80],       # 逆向指标:越小越好
    '吞吐量(QPS)': [8500, 16000, 11000],
    '内存占用(MB)': [4096, 8192, 6144],
    '可用性(%)':   [99.9, 99.99, 99.95]
}, index=['方案A', '方案B', '方案C'])

# 对逆向指标进行反向转换 (如延迟,转换后值越大代表性能越好)
df['P99延迟(ms)'] = df['P99延迟(ms)'].max() + df['P99延迟(ms)'].min() - df['P99延迟(ms)']

# 统一进行 0-100 归一化
scaler = MinMaxScaler(feature_range=(20, 100))
norm_df = pd.DataFrame(scaler.fit_transform(df), columns=df.columns, index=df.index)
ax.tick_params(pad=12) 增加径向标签的外延边距,或者在设置 ax.set_xticklabels(labels) 时根据坐标角度判断水平对齐方式(例如右半圆设为 ha='left',左半圆设为 ha='right'),可彻底消除文字与图表图元的交叉遮挡。
六、多系列雷达图展示技巧全景总结
为了在实际工作中快速决策与审查图表质量,下表和总结图系统归纳了不同场景下的多系列雷达图最佳实践规则。
| 对比维度与场景 | 常见误区与问题 | 推荐优化策略与参数配置 |
|---|---|---|
| 系列数量(2 ~ 3个) | 使用不透明实色填充,造成底层数据彻底被遮蔽 | 单图层叠显示,设定 alpha=0.15~0.25,加粗边框并使用不同顶点 marker |
| 系列数量(4个及以上) | 强行挤在单张图内,导致杂乱无章、无法阅读 | 采用小多图(Small Multiples),各子图锁定统一标尺,引入全量均值底影 |
| 指标量纲不同 | 大尺度指标覆盖微小尺度指标,数据被动失真 | 绘图前执行 Min-Max 标准化;针对耗时等逆向指标提前做取反或倒数平移 |
| 多边形封闭性 | 数据向量未闭合,产生缺角多边形 | 角度数组与数值数组末尾显式追加索引 0 的首元素 |
| 图例与标签排版 | 图例直接覆盖在极坐标内部,外围文字与边线重合 | 图例放置在 bbox_to_anchor=(1.2, 1.0) 外部,设置 pad > 10 外移文字 |
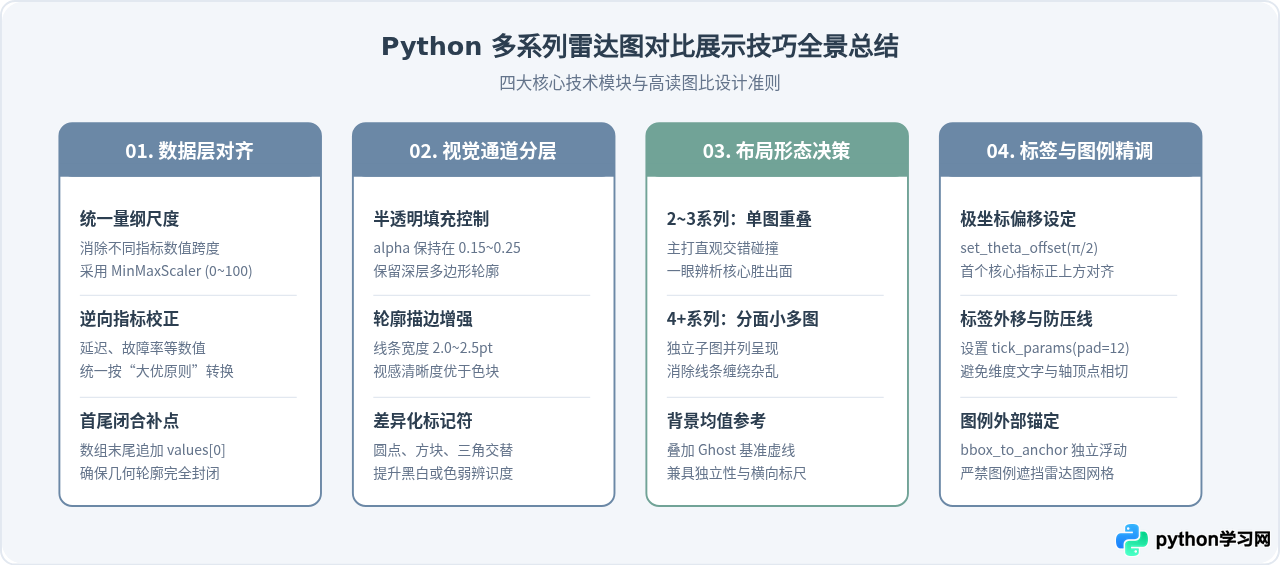
掌握以上技巧后,雷达图不仅能保持多维视角的直观性,更能彻底摆脱“多系列即混乱”的常见弊病。在数据呈现上,严谨的归一化与闭合补点保障了数理真实性;而在视觉传达上,半透明描边与分面小多图则赋予了图表极高的数据墨水比与专业质感。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















