


数据科学选型:Python与R语言在机器学习库生态上的核心差异
深入对比Python与R语言在机器学习库生态上的核心差异,涵盖架构设计、建模流水线API、统计推断、深度学习支持及生产部署考量,为数据科学技术选型提供明确依据。
在数据科学团队的技术选型中,Python与R语言的选择往往决定了后续开发效率、系统架构与维护成本。两者的核心差异并非“谁能实现某种算法”,而是底层设计哲学与工程定位的分水岭:Python以工程落地、统一对象抽象与端到端系统集成为核心导向,在工业级生产环境与深度学习中处于统治地位;R语言则深植于统计学严谨性与数据探索一体化,依靠严密的数据治理理念与元框架(Meta-framework),在因果推断、可解释性实验及科研分析中具有无法替代的表达力。
一、生态顶层设计与架构范式差异
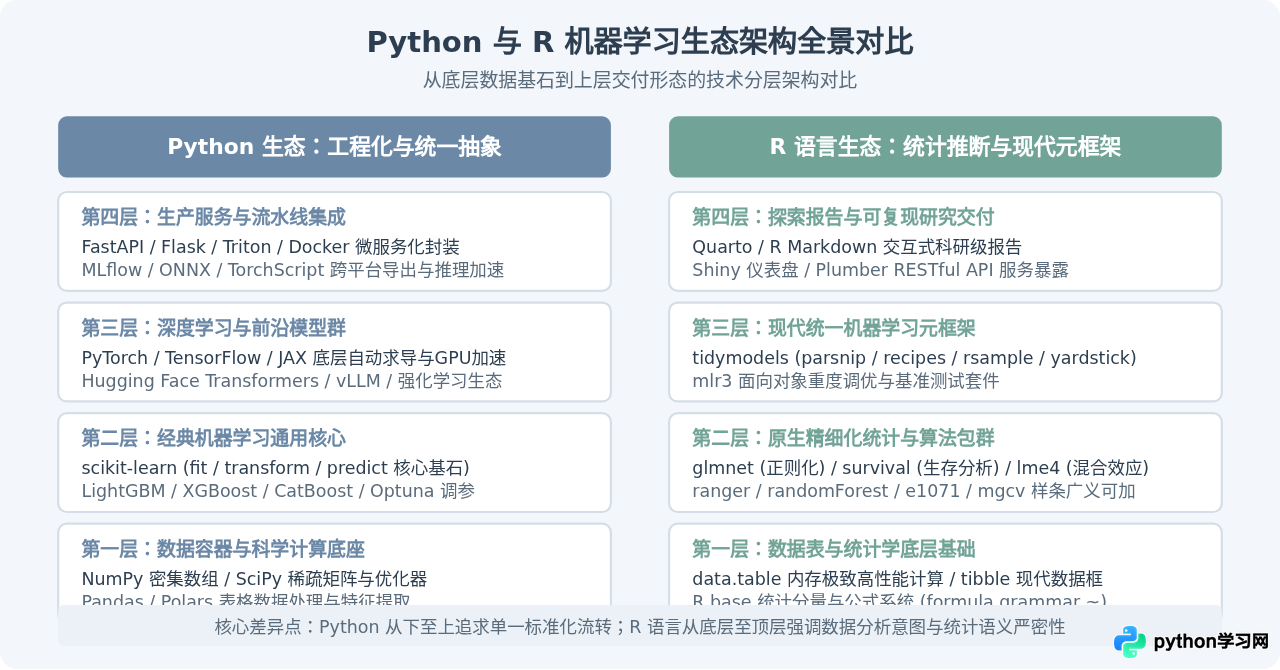
要理解两个语言的机器学习库,首先要看它们的组织范式。Python的经典机器学习生态高度收敛于 scikit-learn 所奠定的 Estimator / Transformer / Predictor 面向对象协议。无论是梯度提升树(LightGBM、XGBoost、CatBoost),还是各类特征工程工具,均遵循统一的 fit、transform 和 predict 接口。这种极简而严密的类继承与多态设计,为流水线管道化构建和自动化封装提供了极低的认知门槛。
相比之下,R语言的机器学习生态经历了一场深刻的演进。早期的R语言依赖CRAN中各自独立的专项统计包(例如专门做岭回归与Lasso的 glmnet、做随机森林的 randomForest、做支持向量机的 e1071)。虽然各包算法由顶尖统计学者开发且算法精度极高,但参数命名、输入数据格式(矩阵 vs 数据框)和预测输出类型长期缺乏一致性。现代R生态通过两套现代元框架解决了这一痛点:一是与 tidyverse 哲学完全融汇的 tidymodels,二是面向高级计算与高性能调参的 mlr3。它们采用函数式管道,将数据预处理规范(Recipe)、模型规约(Model Specification)与训练工作流(Workflow)彻底解耦。
二、标准建模操作流与API范式对比
为了直观感受两个生态在实际工程中的编码范式差异,我们以最常见的数据科学任务为例:对结构化表格数据进行缺失值填补、数值标准化、类别变量独热编码,随后构建分类模型并进行交叉验证评估。
1. Python 中的 scikit-learn 流水线操作
Python使用 ColumnTransformer 与 Pipeline 将预处理与模型捆绑为一个复合估计器,避免在交叉验证过程中发生数据泄露(Data Leakage):
# Python 3.10+ 环境,依赖:scikit-learn, pandas, numpy
import numpy as np
import pandas as pd
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import cross_val_score, train_test_split

# 1. 模拟数据加载
X = pd.DataFrame({
    'age': [25.0, 32.0, np.nan, 47.0, 51.0],
    'income': [50000.0, 72000.0, 61000.0, 89000.0, np.nan],
    'education': ['Bachelor', 'Master', 'Bachelor', 'Doctor', 'HighSchool']
})
y = np.array([0, 1, 0, 1, 0])

num_features = ['age', 'income']
cat_features = ['education']

# 2. 预处理步骤声明
num_transformer = Pipeline(steps=[
    ('imputer', SimpleImputer(strategy='median')),
    ('scaler', StandardScaler())
])

cat_transformer = Pipeline(steps=[
    ('imputer', SimpleImputer(strategy='most_frequent')),
    ('onehot', OneHotEncoder(handle_unknown='ignore'))
])

preprocessor = ColumnTransformer(transformers=[
    ('num', num_transformer, num_features),
    ('cat', cat_transformer, cat_features)
])

# 3. 完整模型流水线组合
model_pipeline = Pipeline(steps=[
    ('preprocessor', preprocessor),
    ('classifier', RandomForestClassifier(n_estimators=100, random_state=42))
])

# 4. 训练与严谨交叉验证(无数据泄露)
scores = cross_val_score(model_pipeline, X, y, cv=2, scoring='roc_auc')
print("CV AUC Scores:", scores)
2. R语言中的 tidymodels 流程实现
在R语言现代体系中,tidymodels 倡导将“预处理配方(recipes)”与“模型结构定义(parsnip)”解耦,通过 workflow 结合:
# R 4.2+ 环境,依赖:tidymodels, tidyverse
library(tidymodels)

# 1. 构造演示数据框
df <- tibble::tibble(
  age = c(25, 32, NA, 47, 51),
  income = c(50000, 72000, 61000, 89000, NA),
  education = factor(c('Bachelor', 'Master', 'Bachelor', 'Doctor', 'HighSchool')),
  target = factor(c('No', 'Yes', 'No', 'Yes', 'No'))
)

# 2. 声明数据预处理配方(Recipe 并不立即执行计算,仅声明逻辑规则)
rec_spec <- recipe(target ~ age + income + education, data = df) %>%
  step_impute_median(age, income) %>%
  step_impute_mode(education) %>%
  step_normalize(age, income) %>%
  step_dummy(education)

# 3. 声明模型规格(使用 parsnip 屏蔽底层具体包名与接口差异)
rf_spec <- rand_forest(trees = 100) %>%
  set_engine("ranger") %>%
  set_mode("classification")

# 4. 组装工作流并执行拟合
wf <- workflow() %>%
  add_recipe(rec_spec) %>%
  add_model(rf_spec)

fitted_wf <- fit(wf, data = df)
predictions <- predict(fitted_wf, new_data = df, type = "prob")
print(head(predictions))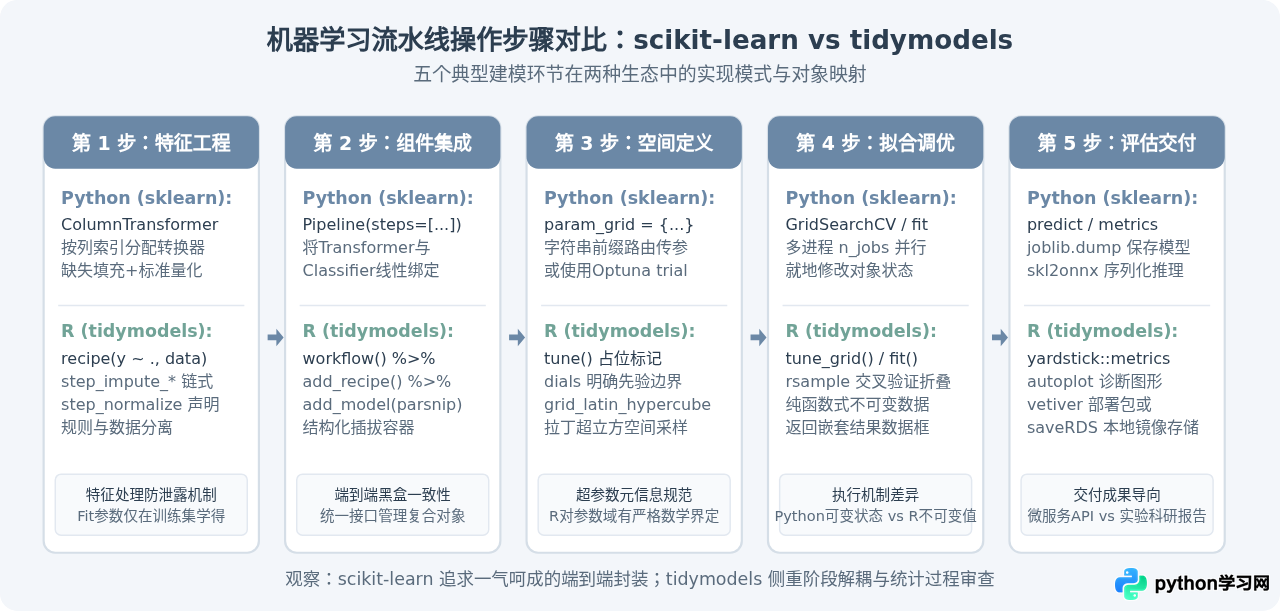
三、三类典型场景的能力边界与生态差距
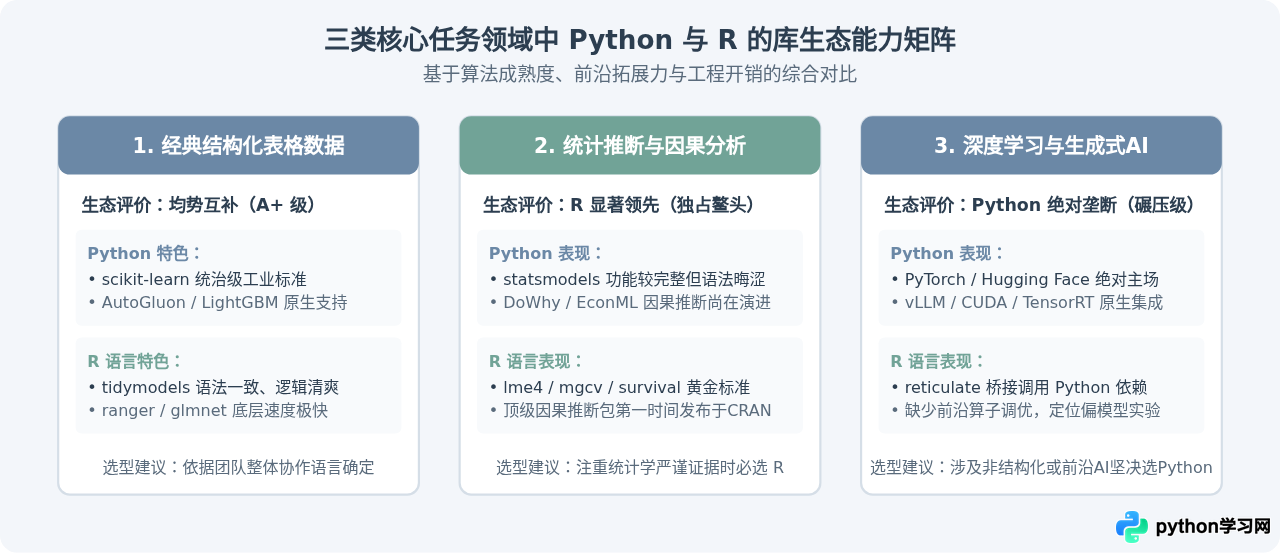
脱离具体任务空谈生态优劣是没有工程意义的。在数据科学实践中,Python与R的库生态在“传统表格数据”、“统计因果推断”与“深度学习/生成式AI”三个领域展现出了极不对称的能力分布。
1. 经典结构化表格数据(Tabular Data)
在这个领域,双方均处于高度成熟状态,平分秋色:
- 梯度提升与树模型:LightGBM、XGBoost、CatBoost 均对两门语言提供了官方原生C++绑定的API。Python通过统一的sklearn接口调用,R则不仅可以通过各自独立包调用,还能直接接入
tidymodels::parsnip或mlr3。 - 自动化机器学习(AutoML):Python拥有更为繁荣的工业级框架(如 AutoGluon、FLAML、TPOT);R语言则在学术界与精准基准测试中具有出色的
mlr3automl。
2. 统计严谨性、因果推断与生物/计量统计
如果业务的核心目标不仅是“预测”,而是“解释为什么”、“分析处理效应(Treatment Effects)”或“推断置信区间”,R语言的库生态占据绝对统治地位:
- 统计推断完整性:R的线性模型
lm、广义线性模型glm、混合效应模型lme4、广义可加模型mgcv输出完整的标准误、t值、p值及方差分析表。而scikit-learn的设计理念偏向纯工程预测,故意剥离了p值计算等假设检验指标;Python中需要依赖statsmodels才能获得类似报告,但其与主流ML工具链的交互相对割裂。 - 生存分析与专门领域:在医学与临床试验中的生存分析(Survival Analysis,如
survival包、Cox比例风险模型),R是业界金标准。Python的替代品如lifelines无论在边缘场景支持还是文献验证成熟度上都存在差距。
3. 深度学习与大语言模型(LLM)生态
在非结构化数据(图像、文本、音频)以及当今的大语言模型领域,Python形成了不可动摇的生态垄断:
- 第一公民地位:PyTorch、TensorFlow、JAX、Hugging Face Transformers 等核心库完全以 Python 作为第一开发语言与主要交互层。最新算子、GPU并行策略(Megatron-LM、DeepSpeed)及量化推理引擎(vLLM、TensorRT-LLM)均第一时间仅在 Python 生态提供。
- R语言的妥协机制:R语言主要依赖
reticulate桥接包在底层启动 Python 运行时,或者使用封装层torch for R与keras。虽然能够运行常见的分类与微调模型,但在遇到自定义CUDA算子、多节点分布式训练或最新大模型基础设施时,调试成本与生态滞后会成倍放大。
四、生产部署与工程落地的核心差异
算法模型只有进入生产系统才能产生业务价值。在这一阶段,Python与R的基础设施差距会迅速放大:
| 对比维度 | Python 机器学习生态 | R 语言机器学习生态 | 工程影响与考量 |
|---|---|---|---|
| 序列化标准 | joblib, pickle, ONNX, TorchScript |
saveRDS, qs, vetiver |
Python支持导出为ONNX格式,可直接在C++、Go或Java引擎中无Python环境低延迟运行。R模型通常强绑定R运行时。 |
| 微服务化与吞吐 | FastAPI, Tornado, Triton Inference Server | Plumber (单进程异步), RestRserve | Python拥有高度成熟的高并发ASGI生态及GPU推理服务器;R更适合构建内部分析API或批处理任务。 |
| 分布式与大数据集成 | PySpark, Ray, Dask, Horovod | sparklyr, future, parallel | Python是分布式算力(Ray/PySpark)的一等公民;R的 sparklyr 体验优秀,但在海量节点调度上周边组件有限。 |
| 交互式可视化报告 | Streamlit, Dash, Gradio, Jupyter | Shiny, Quarto, ggplot2, R Markdown | R在交互式报表与学术级数据出版物(Quarto/ggplot2)上的美观度与响应深度依然是业界天花板。 |
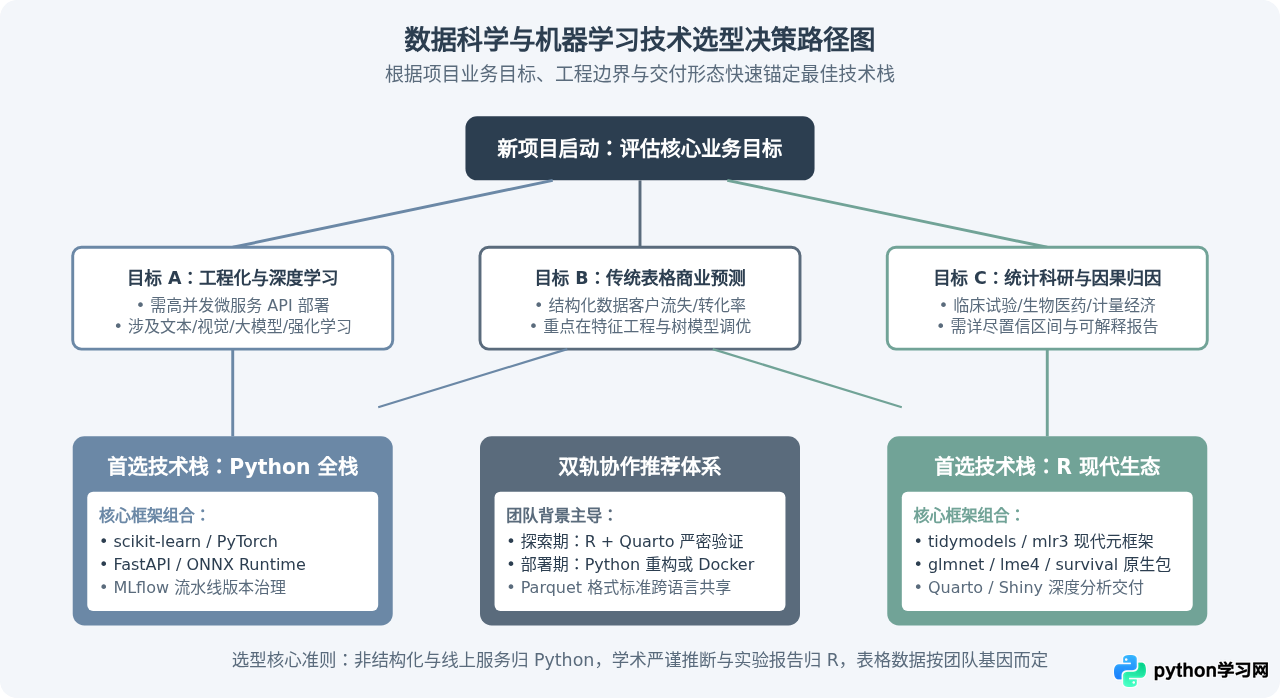
五、数据科学团队技术选型决策树
结合上述分析,数据科学团队在启动项目或规划基础设施时,可通过以下明确的逻辑分支进行精准选型:
总结与选型落地建议
通过对Python与R语言机器学习库生态的深入剖析,我们可以得出明确的选型结论:
- 追求系统工程闭环、高并发低延迟部署或前沿深度学习/大模型项目:毫不犹豫地选择 Python。其依托
scikit-learn的一致接口协议、PyTorch的算力支撑以及无缝衔接的微服务生态,能够将建模成果最高效地转化为工业级应用。 - 专注于科研探索、临床试验、计量经济、因果效应分析或需要交付高保真交互式报告:优先选择 R语言。借助
tidymodels的声明式配方、CRAN百年沉淀的专业统计包群以及Quarto/Shiny的出版级表现力,R能够提供极高密度的分析洞见。 - 成熟团队的协同进化:避免用单一语言解决所有问题。利用现代化列式存储(如 Apache Parquet/Arrow)打通数据流转,让研发团队在探索阶段充分发挥R的统计推断优势,在上线阶段依托Python的工程集成能力,是兼顾严谨性与生产力的最优解。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















