


Python列表怎么使用key参数自定义排序规则
深入讲解Python列表使用key参数自定义排序规则的具体方法与底层原理。涵盖内置函数、lambda表达式、operator模块、复合多键排序及性能注意事项。
list.sort() 方法或内置的 sorted() 函数传入 key 参数。key 接收一个单参数可调用对象(如内置函数、lambda 表达式或命名函数),它会在排序前为每个列表项仅计算一次“排序依据(Key)”,底层排序算法依据该键值进行对比并排定原列表项的次序,从而高效率地实现按长度、多字段、属性或复合维度的定制化排序。
一、key 参数的核心机制与底层原理
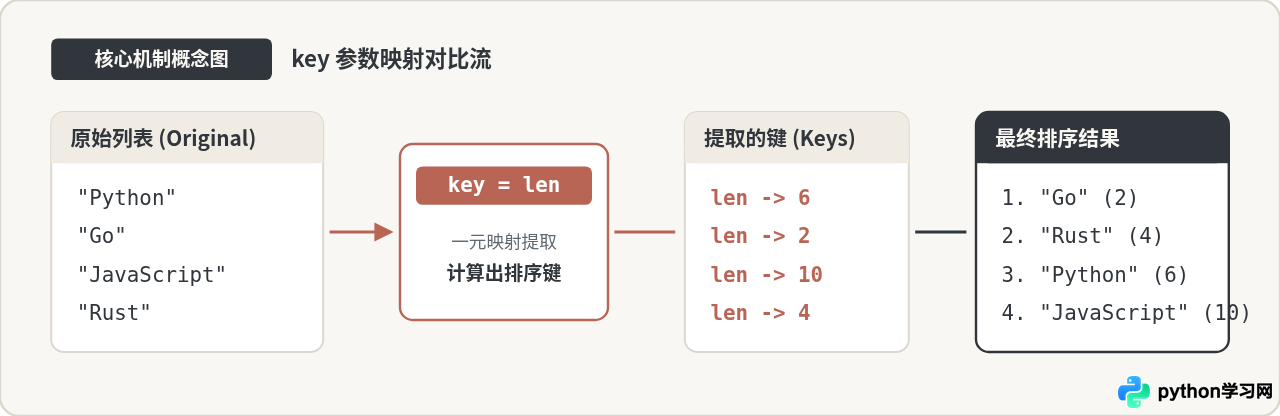
在 Python 排序体系中,key 参数采用的是计算机科学中经典的“装饰-排序-去装饰(Decorate-Sort-Undecorate,简称 DSU)”模式(在 Perl 领域亦被称为施瓦茨变换 Schwartzian Transform)。了解这一原理对于写出高性能、无隐患的排序代码至关重要。
许多从 Python 2 或其他编程语言(如 C++ 或 JavaScript)转过来的开发者,习惯于编写接受两个参数并返回相对大小(-1, 0, 1)的比较函数(即旧版的 cmp 函数)。然而,双参数比较方式存在不可忽视的性能缺陷:一个长度为 \(N\) 的列表在快速排序或归并排序过程中,平均需要进行 \(O(N \log N)\) 次元素比较。这意味着同一个元素的字段提取与解析计算会被高频重复执行几十甚至上百次。
Python 3 彻底移除了 cmp 参数,全面转向纯粹的 key 机制。在 key 机制下:
- 单次计算保证:排序开始时,Python 对列表中的每个元素只调用一次
key函数(调用总次数严格为 \(N\) 次),并将生成的键缓存为临时结构; - C 语言层原生比对:获取到所有元素的 key 之后,底层的 Timsort 算法完全在 C 语言层面直接对这些轻量键进行高效比对;
- 还原原列表元素:当所有键排好顺序后,Python 将各键对应的原始列表项一次性排布到位,并释放临时键缓存。
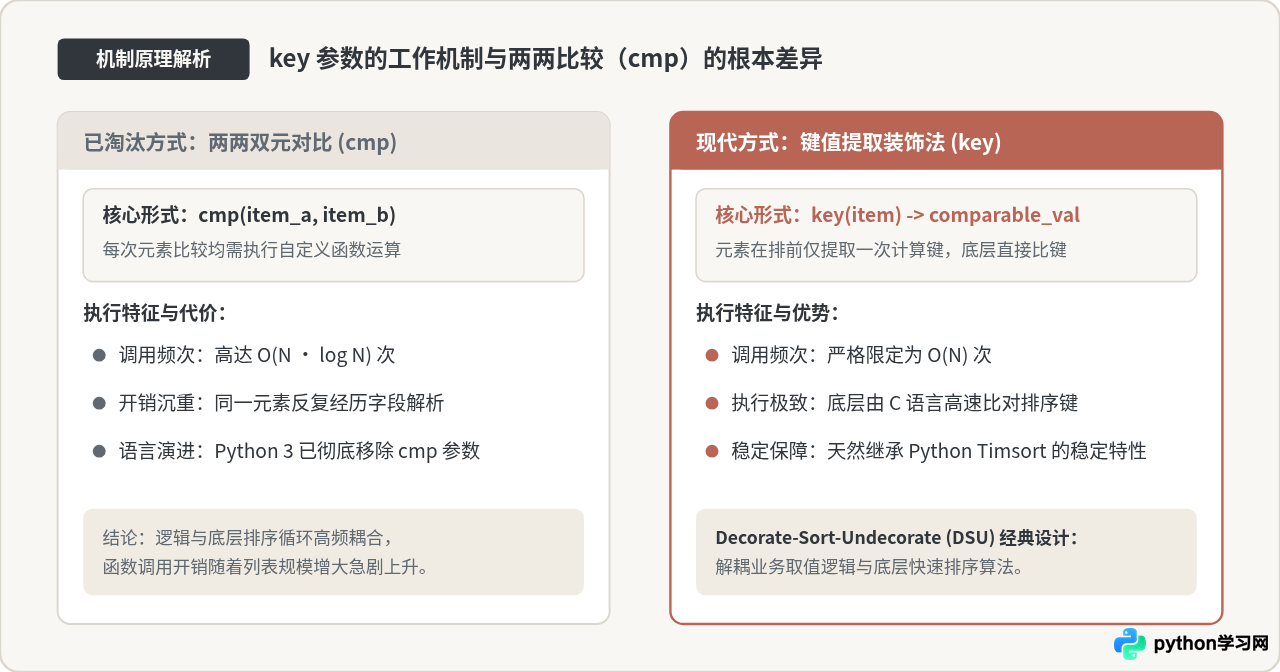
此外,Python 提供了两个排序入口,它们的 key 参数用法完全一致,但对原数据的操作形式不同:
my_list.sort(key=...):列表的原生方法,直接在原始列表上进行原地修改,执行后返回值为None;sorted(my_list, key=...):Python 全局内置函数,接受任意可迭代对象,并始终分配新的内存空间构建并返回一个全新的排好序的列表。
二、使用 key 参数自定义排序的四步实施流程
掌握 key 参数的实际编写,可以归纳为标准化的四步落地流程:
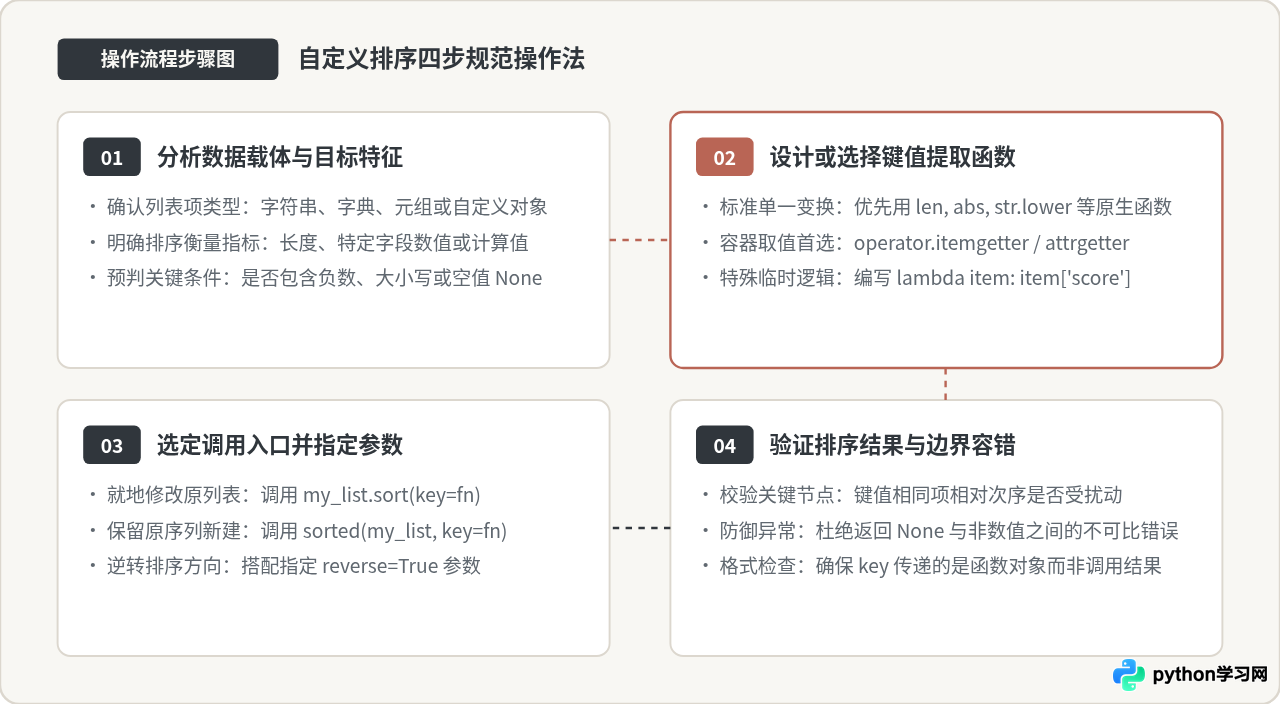
步骤 1:明确列表结构与待排序目标
首先确认待排列表中元素的具体类型。如果是标量类型(如字符串、整数),排序目标往往是元素本身的转换值(如字符长度、绝对值、拼音);如果是复杂容器(如字典、元组、自定义类实例),排序目标则是元素内部的一个或多个特定字段。
步骤 2:选取或编写单参数键值函数
根据业务需求选择最简洁、高效的函数形态。若已有符合一元签名的内置函数,直接传函数名(如 len、abs);若需要访问局部字段,可使用 lambda 或 operator 模块;若包含多级逻辑分支,则独立编写一个 def 函数。
步骤 3:调用排序接口执行排定
将步骤 2 的函数作为关键字参数传递给 key=。注意此处传递的是函数对象本身,切勿在传参时添加括号执行(例如传递 key=len 而非 key=len())。若需要由大到小逆向排列,增加 reverse=True 参数。
步骤 4:校验结果与稳定性保障
检查排序输出是否符合预期。需要特别强调的是,Python 的 Timsort 算法是稳定排序(Stable Sort)。如果两个列表项经过 key 函数运算后得到的键相等,它们在最终结果中的先后相对次序将与在输入列表中的初始相对次序保持完全一致。
以下是一个基础而完整的可运行示例,演示按字符串长度进行排序:
# 完整可执行代码:按字符串长度自定义升序与降序排序
words = ["elephant", "ox", "tiger", "cat", "hippopotamus"]

# 方式一:使用 sorted() 返回新列表(按长度升序)
sorted_by_len = sorted(words, key=len)

# 方式二:使用 list.sort() 原地修改(按长度降序)
words_copy = words.copy()
words_copy.sort(key=len, reverse=True)

print("原始列表:", words)
print("按长度升序:", sorted_by_len)
print("按长度降序:", words_copy)三、常见场景与键函数最佳实践
在实际业务开发中,待排序列表往往包含各种嵌套数据结构。针对不同结构,合理选择键函数可以显著提升代码的运行效率与可读性。
1. 基础单值变换:直接使用内置函数
当目标排序依据可以直接由 Python 内置函数处理时,最推荐的写法就是直接传递函数名。由于 Python 内置函数大部分由 C 语言底层实现,运行速度远快于在 Python 层动态构造的匿名函数:
# 场景:不区分英文字符大小写进行字典序排序
languages = ["python", "Java", "c", "C++", "golang", "Rust"]

# 使用 str.lower 作为 key 函数,避免 'Java' 等大写字母因为 ASCII 码偏小而提前
sorted_langs = sorted(languages, key=str.lower)

print("大小写忽略排序结果:", sorted_langs)2. 嵌套字典与对象属性:lambda 表达式
当列表元素为字典或类对象时,lambda 表达式是最直观的选择。它允许我们在单行内提取对象的任意字段或运算结果:
# 场景:学生成绩字典列表,按成绩从高到低排序
students = [
    {"name": "张三", "score": 82, "class": "A"},
    {"name": "李四", "score": 95, "class": "B"},
    {"name": "王五", "score": 88, "class": "A"},
    {"name": "赵六", "score": 95, "class": "A"}
]

# 按成绩降序排列
students.sort(key=lambda item: item["score"], reverse=True)
print("按成绩降序:", students)注意在上述输出中,李四和赵六的分数同为 95 分。在原始列表中李四排在赵六之前,排序后李四依然排在赵六之前,这正是 Timsort 稳定性的体现。
3. 极速提取:operator 模块的 itemgetter 与 attrgetter
对于大规模数据集(如数万甚至数十万条记录),频繁执行 lambda 会产生解释器层面的函数帧调用开销。Python 提供了标准库 operator,其中的 itemgetter 和 attrgetter 由 C 底层专门优化,性能通常比 lambda 快 15% 到 30%:
from operator import itemgetter, attrgetter

# 字典列表按单个键排序
records = [{"id": 103, "val": 30}, {"id": 101, "val": 10}, {"id": 102, "val": 20}]
records.sort(key=itemgetter("id"))
print("itemgetter 排序结果:", records)

# 类对象列表按属性排序
class Employee:
    def __init__(self, name, level):
        self.name = name
        self.level = level
    def __repr__(self):
        return f"{self.name}(Lv{self.level})"

staff = [Employee("Alice", 3), Employee("Bob", 1), Employee("Charlie", 2)]
staff.sort(key=attrgetter("level"))
print("attrgetter 排序结果:", staff)4. 复合维度与多条件排序(元组返回机制)
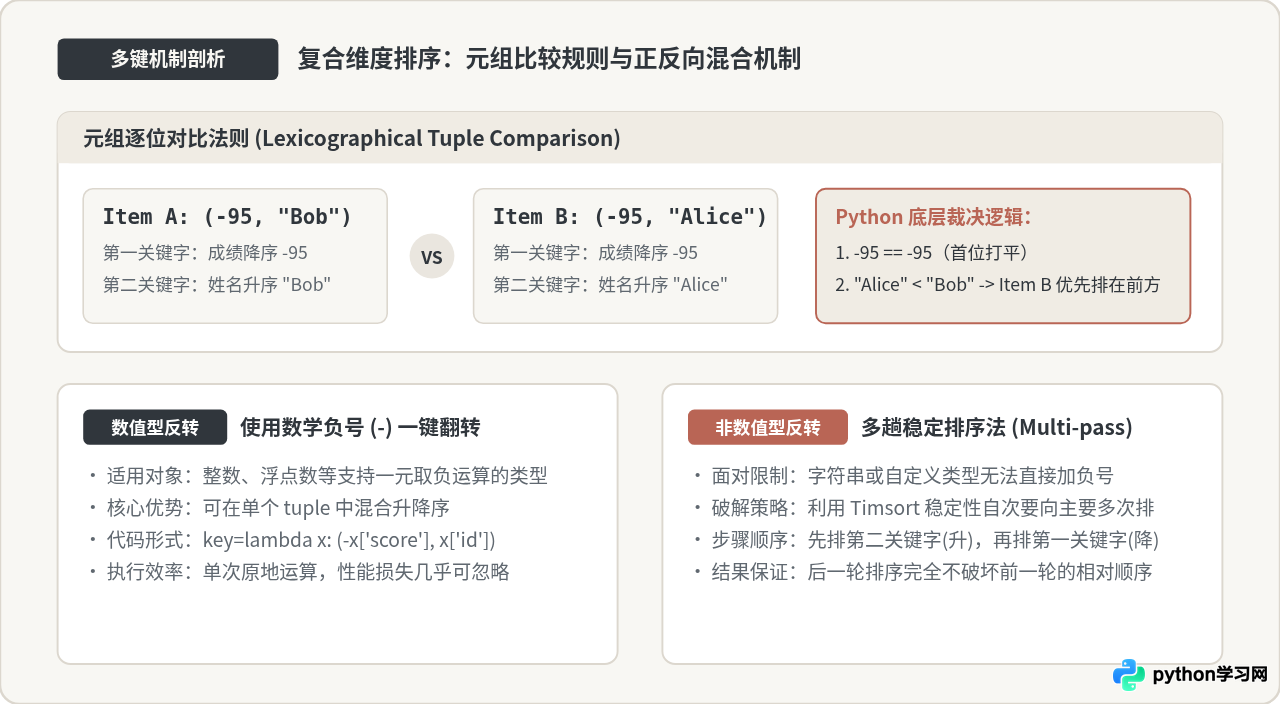
在许多实际场景中,单一规则无法满足排序需求。例如:“先按成绩降序排列,如果成绩相同,再按年龄升序排列”。
在 Python 中,元组(Tuple)之间的比对是按顺序逐位进行的(词典序):首先比较第 0 位元素;若第 0 位元素相等,则比较第 1 位元素,依此类推。利用这一机制,只要让 key 函数返回一个元组,即可天然实现多维度级联排序。
# 场景:成绩降序,同分时年龄升序
candidates = [
    {"name": "小明", "score": 90, "age": 22},
    {"name": "小红", "score": 95, "age": 21},
    {"name": "小华", "score": 90, "age": 19},
    {"name": "小强", "score": 85, "age": 20}
]

# 技巧:对数值型主关键字取负号 -x['score'],实现局部降序,次要关键字保持升序
candidates.sort(key=lambda x: (-x["score"], x["age"]))
print("成绩降序且年龄升序:", candidates)四、关键注意事项与常见陷阱排查
在处理多条件混合排序时,许多开发者习惯对所有字段添加负号 -。但若次要字段是字符串(例如 -x['name']),Python 会立即抛出 TypeError: bad operand type for unary -: 'str'。
应对方案:若必须实现“成绩降序且姓名降序”,可将 reverse=True 配合正向元组使用;若必须实现“成绩降序但姓名升序”,且姓名是不可取负的字符串,则应利用 Python 的稳定排序特性进行“多趟排序”:先按次要键(姓名升序)排一次,再按主要键(成绩降序)排一次。
# 演示多趟稳定排序:成绩降序,姓名按字母升序
data = [
    {"name": "Bob", "score": 90},
    {"name": "Alice", "score": 90},
    {"name": "Charlie", "score": 95}
]

# 第一步:先按次要关键字(姓名字母升序)排序
data.sort(key=lambda x: x["name"])
# 第二步:再按主要关键字(成绩降序)排序(由于稳定性,同分下的姓名先后次序完整保留)
data.sort(key=lambda x: x["score"], reverse=True)

print("多趟稳定排序结果:", data)
在 Python 3 中,不同类型之间默认不支持比较(例如 None < 5 会抛出 TypeError: '<' not supported between instances of 'NoneType' and 'int')。如果列表中存在空值或缺失字段,直接提取会导致排序崩溃。
应对方案:在 key 函数中显式处理 None,将其置为正无穷(float('inf'))或负无穷,将其固定排在列表最后或最前。
# 演示处理带 None 的混合列表,将 None 置于末尾
mixed_vals = [10, None, 5, 20, None, 1]

# 利用元组比较:(是否为None, 具体值),False(0) 优先于 True(1)
sorted_mixed = sorted(mixed_vals, key=lambda x: (x is None, x if x is not None else 0))
print("处理 None 后的结果:", sorted_mixed)五、选型指南与全景总结
为了帮助读者在日常编写代码时快速做出恰当的选择,下图总结了使用 key 参数时针对不同业务场景的选型决策矩阵:
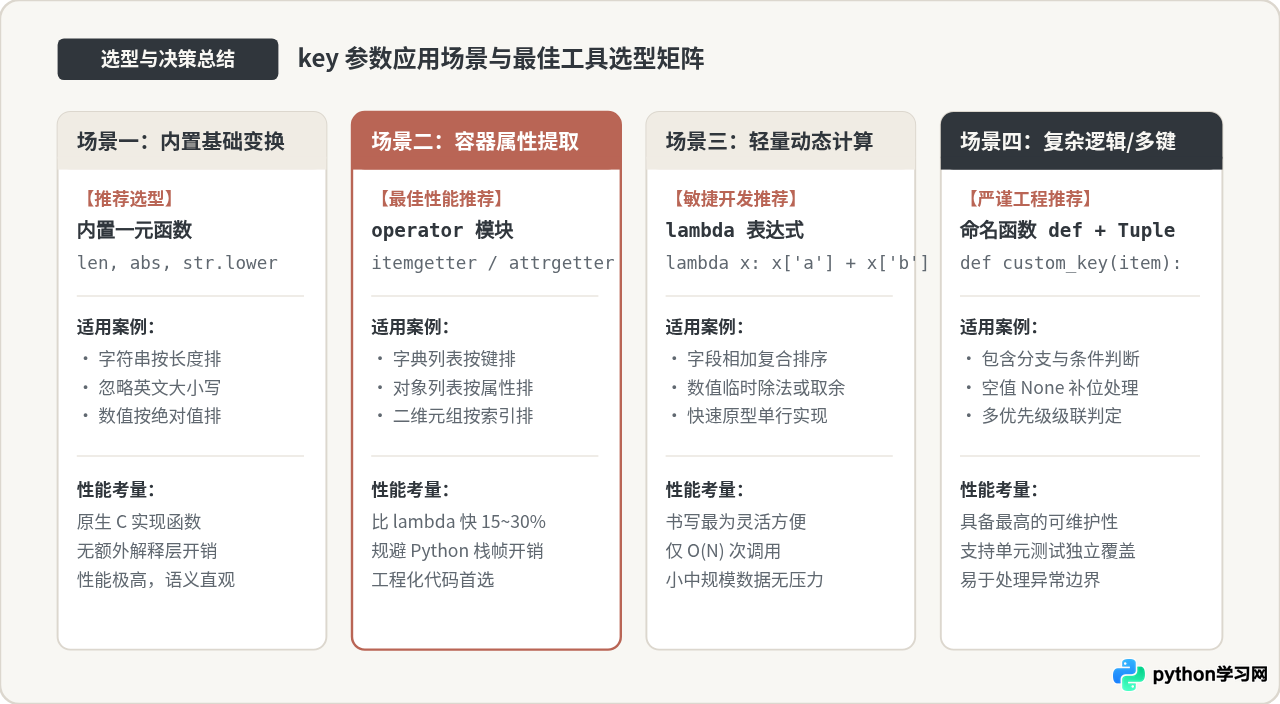
| 业务应用场景 | 推荐函数形式 | 典型代码写法 | 性能与工程特点 |
|---|---|---|---|
| 基础标量属性转换 | 原生内置函数 | key=len, key=str.lower |
底层 C 实现,无解释器调用栈开销,性能最高 |
| 字典/对象固定键提取 | operator 模块 |
key=itemgetter('id') |
比等效 lambda 快 15~30%,易于静态分析 |
| 临时单行计算或加权 | lambda 表达式 |
key=lambda x: x['a'] + x['b'] |
编写灵活便捷,适合小中规模数据与探索式编程 |
| 多级复合排序(含混合升降) | 元组返回 + 取负 / 多趟排序 | key=lambda x: (-x.score, x.id) |
充分发挥 Python 元组比较与 Timsort 稳定排序优势 |
| 含分支判断与空值保护 | 独立命名函数 (def) |
key=custom_key_func |
便于单元测试覆盖、异常排查与团队多人维护 |
通过合理运用 key 参数,开发者不仅能够写出语义清晰、表现稳定的定制排序代码,还能依托 Python 的单次提取机制与 Timsort 算法,获得极致的运行效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















