


Python怎么使用key参数实现自定义排序规则
全面介绍Python中利用key参数实现自定义排序规则的方法与底层原理。涵盖单条件转换、多条件元组排序、降序与升序混排技巧、operator模块性能调优及避坑要点。
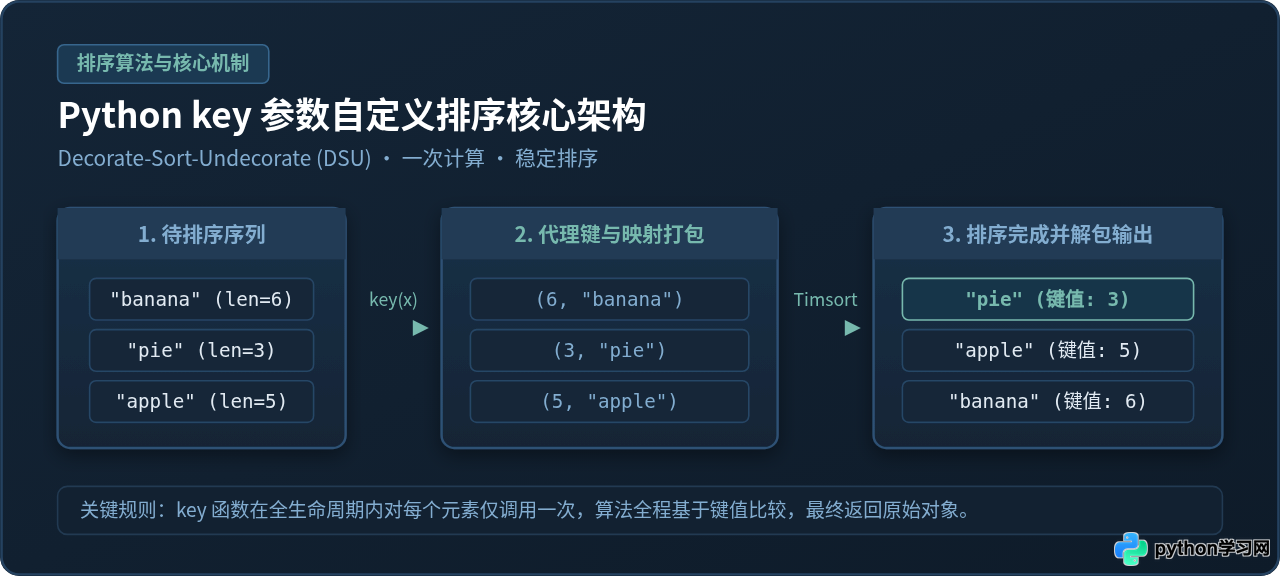
在日常数据处理中,我们经常遇到非标数据的排序需求。例如,需要按照字符串的长短而非字母字典序排列文本列表,需要按照学生的期末总分而不是学号高低排列成绩单,或者需要先按部门升序、再按入职薪资降序排列员工档案。在这些场景下,Python 默认的元素比较运算(<)往往无法满足业务逻辑。Python 的内置函数 sorted() 和列表的原地方法 list.sort() 均提供了一个核心配置项:key 参数。只要为 key 传入一个单参数的可调用对象,就能让排序算法按照该函数返回的值进行比较排布。
一、key 参数的核心工作机制
理解 key 参数的关键,在于搞清它究竟在排序算法的哪个阶段起作用。在 Python 中,排序底层采用的是经过高度优化的 Timsort 算法。当开发者为排序传入 key 参数时,Python 并不会在每两次元素对比时重复调用该函数,而是采用了业内著名的 DSU 模式(Decorate-Sort-Undecorate,即打标签-排序-去标签)。
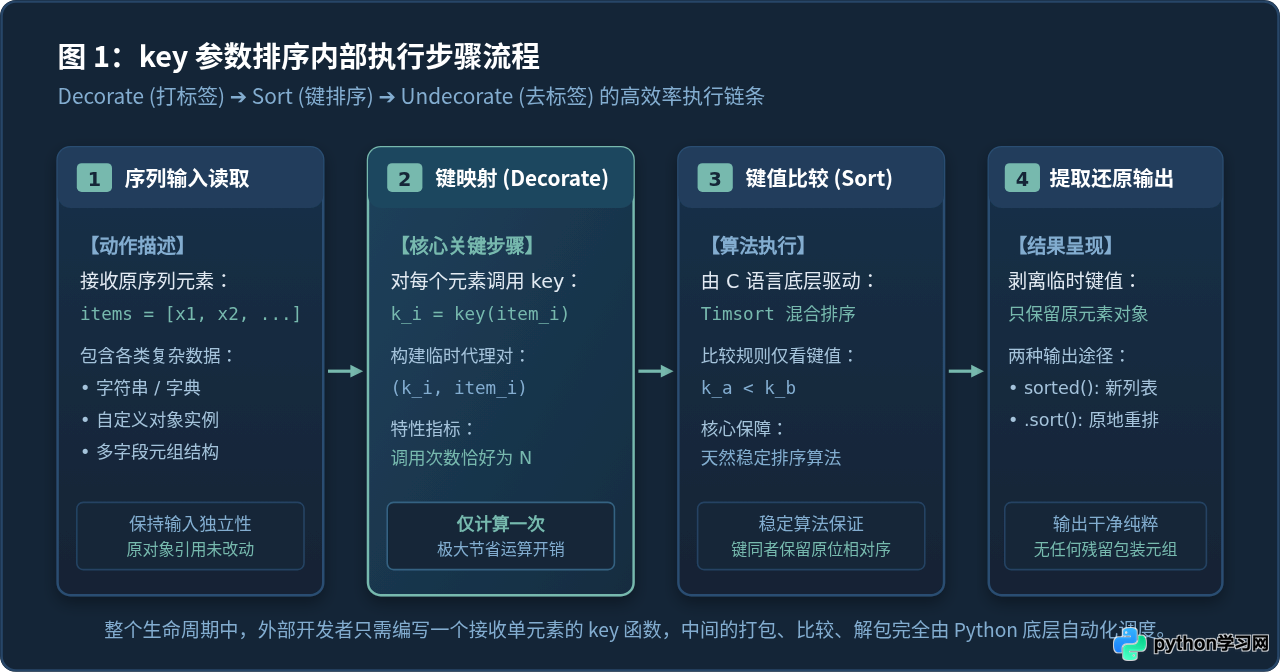
具体而言,key 参数的执行生命周期包含以下四个步骤:
- 输入读取:获取待排序的原始序列,此时原序列对象未发生任何形态修改。
- 键提取与打包(Decorate):Python 依次遍历每一个输入元素
item,仅执行一次key(item),将计算得到的辅助键值与原始元素组成内部代理结构。因为每个元素只被调用一次,即使key函数运算稍显复杂,其函数调用开销也严格被控制在O(N)次。 - 纯键值比较(Sort):底层 Timsort 算法在两两比较时,完全基于提取出来的代理键值进行比对。同时,Timsort 具备稳定排序(Stable Sort)特性:当两个元素的代理键相同时,它们在输出结果中会严格保留原有相对先后次序。
- 还原输出(Undecorate):排序完成后,Python 自动丢弃辅助代理键,将排好序的原元素解包输出。
sorted()会返回一个崭新的排好序的列表,而list.sort()则在原列表内存空间上完成修改。
二、单条件自定义排序的基础实践
单条件排序是日常开发中最频繁的场景。根据处理逻辑的复杂度,既可以使用 Python 现成的内置函数,也可以使用 lambda 匿名表达式构建即席逻辑。
1. 使用内置函数作为 key
如果转换规则本身就是一个已有的单参数函数或方法,可以直接将函数名作为 key 传入,而无需外层包裹任何额外的函数调用。
# 场景一:按字符串长度排序
words = ["python", "c", "javascript", "go", "rust"]
by_length = sorted(words, key=len)
print("按长度升序:", by_length)

# 场景二:忽略英文字母大小写进行字典序排序
mixed_cases = ["banana", "Apple", "cherry", "avocado"]
by_case_insensitive = sorted(mixed_cases, key=str.lower)
print("忽略大小写:", by_case_insensitive)

# 场景三:按数值与原点的绝对距离排序
numbers = [-18, 5, -2, 12, -7]
by_abs = sorted(numbers, key=abs)
print("按绝对值升序:", by_abs)按长度升序: ['c', 'go', 'rust', 'python', 'javascript']
忽略大小写: ['Apple', 'avocado', 'banana', 'cherry']
按绝对值升序: [-2, 5, -7, 12, -18]
2. 使用 lambda 表达式提取指定字段
当待排序数据为字典、复合元组或深层结构时,内置函数通常无法直接提取内部属性,此时使用简洁的 lambda 表达式是最直观的选择。
# 字典列表按指定数值字段排序
students = [
    {"name": "张三", "score": 88},
    {"name": "李四", "score": 95},
    {"name": "王五", "score": 72},
]

# 提取学生字典中的 score 字段作为排序代理键
sorted_students = sorted(students, key=lambda s: s["score"])
print("按成绩升序:", sorted_students)按成绩升序: [{'name': '王五', 'score': 72}, {'name': '张三', 'score': 88}, {'name': '李四', 'score': 95}]
三、多条件与复合排序规则的实现
很多实际业务需要满足层级优先级。例如:先按年级升序排列;年级相同的按总分降序排列;若总分依然相同,则按姓名首字母升序排列。在 Python 中,实现这种多维度组合排序的基石是元组(Tuple)的比对行为。
1. 元组级联比较机制
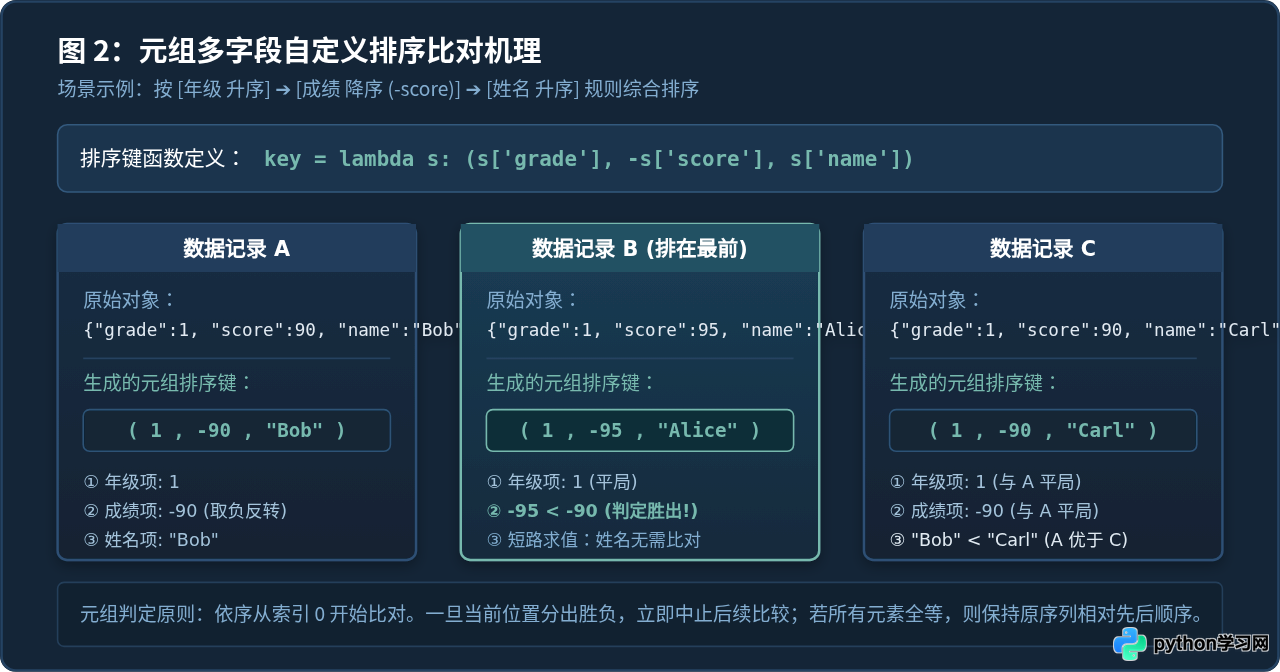
Python 在比较两个元组 (a1, a2, ...) 与 (b1, b2, ...) 时,会从左到右依次比对各个分量。如果 a1 != b1,比较结果直接由 a1 和 b1 决定,并立即触发短路求值,完全不再计算后续分量;只有当 a1 == b1 时,才会继续往后比对第二项 a2 与 b2。因此,只需让 key 函数返回一个元组,即可自然确立主从多级排序。
2. 升降序混排技巧:数值取负法
如果希望其中某一个数值字段逆向排序,而其他字段保持正向排序,只需在 key 元组中对该数值字段添加负号 -:
students_records = [
    {"grade": 1, "score": 90, "name": "Bob"},
    {"grade": 1, "score": 95, "name": "Alice"},
    {"grade": 2, "score": 85, "name": "David"},
    {"grade": 1, "score": 90, "name": "Carl"},
]

# 规则:年级升序(grade) ➔ 分数降序(-score) ➔ 姓名升序(name)
multi_sorted = sorted(
    students_records,
    key=lambda s: (s["grade"], -s["score"], s["name"])
)

for item in multi_sorted:
print(item){'grade': 1, 'score': 95, 'name': 'Alice'}
{'grade': 1, 'score': 90, 'name': 'Bob'}
{'grade': 1, 'score': 90, 'name': 'Carl'}
{'grade': 2, 'score': 85, 'name': 'David'}
避坑提醒:数学负号 - 仅对数字类型(整数、浮点数)有效。如果非数值字段(如字符串)需要降序,而其他字段需要升序,无法通过加负号解决。此时可以借助 Python 稳定排序的特性,从次要关键字向主要关键字依次进行多次排序,例如先按字符串字段执行一次 reverse=True 排序,再按主字段执行一次正常排序。
四、高性能与复杂对象排序:operator 模块应用
虽然 lambda 表达式非常灵活,但在海量数据(例如数十万行数据记录)排序时,每行记录解析执行 Python 层面的字节码会带来不可忽略的开销。Python 提供了标准库 operator 模块,其中的 itemgetter 和 attrgetter 直接由 C 语言底层实现,能够大幅度提升数据读取与打包的吞吐性能。
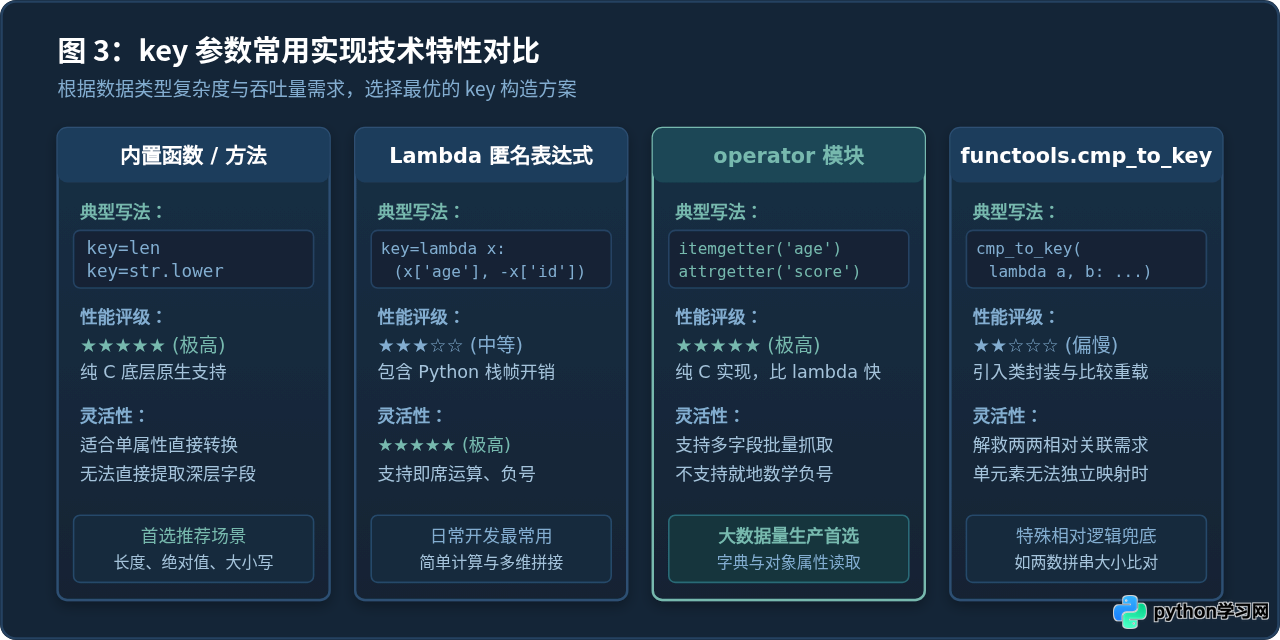
| 实现方案 | 典型代码形式 | 性能表现 | 适用数据形态 |
|---|---|---|---|
| 内置函数 | key=len, key=str.lower |
最高(纯原生调用) | 标量与基础类型转换 |
| operator 模块 | itemgetter("k"), attrgetter("a") |
极高(C 扩展无帧开销) | 字典键提取、类对象属性提取 |
| Lambda 表达式 | lambda x: (x.a, -x.b) |
良好(含 Python 解释开销) | 需即席计算、拼接或负号运算 |
| cmp_to_key | cmp_to_key(compare_func) |
偏慢(需构造包装代理类) | 双元素强相关比较逻辑 |
1. 针对字典或序列:itemgetter
from operator import itemgetter

inventory = [
    {"dept": "IT", "price": 4500, "sku": "A101"},
    {"dept": "HR", "price": 3200, "sku": "B205"},
    {"dept": "IT", "price": 1200, "sku": "A002"},
]

# itemgetter 支持同时传入多个字段,底层自动组装成元组
inventory.sort(key=itemgetter("dept", "price"))
print(inventory)
2. 针对自定义类实例:attrgetter
from operator import attrgetter

class Employee:
    def __init__(self, name, level, salary):
        self.name = name
        self.level = level
        self.salary = salary

    def __repr__(self):
        return f"Employee({self.name}, L{self.level}, ¥{self.salary})"

staff = [
    Employee("赵六", 3, 15000),
    Employee("孙七", 5, 28000),
    Employee("周八", 3, 18000),
]

# 先按级别升序,再按薪资升序
staff.sort(key=attrgetter("level", "salary"))
print(staff)[Employee(赵六, L3, ¥15000), Employee(周八, L3, ¥18000), Employee(孙七, L5, ¥28000)]
五、特殊场景:利用 cmp_to_key 解决相对关联排序
在 Python 2 时代,排序曾支持 cmp(a, b) 参数,允许开发者接收两个元素并返回 -1、0 或 1。而在 Python 3 中,为了统一步骤与提升性能,cmp 参数被彻底废除。但在某些特殊算法场景下,两个元素的排序优先度必须依赖它们两两组合才能判断,无法独立映射为一个固有键值。例如 LeetCode 经典题“拼接最大数”:给定一组数字,怎么拼接能得到最大的数?
此时,可以通过 functools.cmp_to_key 将传统的比较函数平滑转换为符合 key 约定的可调用对象:
from functools import cmp_to_key

nums = ["3", "30", "34", "5", "9"]

def custom_compare(x, y):
    # 比较 x+y 与 y+x 的字典序
    # 若 y+x 更大,说明 y 应该排在 x 前面,返回正数
    if x + y < y + x:
        return 1
    elif x + y > y + x:
        return -1
    else:
        return 0

# 使用 cmp_to_key 转换为 key 参数需要的包装器
sorted_nums = sorted(nums, key=cmp_to_key(custom_compare))
largest_number = "".join(sorted_nums)
print("拼接出的最大数字为:", largest_number)拼接出的最大数字为: 9534330
六、排查避坑指南与选型决策
在实际工程中使用 key 参数时,还需要格外留意以下三个关键边界与约束:
- 比较类型的同质性保证:Python 3 不允许对不兼容类型进行直接比较(例如
5 < "10"会抛出TypeError: '<' not supported between instances of 'int' and 'str')。因此,key函数返回的结果必须是彼此支持比较的同质类型。如果数据中混杂了None,需要在key中提供默认回退(如key=lambda x: x['age'] or 0)。 - 杜绝在 key 中引入高耗时副操作:虽然
key对每个元素仅调用一次,但如果元素量多达数十万,且key内部包含正则表达式编译、文件读取或网络调用,依然会拖慢整个应用。应尽量将静态资源提前编译。 - 精准区分
sorted()与list.sort():如果需要保留原始列表不变,或者处理的是非列表类型(如生成器、集合、元组、字典的键),必须使用sorted();如果数据量极大且原始列表无需保留,优先使用list.sort()原地排序,可节约整整一倍的列表对象内存。
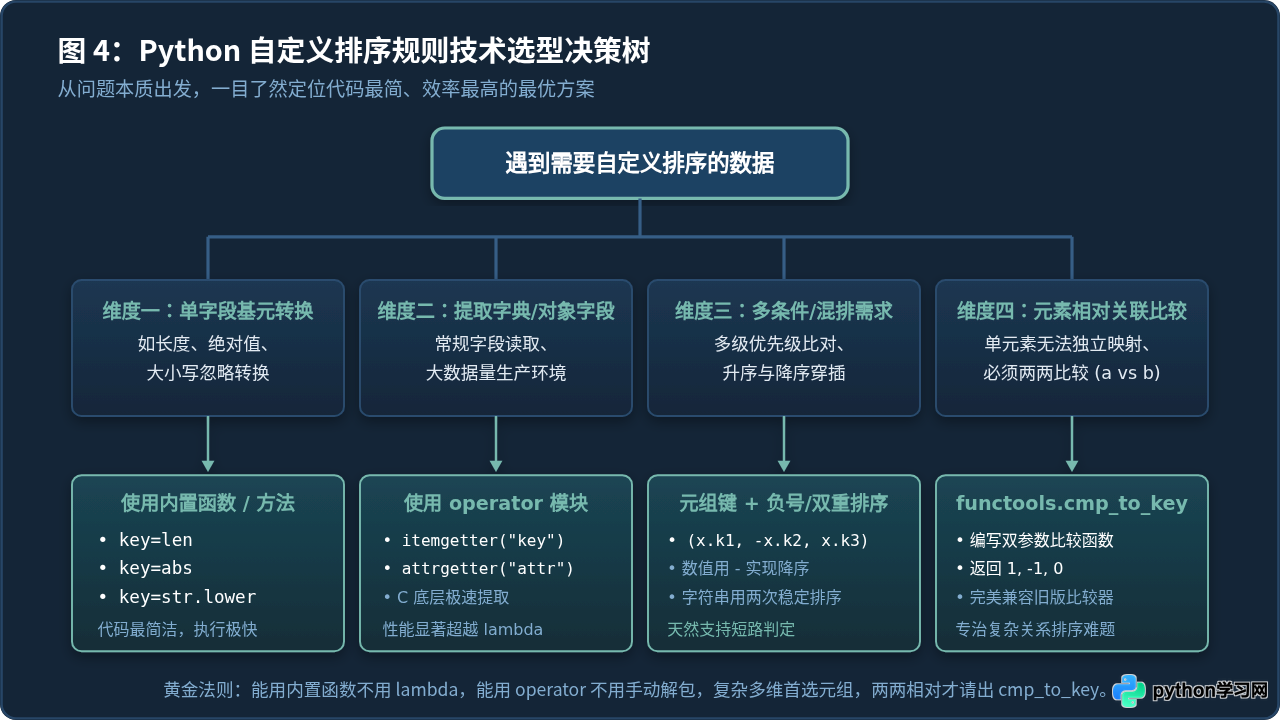
综上所述,Python 的 key 参数以优雅的单参数映射机制取代了低效的重复两两比较。在日常开发中,建议优先遵循“能用内置函数不用匿名函数,数据量大首选 operator 模块,复合条件灵活使用元组判定”的原则,既能保证代码的可读性,又能发挥 Python 底层排序的最大性能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















