


Python集合的并集、交集与差集运算实例
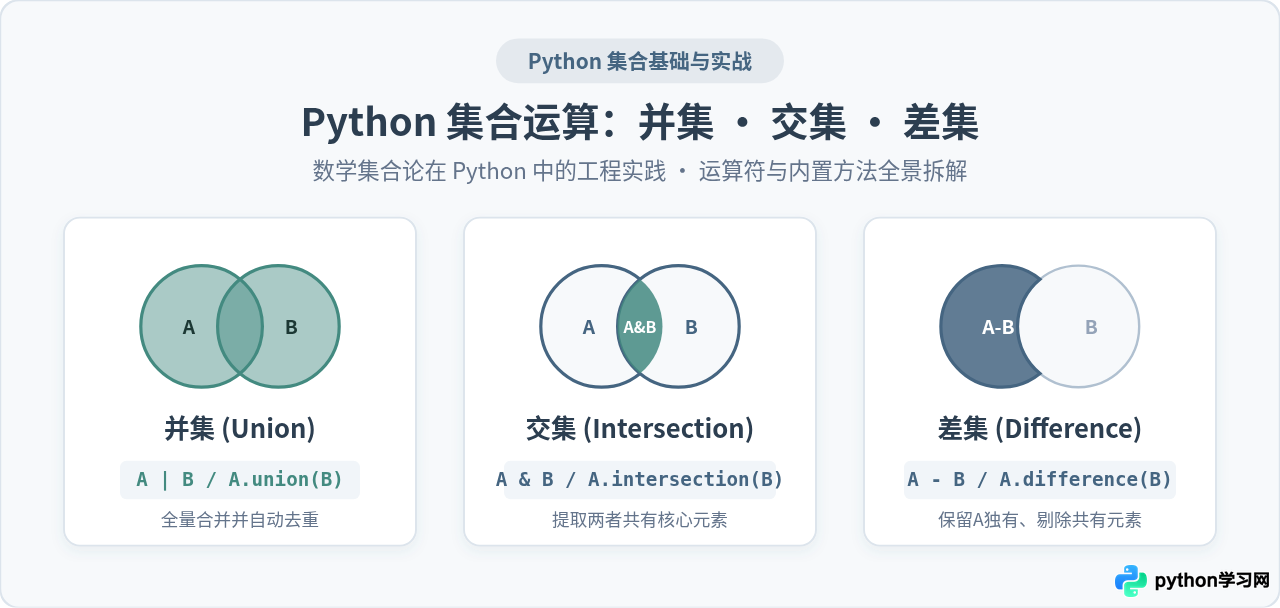
全面讲解Python集合(set)的并集、交集与差集运算,包含运算符与内置方法语法差异、底层去重与哈希原理、实战RBAC权限管理流水线及时间复杂度对比。
set)原生封装了集合论的三大核心运算:并集(Union)将参与计算的所有元素全量合并并自动去重;交集(Intersection)专门提取跨集合共有的重叠元素;差集(Difference)则严格单向剔除属于目标集合的成分。掌握符号运算符(|、&、-)与对象内置方法(.union()、.intersection()、.difference())的使用边界,能够帮助开发者写出执行高效、逻辑自洽的高质量代码。
一、集合运算的核心原理与元素映射
Python 集合基于哈希表(Hash Table)结构实现,集合内的每一个元素都必须满足不可变(Immutable)与可哈希(Hashable)约束。由于哈希桶具备键名唯一的天然排他性,集合在进行数学运算时,元素归属判定、查重与合并均能在平均 O(1) 的时间复杂度内完成。
为了直观展现并集、交集与差集的空间映射关系,我们设定两个具体的基础整数集合:集合 A = {10, 20, 30, 40} 与集合 B = {30, 40, 50, 60}。两者的重合部分为 {30, 40},各自独占部分分别为 {10, 20} 与 {50, 60}。
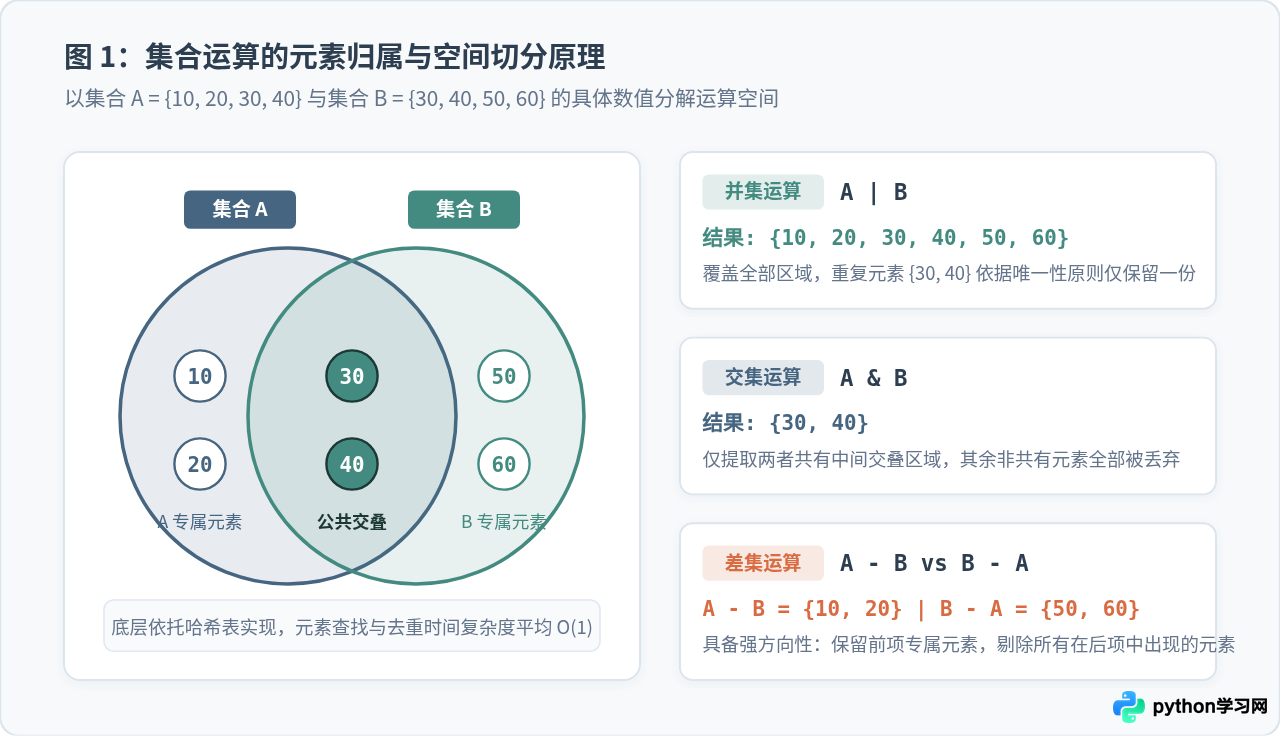
从图 1 的几何切分可以看出:
- 并集空间(A ∪ B):吞吐了两个圆所涵盖的全部物理范围,重叠区元素受集合唯一性限制只保留一次,最终结果容量为 6。
- 交集空间(A ∩ B):仅保留双圆交叉的透镜状区域,非共有元素一律被滤除,最终结果容量为 2。
- 差集空间(A - B):从圆 A 中精准抠除与圆 B 重合的透镜区域,仅剩左侧月牙部分;若反向计算
B - A则得到右侧月牙部分,两者互不相等。
二、并集运算(Union):全量合并与去重机制
并集运算用于汇聚多个数据源的所有元素,同时自动消除重复项。Python 提供了两种操作语法:管道运算符 | 与 set.union() 方法。
1. 符号运算符 | 运算示例
使用 | 可以通过连缀运算符直接合并两个或多个集合。参与运算的双方必须都是 set 类型对象。
# 定义三个部门的员工编号集合
dept_a = {"E101", "E102", "E103"}
dept_b = {"E103", "E104", "E105"}
dept_c = {"E105", "E106"}

# 使用 | 运算符执行并集计算
all_employees = dept_a | dept_b | dept_c

print("全员合并去重名单:", all_employees)
print("去重后总人数:", len(all_employees))去重后总人数: 6
2. 内置方法 .union() 与异构容器支持
set.union(*others) 方法在功能上与 | 等价,但其核心优势在于:能够接收任意可迭代对象(如 list、tuple、dict 键等),无需事先手动将其它容器包裹转为 set。
base_skills = {"Python", "SQL"}
additional_list = ["Docker", "Git", "Python"]  # 列表中包含重复的 Python
additional_tuple = ("Linux", "SQL")             # 元组中包含重复的 SQL

# 直接将列表与元组作为参数传递给 union()
merged_skills = base_skills.union(additional_list, additional_tuple)

print("最终技能清单:", merged_skills)base_skills | additional_list,Python 解释器会立即抛出 TypeError: unsupported operand type(s) for |: 'set' and 'list'。因此,当右侧数据源可能为列表或其他序列时,务必使用 .union()。
三、交集运算(Intersection):公共特征筛选
交集运算用于寻找两个或多个数据集合的共同成员。当我们需要比对多方共识、匹配双向关注好友或检索多重过滤标签时,交集运算是最直接的解法。
1. 符号运算符 & 与 .intersection() 实例
以下示例演示通过交集运算,筛选出在两个技术岗位要求中同时被列为硬性指标的技术项:
# 岗位 A 与岗位 B 的技术要求
job_backend = {"Python", "Django", "PostgreSQL", "Redis", "Docker"}
job_data_eng = {"Python", "SQL", "Spark", "Redis", "Kafka"}

# 使用 & 运算符提取公共技能
shared_reqs_op = job_backend & job_data_eng

# 使用 intersection() 方法比对多源列表
interviewee_skills = ["Python", "Redis", "Go", "Docker"]
matched_skills = job_backend.intersection(job_data_eng, interviewee_skills)

print("双岗位通用技能 (运算符):", shared_reqs_op)
print("候选人与双岗位的公共重叠 (方法):", matched_skills)候选人与双岗位的公共重叠 (方法): {'Python', 'Redis'}
对于多集合的交集,计算遵循结合律与交换律,最终输出的集合仅包含在所有参与集合中都存在的共有项。
四、差集运算(Difference):互斥元素与方向性排他
差集运算用于提取“在集合 A 中存在,但在集合 B 中不存在”的元素。差集运算具有严格的单向非对称性,即 A - B 与 B - A 所代表的业务语义完全不同。
1. 减号运算符 - 的方向性对比
# 应到会名单与实到会名单
expected_attendees = {"Alice", "Bob", "Charlie", "David", "Eva"}
actual_attendees = {"Charlie", "David", "Eva", "Frank"}

# 差集 1:应到但未到(缺勤名单)
absent_members = expected_attendees - actual_attendees

# 差集 2:实到但未受邀(旁听/临时参会名单)
uninvited_guests = actual_attendees - expected_attendees

print("缺勤名单 (expected - actual):", absent_members)
print("未受邀名单 (actual - expected):", uninvited_guests)未受邀名单 (actual - expected): {'Frank'}
2. 补充对照:对称差集(Symmetric Difference)
与单向差集相对,对称差集用于排除两者的重合元素,同时保留各自独有的元素,数学上等价于 (A - B) | (B - A)。在 Python 中使用脱字符 ^ 或 .symmetric_difference() 表示:
set_x = {1, 2, 3}
set_y = {3, 4, 5}

sym_diff = set_x ^ set_y
print("对称差集 (仅保留两者独占项):", sym_diff)五、运算语法选型与操作执行步骤
在工程编码过程中,如何合理选择运算符、内置方法以及是否使用就地修改(In-place),直接关系到代码的健壮性与内存占用。通常遵循以下决策路径:
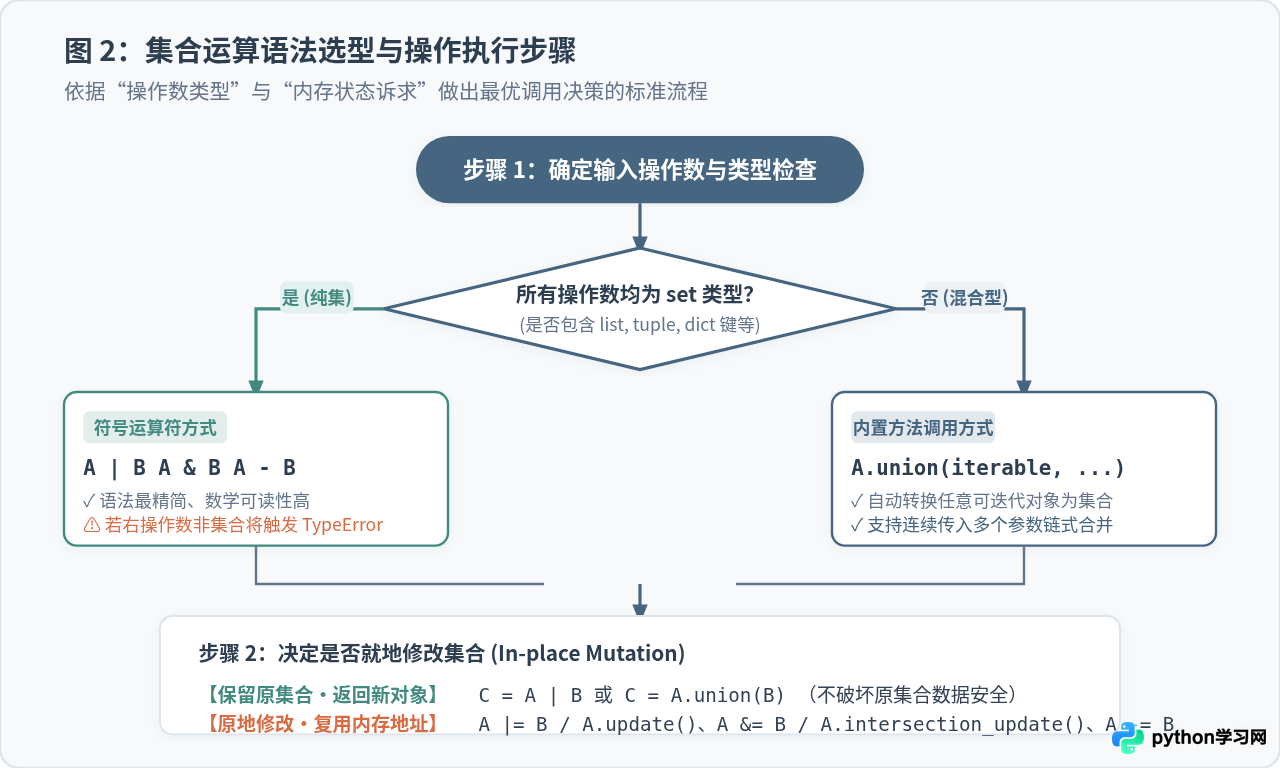
就地修改方法与内存复用
默认的 |、&、- 以及对应方法均会创建并返回一个全新的 set 对象,原集合保持不变。当处理数百万级别的高频大数据集时,频繁分配内存会加剧垃圾回收负担。此时应采用带 _update 后缀的就地方法或复合赋值运算符:
# 初始集合
cache_set = {"item_1", "item_2"}
print("初始对象 id:", id(cache_set))

# 复合运算符就地合并 (等同于 cache_set.update(...))
cache_set |= {"item_3", "item_4"}
print("修改后对象 id:", id(cache_set))  # 内存地址完全相同
print("就地更新后集合:", cache_set)修改后对象 id: 4382910784
就地更新后集合: {'item_1', 'item_2', 'item_3', 'item_4'}
六、实战案例:权限校验与角色补丁计算流水线
在后端系统的 RBAC(基于角色的访问控制)中,并交差运算展现了极高的表现力。以下构建一个完整的权限检查与补丁生成流程:
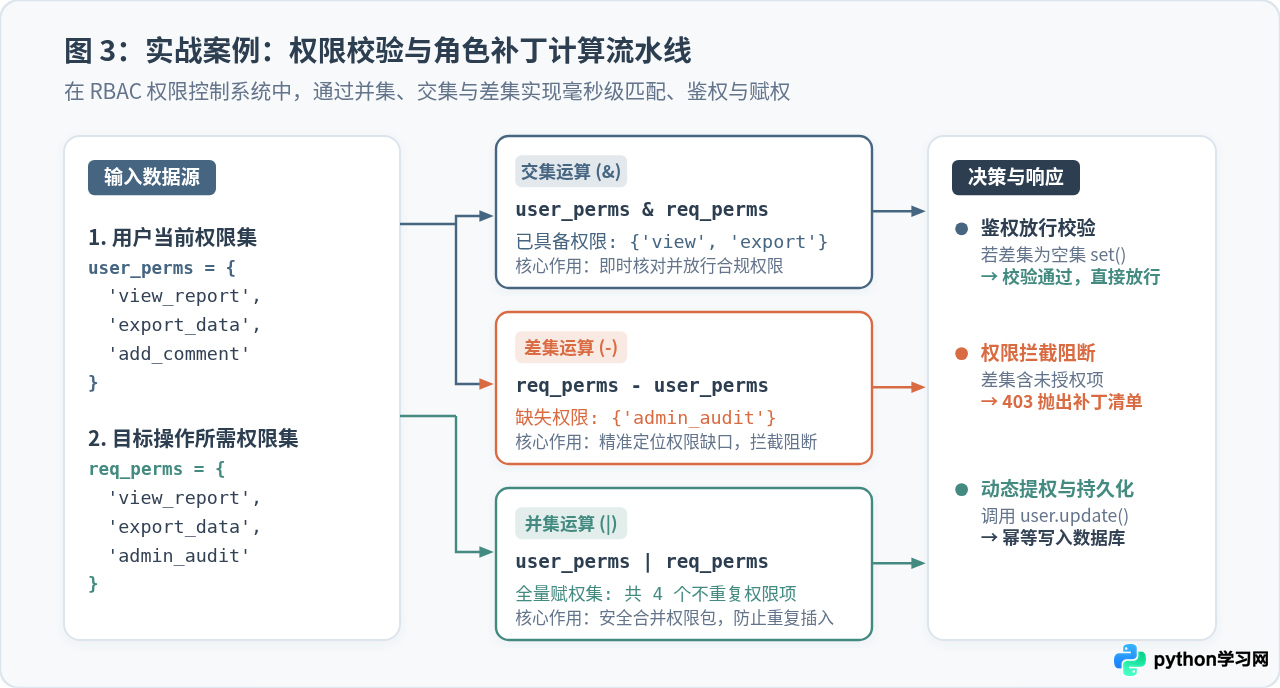
具体 Python 实现代码如下:
def evaluate_permission_pipeline(current_perms: set, required_perms: set) -> dict:
    """
    使用集合运算进行鉴权分析
    :param current_perms: 用户当前拥有的权限集合
    :param required_perms: 访问敏感接口所强制要求的权限集合
    :return: 包含通过状态、重合权限、缺失权限、提权合并集的字典
    """
    # 1. 交集运算:提取已满足的合规权限
    granted_perms = current_perms & required_perms

    # 2. 差集运算:计算尚欠缺的权限缺口 (必须用 required 减去 current)
    missing_perms = required_perms - current_perms

    # 3. 并集运算:若给予临时提权,计算合并后的完整权限快照
    upgraded_perms = current_perms | required_perms

    # 4. 判定放行条件:缺失权限集是否为空
    is_authorized = (len(missing_perms) == 0)

    return {
        "authorized": is_authorized,
        "granted": granted_perms,
        "missing": missing_perms,
        "upgraded": upgraded_perms
    }

# 模拟输入数据
user_perms = {"view_report", "export_data", "add_comment"}
admin_action_reqs = {"view_report", "export_data", "admin_audit"}

# 执行流水线分析
result = evaluate_permission_pipeline(user_perms, admin_action_reqs)

print("是否允许直接执行操作:", result["authorized"])
print("当前已满足权限 (交集):", result["granted"])
print("欠缺阻断权限项 (差集):", result["missing"])
print("提权后综合权限包 (并集):", result["upgraded"])当前已满足权限 (交集): {'view_report', 'export_data'}
欠缺阻断权限项 (差集): {'admin_audit'}
提权后综合权限包 (并集): {'admin_audit', 'export_data', 'view_report', 'add_comment'}
七、关键避坑要点与限制条件
在实际编码中,如果不注意集合的底层约束,容易引发隐蔽的 Bug。以下列举三个核心陷阱:
1. 空集合声明的语法歧义
在 Python 中,字面量 {} 默认被解释器分配给空字典(dict),而非空集合。若要声明一个空的集合,必须使用类型构造器 set():
empty_a = {}
empty_b = set()

print(type(empty_a))  # <class 'dict'>
print(type(empty_b))  # <class 'set'>

# 若错误将空字典用于差集运算将引发异常
try:
    _ = {"read"} - empty_a
except TypeError as err:
print("错误提示:", err)<class 'set'>
错误提示: unsupported operand type(s) for -: 'set' and 'dict'
2. 元素的可哈希性(Hashable)限制
集合中的元素必须可哈希。列表(list)、字典(dict)以及集合本身(set)属于可变对象,无法直接作为集合元素。如果需要将集合嵌套或存入键值,应使用不可变的 frozenset:
# 错误用法:尝试向集合中放入列表
try:
    invalid_set = {"auth_token", [1, 2, 3]}
except TypeError as e:
    print("抛出异常:", e)

# 正确用法:使用不可变的 frozenset 包装复合元素
valid_set = {"auth_token", frozenset([1, 2, 3])}
print("合规嵌套集合:", valid_set)合规嵌套集合: {'auth_token', frozenset({1, 2, 3})}
八、核心知识速查与复杂度总结
为了便于在日常开发中随时查阅,下表系统总结了并集、交集、差集及对称差集的运算符、内置方法、时间复杂度与边界特征:
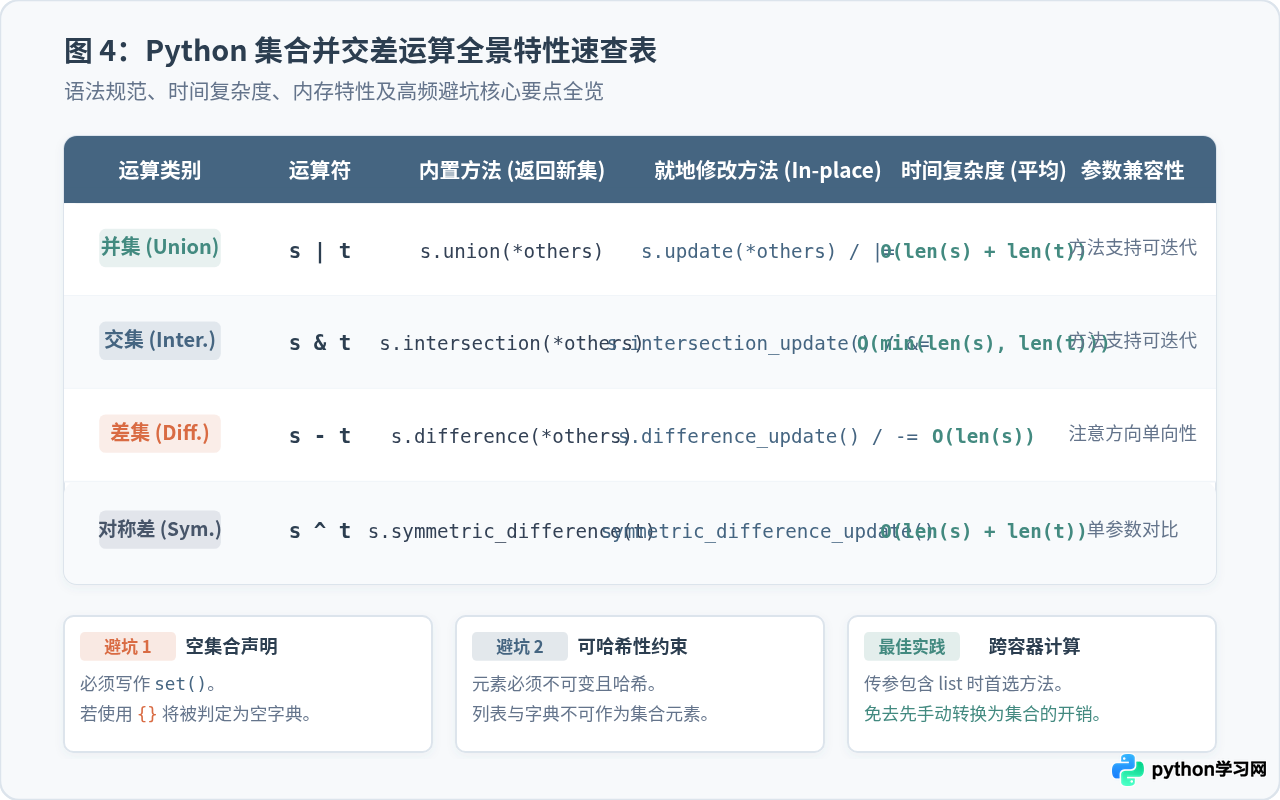
掌握并集、交集与差集的运算规律,不仅能够以声明式的方式替代冗长易错的双重嵌套循环,更能充分利用底层 CPython 哈希表极速的查找效率。在编写涉及去重、过滤、权限比对以及数据清洗的代码时,优先选用原生集合运算往往是最具 Python 风格(Pythonic)的实现方案。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















