


Python使用sqlite3模块连接和操作SQLite数据库
详细讲解Python内置sqlite3标准库的使用方法,包括连接数据库、创建表结构、增删改查操作、参数化防注入、结果集映射以及事务与上下文管理器的正确用法。
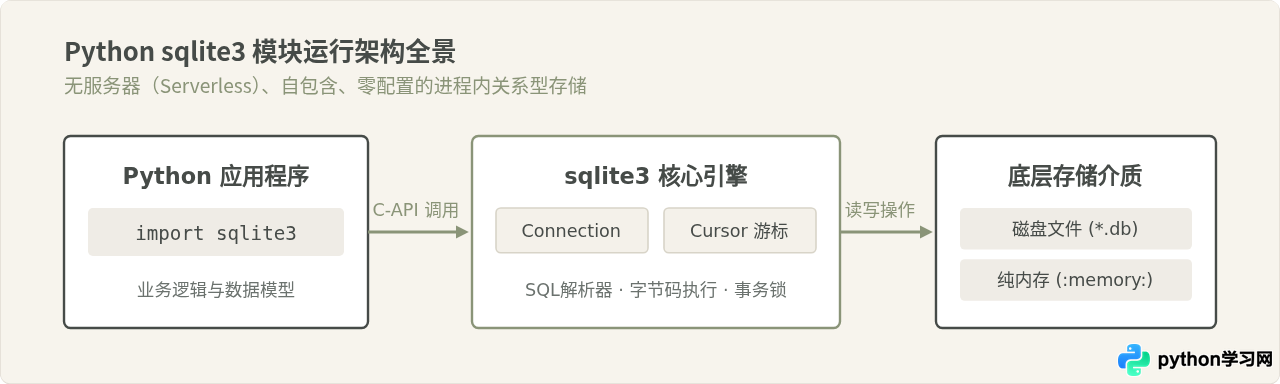
sqlite3 模块提供了对 SQLite 关系型数据库的完整支持,属于 Python 标配标准库,无需借助 pip 额外安装任何依赖。开发者只需指定本地文件路径或内存标识即可建立数据库交互环境,完成数据表的架构设计、数据写入、参数化查询及事务控制。本文通过连贯的步骤与标准示例,系统说明如何规范地使用该模块完成数据库的全流程操作,并辨析开发中常见的事务与连接管理误区。
一、连接数据库与创建游标
使用 sqlite3 的第一步是建立与数据库的连接。调用 sqlite3.connect() 时,如果目标文件已存在,则直接打开;如果目标文件不存在,SQLite 会在指定路径下自动创建一个新的数据库文件。
对于自动化测试或临时缓存等不希望在磁盘留下实体文件的场景,可以使用特殊的 ":memory:" 标识符创建内存数据库。内存数据库驻留在当前运行进程中,进程终止后数据即刻销毁。
import sqlite3

# 1. 连接到磁盘文件数据库(若不存在则自动新建)
conn = sqlite3.connect("app_data.db")

# 2. 或者创建仅在内存中驻留的高速临时数据库
# conn = sqlite3.connect(":memory:")

# 3. 创建执行 SQL 语句的游标对象
cursor = conn.cursor()

print("数据库连接已建立,当前 SQLite 版本:", sqlite3.sqlite_version)
在标准关系型数据库交互中,Connection 对象代表整个数据库的会话连接,负责管理事务与提交配置;而 Cursor(游标)则是执行 SQL 语句、追踪遍历查询结果的句柄。通常情况下,所有的增删改查动作都通过游标的 execute() 或 executemany() 方法发出。
二、创建数据表与定义结构
SQLite 采用动态类型系统,但建议在创建数据表时明确声明字段的亲和类型(Type Affinity)。SQLite 支持五类基本存储类:
INTEGER:带符号整型,根据数值大小采用 1 至 8 字节可变长度存储。REAL:浮点数,对应 IEEE 8-byte 浮点格式。TEXT:文本字符串,通常为 UTF-8 编码。BLOB:二进制原始数据块,用于存储图像、音频或序列化对象。NULL:空值。
在创建数据表时,建议加入 IF NOT EXISTS 约束,避免因重复建表导致程序抛出 sqlite3.OperationalError 异常。
# 创建一张用户表
create_table_sql = """
CREATE TABLE IF NOT EXISTS users (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    username TEXT NOT NULL UNIQUE,
    email TEXT NOT NULL,
    age INTEGER CHECK(age >= 0),
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);
"""

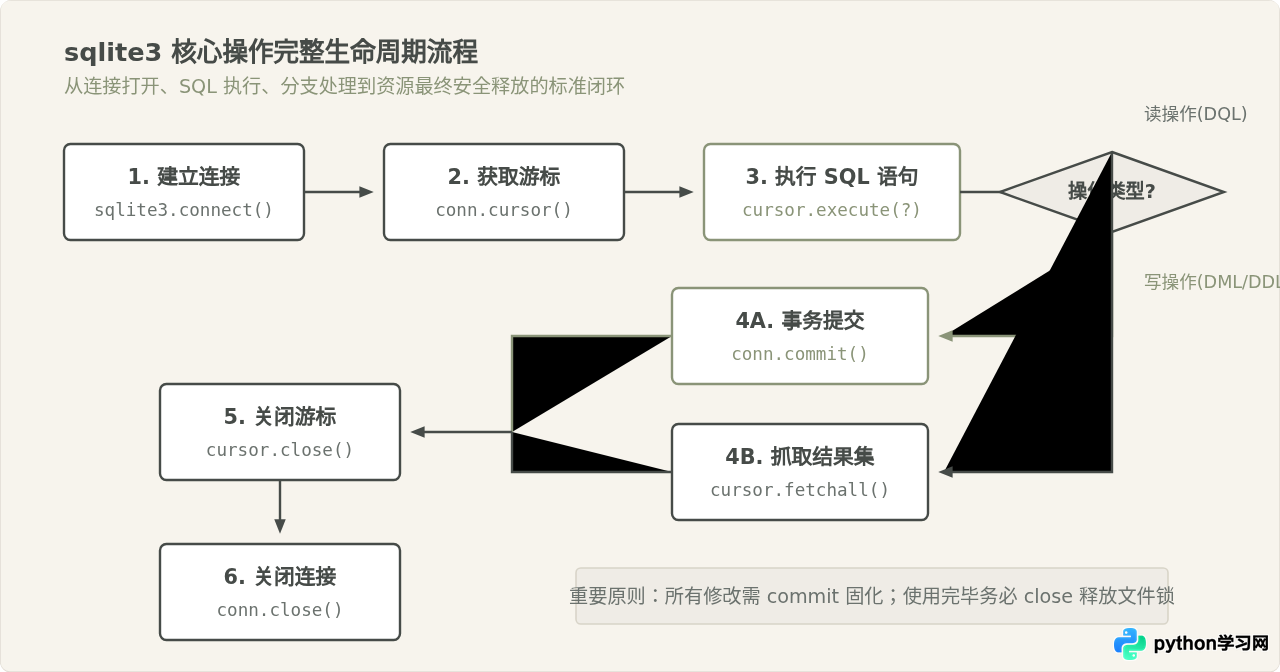
cursor.execute(create_table_sql)
conn.commit()
print("数据表 users 初始化成功。")
三、参数化查询与安全防范
在向数据库插入、更新或按条件筛选数据时,如何将 Python 变量传递进 SQL 语句是数据库编程中最关键的环节。初学者极易采用 Python 原生的 f-string、str.format() 或 % 操作符直接拼接 SQL 字符串。这种做法存在极大的安全漏洞,同时也会损害执行效率。
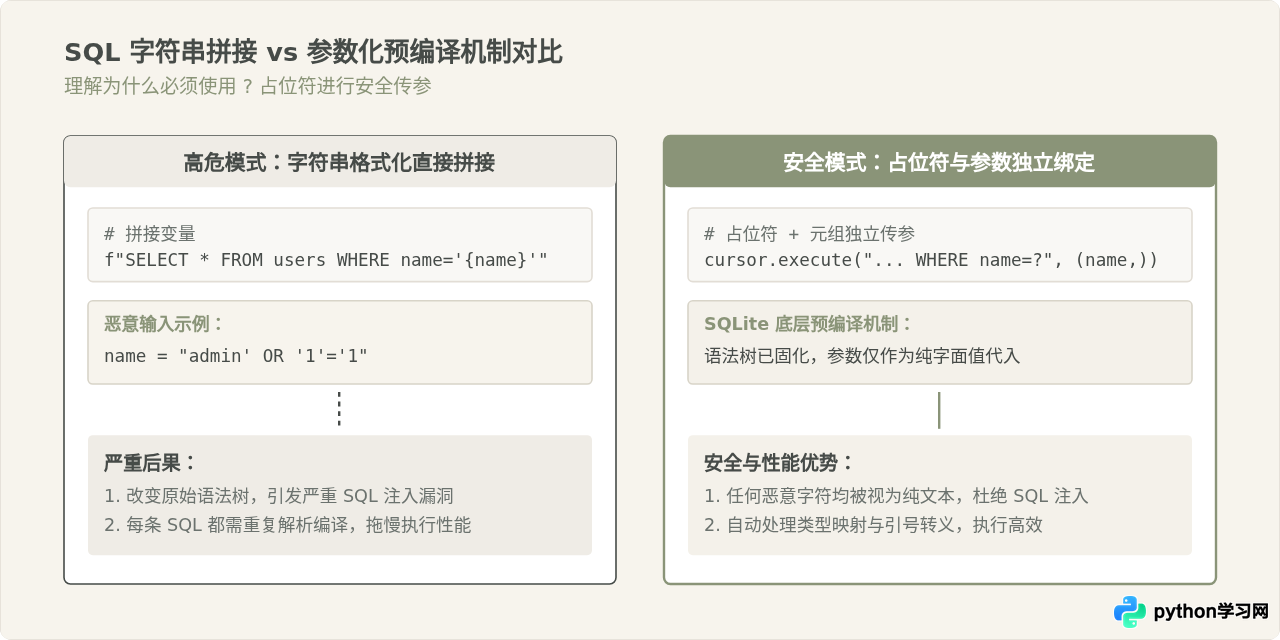
在 sqlite3 模块中,标准占位符是问号 ?(即 qmark 风格),也可以使用以冒号开头的命名占位符(如 :name)。参数必须作为第二个参数以元组(tuple)或列表传入。如果只有一个参数,切记不可遗漏元组尾部的逗号,例如 (val,),否则 Python 会将其解析为普通带括号的表达式而非元组,进而抛出 ProgrammingError: Incorrect number of bindings supplied。
四、数据的增删改与批量写入
对于数据的插入、修改与删除,核心依然是调用 cursor.execute()。若需要插入成百上千条记录,反复单次调用 execute() 会带来巨大的事务开销,此时应优先使用 cursor.executemany()。
# 1. 单条记录插入
insert_sql = "INSERT INTO users (username, email, age) VALUES (?, ?, ?)"
cursor.execute(insert_sql, ("张伟", "zhangwei@example.com", 28))

# 2. 批量记录插入(极大提升写入吞吐量)
users_data = [
    ("李娜", "lina@example.com", 25),
    ("王强", "wangqiang@example.com", 32),
    ("赵敏", "zhaomin@example.com", 22)
]
cursor.executemany(insert_sql, users_data)

# 3. 必须显式提交事务,数据才会真正持久化到磁盘
conn.commit()
print("成功写入数据,最后插入行的自增 ID:", cursor.lastrowid)

# 4. 数据更新与受影响行数获取
update_sql = "UPDATE users SET age = ? WHERE username = ?"
cursor.execute(update_sql, (29, "张伟"))
conn.commit()
print("更新成功,受影响行数:", cursor.rowcount)

# 5. 数据删除
delete_sql = "DELETE FROM users WHERE age < ?"
cursor.execute(delete_sql, (24,))
conn.commit()
print("清理过期记录,删除行数:", cursor.rowcount)
很多初学者在调用 cursor.execute("INSERT ...") 后直接关闭程序,随后用数据库管理工具查看发现数据表中空无一物。这是因为 sqlite3 默认在执行 DML 操作时开启了事务,若未显式调用 conn.commit() 提交事务,程序退出时未提交的事务会自动被回滚(Rollback),导致写入丢失。
五、查询数据与结果集获取
查询语句(SELECT)执行完毕后,结果集暂存在游标相关的缓冲区中。sqlite3 提供了三种提取数据的常规方法:
cursor.fetchone():获取下一行记录,返回一个元组;如果没有更多记录则返回None。cursor.fetchall():一次性取出所有剩余记录,返回元组列表。如果数据量达到百万级,全量拉取可能耗尽内存。cursor.fetchmany(size):分批提取指定数量的记录,适合处理大批量分页处理。
# 查询所有用户记录
cursor.execute("SELECT id, username, email, age FROM users ORDER BY id ASC")

# 方法 A:单条迭代(内存友好,处理海量数据推荐)
print("--- 逐行遍历 ---")
while True:
    row = cursor.fetchone()
    if row is None:
        break
    print(f"ID: {row[0]}, 姓名: {row[1]}, 邮箱: {row[2]}, 年龄: {row[3]}")

# 方法 B:游标本身即为可迭代对象(Pythonic 风格)
cursor.execute("SELECT id, username, email FROM users")
for row in cursor:
    print(row)
利用 row_factory 实现列名映射与字典化
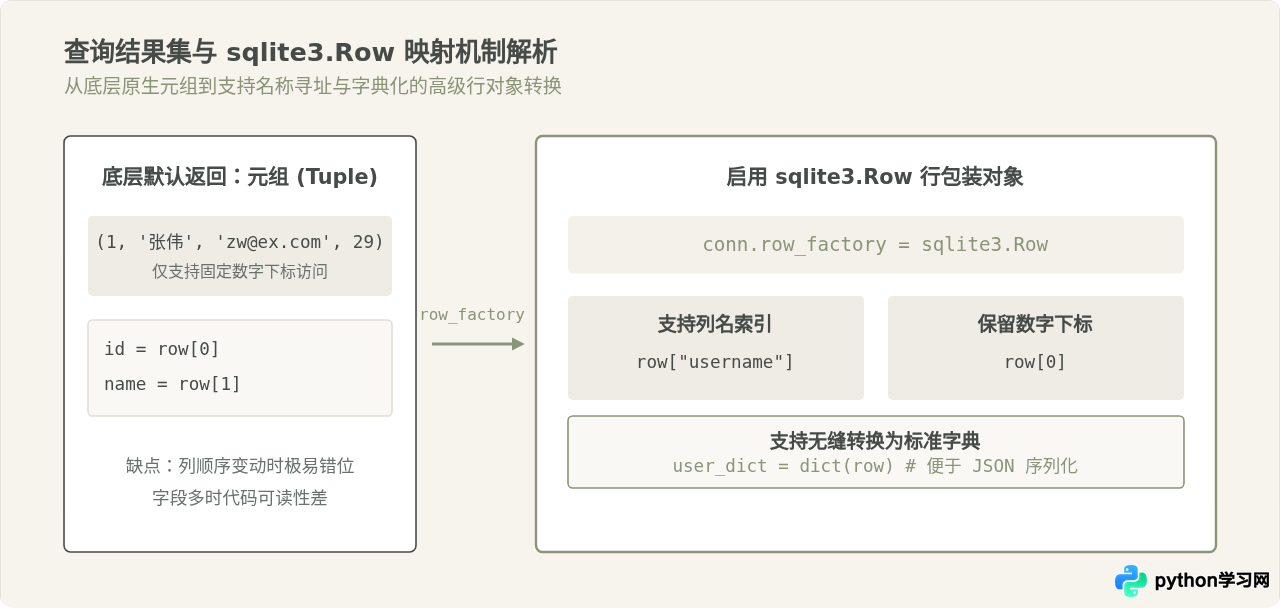
默认情况下,查询提取的每一行都是普通 Python 元组,我们只能通过数字下标(如 row[0]、row[1])访问字段。当查询字段较多或 SQL 经过变更时,数字索引极易发生错位且代码可读性较差。
通过配置连接对象的 row_factory = sqlite3.Row,查询返回的行对象不仅支持下标索引,还支持像字典一样通过列名访问(如 row["username"]),并能通过 dict(row) 轻松序列化为真正的字典。
# 启用 sqlite3.Row 配置
conn.row_factory = sqlite3.Row
cursor = conn.cursor()

cursor.execute("SELECT id, username, email FROM users WHERE id = ?", (1,))
row = cursor.fetchone()

if row:
    # 既可以通过列名访问,也能保持数字索引
    print("通过列名读取:", row["username"], row["email"])
    print("通过下标读取:", row[0])

    # 直接转为纯 Python 字典(非常适合接口返回与 JSON 序列化)
    user_dict = dict(row)
    print("字典格式输出:", user_dict)
六、深入辨析:连接上下文管理器与事务边界
在 Python 编程中,开发者习惯性地认为 with 语句会自动处理所有底层资源的打开与关闭,例如 with open(...) 在退出代码块时必然会关闭文件句柄。许多人因此推断:
这个推论是错误的。在 sqlite3 的官方实现中,Connection 对象的上下文管理器并不负责关闭连接(即不调用 conn.close()),而是仅用于管理事务的边界。
当代码块正常执行无异常退出时,上下文管理器会自动调用 conn.commit();如果代码块内部抛出了任何未捕获的异常,它会自动调用 conn.rollback() 回滚事务。但是,底层数据库连接依然处于保持打开状态。如果长期在循环中这样编写且不调用 close(),会导致文件句柄累积甚至触发数据库文件锁竞争。
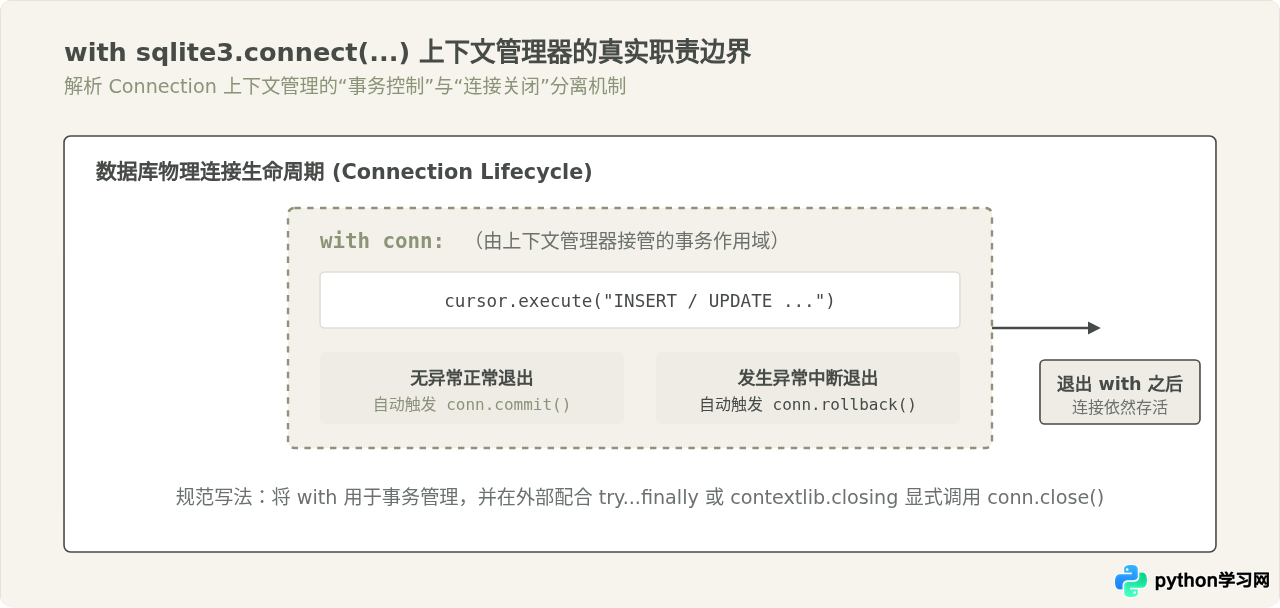
要实现既自动管理事务提交/回滚,又确保连接在业务结束时可靠关闭,有两种标准的工程实践方案:
# 方案 A:try...finally 经典模式(直观、零依赖)
conn = sqlite3.connect("app_data.db")
try:
    with conn:  # 管理事务:成功自动 commit,异常自动 rollback
        cursor = conn.cursor()
        cursor.execute("INSERT INTO users (username, email) VALUES (?, ?)", ("赵六", "zl@ex.com"))
finally:
    conn.close()  # 确保文件句柄释放
    print("数据库连接已彻底关闭。")


# 方案 B:利用 contextlib.closing 包装连接
from contextlib import closing

with closing(sqlite3.connect("app_data.db")) as conn:
    with conn:  # 双层 context:外层关闭连接,内层控制事务
        conn.cursor().execute("UPDATE users SET age = age + 1")
# 代码块退出时,外层 closing 会可靠执行 conn.close()
七、核心 API 汇总与速查总结
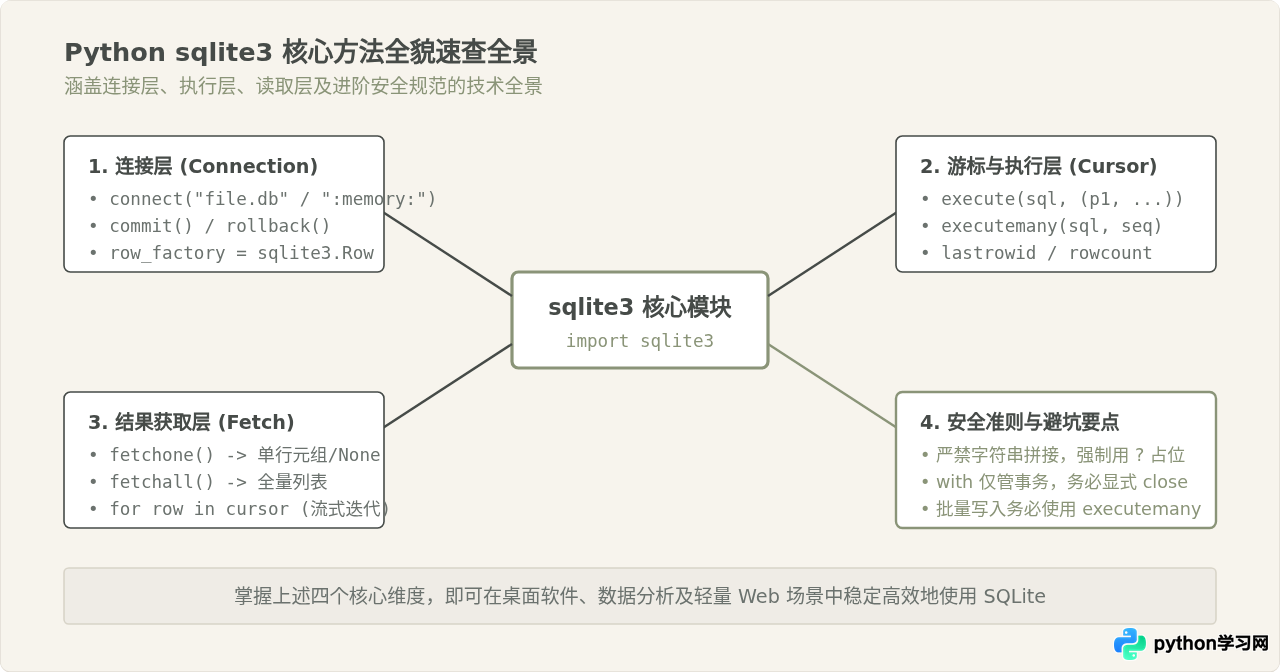
为了方便在实际开发中快速对照,下表梳理了 sqlite3 模块中最常用的对象、方法及其核心作用:
| 方法 / 属性 | 所属对象 | 功能说明与关键要点 |
|---|---|---|
sqlite3.connect(database) |
模块级函数 | 连接数据库。传文件路径打开磁盘库;传 ":memory:" 创建内存库。 |
conn.cursor() |
Connection | 创建并返回游标对象,作为执行 SQL 指令的句柄。 |
conn.commit() |
Connection | 显式提交当前未完结的事务,将修改固化写入磁盘。 |
conn.rollback() |
Connection | 回滚当前未提交事务中的所有写操作。 |
conn.row_factory |
Connection 属性 | 指定结果集行包装器。设为 sqlite3.Row 可按列名与字典方式访问字段。 |
cursor.execute(sql, params) |
Cursor | 执行单条 SQL 语句。参数以元组形式传递,使用 ? 占位符防范注入。 |
cursor.executemany(sql, seq) |
Cursor | 批量执行同一条 SQL,参数为包含多个元组的序列,吞吐性能显著优于循环 execute。 |
cursor.fetchone() |
Cursor | 从查询结果中提取下一条记录;无数据时返回 None。 |
cursor.fetchall() |
Cursor | 取出查询缓冲区内的全部记录,返回列表。 |
cursor.rowcount |
Cursor 属性 | 返回最近一次 UPDATE 或 DELETE 语句实际受影响的数据行数。 |
cursor.close() / conn.close() |
Cursor / Conn | 关闭游标及连接,释放底层文件锁与系统资源。 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















