


Python主流可视化库对比:Matplotlib、Seaborn与Plotly怎么选
深入对比Python三大主流数据可视化库Matplotlib、Seaborn与Plotly的架构定位、核心差异、代码范式与适用场景,提供明确的选型决策树与实践建议。
核心选型结论:在Python数据可视化生态中,选型无需追求“万能库”,而应根据交付媒介与分析阶段精准匹配。Matplotlib适合学术论文出版与要求像素级排版控制的静态图像;Seaborn基于Pandas构建,专为统计探索(EDA)与多维分组聚合设计,开发效率最高;Plotly则是现代Web交互、数据看板与实时动态展示的首选方案。
一、架构与设计定位:为什么它们解决的问题完全不同
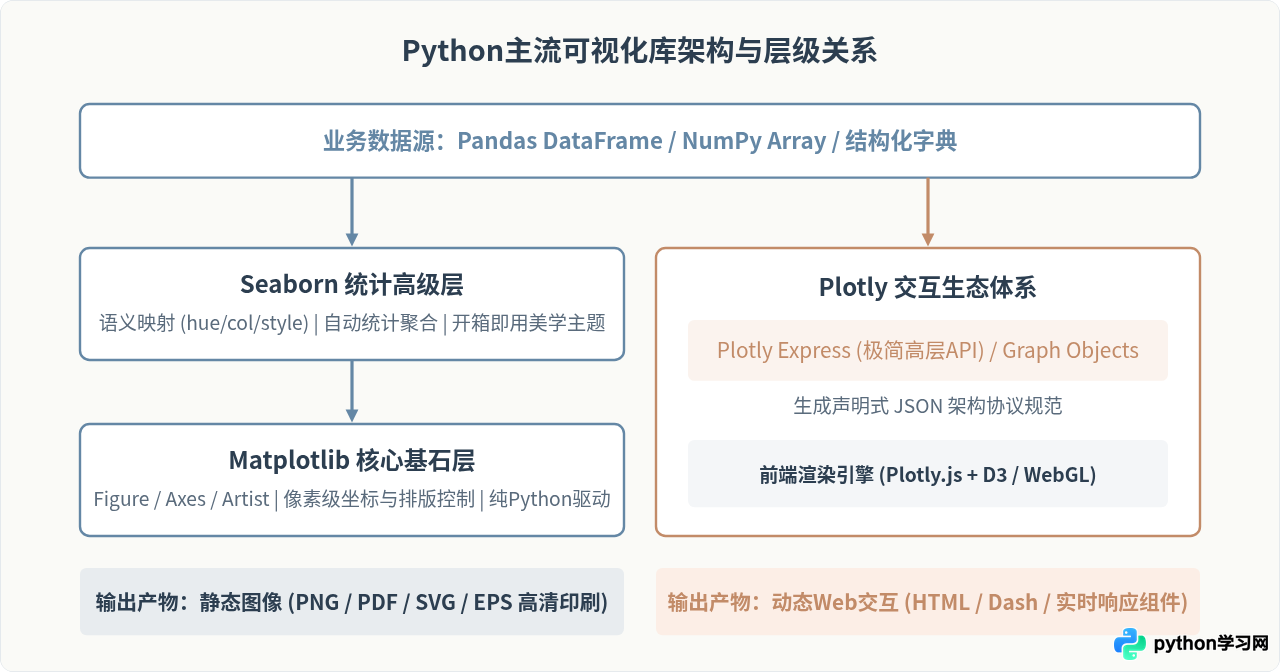
许多初学者容易将Matplotlib、Seaborn与Plotly视为平级的竞争对手,但在底层架构与核心设计哲学上,三者处于不同的技术层级。
Matplotlib是Python可视化领域的“基石渲染引擎”。它采用面向对象的图层架构(Figure、Axes、Artist),允许开发者精确操控坐标轴刻度、脊柱线(Spines)、画布边距和任意自定义图元。这种完备的底层控制力换来的是较为繁琐的API:哪怕绘制一个带置信区间的简单分组柱状图,也往往需要手动拆分数据、计算误差条并遍历绘图。
Seaborn并不试图替代Matplotlib,而是直接构建在Matplotlib之上。它的核心设计围绕“统计数据分析”展开,与Pandas的DataFrame深度集成。在Seaborn中,你无需手动遍历分类变量,只需通过x、y、hue、col等语义参数,Seaborn就会自动完成数据分组、聚合计算、置信区间估计与图例生成。它的底层输出依然是标准的Matplotlib Axes,因此可以完全无缝调用Matplotlib的所有底层指令微调。
Plotly则走了一条完全不同的技术路线。Python端的Plotly(主要通过Plotly Express和Graph Objects)本质上是一个“声明式图表规范生成器”。当你在Python中调用Plotly函数时,它不会直接光栅化像素,而是将数据和视觉映射打包成规范的JSON配置,交由前端的plotly.js(基于D3.js与WebGL)在浏览器中动态渲染。因此,Plotly天然具备缩放、平移、悬停查看数据点(Tooltip)以及图例切换等完备的交互特性。
二、核心维度对比:API范式、性能开销与交互体验
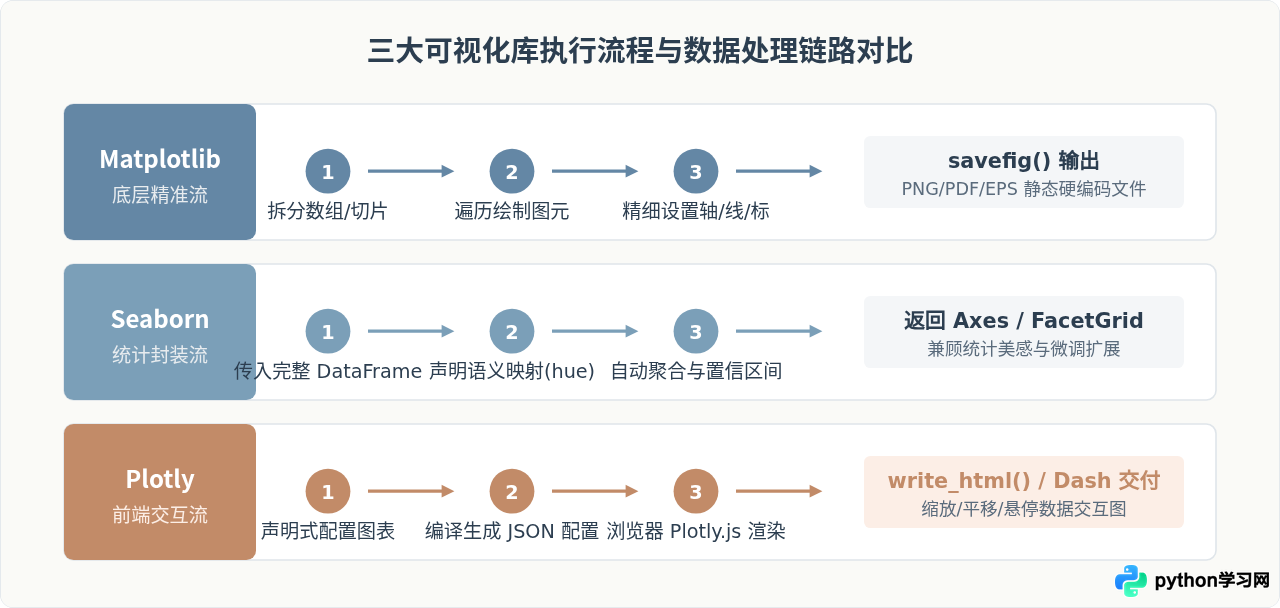
为了让读者直观理解差异,我们从代码范式、渲染性能与交互能力三个关键维度展开拆解:
1. 代码范式与编写心智
在面对“按类别分组着色并绘制趋势线”这一常见需求时,三者的代码量与编写心智差异显著:
- Matplotlib(命令式/面向对象):必须手动提取每个类别子集,为每个子集分别调用
ax.plot()或ax.scatter(),并手动在每次循环中分配合适的色号,最后显式构造图例句柄。虽然掌控力极致,但样板代码(Boilerplate)极多。 - Seaborn(声明式/统计语义驱动):仅需一行代码
sns.lineplot(data=df, x='date', y='value', hue='category')。库内部自动完成DataFrame分组、色板映射与图例绑定,同时自动计算均值与95%置信区间阴影。 - Plotly Express(声明式/交互式):同样只需一行代码
px.line(df, x='date', y='value', color='category')。不仅生成完整的色彩编码与图例,还附带了悬停时精确展示具体数值与日期的Tooltip框。
2. 图像输出与交互能力
这是选型时最硬性的边界条件:
- 静态媒介:如果你的最终成果是PDF报告、学术论文或Word文档,Matplotlib和Seaborn是绝对主力。它们原生支持导出矢量图(SVG、PDF、EPS),对数学公式(LaTeX渲染)、图例微调和印刷CMYK转换提供最稳定的兼容性。
- 动态媒介:如果你的报告以网页、Jupyter Notebook交互演示或BI大屏形式交付,静态位图将无法满足用户对局部数据放大、跨维度过滤或精准查值的需求。Plotly开箱即用的悬停框和选框缩放能够极大地提升沟通效率。
三、实战选型决策流:三步锁定最适配的库
在面对具体的开发或分析任务时,不应主观猜测,而可以通过以下三个具有确定性的判断节点快速得出选型:
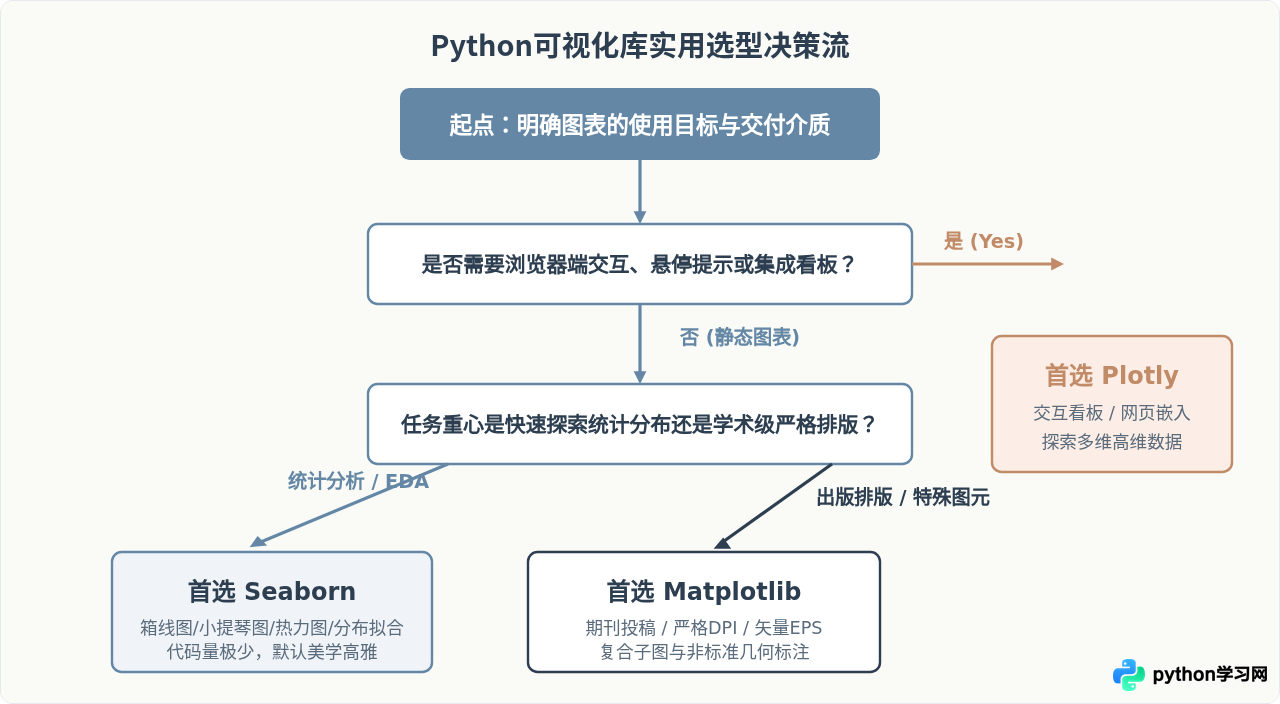
场景一:学术论文投稿与印刷级出版物
选择:Matplotlib
期刊论文(如IEEE、Nature、Elsevier系列)对图表通常有极严苛的技术标准:必须采用Times New Roman或Arial字体、指定字号(通常6~9pt)、特定的图表物理尺寸(如双栏8.5cm或单栏17cm)、黑白打印灰度友好、轴脊柱线线宽精确到0.5pt,且必须输出不失真的矢量图(PDF或EPS)。Matplotlib不仅能够满足这一切要求,还能直接利用原生LaTeX渲染复杂的数学方程式。没有任何其他Python库能在这个领域撼动Matplotlib的地位。
场景二:探索性数据分析(EDA)与统计建模初期
选择:Seaborn
在数据分析与机器学习前期,分析师需要迅速探查特征之间的相关性、特征与目标变量的分布差异、异常值以及多变量联合分布。如果你用Matplotlib编写这些图表,可能80%的时间都消耗在数据切片与轴标签格式化上。而Seaborn专门提供了sns.pairplot()、sns.catplot()、sns.heatmap()和sns.jointplot(),仅需一行代码就能快速完成多维度的统计关系审查。
场景三:业务监控看板、Web应用与跨部门交互展示
选择:Plotly
当你需要向产品经理、业务运营或客户汇报分析成果时,静态图片常常引发一系列二次沟通:“这个异常高点具体是哪一天的数值?”、“把右上角密集的那几个客户放大看一下”。静态图片对此无能为力,而Plotly导出的HTML单文件或配合Streamlit/Dash构建的Web看板,可以让非技术业务人员直接在图表上缩放、圈选、点击图例筛选特定数据流,大幅提升沟通效率与说服力。
四、代码实操:同一数据集下的三种实现写法
我们以一份典型的企业员工薪资数据为例(包含工龄experience、薪资salary和部门department),对比三者的编写范式:
1. Matplotlib:面向对象精细控制写法
import matplotlib.pyplot as plt

# 假设已有数据字典或数组
departments = ['研发', '销售', '运营']
colors = {'研发': '#6487A5', '销售': '#C28B68', '运营': '#8DA399'}

fig, ax = plt.subplots(figsize=(8, 5), dpi=150)

# 手动分组并遍历绘图
for dept in departments:
    sub = df[df['department'] == dept]
    ax.scatter(sub['experience'], sub['salary'],
               label=dept, color=colors[dept], alpha=0.8, edgecolors='none', s=45)

ax.set_title("员工工龄与薪资分布 (Matplotlib实现)", fontsize=13, pad=12)
ax.set_xlabel("工作年限 (年)", fontsize=10)
ax.set_ylabel("月薪 (k)", fontsize=10)
ax.grid(True, linestyle='--', alpha=0.5)
ax.legend(title="所属部门", frameon=True)

# 导出为高清晰度矢量图
plt.tight_layout()
plt.savefig("salary_matplotlib.pdf", bbox_inches='tight')
plt.show()点评:逻辑清晰透明,每个元素都有明确的归属控制,适合对每一个像素都有强迫症的场景。
2. Seaborn:极简统计语义映射写法
import seaborn as sns
import matplotlib.pyplot as plt

# 设置优雅的统计主题
sns.set_theme(style="whitegrid", font="PingFang SC")

# 一行代码完成分类色彩映射与趋势回归拟合
g = sns.lmplot(
    data=df,
    x='experience', y='salary',
    hue='department',
    palette=['#6487A5', '#C28B68', '#8DA399'],
    aspect=1.6, height=5,
    scatter_kws={'alpha': 0.7, 's': 40}
)

g.set_axis_labels("工作年限 (年)", "月薪 (k)")
g.fig.suptitle("工龄与薪资多组趋势拟合 (Seaborn实现)", y=1.03)

plt.show()点评:代码量减半,不仅自动分类画点,还自带了按部门计算的线性回归趋势线与置信带,非常适合统计探索。
3. Plotly Express:现代Web交互写法
import plotly.express as px

# 声明式调用,直接附带丰富交互
fig = px.scatter(
    df,
    x='experience', y='salary',
    color='department',
    hover_name='name', # 悬停时显示员工姓名
    hover_data={'experience': True, 'salary': ':.2f', 'department': False},
    color_discrete_sequence=['#6487A5', '#C28B68', '#8DA399'],
    title="工龄与薪资交互散点分布 (Plotly实现)"
)

# 保存为独立离线HTML文件,双击即可在任何浏览器中交互
fig.write_html("salary_interactive.html", include_plotlyjs='cdn')
fig.show()点评:生成的文件体积轻盈,鼠标悬停即可查看员工详细信息,点击图例可一键隐藏指定部门,交付体验极佳。
五、全维度对比总结与最佳协同实践
为了全面衡量三者的工程表现,我们从开发效率、统计支持、渲染性能和生态适配等维度进行量化总结:
| 评估维度 | Matplotlib | Seaborn | Plotly |
|---|---|---|---|
| 核心架构 | 底座级面向对象渲染 | 基于Matplotlib的统计高级API | Python规范 + 前端D3/WebGL |
| 代码复杂度 | 高(样板代码多,需手动循环) | 极低(语义参数一步到位) | 低(声明式参数直观明了) |
| 统计分析支持 | 基础(需自行计算均值/方差) | 强大(内置置信区间、回归拟合) | 丰富(支持趋势线、直方图等) |
| 交互体验 | 弱(仅基础窗口平移缩放) | 无(纯静态图像) | 原生卓越(悬停、框选、图例筛选) |
| 海量数据性能 | 百万点较慢,需降采样 | 取决于Matplotlib | 原生WebGL加速(scattergl模式) |
| 出版级导出 | 完美(PDF/EPS/SVG精准控制) | 优秀(继承Matplotlib导出) | 普通(需依赖kaleido辅助转换) |
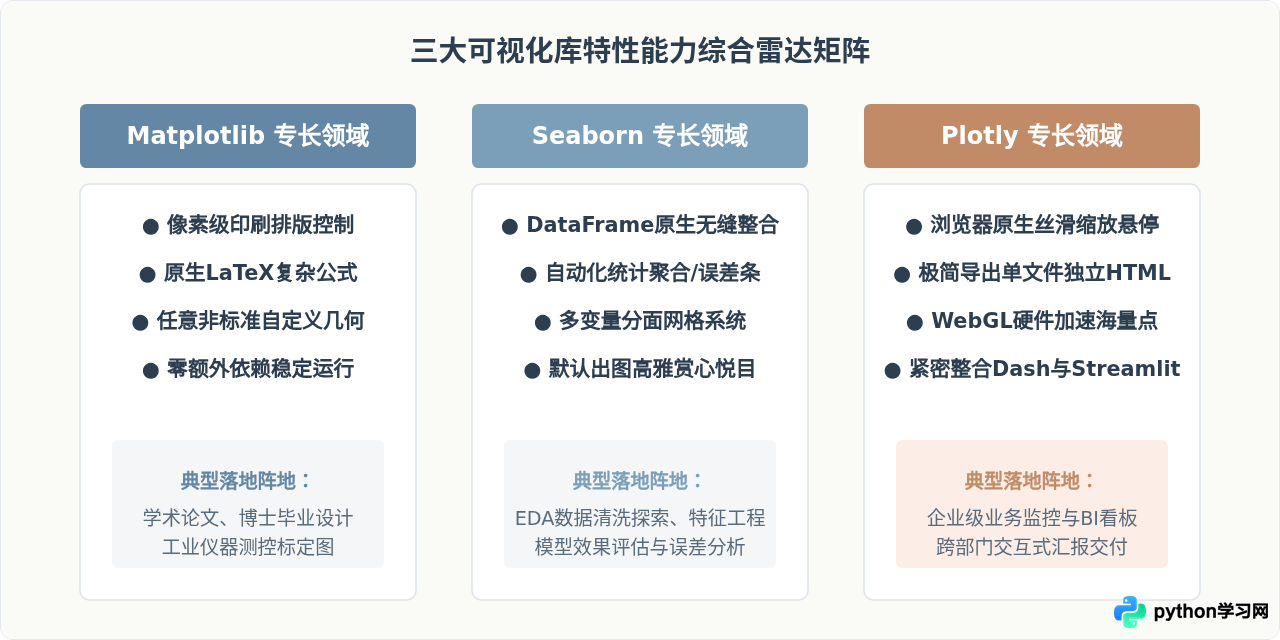
现代工程中的协同组合策略
在实际团队工作中,最高效的团队从不孤立地“三选一”,而是将它们组合进标准分析流:
- 探索阶段(EDA):直接使用Seaborn。利用极简的语法在Jupyter Notebook中快速产出数十张关系图、分布图与关联矩阵,快速验证业务假设与清洗数据。
- 内部交付与监控演示:将核心发现转换为Plotly图表,导出为可交互的HTML单文件或挂载在内部Streamlit后台中,方便团队各角色自主查看数据细节。
- 学术发表与年报归档:针对最终需要沉淀为固定格式的高清论文、技术白皮书,调用Matplotlib进行统一的尺寸标定、字体对齐与矢量导出。
避坑提示:
- 不要试图用Matplotlib去实现复杂的Web交互或频繁的高频动态刷新,这会导致Python进程承受繁重位图渲染开销;
- Plotly在离线环境下直接调用
write_html(include_plotlyjs=True)会将约3MB的JS引擎打包进HTML,若需轻量化可在有网环境下使用include_plotlyjs='cdn'; - Seaborn生成的图表本身就是一个
matplotlib.axes.Axes对象,如果需要修改标题位置或轴标签格式,直接调用ax.set_title()或ax.tick_params()即可,完全不必为了微调而重写为原生Matplotlib。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















