


按模块拆分Python入门100题:字符串、列表与循环专项训练
针对Python入门100题中普遍存在的题目混杂、学习碎片化问题,本文按字符串、列表与循环三大核心模块进行系统拆解。通过底层原理机制剖析、经典高频题型精讲、避坑法则以及多维度内联SVG可视化图解,帮助初学者构建清晰的解题思维与代码规范。
初学 Python 时,“经典入门 100 题”几乎是每位开发者都会接触的练习资源。然而很多学习者在按序刷题时,往往会在第 20 到 40 题之间陷入瓶颈:上一题还在练习打印九九乘法表,下一题突然出现字典去重,再随后又是递归计算斐波那契数列。这种随机混排的刷题模式打破了知识体系的连续性,使学习者把大量精力耗费在反复切换思维定式上,而不是掌握底层的解题范式。
事实上,在入门 100 题中,字符串(String)、列表(List)与循环控制(Loop)这三大要素覆盖了超过 65% 的题量。字符串承担文本输入与字符切片,列表承担数据容器与动态状态暂存,而循环则是驱动数据变换与逻辑判断的计算引擎。将 100 题按这三个核心模块解耦并实施专项训练,能够让初学者在极短时间内看清题目的本质,形成“模块识别 → 容器选型 → 循环控制 → 结果聚合”的自动化解题反射。
一、为什么要按模块拆解入门 100 题?
传统的 Python 入门 100 题最初多由 C/Java 等语言题库转译而来,题目的组织形式往往按照“难度梯队”或“来源顺序”粗糙排列。这种混排结构对初学者存在三大典型阻碍:
- 概念断层严重:例如在尚未完全掌握字符串切片机制的前提下,题目直接要求“提取多行日志中的 IP 地址并去重”,导致学习者同时受挫于正则、字符串分割和集合概念。
- 代码心智负担重:当题目同时混合列表修改与多层循环时,学习者难以分清报错究竟来源于循环边界越界(
IndexError),还是由于列表在迭代过程中长度发生动态变化。 - 无法形成肌肉记忆:孤立地完成一道特定算法题(如“水仙花数”),通常只能记住一道题的特解,而无法掌握“数值拆分为字符序列 → 循环累加幂次方 → 条件验证”这一通用的数据处理管道。
通过将 100 题重构为四阶递进模型,我们把题库中分散的考点集中到三大基石模块中:首先夯实字符串基础,再攻克列表的增删改查与原地维护,进而掌握循环的精准步长与收敛控制,最后完成多模协同的综合题训练。
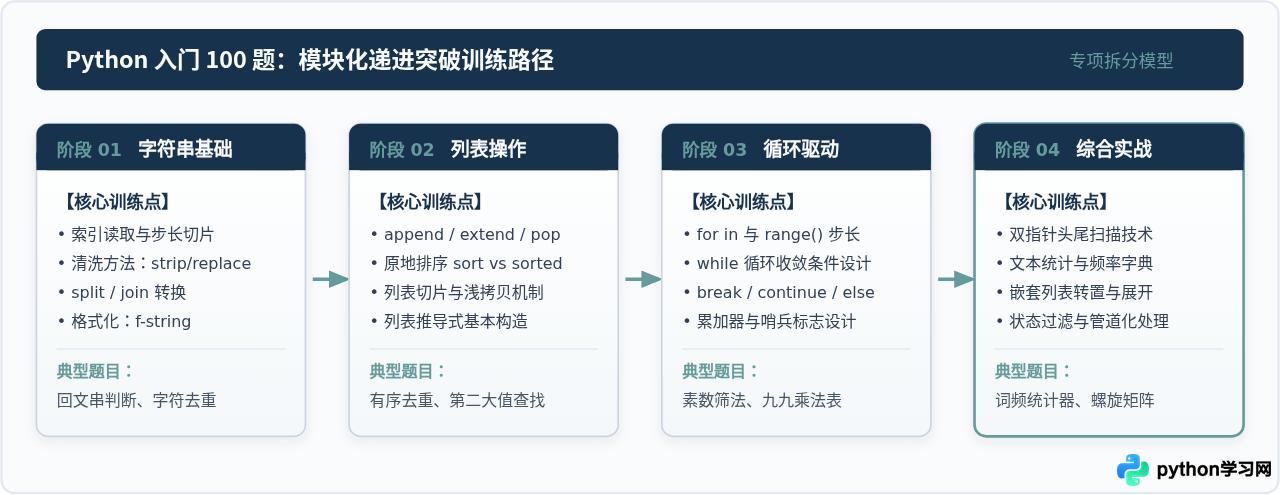
二、模块一:字符串专项训练——不可变序列与文本清洗
在入门 100 题中,字符串题型主要考查文本输入解析、子串检索、格式标准化和对称性验证。理解字符串的核心前提是:Python 中的字符串是不可变对象(Immutable Sequence)。这意味着任何对字符串的“修改”操作(如替换、拼接、大小写转换)都不会改变原字符串,而是创建并返回一个全新的字符串对象。
1. 核心操作与切片语法
切片语法 s[start:end:step] 是解决字符串题目最高频的工具,区间规则为左闭右开 [start, end):
s[::-1]:步长为 -1,用于将字符串整体逆序反转。s[::2]:步长为 2,用于提取所有偶数索引位置的字符。s.strip()、s.lower()、s.replace(old, new):不可变清洗三件套。s.split(sep)与sep.join(iterable):实现字符串与列表之间的双向互通桥梁。
2. 典型高频题型精解
【题型 A:回文串判断与清洗】
题目要求:输入一段文本(例如 "A man, a plan, a canal: Panama"),忽略其中的标点符号、空格与大小写差异,判断其是否为回文串。
def is_palindrome(s: str) -> bool:
    # 步骤 1:利用推导式完成清洗,仅保留小写字母与数字
    cleaned_chars = [c.lower() for c in s if c.isalnum()]

    # 步骤 2:利用切片直接比较逆序
    return cleaned_chars == cleaned_chars[::-1]

# 示例验证
sample_input = "A man, a plan, a canal: Panama"
result = is_palindrome(sample_input)
print(f"输入文本: '{sample_input}'")
print(f"回文校验结果: {result}")回文校验结果: True
【题型 B:统计字符出现频次并格式化输出】
题目要求:统计给定字符串中各字母的出现次数,按照出现频次从高到低输出,若频次相同则按字母顺序排列。
def count_char_frequencies(text: str) -> str:
    cleaned = text.lower()
    counts = {}

    # 循环统计每个字符的出现频次
    for char in cleaned:
        if char.isalpha():
            counts[char] = counts.get(char, 0) + 1

    # 按照频次降序、字母升序排序
    sorted_items = sorted(counts.items(), key=lambda item: (-item[1], item[0]))

    # 格式化拼接为报告文本
    formatted = [f"{k}: {v}" for k, v in sorted_items]
    return ", ".join(formatted)

sample_text = "Python Programming Language"
print(f"统计报告: {count_char_frequencies(sample_text)}")3. 核心机制剖析:不可变性带来的内存陷阱
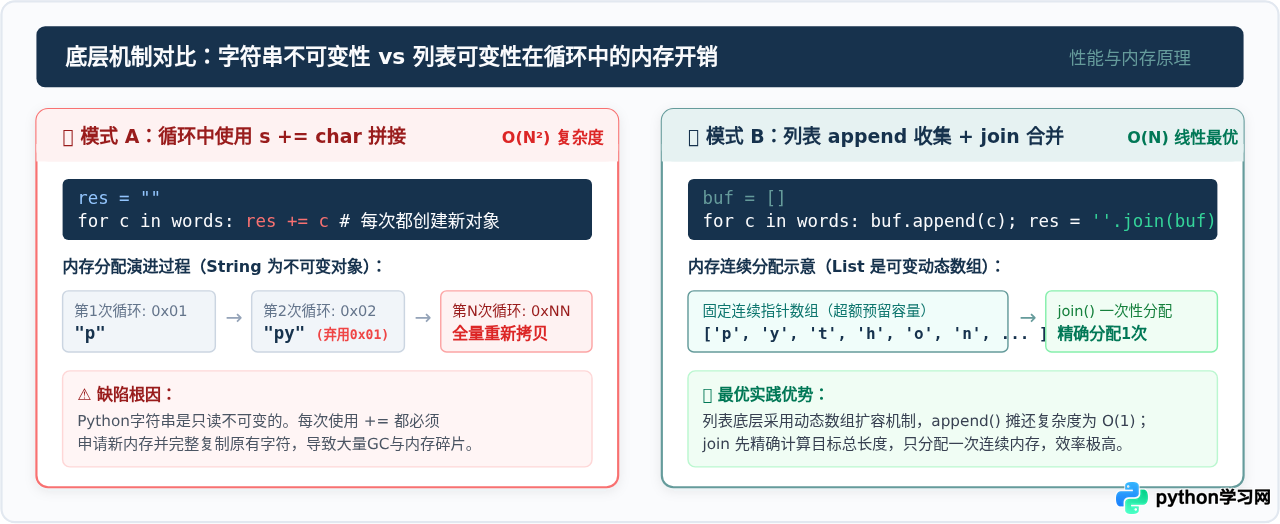
初学者最常见的性能 Bug 是在循环体内部使用 s += char 拼接大量字符。由于字符串不可变,每次 += 解释器都必须在堆内存中重新申请一块空间,并将原有字符全量拷贝过去。如果字符串长度为 N,该操作会导致累积时间复杂度攀升至 O(N²)。正确的工程范式是利用可变容器列表的 append() 方法收集字符,循环结束后使用 ''.join() 进行单次内存分配。
三、模块二:列表专项训练——动态容器与状态维护
列表是 Python 中最核心的可变序列(Mutable Sequence)。在 100 题中,列表通常承担“状态记录表”、“待处理任务队列”或“矩阵多维结构”。掌握列表的关键在于厘清原地修改(In-place Modification)与生成新对象的区别,以及警惕浅拷贝对嵌套结构带来的副作用。
1. 核心操作规范与区分
| 操作分类 | 典型方法 / 语法 | 是否原地修改原列表 | 返回值 | 核心应用场景 |
|---|---|---|---|---|
| 尾部操作 | lst.append(x) / lst.pop() |
是 | None / 弹出元素 |
栈结构模拟、动态构建结果 |
| 批量扩展 | lst.extend(iterable) |
是 | None |
合并多个子序列,优于循环 append |
| 原地排序 | lst.sort(reverse=True) |
是 | None |
节省内存的就地重排 |
| 稳定新排序 | sorted(iterable, key=...) |
否 | 新列表 | 保留原始顺序、支持任意可迭代对象 |
| 切片复制 | lst[:] / lst.copy() |
否 | 一维浅拷贝副本 | 遍历保护、防止原数组被篡改 |
2. 典型高频题型精解
【题型 A:列表保持原始顺序去重】
题目要求:输入一个包含重复元素的数字列表,去除重复元素,并严格保留元素在原列表中首次出现的相对先后顺序。
def remove_duplicates_keep_order(items: list) -> list:
    seen = set()
    result = []

    # 结合 set 的 O(1) 查询效率与 list 的有序追加
    for item in items:
        if item not in seen:
            seen.add(item)
            result.append(item)

    return result

raw_nums = [4, 2, 1, 3, 2, 4, 5, 1, 6]
clean_nums = remove_duplicates_keep_order(raw_nums)
print(f"原列表: {raw_nums}")
print(f"保序去重结果: {clean_nums}")保序去重结果: [4, 2, 1, 3, 5, 6]
【题型 B:单次遍历寻找列表第二大值】
题目要求:在不使用内置 sort() 函数的前提下,通过一次遍历 O(N) 找到列表中严格小于最大值的“第二大值”。
def find_second_largest(nums: list) -> int:
    if len(nums) < 2:
        raise ValueError("列表元素至少需要包含两个数字")

    first = second = float('-inf')

    for n in nums:
        if n > first:
            second = first
            first = n
        elif first > n > second:
            second = n

    if second == float('-inf'):
        raise ValueError("列表中所有数值完全相同,不存在第二大值")

    return second

test_scores = [78, 92, 85, 99, 99, 88, 95]
print(f"分数列表: {test_scores}")
print(f"第二高分: {find_second_largest(test_scores)}")第二高分: 95
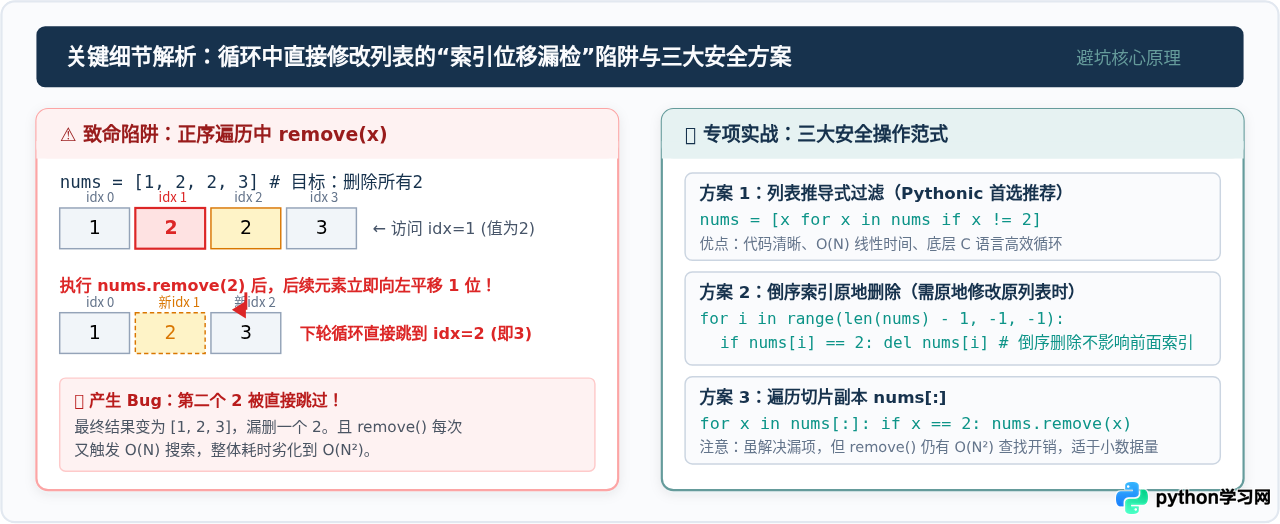
在入门 100 题中,许多初学者写出如下代码:for x in nums: if x == 2: nums.remove(x)。这种写法会直接引发“索引位移漏检”错误。因为每当从列表中删除一个元素,后面的所有元素都会立即向前平移一位,而 for 循环底层的迭代指针依然无条件递增,导致紧随被删元素之后的那个元素被直接跳过,产生严重静默 Bug。
四、模块三:循环专项训练——控制流引擎与边界设计
循环是程序由静态转为动态执行的核心。在 Python 100 题中,循环结构考查的重心主要包含:
- 确定步长迭代:精准掌握
range(start, stop, step),尤其注意 stop 是开区间边界。 - 状态收敛迭代:
while循环必须设置可严格收敛的终止条件,严防死循环。 - 双重/多重嵌套循环:外层循环控制行/阶段,内层循环控制列/单步计算。
- 流程分支控制:
break(立即跳出整个当前层循环)、continue(跳过本轮剩余逻辑)、for...else(当循环完整跑完、未被 break 中断时触发)。
1. 典型高频题型精解
【题型 A:素数判定与 for...else 语法糖应用】
题目要求:找出 100 以内的所有素数。要求代码逻辑紧凑,不使用额外的标志位变量(Flag)。
def get_primes_under_n(limit: int) -> list:
    primes = []

    for num in range(2, limit + 1):
        # 仅需检查至 int(sqrt(num)) + 1
        is_prime = True
        limit_check = int(num ** 0.5) + 1

        for divisor in range(2, limit_check):
            if num % divisor == 0:
                break
        else:
            # 只有内层循环未触发 break 时,else 才会执行
            primes.append(num)

    return primes

primes_100 = get_primes_under_n(50)
print(f"50以内的素数列表 (共 {len(primes_100)} 个):")
print(primes_100)[2, 3, 5, 7, 11, 13, 17, 19, 23, 29, 31, 37, 41, 43, 47]
【题型 B:双指针收敛扫描(两数之和专项)】
题目要求:给定一个已升序排列的整数列表和一个目标值 target,寻找列表中两数之和等于目标值的两数索引。要求时间复杂度为 O(N)。
def two_sum_sorted(numbers: list, target: int):
    left = 0
    right = len(numbers) - 1

    # while 循环驱动对撞双指针
    while left < right:
        current_sum = numbers[left] + numbers[right]
        if current_sum == target:
            return (left, right)
        elif current_sum < target:
            left += 1   # 和偏小,左指针右移增大数值
        else:
            right -= 1  # 和偏大,右指针左移减小数值

    return None

sorted_arr = [2, 7, 11, 15, 19, 28]
target_val = 26
match_indices = two_sum_sorted(sorted_arr, target_val)
print(f"有序序列: {sorted_arr}, 目标和: {target_val}")
print(f"匹配下标对: {match_indices} -> 值: {sorted_arr[match_indices[0]]} + {sorted_arr[match_indices[1]]}")匹配下标对: (1, 4) -> 值: 7 + 19
五、模块协同:三者交织的综合实战训练
在入门 100 题的后半段,绝大多数题目并非孤立考查某单一 API,而是将字符串、列表与循环组合成一条完整的数据管道。标准的数据流转模型表现为:以不可变字符串为数据源,借助字符串方法拆分为列表容器,由循环控制引擎执行过滤与累加,最终再次聚合为规范的输出结构。
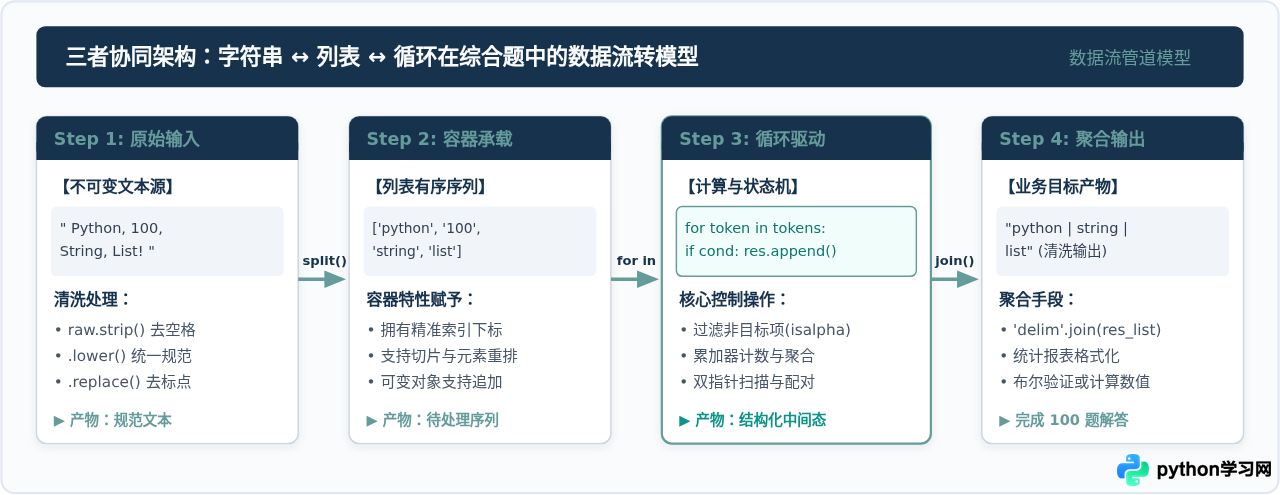
综合实战题:日志词频过滤与报表对齐生成器
题目综合要求:给定一段模拟的服务器日志行,包含时间戳、状态标签与文本信息。要求:
- 提取所有的有效文本 Token,过滤掉停用标点符号与纯数字干扰项;
- 所有单词转换为小写,计算有效词频;
- 剔除出现频次低于阈值的噪点词,按照频次从高到低排序;
- 利用循环配合 f-string 生成固定列宽的对齐式报表字符串。
def generate_log_report(log_text: str, min_count: int = 2) -> str:
    # 阶段 1:字符串清洗与字符替换
    punctuation = "!?:;,.-[]()"
    cleaned_text = log_text
    for p in punctuation:
        cleaned_text = cleaned_text.replace(p, " ")

    # 阶段 2:拆分转为列表容器
    raw_tokens = cleaned_text.split()

    # 阶段 3:循环驱动过滤与状态统计
    freq_map = {}
    for token in raw_tokens:
        word = token.lower()
        # 仅保留纯字母且长度大于1的有效单词
        if word.isalpha() and len(word) > 1:
            freq_map[word] = freq_map.get(word, 0) + 1

    # 阶段 4:列表推导式二次过滤与排序
    filtered_tokens = [
        (word, count) for word, count in freq_map.items()
        if count >= min_count
    ]
    sorted_tokens = sorted(filtered_tokens, key=lambda x: (-x[1], x[0]))

    # 阶段 5:聚合格式化输出为排版报表
    report_lines = [
        "+" + "-" * 22 + "+" + "-" * 10 + "+",
        f"| {'WORD':<20} | {'COUNT':<8} |",
        "+" + "-" * 22 + "+" + "-" * 10 + "+"
    ]

    for word, count in sorted_tokens:
        report_lines.append(f"| {word:<20} | {count:<8} |")

    report_lines.append("+" + "-" * 22 + "+" + "-" * 10 + "+")
    return "\n".join(report_lines)

sample_log = """
[2026-11-01 21:00:10] (INFO): Server worker-1 started successfully!
[2026-11-01 21:00:12] (WARNING): High memory usage on worker-1, worker memory load high.
[2026-11-01 21:00:15] (INFO): Server health check passed, worker status normal.
"""

print(generate_log_report(sample_log, min_count=2))| WORD | COUNT |
+----------------------+----------+
| worker | 4 |
| high | 2 |
| memory | 2 |
| server | 2 |
+----------------------+----------+
六、专项训练避坑速查矩阵与通关检查单
在完成 100 题专项突破时,很多代码错误往往并非源自算法思路偏差,而是对底层细节的疏忽。以下矩阵系统总结了三大核心模块中最容易被忽略的细节准则:
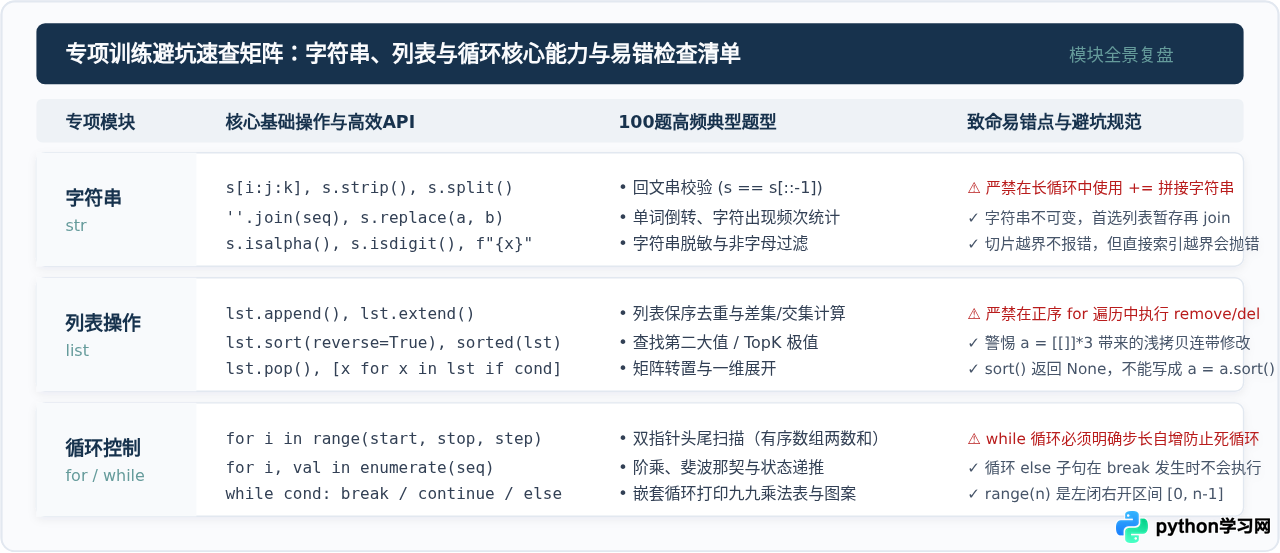
- 边界测试:传入空字符串
""或空列表[]时,程序会抛出IndexError还是优雅返回? - 单元素验证:输入只有 1 个字符或 1 个数字的列表时,极值或双指针逻辑是否会发生死循环?
- 只读性检查:函数内部是否在未经意间修改了调用方传入的原列表参数?
- 浅拷贝警惕:初始化二维矩阵时,是否误写成了
matrix = [[0] * m] * n(会导致修改一行连带所有行变动)?正确写法应为[[0] * m for _ in range(n)]。 - 返回值类型:是否误把
lst.sort()或lst.reverse()的结果赋给了新变量(它们的返回值为None)? - 区间开闭性:
range(start, end)的end是否少算了 1 位? - 循环收敛:
while循环体内部是否每条分支都有让循环条件趋近退出的步长递增? - 不可变效率:循环中是否存在长字符串的频繁拼接?是否已经改用列表
join()模式? - 删除安全:列表中是否有在正向迭代中执行删除操作的代码?是否已经重构为列表推导式?
- 类型统一:从字符串提取数字时,是否记得调用
int()转换后再做数值比较?
通过这种按模块拆分的专项训练,原本散乱无章的 Python 入门 100 题将转化为一组高度结构化的技能矩阵。掌握了字符串的切片与清洗、列表的状态管理与安全维护,以及循环的边界把控,无论是面对经典入门习题,还是后续进阶到字典、集合、面向对象乃至 LeetCode 算法题,读者都能够胸有成竹、条理清晰地写出稳健高效的代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















