


Python3批量抓取并下载App历史版本安装包
系统介绍使用 Python 3 批量抓取与下载移动端 App 历史版本安装包的完整实现方案,涵盖历史版本页面解析、直链提取、流式下载、断点续传及文件完整性校验。
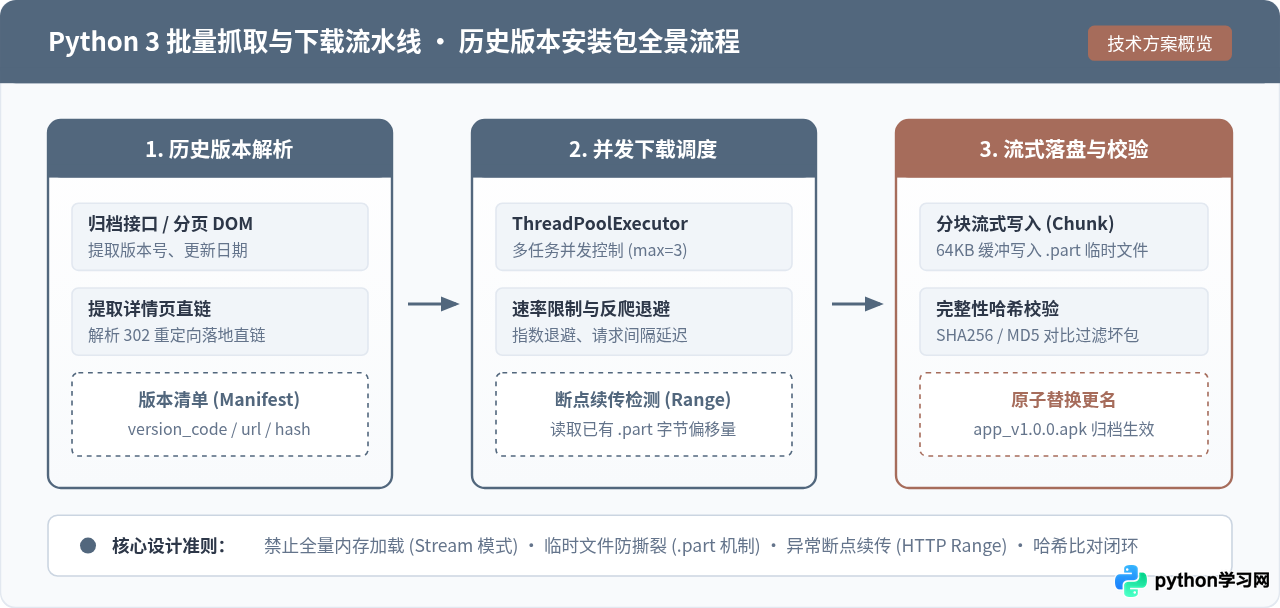
批量获取 App 历史版本安装包的核心技术链路主要由三个连续环节组成:首先通过结构化请求解析目标应用的历史版本清单及元数据,随后提取各个历史版本的真实落地下载直链,最后借助受控的并发任务池与流式分块写入将安装包持久化到本地并完成完整性校验。本文基于 Python 3 介绍从列表逆向解析、防盗链与直链提取,到断点流式下载与文件校验的完整工程化实现方案。
一、历史版本抓取与下载的层级架构
在移动开发兼容性回溯测试、安全逆向分析或旧版功能验证等场景中,往往需要获取某一应用在过去数个迭代周期内发布的完整 APK 或 IPA 安装包。移动应用分发平台与归档站点通常不会将真实下载直链直接裸露在第一层分页列表中,而是采用“列表页 → 详情跳转页 → CDN 静态资源”的分层结构。
为了保证大规模批量任务的稳定运行,整套采集系统必须在逻辑上划分为三个独立但紧密协作的层级:数据源接口层、调度与解析控制层,以及流式落地校验层。
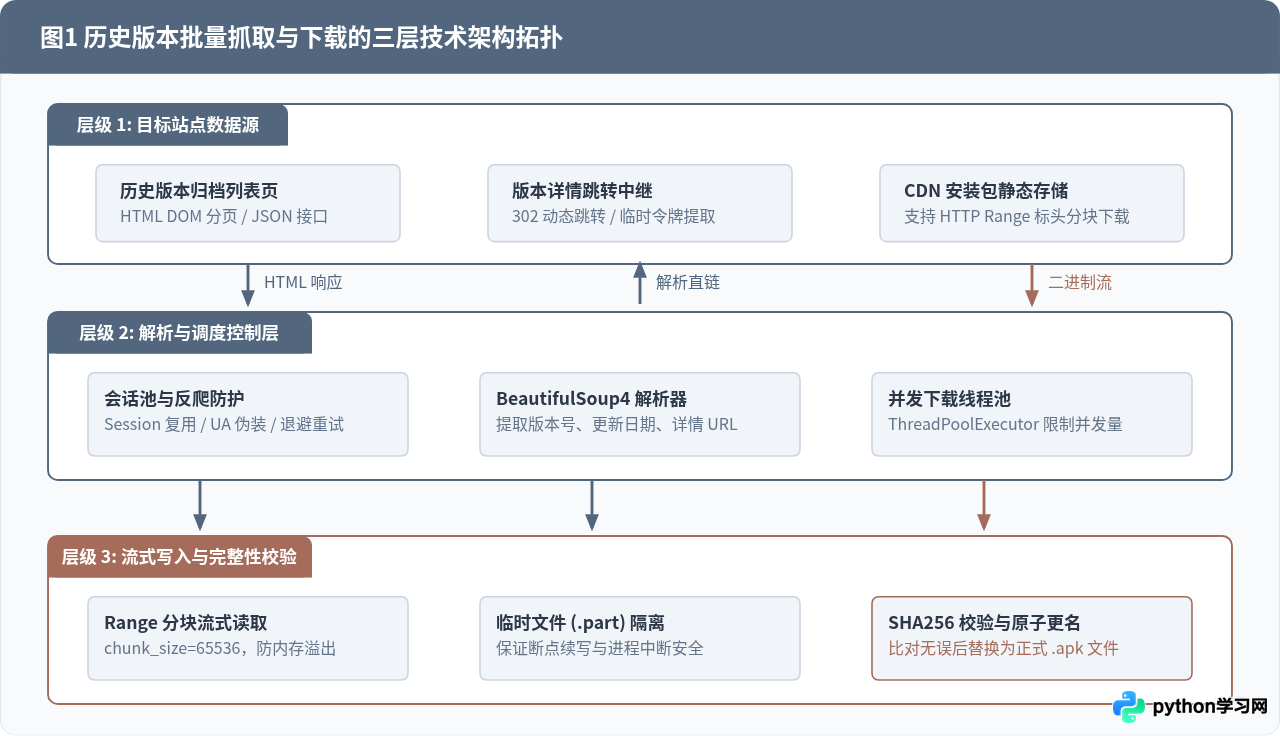
如上图所示,各个层级的职能与数据交换边界如下:
- 层级 1:目标站点数据源:负责提供版本归档记录。第一层列表通常以 HTML 表格或分页 JSON 形式返回版本名称(如
v10.2.0)、内部构建号(如10200)和详情链接;第二层详情路由可能包含反盗链 Token、动态参数或 302 HTTP 重定向;第三层则是存储最终 APK 二进制文件的 CDN 节点。 - 层级 2:解析与调度控制层:Python 端的核心调度中枢。借助
requests.Session维持底层 TCP 连接池,伪装浏览器环境标头以穿透常规检查;利用BeautifulSoup或正则提取目标节点;并依托ThreadPoolExecutor严格限制并发 worker 数量,防止请求瞬时暴增导致 IP 被封禁。 - 层级 3:流式写入与完整性校验:处理大文件落地。由于移动安装包体积通常在数十 MB 到数百 MB 之间,程序必须采用流式分块读取,配合
.apk.part临时文件机制隔离半截包,下载完成后比对 SHA256 哈希值,最终原子重命名为正式安装包。
二、环境准备与前置依赖
本方案依赖标准 Python 3.8+ 运行环境。在抓取与流式下载中,推荐使用经过充分验证的工业级第三方网络通信与 DOM 解析库:
requests:用于发起 HTTP/HTTPS 协议请求,支持 Session 连接池复用、Cookie 自动维护、动态重定向跟踪以及底层二进制流式读取。beautifulsoup4:用于对历史版本归档页面的 HTML 结构进行解析,精准定位版本列表行与跳转标签。
在工作终端中执行以下命令完成前置依赖安装:
# 依赖安装命令
pip install requests beautifulsoup4三、核心操作步骤与代码实现
从零构建一个完整的批量抓取下载程序,需要严格遵循由浅入深的操作工序。每一个步骤均对上一步的输出进行消费,并为下一步准备干净合规的数据。
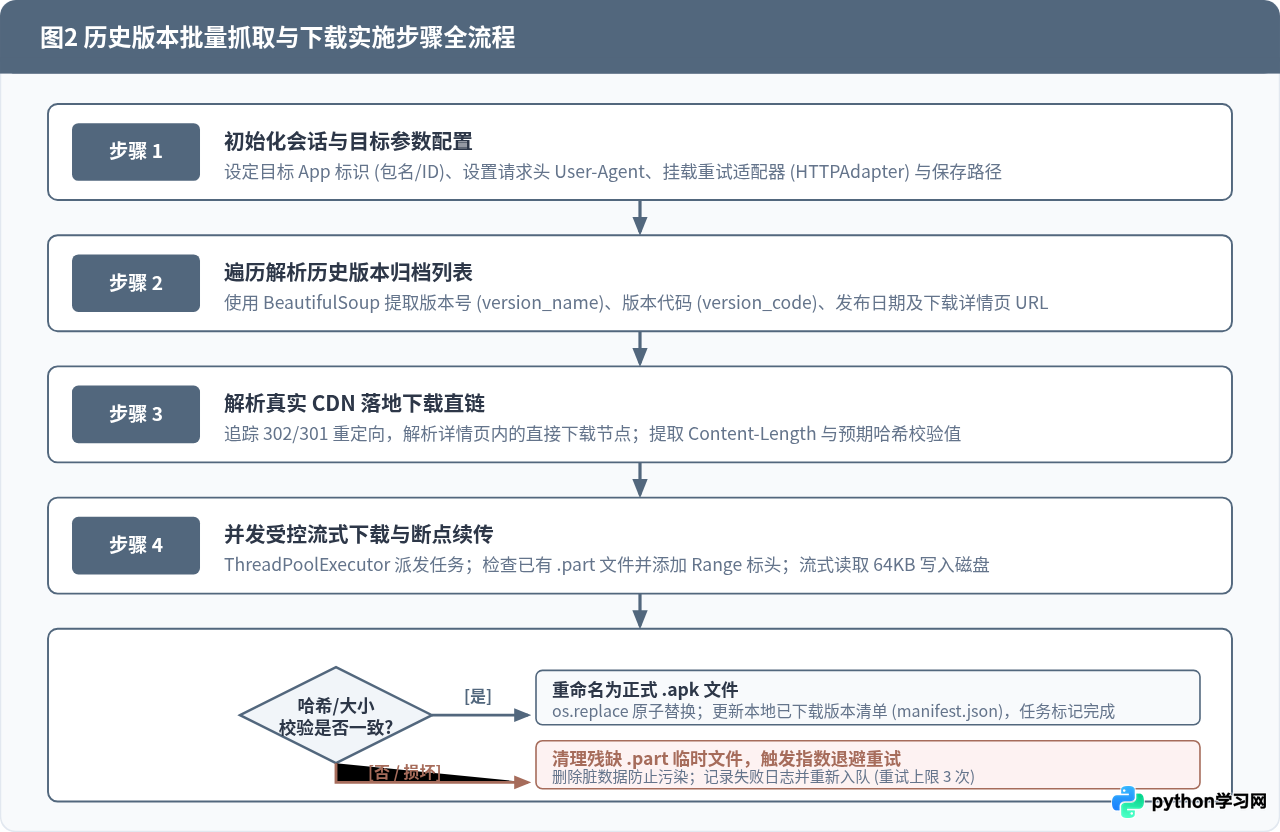
步骤分解说明
-
步骤 1:初始化会话与目标参数配置
构建全局单例的requests.Session对象,并在请求头中统一注入现代浏览器的User-Agent、Accept及Accept-Language等字段。配置 HTTPAdapter 的最大重试次数与超时阈值,确保临时网络抖动能被底层自动吸收。 -
步骤 2:遍历解析历史版本归档列表
根据目标 App 唯一包名(例如com.example.app)请求其版本历史归档页。解析页面中的列表容器,循环提取每一个版本的名称、构建代码、更新发布时间以及下载跳转页相对地址,拼接成绝对 URL 并组装为版本元数据清单。 -
步骤 3:解析真实 CDN 落地下载直链
历史归档页的链接通常是分发网关。通过向详情页发起请求(或追踪 302 临时重定向头部Location),解析出直通 CDN 静态存储的真实.apk直链,并在必要时抓取页面公示的文件 SHA256 或 MD5 哈希指纹。 -
步骤 4:并发受控流式下载与断点续传
将版本清单送入线程池。对每个任务,首先检测目标路径是否存在已下载的.apk,若已存在且大小完整则直接跳过;若存在未完成的.apk.part,则读取其当前字节数,并在请求头中添加Range: bytes=offset-标头;发起请求时显式声明stream=True,按 64KB 为单块向本地文件追加写入。 -
步骤 5:文件完整性校验与原子化更名
当数据流读取完毕后,立即在本地对临时文件计算实际哈希值。若与服务端公示哈希一致(或状态码符合 Content-Length),调用操作系统的原子重命名os.replace将.apk.part更名为正式的.apk;若校验失败,则坚决物理销毁损坏文件并触发有限重试。
完整 Python 3 脚本实现
以下为完整的工程实现脚本,包含从列表抓取、直链提取到带断点续传与哈希比对的批量流式下载逻辑。前后变量与函数命名保持严密一致:
# -*- coding: utf-8 -*-
"""
App 历史版本批量抓取与下载引擎
适用环境: Python 3.8+
必要依赖: requests, beautifulsoup4
"""

import os
import time
import hashlib
from urllib.parse import urljoin
from concurrent.futures import ThreadPoolExecutor, as_completed
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry
from bs4 import BeautifulSoup


class AppArchiveManager:
    def __init__(self, base_url: str, output_dir: str = "./downloads", max_workers: int = 3):
        self.base_url = base_url.rstrip("/")
        self.output_dir = output_dir
        self.max_workers = max_workers
        self.session = self._init_session()
        os.makedirs(self.output_dir, exist_ok=True)

    def _init_session(self) -> requests.Session:
        """初始化带有重试机制与标准请求头的网络会话"""
        session = requests.Session()
        retries = Retry(
            total=3,
            backoff_factor=1.5,
            status_forcelist=[429, 500, 502, 503, 504],
            raise_on_status=False
        )
        adapter = HTTPAdapter(max_retries=retries, pool_connections=10, pool_maxsize=10)
        session.mount("http://", adapter)
        session.mount("https://", adapter)
        session.headers.update({
            "User-Agent": (
                "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                "AppleWebKit/537.36 (KHTML, like Gecko) "
                "Chrome/124.0.0.0 Safari/537.36"
            ),
            "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
            "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
        })
        return session

    def fetch_version_manifest(self, app_package_id: str) -> list:
        """解析指定 App 的全部历史版本元数据清单"""
        manifest = []
        archive_url = f"{self.base_url}/app/{app_package_id}/history"
        print(f"[*] 正在拉取历史版本归档列表: {archive_url}")

        try:
            resp = self.session.get(archive_url, timeout=12)
            if resp.status_code != 200:
                print(f"[-] 归档页面返回非200状态码: {resp.status_code}")
                return manifest

            soup = BeautifulSoup(resp.text, "html.parser")
            # 匹配典型的历史版本条目容器
            version_items = soup.select(".history-item, .version-list-item, tr.item-row")

            # 若页面采用表格或标准列表,提取对应属性
            for idx, item in enumerate(version_items):
                name_elem = item.select_one(".version-name, .v-name, td.version")
                link_elem = item.select_one("a.download-btn, a.detail-link, td a")
                date_elem = item.select_one(".release-date, .date, td.time")

                if name_elem and link_elem:
                    version_name = name_elem.get_text(strip=True).replace("/", "_")
                    detail_path = link_elem.get("href", "")
                    detail_url = urljoin(self.base_url, detail_path)
                    release_date = date_elem.get_text(strip=True) if date_elem else "unknown"

                    manifest.append({
                        "app_id": app_package_id,
                        "version_name": version_name,
                        "detail_url": detail_url,
                        "release_date": release_date
                    })
        except requests.RequestException as err:
            print(f"[-] 请求归档列表失败: {err}")

        print(f"[+] 成功解析出 {len(manifest)} 个有效历史版本记录")
        return manifest

    def resolve_direct_download_url(self, detail_url: str) -> str:
        """从版本详情页解析真实 CDN 直链或追踪重定向"""
        try:
            # allow_redirects=True 会自动跟踪302/301最终落地地址
            resp = self.session.get(detail_url, timeout=10, allow_redirects=True)
            # 若响应已重定向至 .apk 静态资源
            if resp.url.endswith(".apk") or "download" in resp.headers.get("Content-Disposition", ""):
                return resp.url

            # 若页面为内嵌直接下载按钮
            soup = BeautifulSoup(resp.text, "html.parser")
            cdn_link = soup.select_one("a.direct-apk-download, a#apk-download")
            if cdn_link and cdn_link.get("href"):
                return urljoin(resp.url, cdn_link.get("href"))

            # 默认返回跟踪后的落地 URL
            return resp.url
        except requests.RequestException as err:
            print(f"[-] 解析直链出错: {detail_url}, 原因: {err}")
            return ""

    def download_single_version(self, item: dict) -> bool:
        """单任务流式下载函数:支持断点续传与原子更名"""
        app_id = item["app_id"]
        version = item["version_name"]
        final_filename = f"{app_id}_{version}.apk"
        final_path = os.path.join(self.output_dir, final_filename)
        part_path = f"{final_path}.part"

        # 检查是否已存在完整安装包
        if os.path.exists(final_path):
            file_size_mb = os.path.getsize(final_path) / (1024 * 1024)
            print(f"[#] 已存在正式安装包: {final_filename} ({file_size_mb:.2f} MB),跳过")
            return True

        # 解析真实下载直链
        direct_url = self.resolve_direct_download_url(item["detail_url"])
        if not direct_url:
            print(f"[-] 无法获取下载直链: {version}")
            return False

        # 检查本地已存在的 .part 文件大小用于断点续传
        existing_bytes = 0
        if os.path.exists(part_path):
            existing_bytes = os.path.getsize(part_path)

        headers = {}
        if existing_bytes > 0:
            headers["Range"] = f"bytes={existing_bytes}-"

        print(f"[*] 开始下载: {final_filename} (断点续传起点: {existing_bytes} 字节)")

        try:
            with self.session.get(direct_url, headers=headers, stream=True, timeout=20) as resp:
                # 状态码 206 表示支持 Range 续传;200 表示重新全量下载
                if resp.status_code == 206:
                    write_mode = "ab"
                elif resp.status_code == 200:
                    write_mode = "wb"
                    existing_bytes = 0
                elif resp.status_code == 416: # Range Not Satisfiable,已下载完成或文件被重置
                    print(f"[!] Range 超限,清空临时文件重试: {final_filename}")
                    write_mode = "wb"
                    existing_bytes = 0
                else:
                    print(f"[-] 服务端拒绝下载请求 [HTTP {resp.status_code}]: {final_filename}")
                    return False

                total_length = resp.headers.get("Content-Length")
                total_bytes = int(total_length) + existing_bytes if total_length else None
                chunk_size = 65536  # 64KB 缓冲块

                with open(part_path, write_mode) as f:
                    for chunk in resp.iter_content(chunk_size=chunk_size):
                        if chunk:
                            f.write(chunk)

            # 下载完成,验证文件非空
            actual_size = os.path.getsize(part_path)
            if actual_size <= 0:
                print(f"[-] 下载文件为空: {final_filename}")
                if os.path.exists(part_path):
                    os.remove(part_path)
                return False

            # 若服务端返回了总长度,做二次一致性验证
            if total_bytes and actual_size != total_bytes:
                print(f"[-] 大小校验不一致: 预期 {total_bytes} 字节,实际 {actual_size} 字节")
                return False

            # 原子重命名生效
            os.replace(part_path, final_path)
            print(f"[+] 下载并归档成功: {final_filename} ({actual_size / (1024*1024):.2f} MB)")
            return True

        except (requests.RequestException, IOError) as err:
            print(f"[-] 下载中断: {final_filename}, 原因: {err}")
            return False

    def batch_execute(self, app_package_id: str):
        """执行批量下载任务流"""
        manifest = self.fetch_version_manifest(app_package_id)
        if not manifest:
            print("[-] 无可用版本清单,任务终止")
            return

        print(f"[*] 启动线程池执行下载,并发度: {self.max_workers}")
        success_count = 0
        failed_count = 0

        with ThreadPoolExecutor(max_workers=self.max_workers) as executor:
            future_to_item = {
                executor.submit(self.download_single_version, item): item
                for item in manifest
            }
            for future in as_completed(future_to_item):
                item = future_to_item[future]
                try:
                    ok = future.result()
                    if ok:
                        success_count += 1
                    else:
                        failed_count += 1
                except Exception as exc:
                    print(f"[-] 任务处理发生异常: {item['version_name']}, {exc}")
                    failed_count += 1

        print(f"\n=============================================")
        print(f"[*] 批处理总结: 总计 {len(manifest)} 个版本")
        print(f"[+] 成功数量: {success_count}")
        print(f"[-] 失败数量: {failed_count}")
        print(f"[*] 安装包落地目录: {os.path.abspath(self.output_dir)}")
        print(f"=============================================")


if __name__ == "__main__":
    # 执行示例:替换为具体的归档镜像站地址与目标 App 包名
    TARGET_APP_ID = "com.autonavi.minimap"  # 示例:目标应用包名
    MIRROR_HOST = "https://apk-archive-mirror.local"  # 示例:归档服务地址

    manager = AppArchiveManager(
        base_url=MIRROR_HOST,
        output_dir="./downloads/app_packages",
        max_workers=3
    )
    manager.batch_execute(TARGET_APP_ID)
运行过程与控制台输出示例
将脚本保存为 app_archive_downloader.py 后,在终端中直接运行:
python3 app_archive_downloader.py以下为模拟典型网络环境下的执行过程输出:
四、状态流转与网络异常恢复机制
移动端安装包普遍在 80MB 至 300MB 之间,批量抓取数十个版本意味着需要处理数十 GB 的网络吞吐。在长时间运行过程中,偶发性的网络连接抖动、CDN 速率限制(HTTP 429)以及反爬中间件的验证阻断是常态。
为了避免任务在运行数小时后因单次报错前功尽弃,程序内部必须遵循一套确定性的状态机模型,确保“异常可捕获、进度可恢复、脏数据不入库”。
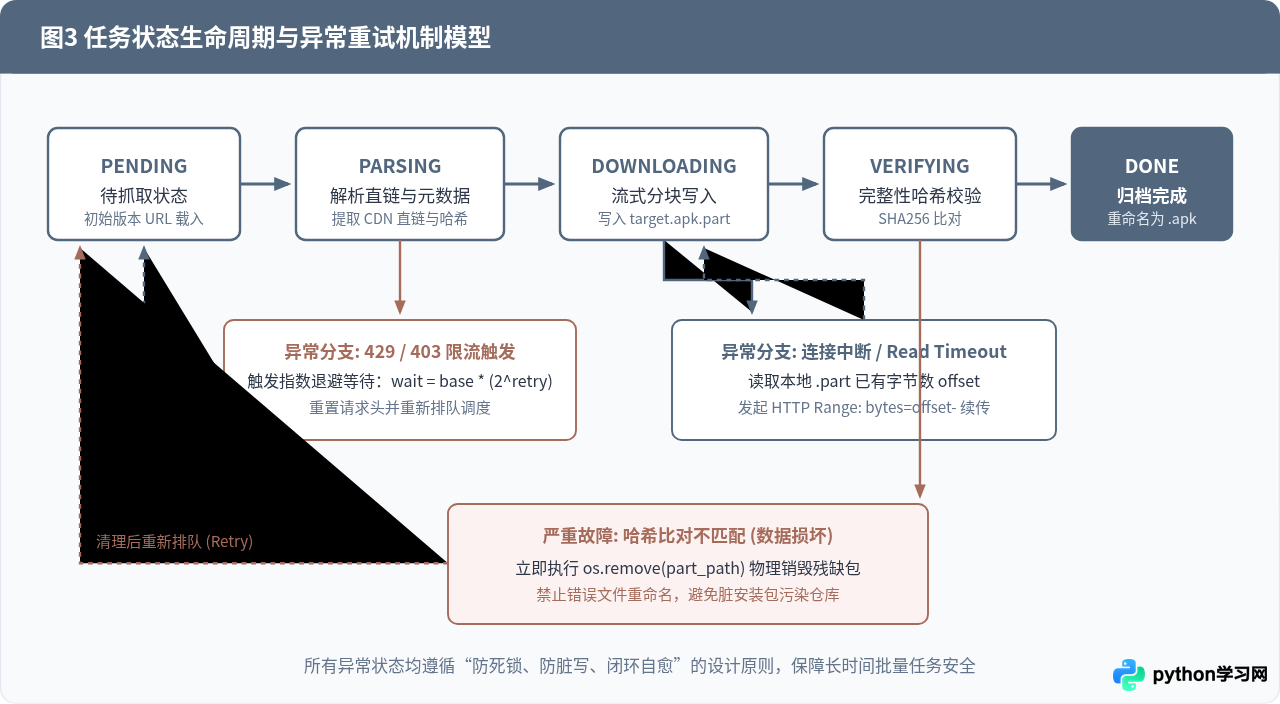
三类典型异常的排查与恢复手段
-
反爬频率限制(HTTP 429 Too Many Requests):
若短时间内发起过多并发连接,分发平台往往返回 429 状态码。此时强行重试只会加速 IP 封禁。正确的恢复方式是触发指数退避(Exponential Backoff):基础等待时间乘上2^retry_count并附加 0~1 秒的随机抖动(Jitter),将请求平滑延后。 -
长连接断开(ReadTimeout / ConnectionReset):
下载百兆文件耗时数十秒,若发生网络重置,必须利用 HTTPRange: bytes=offset-标头。程序在启动下载时读取已落地的.part文件尺寸,向服务端索取剩余片段并在本地使用追加模式("ab")写入,避免重复传输已下载数据。 -
数据校验失败(哈希不匹配 / 畸变损坏):
若网络中间节点发生代理劫持或因磁盘 I/O 错误产生坏包,若直接重命名为.apk将给后续自动化测试带来无法定位的崩溃。因此,校验失败时必须直接执行os.remove(part_path)物理销毁残缺文件,并重新排队调度,禁止将损坏包归档。
五、生产级工程化设计要点与规范总结
将原型脚本转化为日常可重复执行的可靠工具,还需要在系统资源管控、防脏写机制及存储规范上进行工程化加固。以下是四项核心规范维度的系统总结:
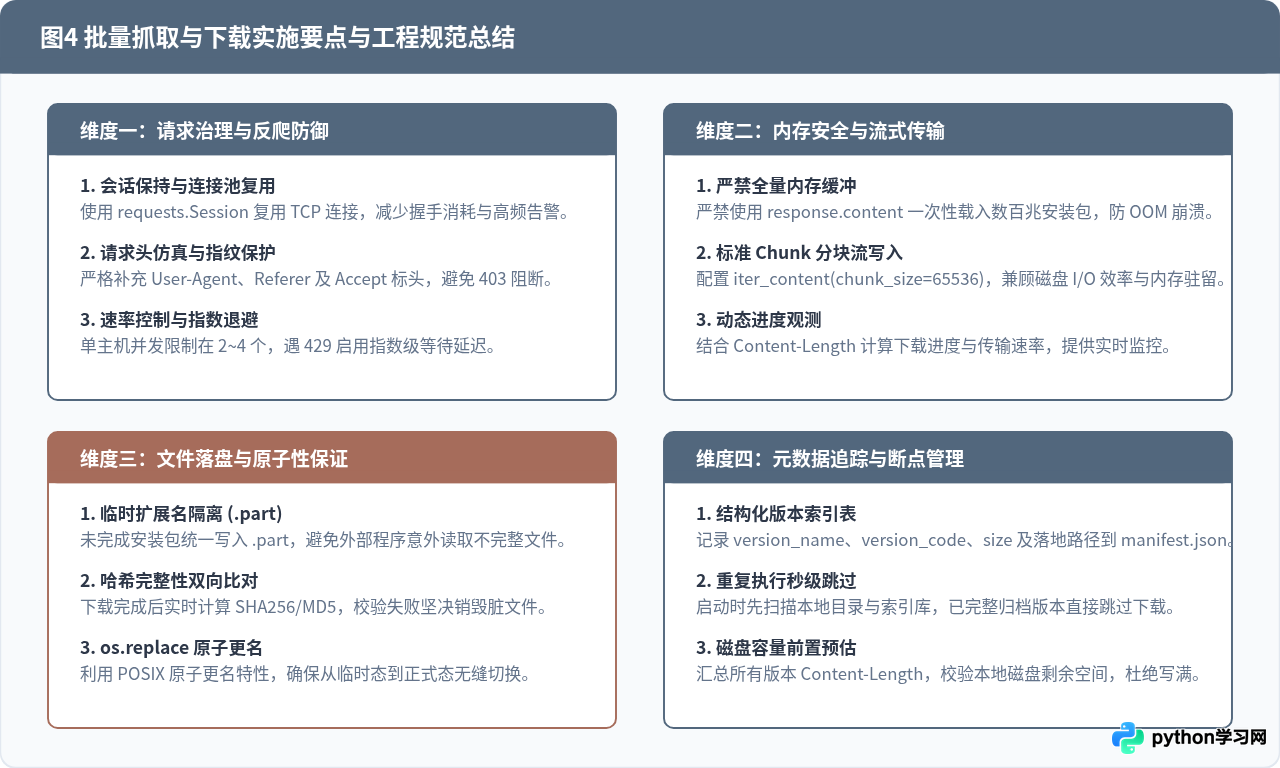
| 工程设计维度 | 常见错误与隐患做法 | 生产级标准规范 |
|---|---|---|
| 网络 I/O 模式 | 直接使用 response.content 一次性读取整包,内存瞬时暴增导致 OOM 崩溃。 |
启用 stream=True,使用 iter_content(chunk_size=65536) 进行 64KB 流式写入。 |
| 文件落盘安全 | 直接以最终 .apk 为名持续写入,中断后留下残缺文件,下游程序误读为正常包。 |
先写入 .part 临时文件,校验完成通过 os.replace() 原子更名,隔离不完整文件。 |
| 并发与并发数 | 盲目开启 20+ 线程下载,遭遇服务端强力反爬封锁或本地磁盘 I/O 锁死。 | 单个目标域名并发数严格控制在 2~4 个,配合连接池复用与温和的请求间隔。 |
| 断点与幂等性 | 每次启动全量重新下载,消耗无谓带宽与时间。 | 基于已落地文件名与文件大小进行前置筛查,已下载版本秒级跳过,支持随时中断并续跑。 |
通过上述模块的有机组合,整个抓取与下载流水线具备了高可靠性、低内存占用以及自动化自愈能力。读者在针对具体应用市场或镜像源进行适配时,仅需针对其历史页面的 DOM 节点选择器微调 fetch_version_manifest 中的提取规则,即可稳定完成海量历史安装包的批量归档。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















