


想转行数据分析,该去哪些Python学习网站补课
针对想转行数据分析的初学者,解析Python补课的核心知识边界、四类主流学习网站的选择策略以及从语法到实战项目的落地三步走方法。
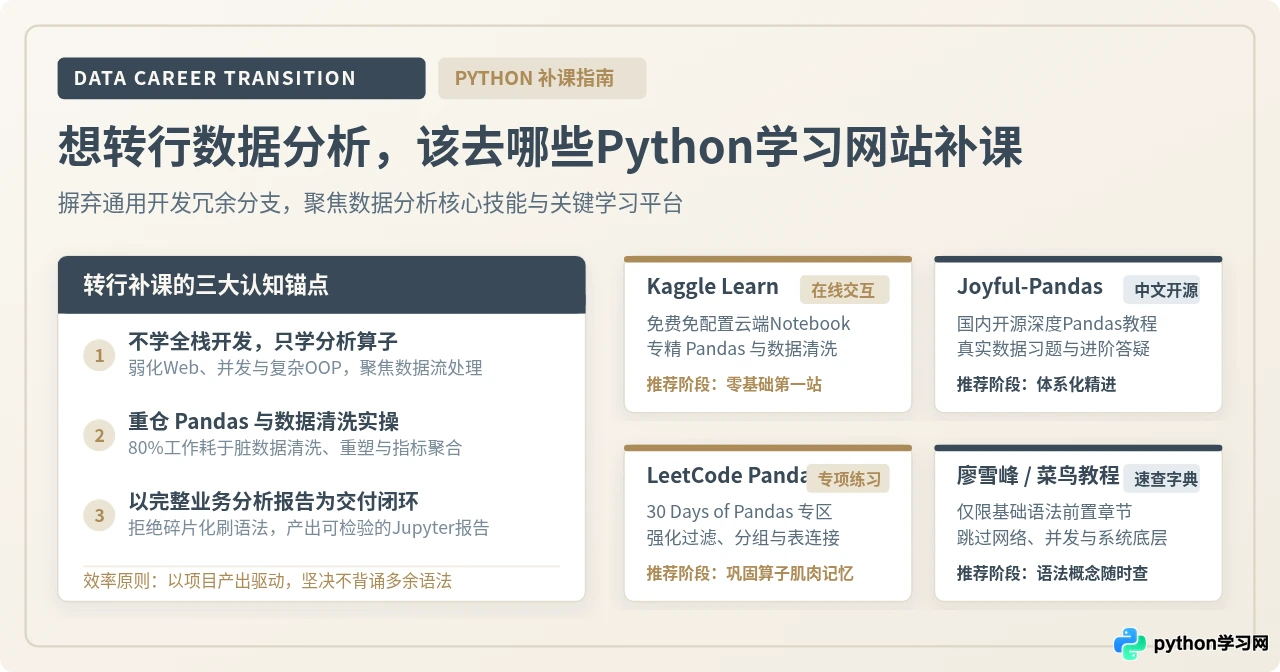
一、补课前必须厘清的 Python 技能边界
很多转行者在自学初期犯下的最大错误,就是随便在搜索引擎里输入“Python 基础教程”,然后顺着目录从头看到尾。通用软件开发路线通常会花大量篇幅讲解深层面向对象设计、网络 Socket 通信、多线程与多进程、GUI 界面开发以及 Django 或 Flask 等 Web 框架。这些内容对后端工程师至关重要,但对数据分析师而言,前期投入这些方向只会严重拖慢求职节奏。
数据分析岗位的代码核心场景非常专一:读取业务数据库导出或爬取的表格数据,排查缺失值与脏字符,基于特定口径进行分组统计、时间维度切片,并输出能够辅助业务决策的可视化图表。因此,转行补课时需要有意识地做知识裁剪。
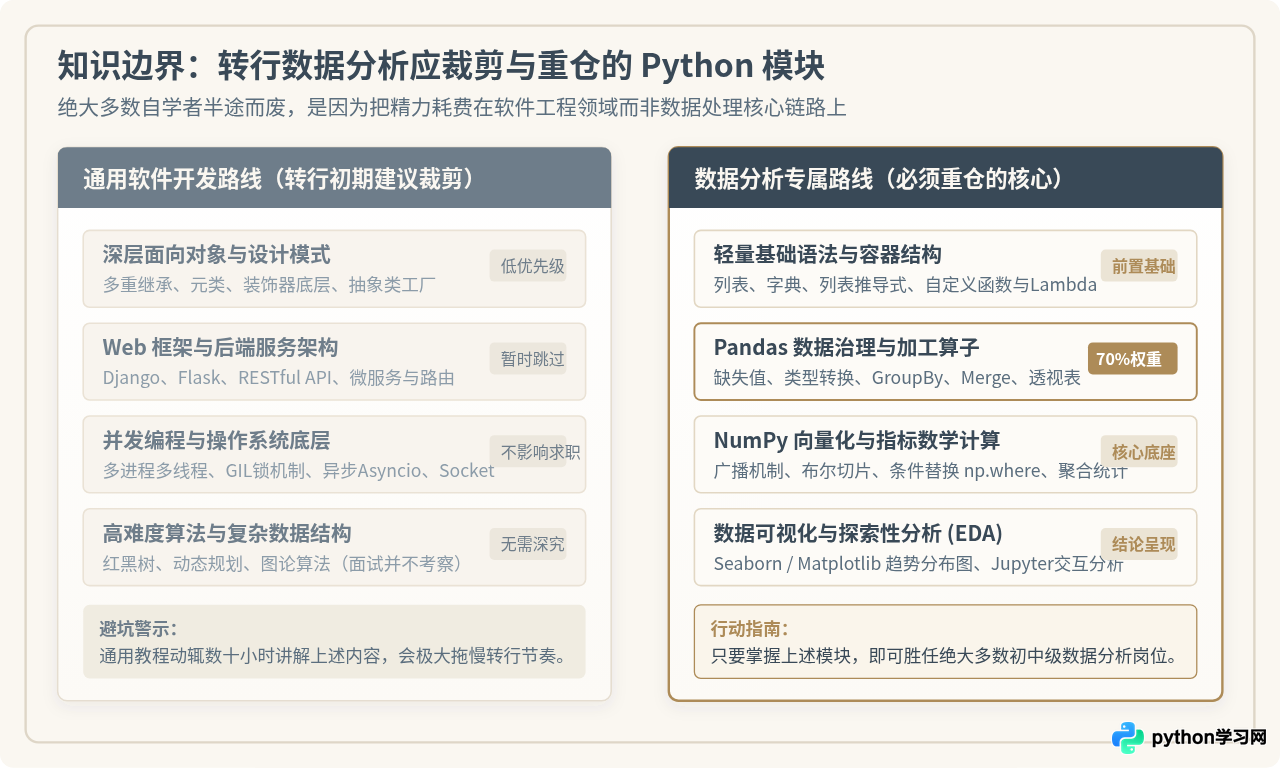
在进入具体网站之前,建议读者将注意力收敛在以下三个模块上:
- 精简的语言基础(占比约 20%):变量、布尔判断、列表(List)、字典(Dict)、列表推导式以及基础函数定义
def。至于类与对象,只需理解如何调用现有库的方法即可,无须深究继承或元类。 - 核心数据处理库(占比约 60%):重仓
Pandas与NumPy。数据分析工作中 80% 的编码时间都在与 Pandas 的 DataFrame 打交道,包括索引切片、缺失值填充、分组聚合(groupby)、表关联(merge)以及数据透视(pivot_table)。 - 探索性数据可视化(占比约 20%):掌握
Matplotlib与Seaborn的基础图表绘制,能够根据分析目的选择折线图(趋势)、柱状图(对比)、箱线图(分布离散)及散点图(相关性)。
二、四类主流 Python 学习网站的定位与精准推荐
不同网站在教学形式、侧重领域和难度进阶上存在显著差异。盲目在论坛或视频弹幕推荐中随波逐流容易导致“眼高手低”。根据转行数据分析的实际诉求,推荐以下四类针对性突出的优质站点:
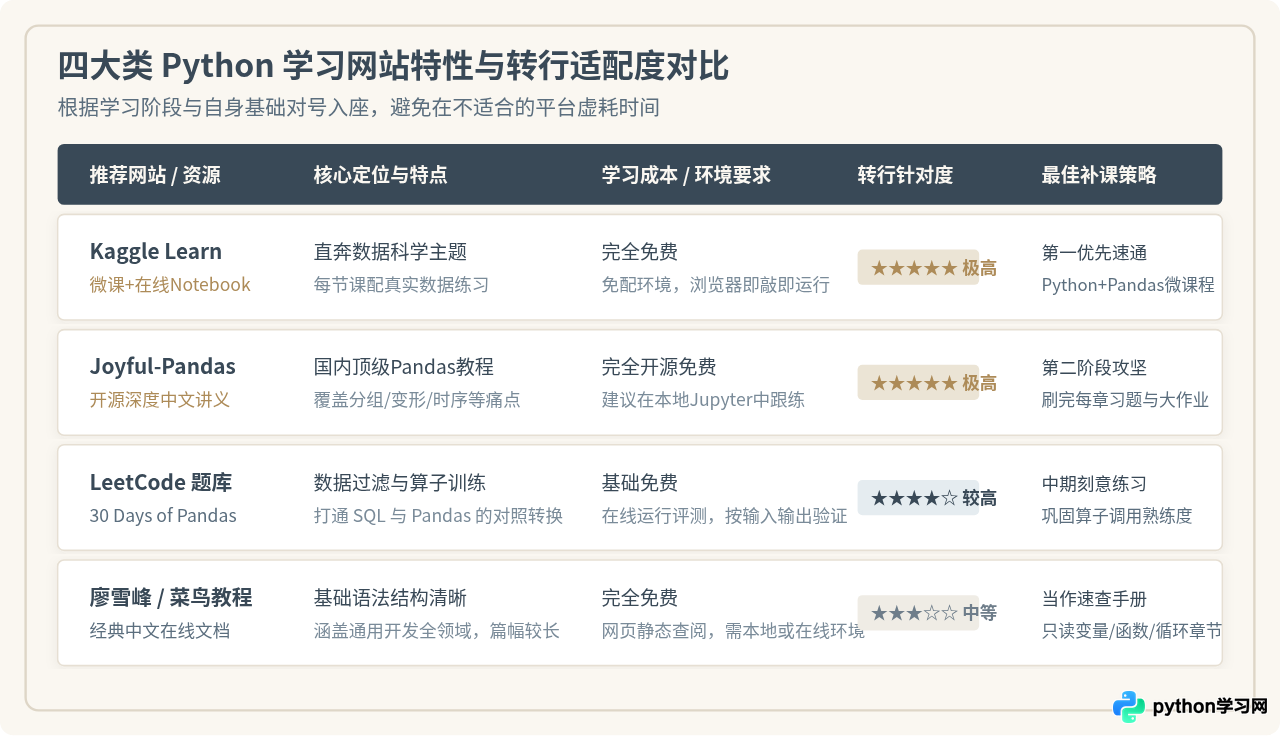
1. Kaggle Learn:免费、免配置、直奔数据科学主题的轻量微课
网址定位:全球知名数据科学竞赛平台 Kaggle 推出的免费微课程体系。
适用场景:零基础转行者最容易被本地环境配置(如 Python 安装包路径配置、环境变量、依赖冲突等)劝退。Kaggle Learn 的所有课程均直接在浏览器云端 Jupyter Notebook 中运行,打开网页即可一边阅读讲解,一边在对应的单元格中敲写代码并实时验证输出。
核心推荐章节:
Python:耗时约 4~6 小时,涵盖基础算术、函数、列表、字典及外部库调用的核心概念,剔除了一切与数据无关的冗余内容。Pandas:耗时约 4 小时,从创建与读取开始,重点演练索引筛选、汇总函数、Maps、Grouping & Sorting、数据类型与缺失值、重命名与组合(Renaming and Combining)。Data Cleaning:专讲现实中脏数据的处理策略,包括缺失值插补、缩放与正态化、日期格式解析及字符编码错误处理。
2. Joyful-Pandas(开源讲义):深入掌握 Pandas 的国内标杆读本
网址定位:由国内知名开源数据科学社区 Datawhale 发起的全面 Pandas 中文实战讲义。
适用场景:当读者在交互式平台上跑通了基础命令后,往往会发现面对实际业务数据依然无从下手,例如多级索引如何取数、长宽表如何互换、时序数据如何按自然周重采样等。Joyful-Pandas 采用纯中文撰写,内容条理极其细致,且每章末尾都附带来自真实业务场景的练习题与大作业。
补课建议:建议读者在本地搭建 JupyterLab 或使用 Google Colab,将该教程克隆或复制后,逐行手工运行其中的代码块,并独立完成每章的思考题。攻克完其分组、变形、合并与时序四章,便足以应付 90% 以上的工作数据处理需求。
3. LeetCode(30 Days of Pandas 专区):强化算子熟练度的刻意练习场
网址定位:算法刷题平台 LeetCode 针对数据分析方向专门推出的 Pandas 专题题库。
适用场景:很多从 SQL 或 Excel 转过来的同学,容易出现“逻辑知道但写不出 Pandas 算子”的卡顿。LeetCode 的 Pandas 题库将原本考察 SQL 的业务场景(如计算第二高薪水、重构部门表格、筛选有效客户等)全量支持了 Pandas 提交。
核心收益:通过自动化的输入用例与输出检验,迫使学习者摆脱对教程的依赖,建立“输入 DataFrame → 算子转换 → 目标结构”的代码直觉,同时能清晰体会 SQL 算子(如 GROUP BY、LEFT JOIN、WHERE)在 Pandas 中对应的 .groupby()、.merge(how='left')、布尔切片语法。
4. 廖雪峰 Python 教程与菜鸟教程:仅作“概念快速查阅字典”
网址定位:老牌中文系统化基础语法教程。
适用场景:对于英语基础薄弱、初次接触编程逻辑的学习者,当在其他平台遇到如“什么是可变对象与不可变对象”、“字典的 get() 方法与键访问有什么区别”等基本语法疑问时,这类中文站点是合格的备查字典。
特别提醒:切忌把廖雪峰教程从头读到尾。只需阅读其前置语法部分(数据类型、条件循环、函数参数),一旦出现“面向对象高级编程、模块发布、网络编程、多进程、Web 开发”等章节,请立即跳过,迅速切换至 Pandas 专门教程。
三、转行补课的三步走实操路线与交付物
掌握了推荐网站之后,如何安排时间节奏是决定能否顺利落地的关键。建议读者采用为期 4~6 周的高效冲刺模型,每个阶段以明确的“交付物”作为检验标准:
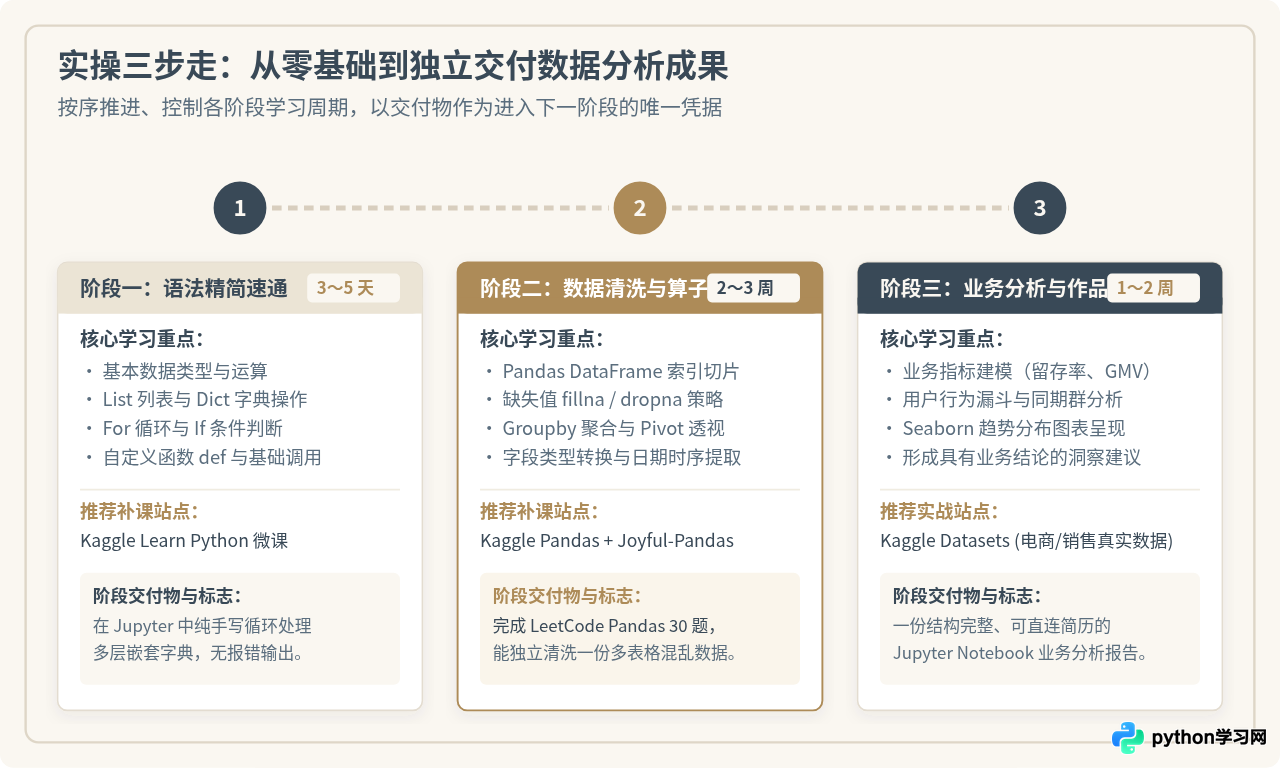
第一阶段:语法精简速通(3~5 天)
学习任务:在 Kaggle Learn 或廖雪峰教程中,快速刷完变量、数据类型、列表、字典、循环和基础函数。不强求死记硬背每个内置方法,只要明白基本逻辑即可。
检验标准:能够不看教程,在 Jupyter 中独立写出一个脚本:遍历一个包含若干订单字典的列表,统计出特定状态订单的总金额与平均客单价。
# 示例:不用第三方库,纯原生语法统计订单金额
orders = [
    {"order_id": "A101", "status": "completed", "amount": 240.5},
    {"order_id": "A102", "status": "canceled", "amount": 99.0},
    {"order_id": "A103", "status": "completed", "amount": 510.0},
    {"order_id": "A104", "status": "completed", "amount": 120.0}
]

completed_amounts = [item["amount"] for item in orders if item["status"] == "completed"]
total_gmv = sum(completed_amounts)
avg_order_value = total_gmv / len(completed_amounts) if completed_amounts else 0

print(f"有效订单总额: {total_gmv:.2f}, 平均客单价: {avg_order_value:.2f}")
# 示例输出:有效订单总额: 870.50, 平均客单价: 290.17
第二阶段:数据清洗与算子专攻(2~3 周)
学习任务:主攻 Kaggle Learn 的 Pandas 与 Joyful-Pandas。熟练掌握使用 pd.read_csv() 读取数据、处理缺失值(isna()、fillna())、转换日期时序(pd.to_datetime()),以及多维度聚合运算。
检验标准:完成 LeetCode Pandas 专项 30 题,且能独立运用 pivot_table 与 groupby 生成各类层级交叉报表。
import pandas as pd
import numpy as np

# 构建包含脏数据的示例销售记录
data = {
    "user_id": [101, 102, 103, 104, 105, 101],
    "pay_time": ["2026-03-01", "2026-03-01", "2026-03-02", "invalid_date", "2026-03-03", "2026-03-01"],
    "channel": ["App", "Web", "App", "App", np.nan, "App"],
    "sales": [128.0, 256.0, np.nan, 88.0, 310.0, 128.0]
}

df = pd.DataFrame(data)

# 1. 剔除完全重复行
df = df.drop_duplicates()

# 2. 转换日期并过滤非法记录
df["pay_time"] = pd.to_datetime(df["pay_time"], errors="coerce")
df = df.dropna(subset=["pay_time"])

# 3. 缺失值填充与类型统一
df["channel"] = df["channel"].fillna("Unknown")
df["sales"] = df["sales"].fillna(df["sales"].median())

# 4. 按渠道汇总计算指标
channel_summary = df.groupby("channel").agg(
    order_count=("user_id", "count"),
    total_sales=("sales", "sum"),
    avg_sales=("sales", "mean")
).reset_index()

print(channel_summary)
# 示例输出:
#    channel  order_count  total_sales  avg_sales
# 0      App            2        256.0      128.0
# 1      Web            1        256.0      256.0
第三阶段:真实业务数据集实战与分析报告产出(1~2 周)
学习任务:在 Kaggle Datasets 或公开电商、餐饮销售数据集中挑选一份真实数据,围绕具体业务问题(例如“某电商平台用户流失归因分析”或“商品品类促销转化率洞察”)进行完整的探索性分析(EDA)。
检验标准:产出一份包含背景假设、数据清洗过程、聚合指标对比、Seaborn 可视化图表以及明确文字分析结论的 Jupyter Notebook 文件。这份文件将直接作为转行求职面试时的作品集附录。
四、转行自学常见的 4 个致命误区与避坑指南
许多转行者投入了大量精力却收效甚微,往往不是因为不够努力,而是踩中了典型的认知陷阱:
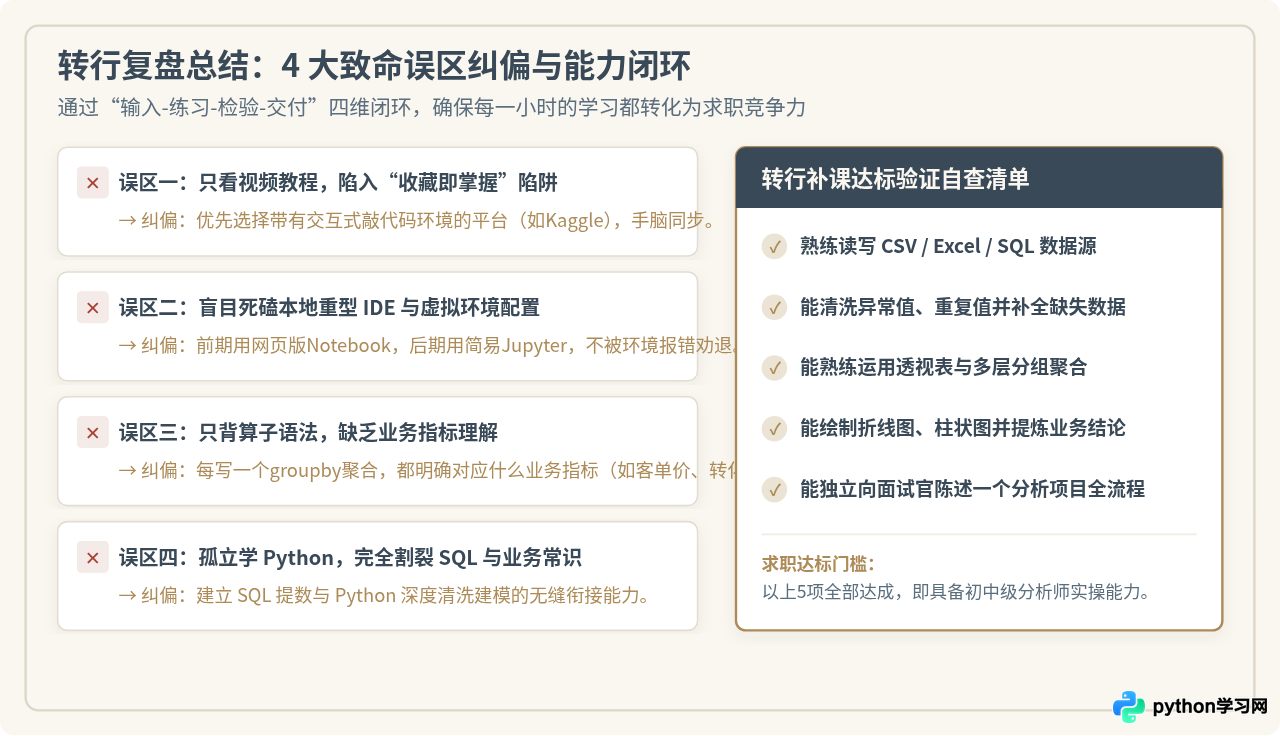
- 误区一:只看视频不写代码,陷入“教程虚假满足感”。看视频时往往觉得代码顺理成章,一旦打开空白编辑器却连导入库都拼错。必须保证“敲代码的时间至少是看教程时间的 2 倍以上”,坚决在交互式环境中手敲练习。
- 误区二:盲目死磕复杂的本地 IDE 配置。新手常常因为 Anaconda 路径配错、pip 镜像源超时或者 PyCharm 虚拟环境关联失败折腾整整几天,耗尽学习热情。在刚开始补课的 2 周内,请优先使用 Kaggle 在线环境或 Google Colab,把精力集中在语法和数据处理本身。
- 误区三:只记函数算子,缺乏业务指标思维。数据分析的核心是“用数据回答业务问题”。在学习每个 Pandas 函数时,都要思考它对应什么业务场景。例如学习
shift()时要想到计算日环比、周同比;学习cummax()时要联想到最大回撤与生命周期峰值。 - 误区四:孤立学 Python,完全割裂 SQL。在绝大多数企业的实际工作流中,第一步永远是用 SQL 在数据仓库中做初步过滤与提取,第二步才是在 Python 中做复杂统计建模与精细化清洗。补课 Python 的同时,务必保持与 SQL 语法的对照映射,避免出现“会写 Pandas 却不会写 SQL”的求职断层。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















