


Python读取CSV中文乱码怎么办?encoding编码设置指南
针对Python读取CSV文件时常见的中文乱码问题与UnicodeDecodeError报错,详细梳理UTF-8、UTF-8-SIG、GBK及GB18030的编码机制,提供标准库csv与Pandas的encoding参数配置方案、排查四步法与选型速查。
UnicodeDecodeError,本质上是“文件写入时使用的二进制编码格式”与“读取时指定的解码格式”不一致。只需在 open() 函数或 pandas.read_csv() 中显式传入匹配的 encoding 参数(最常见为 utf-8、utf-8-sig、gbk 或 gb18030),即可彻底解决乱码问题。
一、为什么会发生中文乱码?核心原理解析
CSV(Comma-Separated Values)本质上是一个纯文本文件。计算机在硬盘上存储任何文本时,都必须先将其转换为一系列 0 和 1 组成的二进制字节(Byte)。当我们读取文件时,程序又需要按照某种对照规则将字节还原成字符,这个过程叫做“解码”(Decoding)。
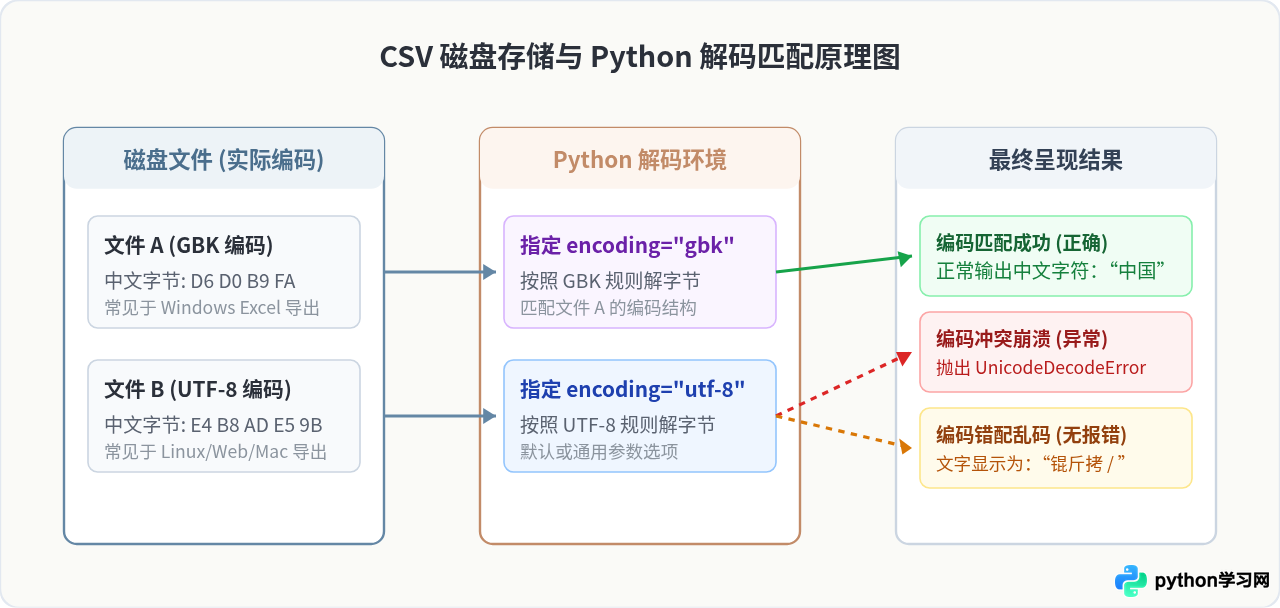
Python 3 默认在读取文本文件时采用系统的默认编码(在 Windows 下通常是系统的 ANSI 代码页,如 CP936;在 Linux 和 macOS 下通常是 UTF-8)。乱码或解码崩溃通常发生在以下几种典型情形:
- 用 UTF-8 解码 GBK 编码的文件:GBK 编码采用双字节表示中文字符,若其字节组合不符合 UTF-8 的多字节前缀规则,Python 解码器会直接中断并抛出
UnicodeDecodeError: 'utf-8' codec can't decode byte ...。 - 用 GBK 解码 UTF-8 编码的文件:UTF-8 的中文字节被强行拆解为 GBK 双字节,通常不会直接报错,但文字会显示为完全无法阅读的混乱字符(如“æµè¯•”或“锟斤拷”)。
- 未处理 UTF-8 BOM 标记:Windows 平台下的 Excel 导出 CSV 时,常在文件开头加入 3 个不可见字节
\xef\xbb\xbf(称为 Byte Order Mark,BOM)。若用普通的utf-8读取,第一个字段的列名会被解析为\ufeff姓名,导致通过列名索引字段时 KeyError。
二、Python 标准库读取 CSV 的 encoding 设置
使用 Python 原生内置的 csv 模块时,其本身并不直接负责打开物理文件,而是依赖内建的 open() 函数。因此,编码设置的关键在于 open() 中的 encoding 形参。
1. 标准规范写法
强烈建议始终在 open() 中显式指定 encoding,不要依赖系统默认值。例如读取标准的 UTF-8 文件:
import csv

# 显式指定 encoding='utf-8',避免不同操作系统默认编码差异
with open('data_utf8.csv', mode='r', encoding='utf-8', newline='') as f:
    reader = csv.reader(f)
    for row in reader:
        print(row)
2. 处理中文 Windows 环境导出的 CSV(GBK 与 GB18030)
如果 CSV 文件由简体中文版 Microsoft Excel 直接点击“另存为 CSV”生成,其默认采用的编码通常为 ANSI(在简体中文 Windows 下为 GBK / CP936)。在读取此类文件时,应将 encoding 设为 gbk 或更推荐的 gb18030:
import csv

# 推荐使用 gb18030,它是 GBK 的超集,包含更多生僻汉字和少数民族字符
with open('excel_export.csv', mode='r', encoding='gb18030', newline='') as f:
    reader = csv.DictReader(f)
    for row in reader:
print(row)GB18030 是中国国家强制标准,完全向后兼容 GBK 和 GB2312。部分人名、地名、特殊符号(如“镕”、“赟”、“䶮”等)在 GBK 中不存在,读取时会抛出异常;改用 gb18030 即可顺利解码并完全规避此类生僻字报错。
3. 消除首列 BOM 头:utf-8-sig
如果 Excel 在导出时选用了“CSV UTF-8 (逗号分隔) (*.csv)”,Excel 会在文件起始插入 3 个字节的 BOM 头。使用 encoding='utf-8' 读取时,虽然不会报错,但首个字段会被附加 \ufeff,例如字典键会变成 '\ufeff姓名' 而不是 '姓名'。此时必须使用专门的 utf-8-sig:
with open('excel_utf8_bom.csv', mode='r', encoding='utf-8-sig', newline='') as f:
    reader = csv.DictReader(f)
    # 输出表头列表,首列不再带有 \ufeff 前缀
    print(reader.fieldnames)
三、Pandas 库中的 encoding 参数设置与容错处理
在数据分析领域,Pandas 的 pd.read_csv() 是读取 CSV 的主力工具。它的底阶核心解析器默认使用 utf-8,如果遇到其他编码的文件,同样会直接抛出 UnicodeDecodeError。
1. Pandas 基础编码参数调用
import pandas as pd

# 场景 1:读取标准 UTF-8 文件
df_utf8 = pd.read_csv('data.csv', encoding='utf-8')

# 场景 2:读取带有 BOM 的 Excel UTF-8 文件
df_sig = pd.read_csv('data_excel_bom.csv', encoding='utf-8-sig')

# 场景 3:读取 Windows Excel 默认 ANSI/GBK 导出的 CSV
df_gbk = pd.read_csv('data_excel_ansi.csv', encoding='gb18030')
2. 紧急容错参数:encoding_errors(谨慎使用)
在 Pandas 1.3.0 及更高版本中,pd.read_csv() 新增了 encoding_errors 参数(对应底层 Python 解码错误处理机制)。当文件中混入了少量受损或无法识别的脏字节时,可以通过该参数防止程序直接崩溃:
# 遇到无法解码的损坏字节时,替换为官方占位符(通常是 ? 或 ),不中断程序
df_replace = pd.read_csv('dirty_data.csv', encoding='gb18030', encoding_errors='replace')

# 直接忽略并跳过无法解码的字节(存在字符丢失风险,不推荐用于正式数据核算)
df_ignore = pd.read_csv('dirty_data.csv', encoding='utf-8', encoding_errors='ignore')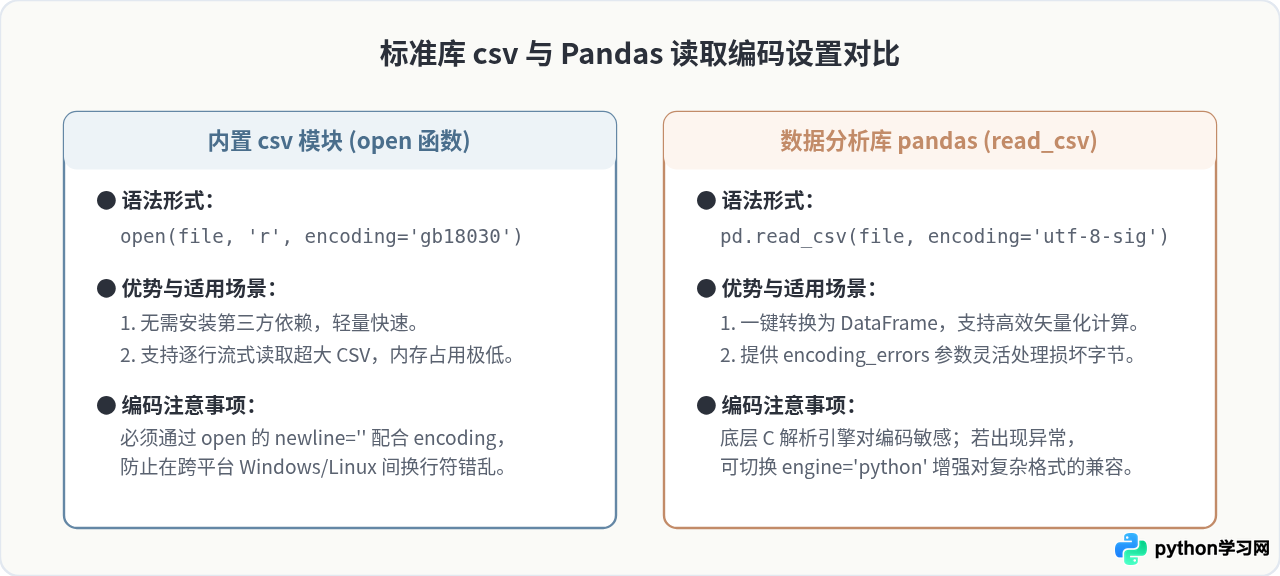
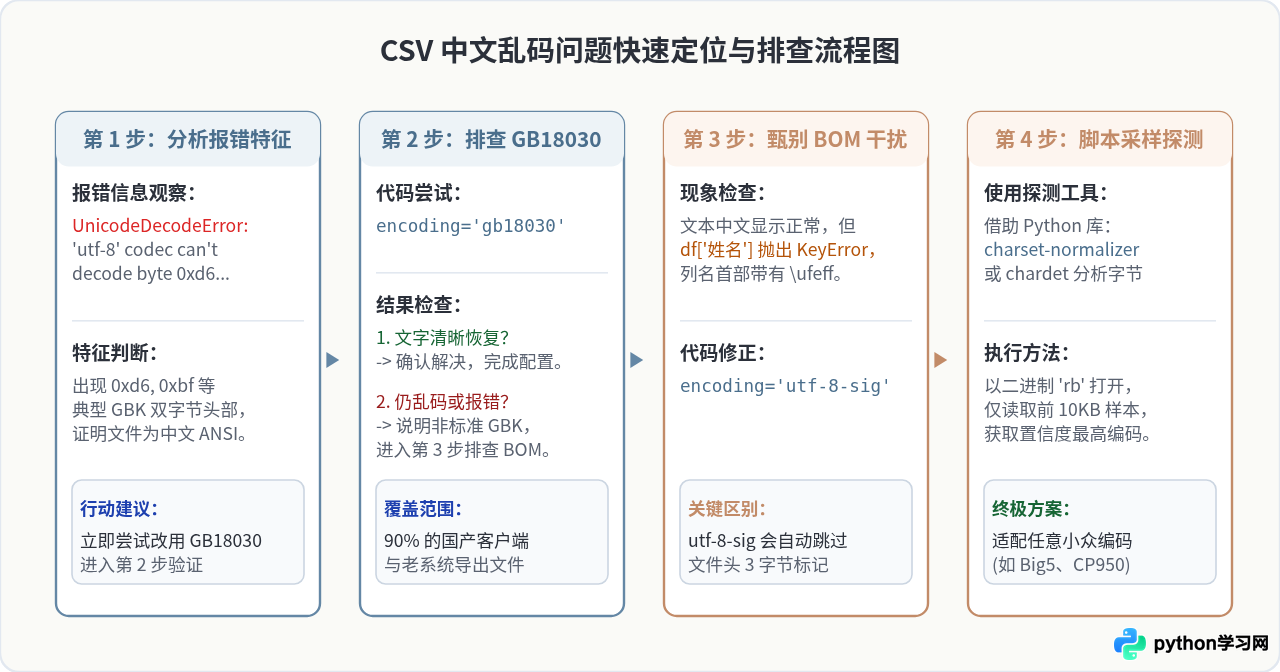
四、未知编码 CSV 文件的排查四步法
面对来源不明的 CSV 文件,切忌盲目猜测。建议按照以下顺序建立排查机制:
采样自动检测编码的完整脚本
对于批量文件或体积过大的 CSV,推荐读取前 10KB 字节进行探测,既轻量又高效:
import charset_normalizer

def detect_encoding(file_path):
    # 以二进制模式读取前 10240 字节,避免读取整个大文件浪费内存
    with open(file_path, 'rb') as f:
        raw_bytes = f.read(10240)

    result = charset_normalizer.from_bytes(raw_bytes).best()
    if result:
        return result.encoding
    return 'utf-8'  # 默认兜底推荐

# 实际调用示例
detected = detect_encoding('unknown_data.csv')
print(f"检测到的文件编码为: {detected}")

# 接着用检测出的编码进行读取
with open('unknown_data.csv', 'r', encoding=detected) as f:
    # 执行常规处理...
    pass
五、编码选型速查与决策指南
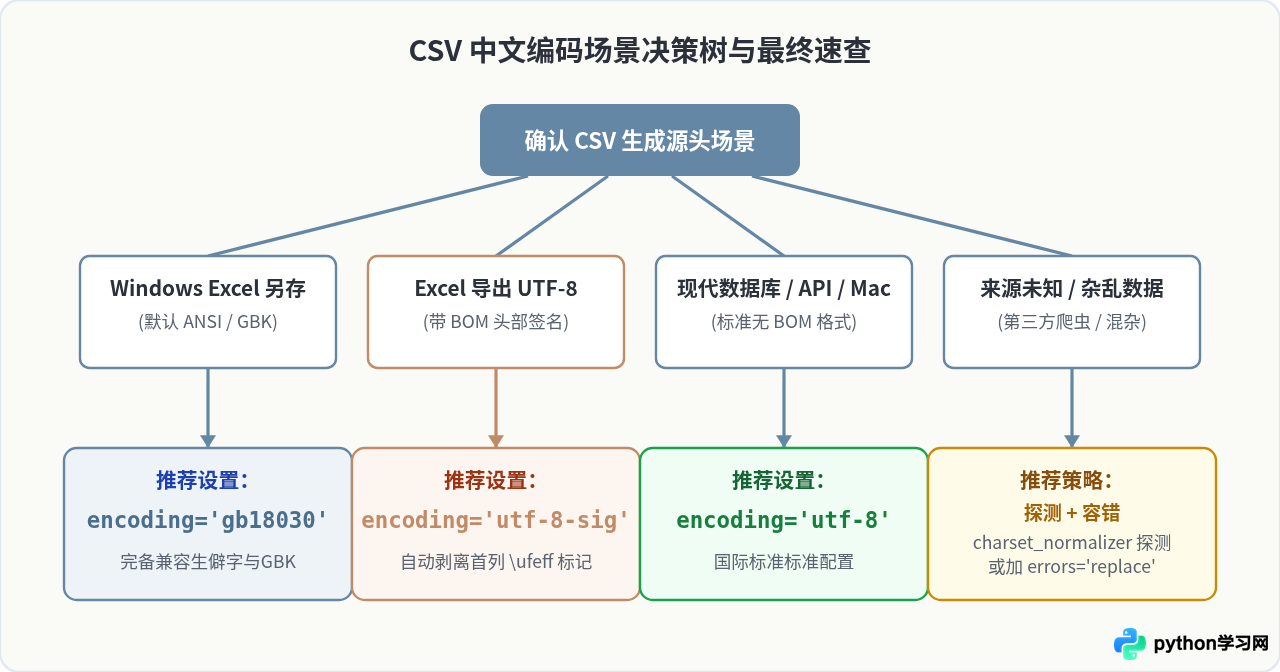
为避免反复调试,可根据数据生成方与运行平台直接锁定 encoding 取值:
| 数据生成来源 | 文件特征 / 表现 | 推荐 encoding 参数 | 备选或注意事项 |
|---|---|---|---|
| 简体中文 Windows Excel 直接保存 | 默认 ANSI 编码,通常包含各类汉字 | gb18030 |
gbk(若无生僻字时可用) |
| Excel 另存为“UTF-8 CSV” | 文件头包含 3 字节 BOM(\xef\xbb\xbf) |
utf-8-sig |
用 utf-8 会导致首字段多出 \ufeff |
| 现代 Web API / MySQL / Linux | 标准无 BOM 的 UTF-8 编码文本 | utf-8 |
国际通用主流,推荐跨平台使用 |
| 中国台湾/中国香港地区老系统 | 传统繁体中文,含大五码体系字符 | big5 / cp950 |
gb18030 也能解码大部分常用繁体 |
| 第三方抓取 / 数据源杂乱 | 多种编码混合,或包含部分乱码字节 | gb18030 配合 encoding_errors='replace' |
优先使用 charset_normalizer 自动探测 |
六、长效维护建议
为了在团队协作与自动化数据管道中彻底杜绝中文乱码问题,建议确立以下规范:
- 读写明确指定:在编写代码时,养成对每一个
open()或pd.read_csv()/to_csv()显式指定encoding的习惯,禁止省略或依赖环境默认设置。 - 向 Excel 用户交付时使用 utf-8-sig:如果你使用 Python 生成 CSV 文件并需要分发给使用 Windows Excel 的业务人员,保存时请设置
encoding='utf-8-sig'。这样 Excel 打开时能直接识别出 UTF-8,既不会发生中文乱码,又能保证多语言兼容性。 - 代码仓库内部统一 UTF-8:项目内部流转的数据一律强制转换为无 BOM 的
utf-8,减少中间处理环节的转码损耗。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















