


怎么用Python字符串切片实现逆序输出?
本文详细讲解如何使用Python字符串切片语法s[::-1]实现逆序输出,深入拆解start、stop、step三参数模型、缺省值补充规则、底层执行机制与常见易错陷阱,并提供性能对比与选型建议。
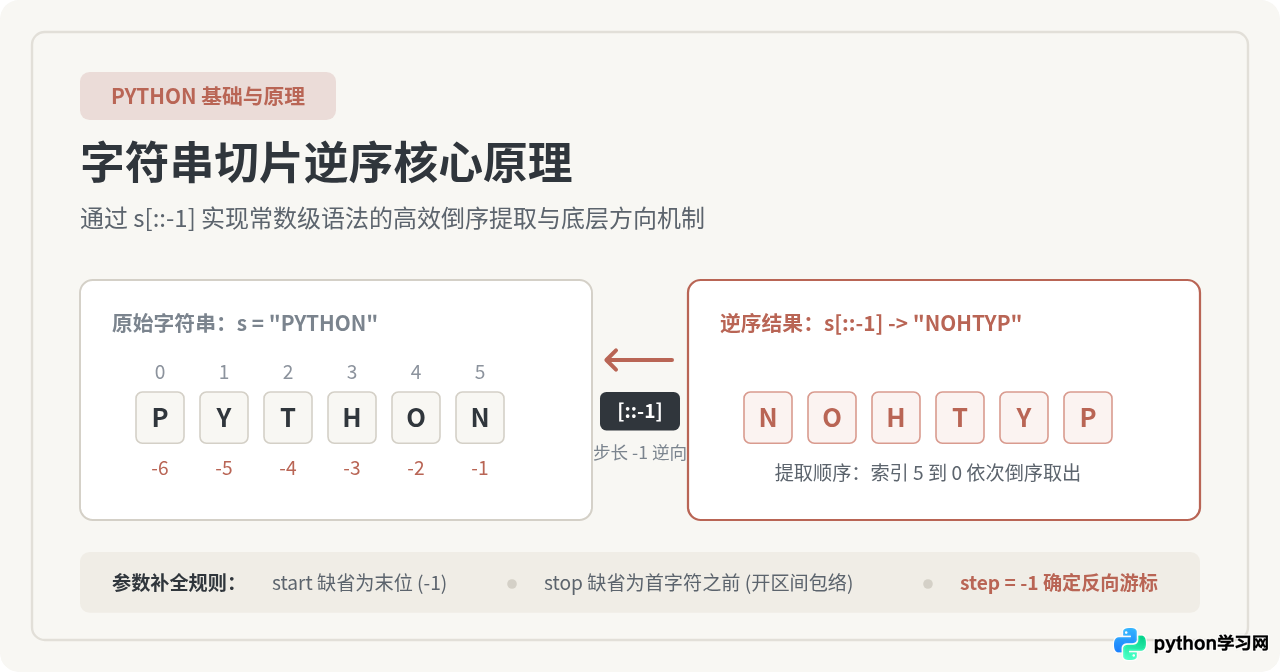
在 Python 中,想要将一个字符串反转并逆序输出,最直接、最高效的做法是使用切片语法 s[::-1]。这一行简洁的表达式背后蕴含着 Python 强大的切片参数模型与游标步长机制。
一、核心答案:一行代码完成逆序
在日常开发中,对任意字符串变量执行反向翻转,只需在字符串变量名后紧跟两个冒号与数字 -1 构成的切片操作符:
# 示例代码:使用切片实现逆序
original_str = "Python编程"
reversed_str = original_str[::-1]

print("原字符串:", original_str)
print("逆序输出:", reversed_str)
运行结果示例:
原字符串: Python编程
逆序输出: 程编nohtyP
该操作不需要调用外部函数库,也不依赖循环累加。无论是英文、数字还是中文字符串,Python 都能正确按字符顺序从右向左完整反转。需要特别说明的是,由于 Python 中的字符串属于不可变对象(Immutable),此切片操作绝不会修改原字符串 original_str 的内容,而是生成并返回一个全新的字符串对象。
二、深度拆解:为什么 [::-1] 能够实现逆序?
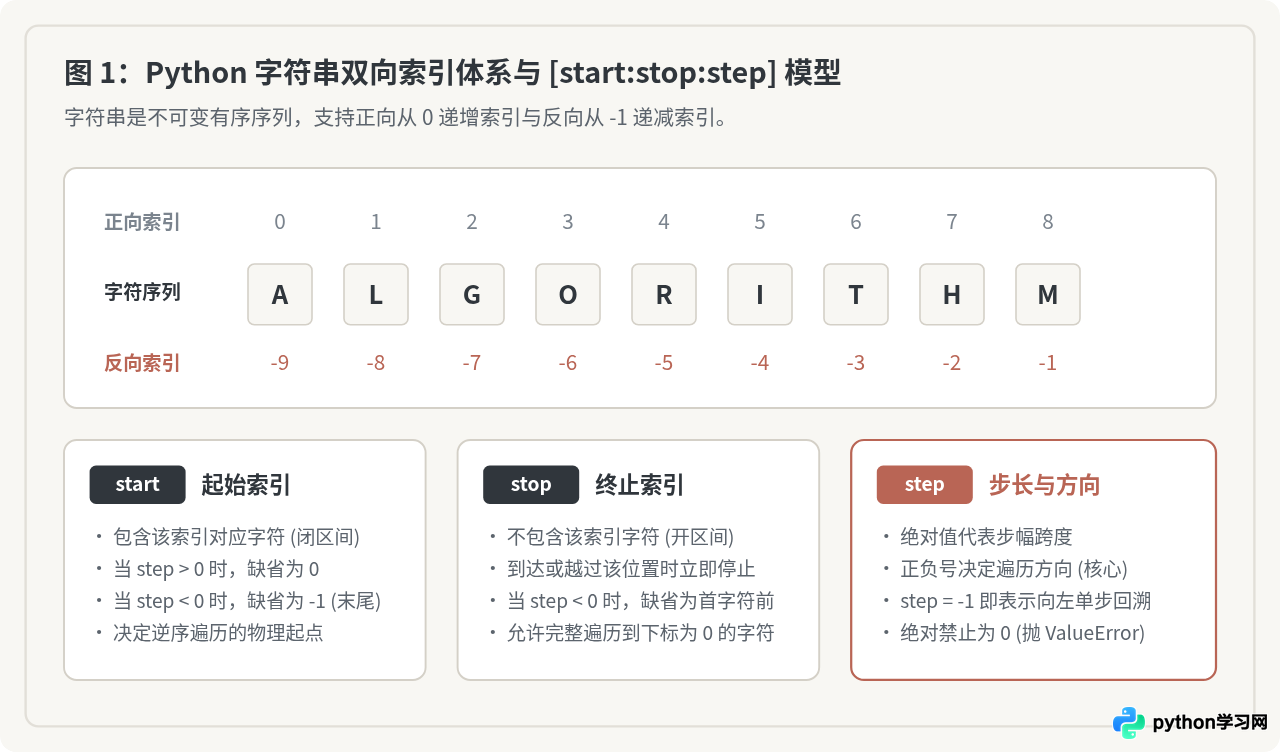
为了真正掌握这一技巧并灵活运用,需要理解 Python 字符串切片的标准三参数语法:
sequence[start:stop:step]这三个参数的含义与默认规则如下:
- start(起始索引):切片开始提取的位置。此位置处的字符包含在内(闭区间)。
- stop(终止索引):切片停止提取的位置。此位置处的字符不包含在内(开区间)。一旦游标到达或越过该索引,截取立刻终止。
- step(步长与方向):每次游标移动的跨度。其正负符号决定了遍历的方向:符号为正表示从左向右(正向递增);符号为负表示从右向左(反向递减)。
1. 两个冒号的省略机制
在 s[::-1] 这一表达式中,我们连续写了两个冒号,且前两个位置留空。这表示显式省略了 start 和 stop 参数,仅指定了 step = -1。
Python 解释器在遇到省略参数时,会根据 step 的正负号智能补齐默认值:
- 当 step > 0 时:
start默认补齐为0(字符串第一个字符),stop默认补齐为字符串总长度len(s)。 - 当 step < 0 时:
start默认补齐为末尾索引len(s) - 1(即-1对应的最后一个字符),stop则默认补齐为首字符之前的一个虚拟前向哨兵位置。
因此,表达式 s[::-1] 完整等价于“从字符串的最后一个字符开始,每次向左移动 1 个字符,一直连续提取到第 0 个字符”。
三、底层推导:解释器如何执行 s[::-1]?
理解了语法规则后,我们可以看一看 Python 解释器(CPython)在底层处理逆序切片时的执行步骤。整个过程严谨且高度优化:
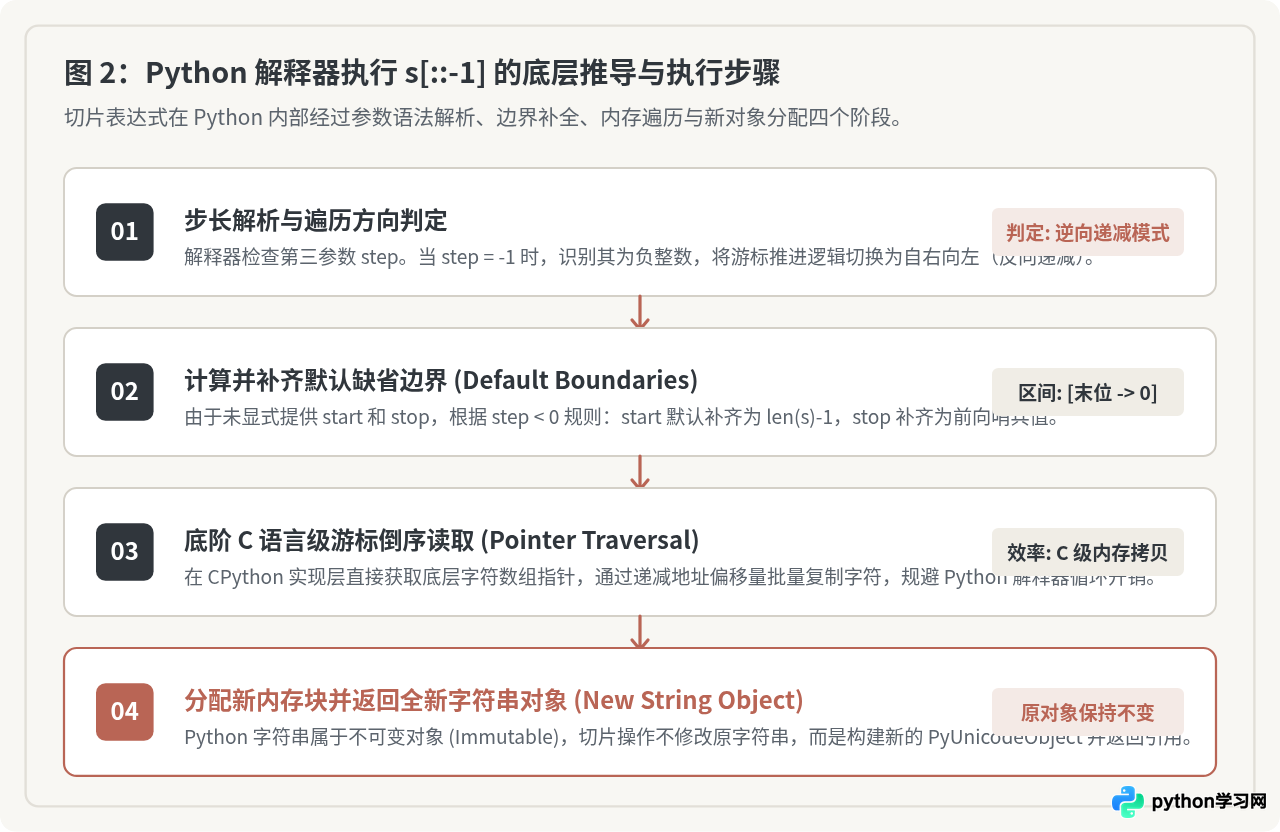
- 解析参数与判定步长符号:解释器先对切片参数求值。检测到
step = -1 < 0,立即将游标寻址模式从“递增”切换为“递减”。 - 计算缺省边界范围:由于省略了起始与终止参数,Python 根据负步长规则自动计算边界:起始索引置为末位字符,终止哨兵设定为保证下标 0 包含在内的开区间。
- 底层 C 级连续内存复制:CPython 底层直接读取字符串的原始连续内存缓冲。依靠指针递减运算,以纯 C 语言级别的速度自右向左搬运字符,避免了在 Python 虚拟机层面产生任何多余的对象包装开销。
- 创建并返回新字符串:在内存中一次性分配目标长度空间,写入倒序排布的字符数据,打包为新的
PyUnicodeObject返回给调用者,原字符串对象保持完全独立不变。
四、进阶应用:局部逆序与特定步长
除了对整串进行全量翻转,切片三参数模型还支持在指定范围内进行局部逆序,或者跳跃式逆序输出。
1. 局部子字符串逆序
如果你只想反转字符串中的某一段,需要显式指定 start 和 stop。牢记:当步长为负时,起始索引 start 的物理位置必须位于终止索引 stop 的右侧。
text = "ABCDEFG"

# 从索引 5 ('F') 逆序提取到索引 2 ('C'),终止索引为 1 (不含)
sub_reversed = text[5:1:-1]
print("局部逆序 [5:1:-1]:", sub_reversed)
运行结果示例:
局部逆序 [5:1:-1]: FEDC2. 跳跃逆序(步长绝对值大于 1)
若将步长设为 -2,则表示从最后一个字符开始,每次向左跨越 2 个字符进行提取,实现“隔一位倒序采样”:
numbers = "0123456789"
jump_reversed = numbers[::-2]
print("跳跃逆序 [::-2]:", jump_reversed)
运行结果示例:
跳跃逆序 [::-2]: 97531五、常见陷阱与注意事项
初学者在使用切片逆序时,容易因索引习惯惯性而踩坑。以下是必须重点注意的两大典型问题。
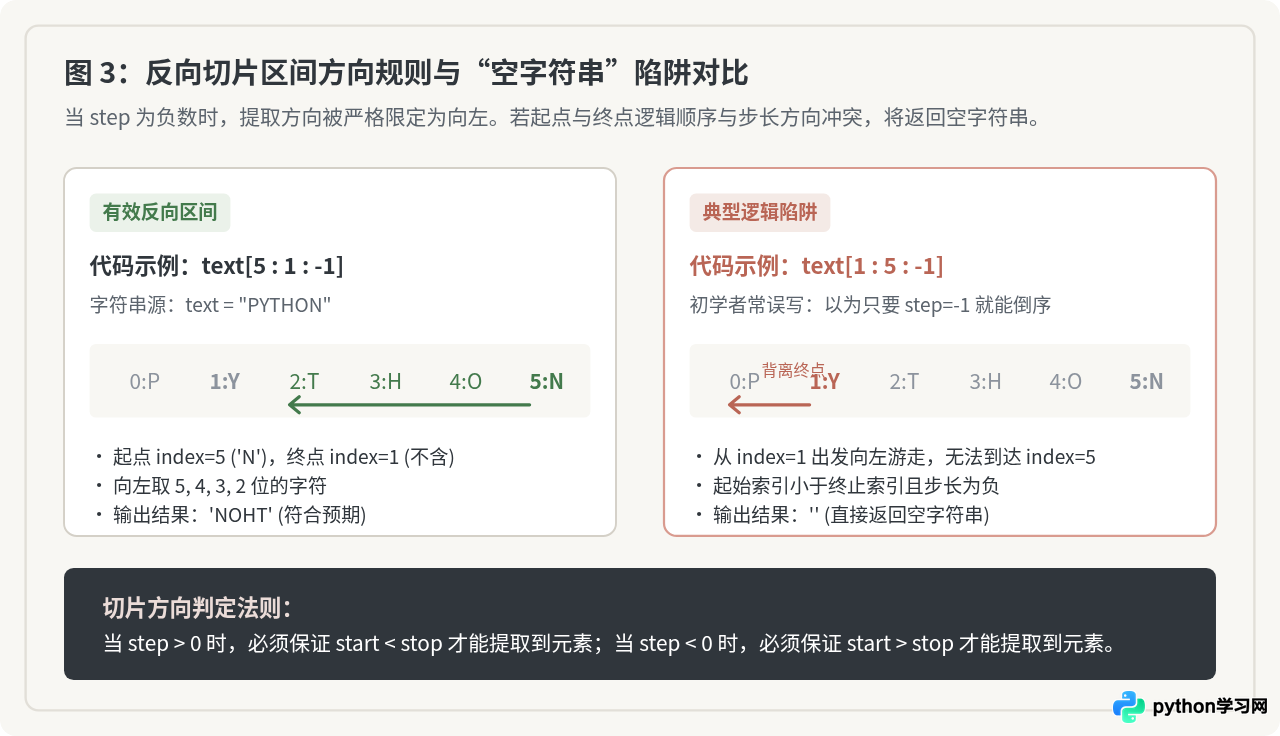
1. 起始与终止顺序颠倒引发的“空字符串”陷阱
在正向切片中,我们习惯写 text[1:5](从索引 1 提取到 4)。部分开发者想要倒序时,会下意识写成:
text = "PYTHON"
# 错误示范:以为加上 -1 就能倒序输出索引 1 到 4 的内容
result = text[1:5:-1]
print("结果为:", repr(result))
运行结果示例:
结果为: ''这里 start=1,stop=5,而 step=-1 要求游标从索引 1 向左走。向左移动的游标(递减到 0, -1, ...)在逻辑上永远不可能到达右侧的索引 5。Python 判定该区间无法成立,因此安全地返回一个空字符串 '',既不报错也不输出字符。
2. Unicode 组合字符与 Emoji 表情符号
Python 3 的字符串切片是基于 Unicode 码点(Code Point)而不是视觉字形簇(Grapheme Cluster)运行的。对于普通英文字母、汉字以及单码点符号,切片逆序完全正确。但若字符串包含由多个码点通过零宽连接符(ZWJ)组合而成的复杂 Emoji 或音调组合字符(如 é),纯切片可能会将复合码点拆散,导致显示异常:
# 示例:复合字形在码点层面的倒序
# "e\u0301" 是带有重音符号的 é
accent_char = "é"
print("原字符:", accent_char)
print("切片倒序:", repr(accent_char[::-1]))
运行结果示例:
原字符: é
切片倒序: '́e'
在此场景下,重音符号 ́ 被翻转到了字母 e 的前面,破坏了原有的复合修饰关系。在处理涉及多语言复杂注音文本或复合 Emoji 场景时,应借助第三方库如 regex 进行字形簇层面的安全反转。
六、方案对比:切片与其它逆序方式
在 Python 中,除了使用切片 [::-1],常见的反转手段还包括内置函数 reversed() 配合 str.join(),以及基础的循环累加。它们在原理和应用场景上存在明显差异:
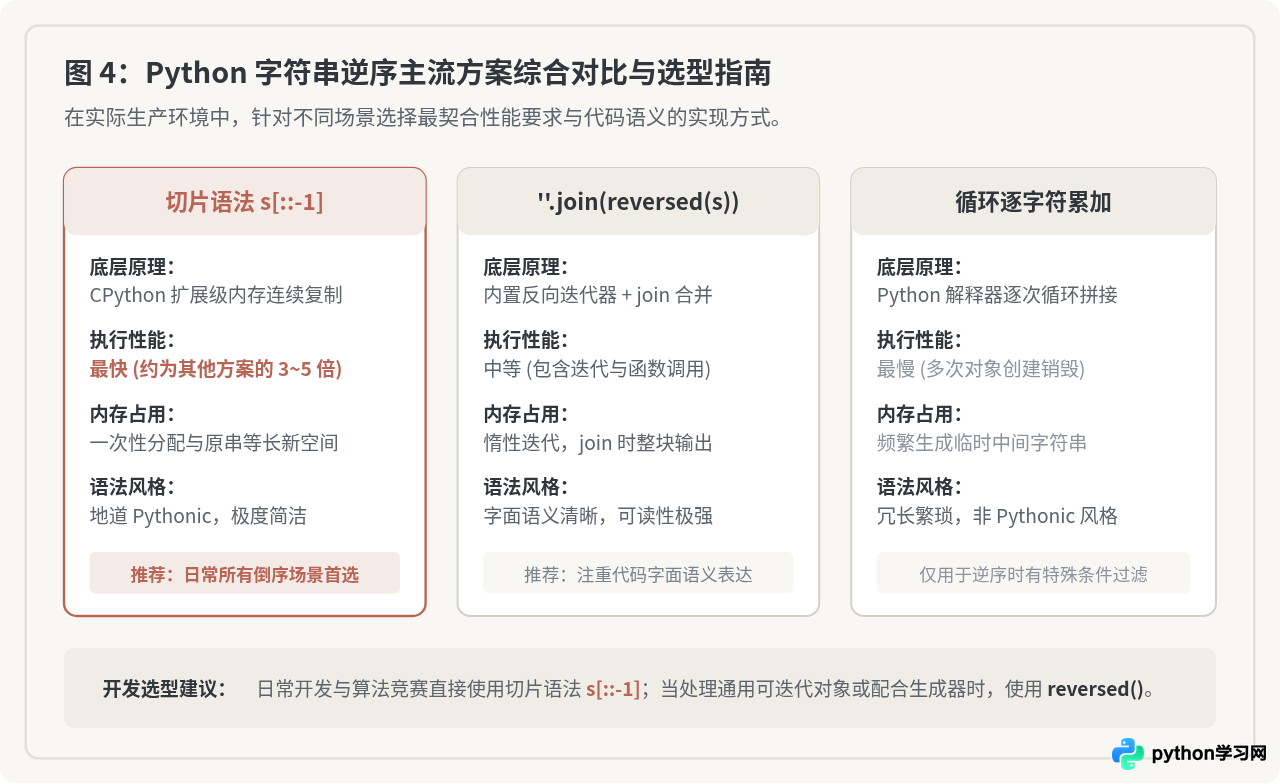
| 实现方式 | 代码写法 | 时间复杂度 | 性能表现 | 适用场景 |
|---|---|---|---|---|
| 切片语法 | s[::-1] |
O(N) | 极快(底层 C 级复制) | 日常业务开发、算法题、绝大多数文本反转 |
| 反向迭代器 | ''.join(reversed(s)) |
O(N) | 中等(涉及迭代器包装) | 注重代码字面语义、或与其他生成器流式处理配合 |
| 循环拼接 | for char in s: res = char + res |
O(N) ~ O(N²) | 较慢(频繁创建临时对象) | 反转过程中需要动态插入复杂的字符清洗与过滤逻辑 |
从微基准测试(Benchmark)来看,s[::-1] 的执行速度通常是 ''.join(reversed(s)) 的 3 至 5 倍,更是循环拼接写法的数十倍以上。因此,在无需流式消费字符的前提下,切片始终是首选方案。
七、总结速查
掌握 Python 字符串切片逆序的核心要点可归纳为以下三句话:
- 快速实现:全串翻转直接使用
s[::-1],简洁、高效且符合 Python 惯用表达。 - 参数规律:两个冒号分别分隔起始、终止与步长。当
step < 0时,缺省边界自动对齐为“从尾到头”。 - 区间法则:若进行局部反向截取,必须保证
start > stop,否则将得到空字符串。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















