


Python实现汉诺塔:递归法与迭代法对比
深入对比汉诺塔问题的Python递归实现与迭代实现(显式栈模拟与数学周期法),系统分析调用栈机制、时间与空间开销及工程防御选型策略。
一、汉诺塔规则与移动本质
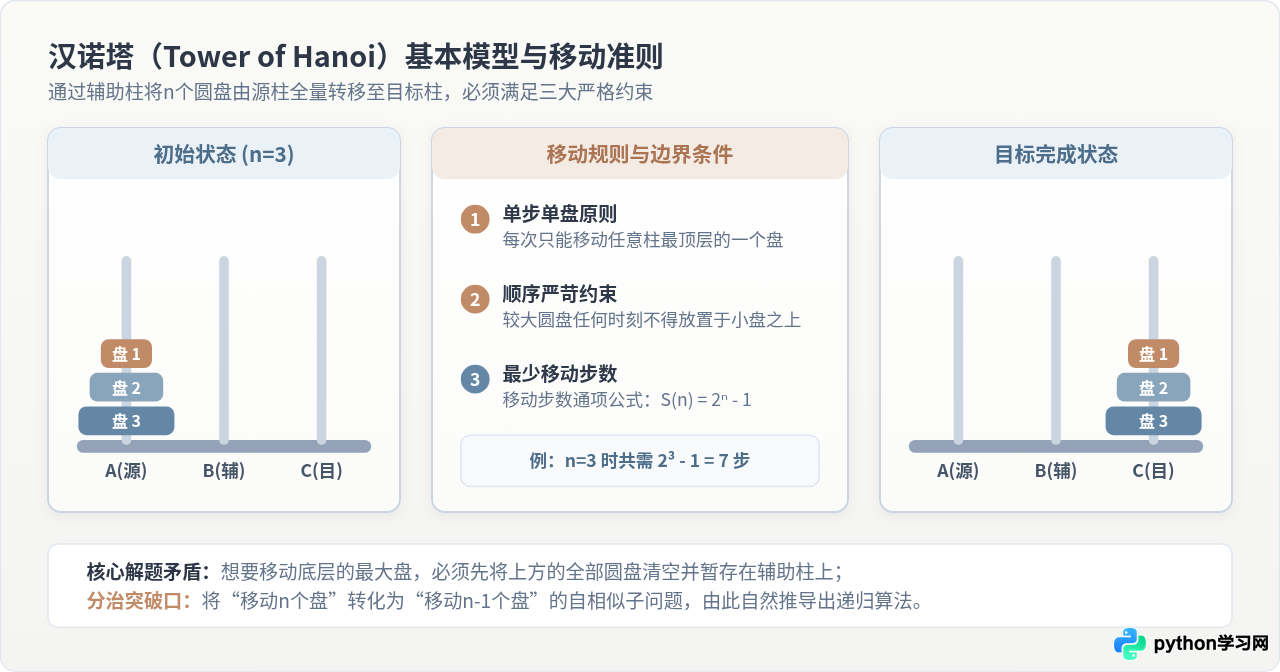
汉诺塔(Tower of Hanoi)起源于古老传说,其数学模型非常简洁:在三根立柱(习惯记为 A、B、C)上,放置着 n 个半径各不相同的圆盘。初始状态下,全部圆盘自下而上按照从大到小的顺序整齐叠放在源柱 A 上;解题目标是在遵循指定规则的前提下,将所有圆盘完整平移到目标柱 C 上。
在移动过程中,任何算法实现都必须严格遵守以下三条铁律:
- 单步单盘原则:每一步操作仅允许移动任意一根立柱顶层的单一圆盘;
- 顺序严苛约束:在任何移动时刻与任何立柱上,较大圆盘绝对不能叠压在较小圆盘上方;
- 柱间合法中转:只允许利用指定的源柱、辅助柱与目标柱进行盘片周转。
设移动 n 个圆盘所需要的最少步数为 S(n)。要将最底部的最大盘(第 n 盘)移到目标柱,前提是必须先将其上方的 n-1 个圆盘整体转移到辅助柱;底盘就位后,再将这 n-1 个圆盘从辅助柱转移到目标柱。因此,其最小步数满足递推关系:
S(n) = 2 · S(n - 1) + 1 ,其中 S(1) = 1
由此解得通项公式为 S(n) = 2ⁿ - 1。移动步数随着圆盘数呈指数级爆炸,这是汉诺塔问题的核心物理本质。
二、递归法实现:分治思想与调用栈推导
递归法是求解汉诺塔最直观也是最经典的方法。其核心策略是分治法(Divide and Conquer):把一个规模为 n 的复杂问题拆分为三个先后承接的子任务:
- 以目标柱为中介,将源柱上方的
n - 1个圆盘转移到辅助柱; - 将源柱上仅剩的第
n个最大圆盘直接移动到目标柱; - 以源柱为中介,将辅助柱上的
n - 1个圆盘最终转移到目标柱。
当 n == 1 时触发基准条件(Base Case),此时无须继续分解,直接输出单次盘片移动即可。下面是完整的 Python 3 递归实现:
def hanoi_recursive(n: int, source: str, target: str, auxiliary: str, step_counter: list) -> None:
    # 汉诺塔递归分治求解
    if n <= 0:
        return
    if n == 1:
        # 基准情况:单盘直接移动
        step_counter[0] += 1
        print(f"步骤 {step_counter[0]:02d}: 移动圆盘 1 从 [{source}] 柱 -> [{target}] 柱")
        return

    # 步骤 1: 将前 n-1 个盘从 source 借 target 移到 auxiliary
    hanoi_recursive(n - 1, source, auxiliary, target, step_counter)

    # 步骤 2: 将第 n 个底层大盘直接从 source 移到 target
    step_counter[0] += 1
    print(f"步骤 {step_counter[0]:02d}: 移动圆盘 {n} 从 [{source}] 柱 -> [{target}] 柱")

    # 步骤 3: 将位于 auxiliary 上的 n-1 个盘借 source 移到 target
    hanoi_recursive(n - 1, auxiliary, target, source, step_counter)


if __name__ == "__main__":
    disks = 3
    print(f"--- 汉诺塔递归法执行过程 (圆盘数 n={disks}) ---")
    counter = [0]
    hanoi_recursive(disks, source="A", target="C", auxiliary="B", step_counter=counter)
    print(f"执行完毕,总计移动步数: {counter[0]}")
运行上述代码时,针对 n=3,控制台将严格按照中序遍历顺序输出 7 次移动。整个调用过程构成一棵高度为 3 的二叉树,系统在执行中通过函数调用栈隐式记录当前的变量状态与返回地址。
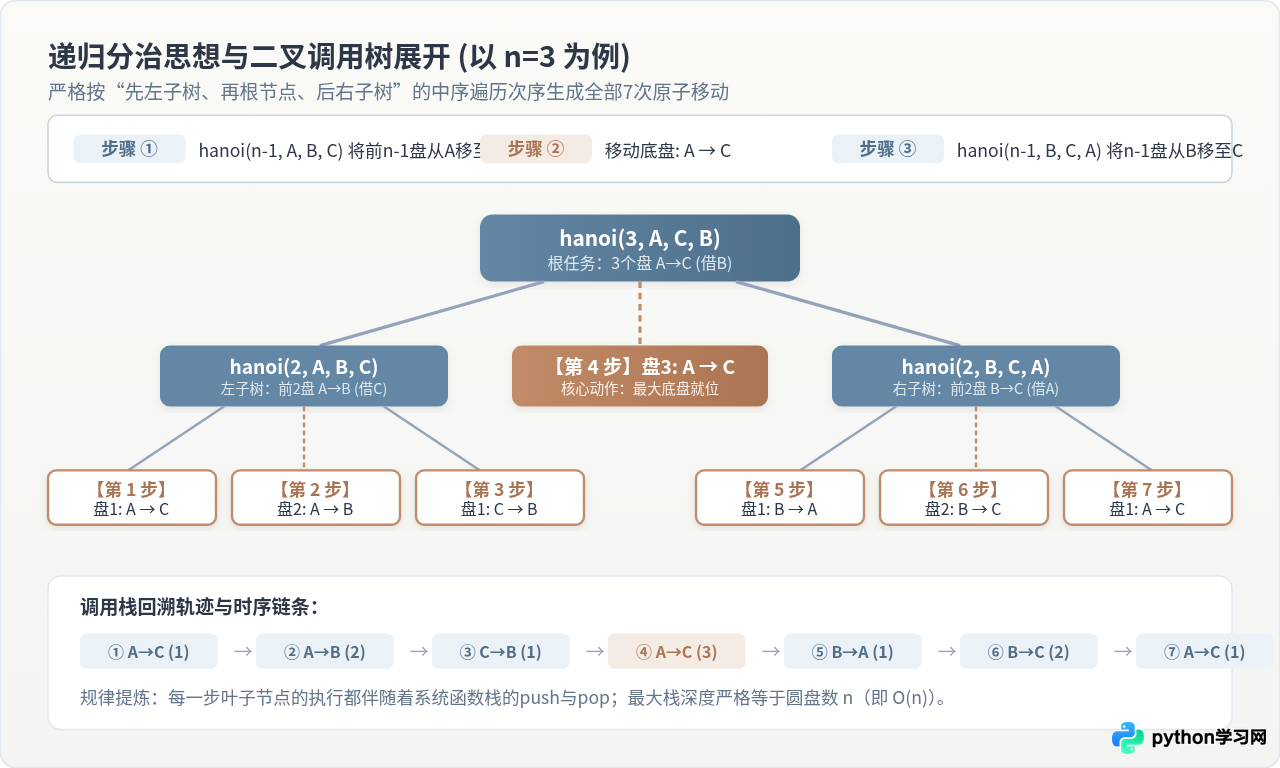
PyFrameObject(函数栈帧)。求解规模为 n 的汉诺塔,调用栈的最大驻留深度为 n。由于 Python 默认设有递归限制(可通过 sys.getrecursionlimit() 查询,通常为 1000),当递归层级超过限制时,程序会抛出 RecursionError。
三、迭代法实现:非递归规避与状态推导
为了摆脱语言层面对调用栈深度的硬性束缚,必须使用迭代法(非递归法)。在工程领域,汉诺塔的非递归实现主要有两种流派:显式栈模拟递归与数学周期规律法。
1. 路径一:显式任务栈模拟(Explicit Call Stack)
显式栈模拟的本质是将操作系统负责维护的调用栈“搬迁”到开发者可控的堆内存中。在 Python 中,我们使用原生的 list 充当 LIFO(后进先出)工作栈。
对于每个任务,我们用一个元组 (n, source, target, auxiliary) 表示。由于栈是后进先出的,为了确保子任务按照“前 n-1 盘移动 → 底层单盘移动 → 后 n-1 盘移动”的自然顺序执行,我们在压栈时必须执行逆序压栈:
def hanoi_iterative_stack(n: int, source: str, target: str, auxiliary: str) -> list:
    # 使用显式栈模拟递归执行汉诺塔,避免系统调用栈溢出
    if n <= 0:
        return []

    moves = []
    # 栈中元素格式: (n, source, target, auxiliary)
    # 当 n=1 时表示直接移动;当 n>1 时表示需要展开的复合任务
    task_stack = [(n, source, target, auxiliary)]
    step = 0

    while task_stack:
        curr_n, src, tgt, aux = task_stack.pop()

        if curr_n == 1:
            step += 1
            record = f"步骤 {step:02d}: 移动圆盘 1 从 [{src}] 柱 -> [{tgt}] 柱"
            moves.append(record)
            print(record)
        else:
            # 逆序压栈:后执行的先入栈
            # 步骤 3 最后执行,最先入栈
            task_stack.append((curr_n - 1, aux, tgt, src))
            # 步骤 2 居中执行
            task_stack.append((1, src, tgt, aux))
            # 步骤 1 最先执行,最后入栈
            task_stack.append((curr_n - 1, src, aux, tgt))

    return moves
2. 路径二:数学周期规律法(Mathematical Cycle)
若追求极致的空间复杂度,汉诺塔存在一个基于状态机轮转的奇妙数学规律:
- 如果圆盘总数
n为奇数:第一步必须将盘 1 移向目标柱 C;随后立柱轮转配对顺序为A ↔ C,A ↔ B,B ↔ C; - 如果圆盘总数
n为偶数:第一步必须将盘 1 移向辅助柱 B;随后立柱轮转配对顺序为A ↔ B,A ↔ C,B ↔ C; - 每次选定两个立柱后,其移动方向是唯一确定的——只能由顶层盘较小的一方移向盘较大(或为空)的一方,绝无第二种合法选择。
利用该规律,整个算法只需一个 for 循环,空间复杂度直接降为常数级 O(1):
def move_between_pegs(pegs: dict, p1: str, p2: str, step_container: list) -> None:
    """在两根立柱之间执行唯一合法的单向盘片移动"""
    stack1 = pegs[p1]
    stack2 = pegs[p2]

    if not stack1 and not stack2:
        return
    elif not stack1:
        disk = stack2.pop()
        stack1.append(disk)
        step_container[0] += 1
        print(f"步骤 {step_container[0]:02d}: 移动圆盘 {disk} 从 [{p2}] 柱 -> [{p1}] 柱")
    elif not stack2:
        disk = stack1.pop()
        stack2.append(disk)
        step_container[0] += 1
        print(f"步骤 {step_container[0]:02d}: 移动圆盘 {disk} 从 [{p1}] 柱 -> [{p2}] 柱")
    elif stack1[-1] < stack2[-1]:
        disk = stack1.pop()
        stack2.append(disk)
        step_container[0] += 1
        print(f"步骤 {step_container[0]:02d}: 移动圆盘 {disk} 从 [{p1}] 柱 -> [{p2}] 柱")
    else:
        disk = stack2.pop()
        stack1.append(disk)
        step_container[0] += 1
        print(f"步骤 {step_container[0]:02d}: 移动圆盘 {disk} 从 [{p2}] 柱 -> [{p1}] 柱")


def hanoi_iterative_cycle(n: int, source: str = "A", target: str = "C", auxiliary: str = "B") -> None:
    """基于离散周期规律的 O(1) 辅助空间迭代解法"""
    if n <= 0:
        return

    pegs = {
        source: list(range(n, 0, -1)),
        auxiliary: [],
        target: []
    }

    p_aux = auxiliary if (n % 2 == 0) else target
    p_tgt = target if (n % 2 == 0) else auxiliary

    total_moves = (1 << n) - 1
    step_box = [0]

    for step in range(1, total_moves + 1):
        remainder = step % 3
        if remainder == 1:
            move_between_pegs(pegs, source, p_aux, step_box)
        elif remainder == 2:
            move_between_pegs(pegs, source, p_tgt, step_box)
        elif remainder == 0:
            move_between_pegs(pegs, auxiliary, target, step_box)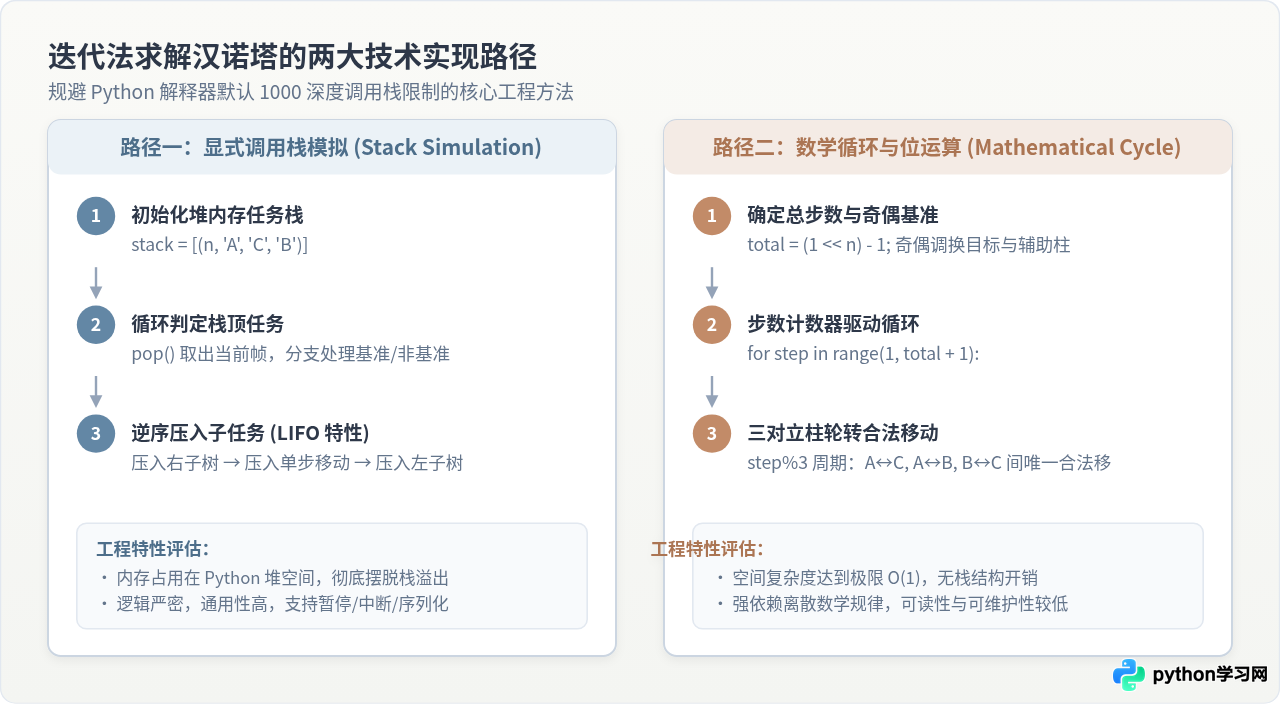
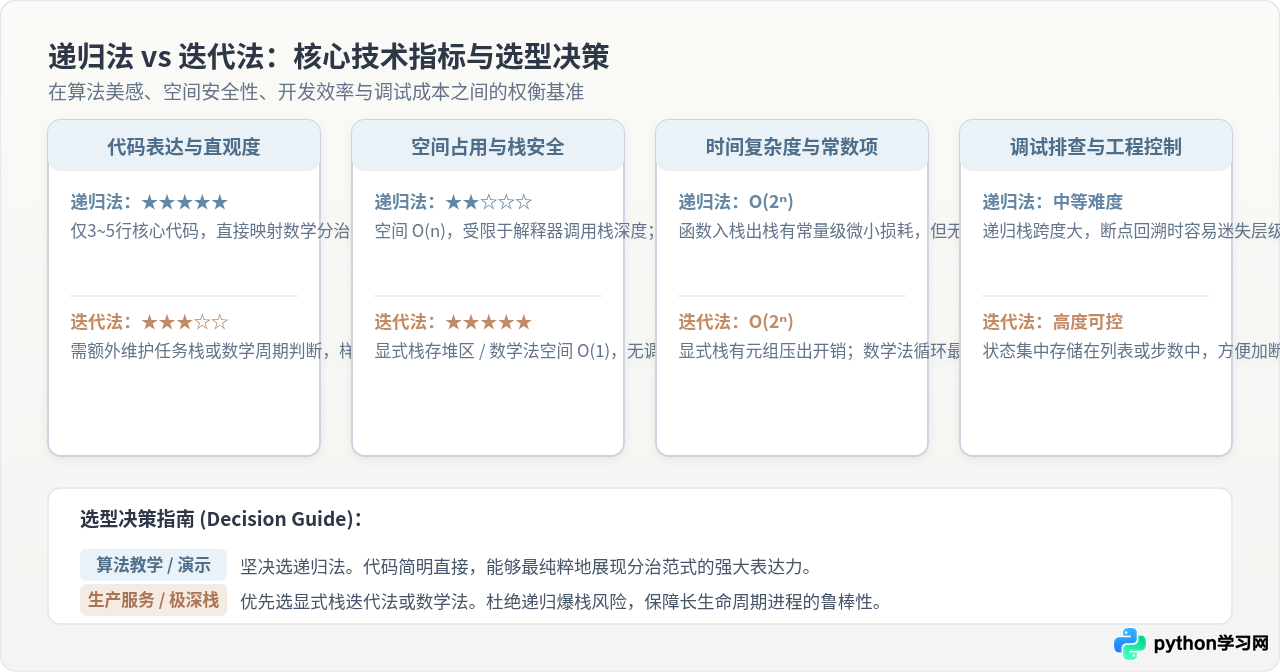
四、递归法 vs 迭代法深度对比
在深入理解了两种范式的实现机制后,我们围绕工程实用场景最关心的四个核心维度进行系统比对:
| 对比维度 | 递归法 (Recursive) | 显式栈迭代法 (Stack Simulation) | 数学周期迭代法 (Math Cycle) |
|---|---|---|---|
| 代码复杂度 | 极低(仅约 6 行),天然符合分治归纳模型 | 中等(约 20 行),需手工维护 LIFO 压栈拆分 | 较高(约 35 行),需处理柱间双向合法判定 |
| 时间复杂度 | O(2ⁿ)(最少 2ⁿ - 1 次原子操作) |
O(2ⁿ)(最少 2ⁿ - 1 次原子操作) |
O(2ⁿ)(最少 2ⁿ - 1 次原子操作) |
| 辅助空间 | O(n) 内部调用栈帧 |
O(n) 外部堆内存列表 |
O(1)(排除存储结果所需开销) |
| 栈溢出风险 | 存在,受 sys.getrecursionlimit() 限制 |
绝对安全,堆内存上限极大 | 绝对安全,无调用栈依赖 |
| 断点调试便利性 | 较差,深层递归下断点容易迷失调用层级 | 极佳,可实时打印与持久化 stack 状态 | 良好,步数步幅单向递增,状态直观 |
深入剖析这些差异,可以得出两点深层的工程洞见:
-
时间开销的瓶颈并非来自调用方式,而是问题本身的指数爆炸:虽然递归法存在微弱的栈帧创建销毁开销,但在汉诺塔
O(2ⁿ)的几何级数面前,当n > 30时,无论采用递归还是迭代,算法均已无法在合理时间内完成全部输出。因此,两者在时间效率上的差异在宏观上并不构成决策瓶颈。 -
空间维度的防御性是迭代法的核心壁垒:递归法的
O(n)栈深直指操作系统的受限线程栈。一旦遇到配置严格的嵌入式环境或极浅的运行时限制,递归法将直接导致进程崩溃。显式栈将这种压力卸载到动态堆内存中,赋予了系统极强的鲁棒性。
五、实现陷阱与注意事项
在编写和测试汉诺塔算法时,开发者常在以下细节产生偏差:
-
参数传递顺序错位:在递归函数
hanoi(n-1, source, auxiliary, target)的两处子调用中,源柱、目标柱与辅助柱的实参位置是交替互换的。初学者常误将参数固定写死为(n-1, 'A', 'B', 'C'),导致无限递归或盘片越界。 - 迭代显式栈的压栈次序反转:栈遵循 LIFO 规则,若要先执行左子树任务,必须最后将左子树元组推入栈顶。颠倒压栈顺序将导致步骤完全打乱。
-
规模测试边界控制:测试代码时切忌盲目设置过大的
n值。例如n = 64时步数高达18,446,744,073,709,551,615次,即便现代处理器每秒能执行十亿步,也需运转数百亿年。教学与单元测试建议将n控制在3 ~ 15之内。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















