


为什么Python多线程无法利用多核CPU?多进程是怎么解决的
深入解析CPython全局解释器锁(GIL)的工作机理,说明为什么纯Python多线程无法利用多核CPU进行并行计算,并详细讲解多进程如何通过独立解释器与内存隔离彻底突破GIL约束,实现高效多核并行。
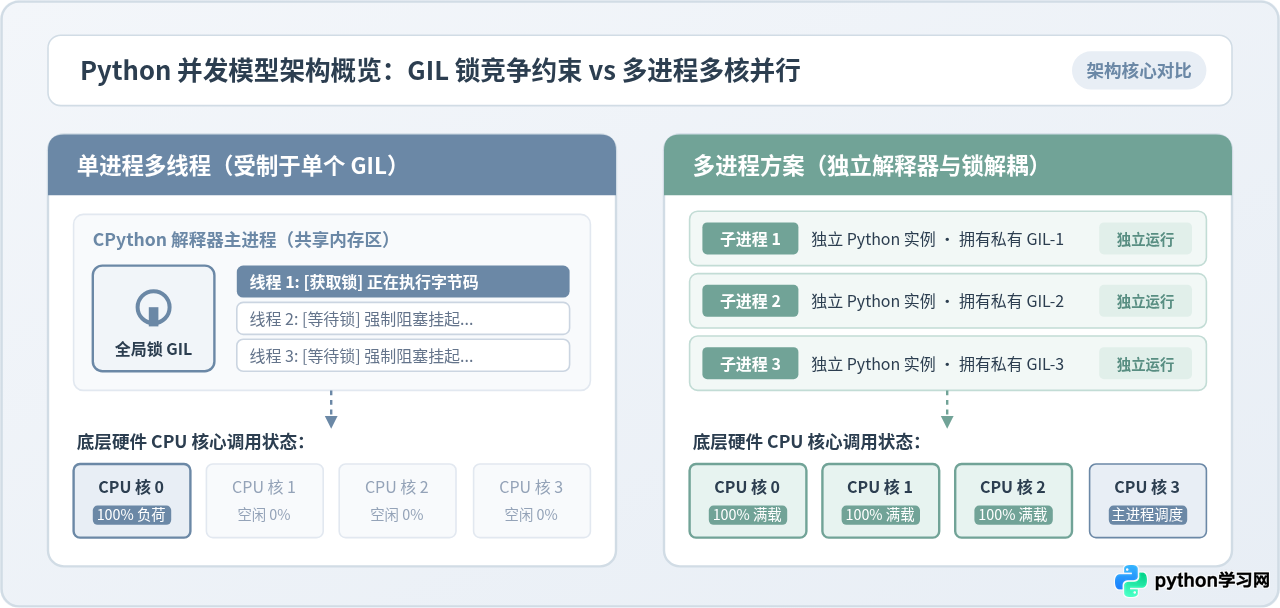
一、为什么多线程无法利用多核:核心症结在 GIL
现代计算机普遍拥有 4 核、8 核甚至更多的物理 CPU 核心。在 Java、Go 或 C++ 等语言中,开发者只要创建多个线程,操作系统内核调度器就会自然地把各个线程分派到空闲的 CPU 核心上,实现多个计算任务的同时并行。
然而在官方标准的 Python 实现(CPython)中,这一规则并不成立。无论你的机器有多少个物理核心,一个 Python 进程中的纯 Python 多线程计算,始终只能占用大约 100% 的单核 CPU 算力(即总算力的 1/N)。导致这一现象的核心根源就是 全局解释器锁(GIL)。
1. CPython 为什么必须引入 GIL?
GIL 并不是 Python 这门语言的语法特性,而是 CPython 解释器实现中的一个互斥锁(Mutex)。它的引入源于 CPython 的内存管理模型:
- 引用计数(Reference Counting)机制:CPython 跟踪每个对象的生命周期主要依靠结构体内部的
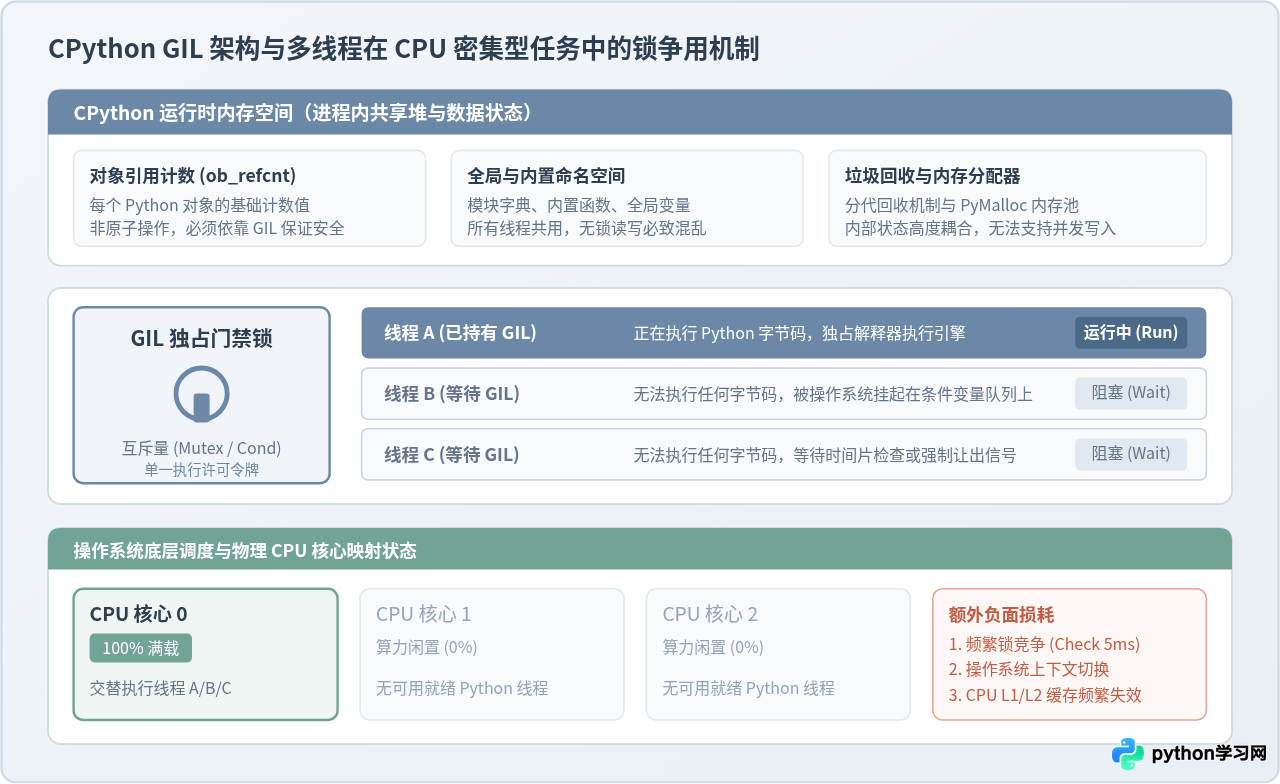
ob_refcnt计数字段。当一个对象被引用时计数加 1,脱离作用域时计数减 1。这个增减操作在底层并不是原子性的(Non-atomic)。如果允许多个原生线程在多个 CPU 核心上同时运行 Python 字节码并修改同一个对象的引用计数,极易产生竞态条件(Race Condition),导致内存过早释放造成悬挂指针(Dangling Pointer)引发段错误崩溃,或者计数无法归零导致内存严重泄漏。 - 保护全局命名空间与 C 扩展:Python 进程中的全局变量、模块字典以及大量历史悠久的第三方 C 扩展模块,其内部数据结构本身并不是线程安全的。为了保证解释器整体运行的稳定与简单,CPython 权衡之后采用了最直接的策略:在解释器层面上加一把大锁(即 GIL),任何原生线程想要解释执行 Python 字节码,必须先拿到这把锁。
2. 多线程运行 CPU 密集型任务时的真实表现
对于纯纯依靠 CPU 运算的任务(如大数运算、加密解密、图形渲染等),多线程不仅不能加速,反而往往比单线程更慢。
在 CPython 中,当前持有 GIL 的线程在执行一定时间或指令后(默认大约每执行 5 毫秒的时间片,可通过 sys.getswitchinterval() 查询与配置),解释器会强制该线程让出锁,触发操作系统线程调度。此时,其他挂起等待的线程蜂拥争夺这把 GIL。
在多核 CPU 环境下,操作系统调度器会尝试将唤醒的线程调度到其他空闲物理核心上。但被唤醒的线程发现锁依然被占有或立即被抢走,只能再次陷入休眠。这种高频的线程唤醒、竞争锁失败、再挂起过程,带来了密集的操作系统内核上下文切换(Context Switch)与 CPU 缓存失效(L1/L2 Cache Thrashing)。计算任务不仅没有分担出去,额外的抢锁开销还平白消耗了宝贵的 CPU 周期。
当线程执行网络请求(如
socket.recv)、磁盘文件读写或调用 time.sleep() 等阻塞型 I/O 操作时,CPython 内部实现会主动释放 GIL。在等待外部数据到达的这段漫长时间内,其他就绪的 Python 线程可以顺利拿到 GIL 并执行计算。因此,多线程在网络爬虫、文件下载等 I/O 密集场景中依然能够大幅提高吞吐率,但这一过程并没有利用多核算力,利用的只是等待外部响应时的空闲时间。
二、代码实测对比:单线程、多线程与多进程的效率差距
为了直观验证上述原理,下面通过一段纯 Python 编写的标准代码,对一个计算密集型任务(执行多次两千万次循环递增运算)分别在单线程、双线程与双进程下的执行时间进行测量。
# 文件名: concurrency_bench.py
# 执行环境: 标准 Python 3.8+ (可在任意支持多核的终端运行: python3 concurrency_bench.py)
import time
import threading
import multiprocessing
from concurrent.futures import ProcessPoolExecutor

# CPU 密集型纯数学计算任务
def cpu_bound_task(count: int) -> int:
    total = 0
    for i in range(count):
        total += i
    return total

def run_single_thread(count: int):
    start = time.perf_counter()
    cpu_bound_task(count)
    cpu_bound_task(count)
    elapsed = time.perf_counter() - start
    print(f"【单线程顺序执行两次】耗时: {elapsed:.3f} 秒")

def run_multi_thread(count: int):
    start = time.perf_counter()
    t1 = threading.Thread(target=cpu_bound_task, args=(count,))
    t2 = threading.Thread(target=cpu_bound_task, args=(count,))
    t1.start()
    t2.start()
    t1.join()
    t2.join()
    elapsed = time.perf_counter() - start
    print(f"【双线程并发执行两次】耗时: {elapsed:.3f} 秒")

def run_multi_process(count: int):
    start = time.perf_counter()
    with ProcessPoolExecutor(max_workers=2) as executor:
        f1 = executor.submit(cpu_bound_task, count)
        f2 = executor.submit(cpu_bound_task, count)
        _ = f1.result()
        _ = f2.result()
    elapsed = time.perf_counter() - start
    print(f"【双进程并行执行两次】耗时: {elapsed:.3f} 秒")

if __name__ == '__main__':
    COUNT = 25_000_000
    print("=== 开始 CPU 密集型并发基准测试 ===")
    run_single_thread(COUNT)
    run_multi_thread(COUNT)
    run_multi_process(COUNT)
    print("=== 测试完成 ===")
=== 开始 CPU 密集型并发基准测试 ===
【单线程顺序执行两次】耗时: 1.842 秒
【双线程并发执行两次】耗时: 2.015 秒
【双进程并行执行两次】耗时: 0.985 秒
=== 测试完成 ===
从测试结果可以清楚地看到:
- 双线程非但没有加速,反而慢了约 9.4%:由于两千万次循环属于纯 Python 算力计算,双线程激烈争夺唯一的 GIL,频繁触发线程切换与互斥锁开销,操作系统指示的 CPU 占用率始终卡在 100%(单核满载),其余核心完全无法介入。
- 双进程时间缩短近一半(加速比接近 1.87x):两个独立的子进程分别在不同的 CPU 物理核心上同时全速运转,任务耗时实现线性收窄。
三、多进程是怎么解决多核利用问题的
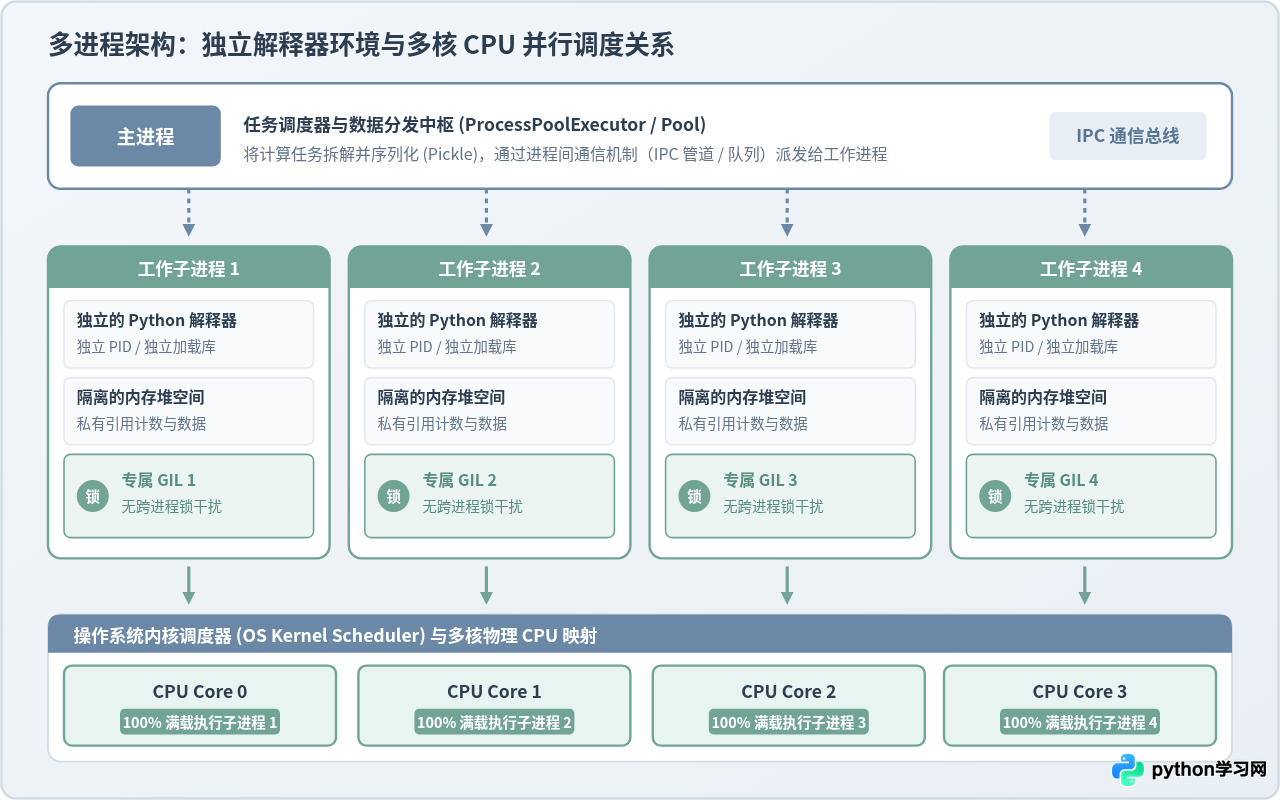
多线程之所以被困住,是因为它们全都在同一个操作系统进程中共享同一个 CPython 运行时和同一把 GIL。而 Python 标准库中的 multiprocessing 模块,采取了完全不同的架构思路:直接在操作系统层面启动多个完全独立的进程。
1. 独立解释器与私有内存空间
当使用 multiprocessing.Process 或 ProcessPoolExecutor 启动子进程时,操作系统会为每一个子进程分配:
- 独立的进程 ID(PID):操作系统内核将其视为平等的独立程序实体。
- 独立的 CPython 解释器实例:每个进程拥有自己独享的 Python 虚拟机、内置类型表与垃圾回收器。
- 隔离的内存堆空间:子进程拥有自己独立的对象内存区域,子进程 A 修改对象的
ob_refcnt引用计数与子进程 B 没有任何关联。 - 私有的 GIL 锁:因为解释器实例彼此物理隔离,进程 1 拥有专属的
GIL-1,进程 2 拥有专属的GIL-2。每个子进程只在自己内部管理自己的线程,进程之间不存在任何互斥锁竞争。
2. 硬件层面的无干扰并行调度
一旦打破了解释器内部的共享锁枷锁,底层调度权就完全交还给了操作系统内核调度器(OS Kernel Scheduler)。当主进程派发出 4 个工作子进程时,操作系统会检测到有 4 个处于就绪状态的原生进程,并将它们分别绑定到 Core 0、Core 1、Core 2、Core 3 上同步全速推进。此时,各个核心的算力得以 100% 释放,实现真正的硬件级并行计算。
四、CPU 密集型任务改造多进程的标准步骤与实战
把单线程或多线程的 CPU 密集型任务改造成多进程,并不需要从底层重写逻辑。现代 Python 推荐使用 concurrent.futures.ProcessPoolExecutor,它提供了简洁、现代的高级抽象接口。整个实施流程可分为五个清晰步骤:
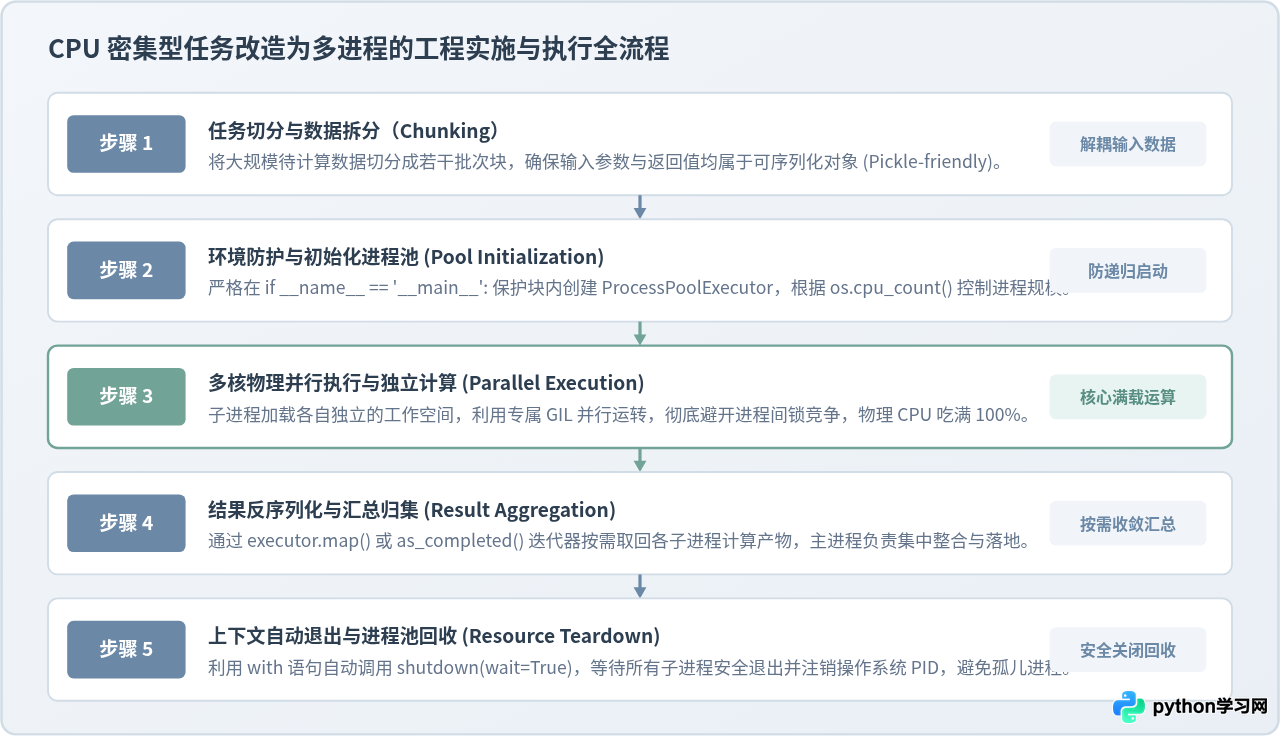
步骤 1:任务切分与数据准备(Chunking)
多进程无法直接像多线程那样在内存中直接读取共享对象指针。因此,计算函数必须设计为无状态的纯函数:输入明确的数据切片,输出计算好的独立结果。确保传递给函数的参数和返回值是可以用标准库 pickle 序列化的常规数据类型(如基础类型、列表、字典、NumPy 数组等)。
步骤 2:环境防护与初始化进程池
必须将进程池的创建与启动逻辑放在 if __name__ == '__main__': 保护块内部。这是多进程编程中最关键的安全边界,能够防止子进程在启动导入脚本时陷入无限递归创建进程的死循环。通常根据机器的可用物理核数(os.cpu_count())合理配置工作进程数。
步骤 3:多核独立并行运算
调用进程池的 map() 方法(适用于批量处理列表数据)或 submit() 方法(适用于单个异构任务提交),任务会被自动分发到后端的各个子进程中开始并行执行。
步骤 4:结果反序列化与汇总归集
工作进程计算完成后,结果数据通过底层的操作系统管道(Pipe)序列化回传给主进程。主进程接收到数据并反序列化,集中完成汇总、累加或持久化。
步骤 5:优雅关闭与资源回收
使用 Python 的 with 上下文管理器来管理进程池,当退出 with 作用域时,执行器会自动调用 shutdown(wait=True),安全释放进程池内的所有子进程资源,注销系统 PID,防止产生僵尸进程或孤儿进程。
工程规范实战范式
# 规范的多进程工程模版
import os
import math
from concurrent.futures import ProcessPoolExecutor

# 独立无副作用的纯计算函数
def process_data_chunk(chunk_data: list) -> int:
    local_sum = 0
    for num in chunk_data:
        local_sum += math.isqrt(num)
    return local_sum

def main():
    # 1. 准备待计算的大规模数据并拆分成 4 个块
    raw_numbers = list(range(1, 10_000_001))
    chunk_size = len(raw_numbers) // 4
    chunks = [raw_numbers[i:i + chunk_size] for i in range(0, len(raw_numbers), chunk_size)]

    workers = os.cpu_count() or 4
    print(f"检测到系统物理/逻辑核心数: {workers},开始启动多进程计算...")

    # 2. 初始化进程池并分发执行
    total_result = 0
    with ProcessPoolExecutor(max_workers=workers) as executor:
        # executor.map 会按顺序返回每个块的计算产物
        for partial_sum in executor.map(process_data_chunk, chunks):
            total_result += partial_sum

    print(f"最终计算汇总结果: {total_result}")

# 严格保护主入口
if __name__ == '__main__':
    main()
五、多进程带来的代价与避坑指南
多进程虽然成功攻克了 GIL 的束缚,但它并不是免费的银弹。在工程落地时,必须清楚它的开销与潜在缺陷。
if __name__ == '__main__': 保护在 Windows 和 macOS(Python 3.8+ 默认模式)系统下,多进程的默认启动方式为
spawn。子进程启动时会从头重新导入主模块文件。如果主程序中没有入口保护代码,子进程导入时又会执行创建进程的代码,瞬间导致系统递归派生数千个进程,直接引发内存溢出甚至导致系统假死崩溃(进程炸弹)。
1. 内存资源开销显著增加
多线程的每个线程只占用几百 KB 到几 MB 的栈内存,堆内存完全共用。而多进程的每个子进程都是一个完整的 Python 虚拟机实例,各自载入一套 Python 运行时环境和导入的第三方模块(如 NumPy、Pandas)。如果单进程内存占用为 200MB,开启 8 个进程的常驻内存开销就可能迅速突破 1.6GB。在内存紧张的容器(如 Docker)环境中,极易触发操作系统的 OOM Killer(内存溢出终止)。
2. 跨进程通信(IPC)与序列化性能瓶颈
多进程之间内存物理隔离,主进程向子进程传递参数、子进程向主进程返回结果,底层都必须依赖 Pickle 序列化 和 操作系统管道(Pipes / Sockets) 传递:
- 不可序列化对象无法跨进程传递:例如文件句柄、网络 Socket 连接、数据库连接对象、带有上下文闭包的某些局部函数或 Lambda 表达式,无法被 Pickle 打包,传递时会直接抛出
PicklingError。 - 大体积数据传输损耗高:如果主进程把一个 2GB 的 Pandas DataFrame 频繁作为参数传给 4 个子进程,系统将执行 4 次深层序列化与内存拷贝,导致 CPU 全在忙于数据搬运,反而抵消了并行计算带来的收益。此时应考虑使用
multiprocessing.shared_memory共享内存机制,或者让每个子进程各自独立读取磁盘分块。
六、总结与并发技术选型全景路线
面对具体的技术需求,选择多线程、多进程还是异步协程,本质上取决于业务瓶颈是落在 CPU 计算能力 还是 I/O 等待耗时 上。
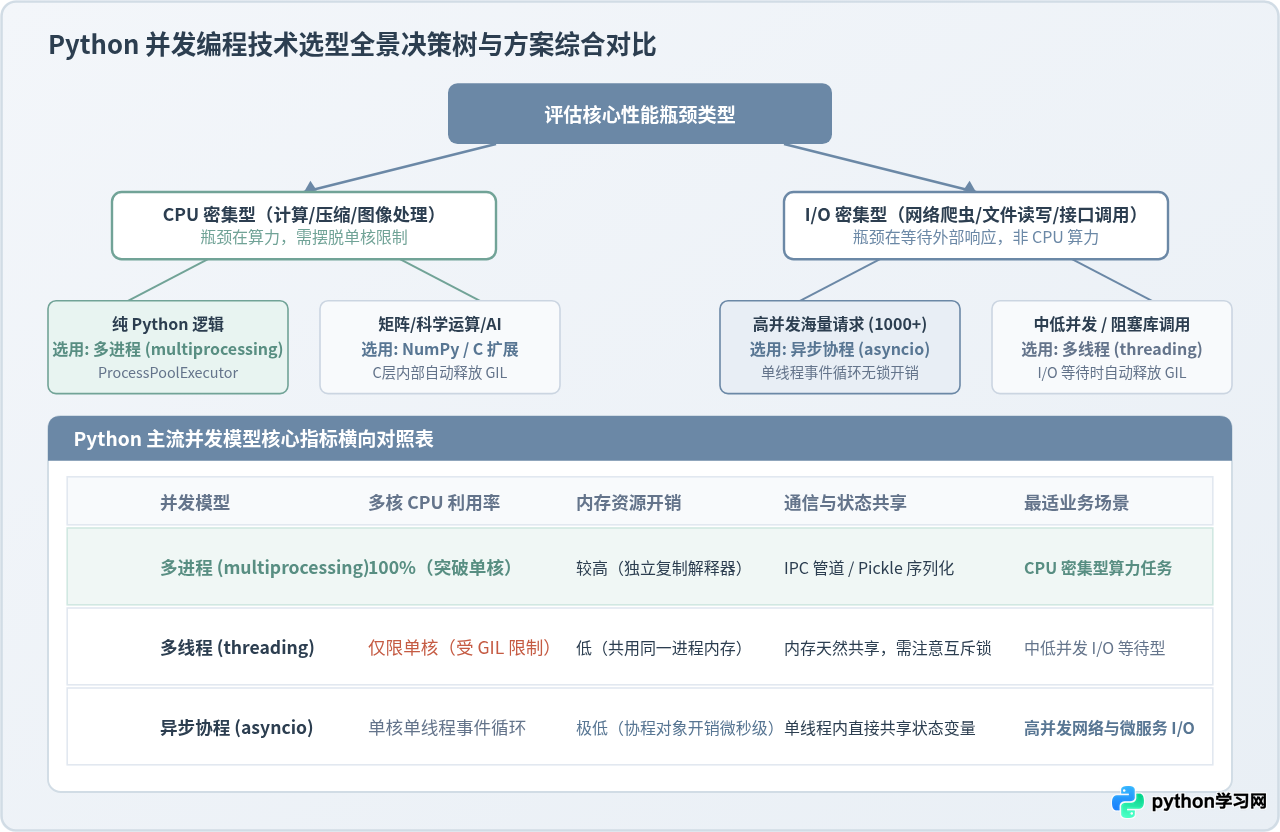
选型决策总结法则
- CPU 密集型(算力瓶颈):坚决使用 多进程(
multiprocessing/ProcessPoolExecutor)。如果涉及重度科学计算或矩阵运算,优先采用底层由 C/Fortran 编写的成熟库(如 NumPy、PyTorch),这些底层库在进入密集数学运算循环时会自动在 C 层释放 GIL,同样能直接跑满多核。 - I/O 密集型且并发极高(网络等待瓶颈):首选 异步协程(
asyncio)。单线程利用事件循环调度成千上万个非阻塞网络连接,内存开销最小,完全没有线程上下文切换和锁的损耗。 - I/O 密集型且包含阻塞式第三方库:使用 多线程(
threading/ThreadPoolExecutor)。在阻塞式 I/O 调用期间 Python 自动释放 GIL,编程心智模型简单,内存占用也远低于多进程。
Python 社区一直在积极推进摆脱 GIL 的方案: 1. 子解释器(Sub-interpreters / PEP 684):自 Python 3.12 起,标准库已在底层支持“每个解释器独立 GIL(Per-interpreter GIL)”,允许同进程内的多个解释器互不锁争用,未来可望兼顾低内存共享与多核并行。
2. 自由线程模式(Free-threaded CPython / PEP 703):自 Python 3.13 开始,官方提供了实验性的无 GIL 构建版本(
--disable-gil),通过偏向锁、非延迟引用计数等技术从根本上移除 GIL。虽然目前生态中第三方 C 扩展库对无 GIL 的兼容适配仍在推进中,但“多线程直接利用多核”正在逐步成为现实。而在现阶段的生产工程实践中,多进程依然是榨干多核 CPU 算力最稳定、最可靠的标准利器。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















