


Python爬虫在电商价格监控与竞品分析中的应用
深入讲解如何使用Python构建高可用电商价格监控与竞品分析系统,涵盖动态反爬穿透、券后真实到手价演算、跨平台同款SKU智能对齐及分级告警决策闭环。
一、电商价格监控的核心挑战与工程目标
在电商运营与精细化竞品分析场景中,价格是直接影响转化率与流量分配的核心杠杆。然而,直接编写爬虫请求商品详情页往往无法获得具备决策价值的真实数据。现实场景中存在三大核心痛点:
- 标价与实付价严重脱节:各大电商平台普遍采用复杂的“标价-店铺直降-平台品类券-跨店满减-会员专享”叠加促销机制。前端展示的标价往往比消费者最终结算的真实到手价高出 10% 到 30%。单纯抓取页面标价会导致虚假的竞品价格分析结论。
- 多 SKU 价格与库存歧义:同一 SPU 下挂载数十个不同的配置、颜色和套餐规格(SKU)。部分商家常设置极低价格的配件引流(如“手机壳套餐”标低价),若爬虫仅采集页面抓取到的最低展示价,将严重误判竞品的主力货品定价。
- 跨平台同款商品命名无序:同一款标品在不同平台乃至不同店铺中的标题差异极大。营销词(如“官方现货”、“百亿补贴”、“现货速发”)、修饰语与参数简写的交织,使得基于普通字符串完全匹配的分析机制彻底失效。
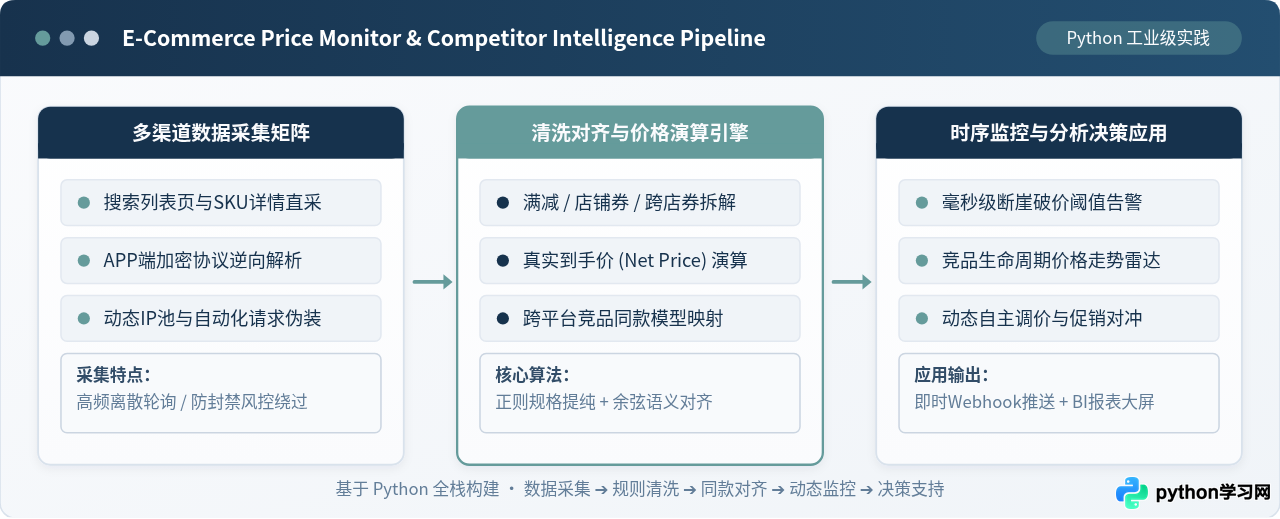
针对上述痛点,一套成熟的监控系统必须具备五大核心模块:多通道离散采集、网络风控穿透、促销规则逆向演算、跨平台特征归一化对齐,以及毫秒级异动告警引擎。
二、系统全链路架构与数据流转拓扑
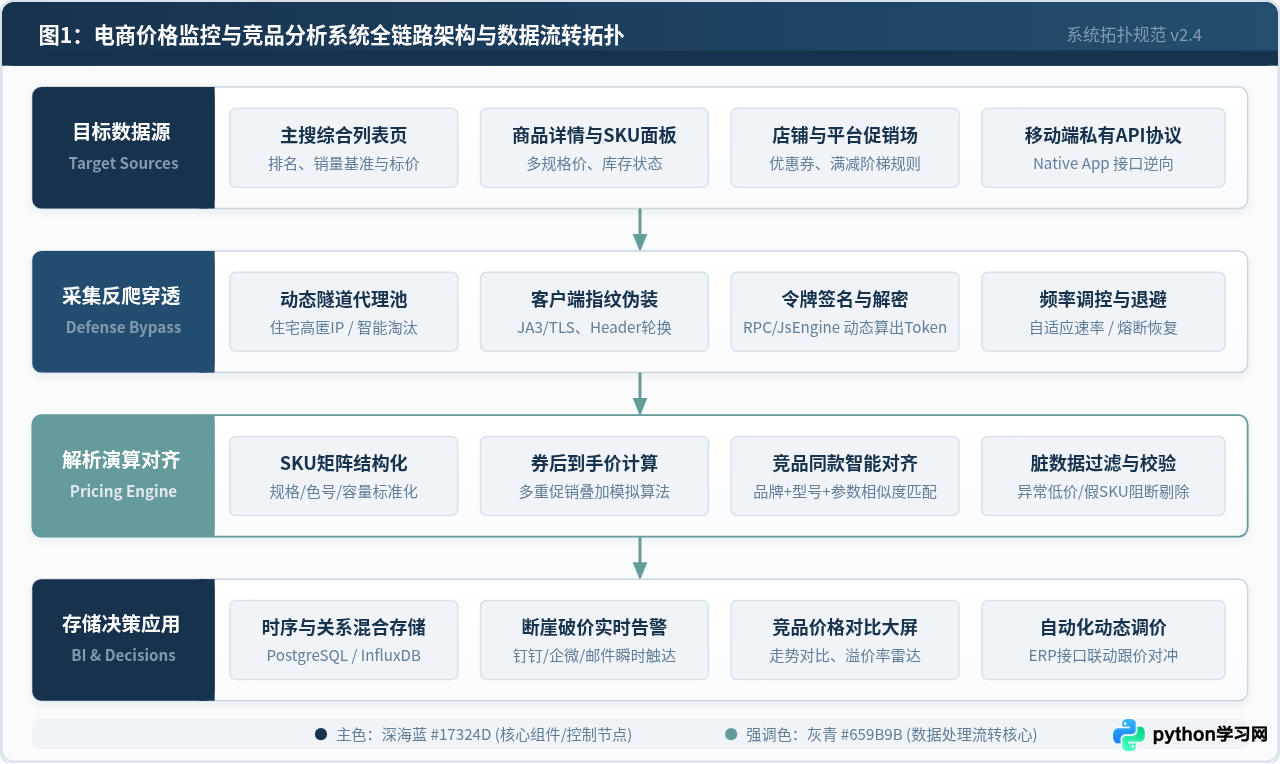
如上方图 1 所示,整套系统采用分层解耦的流水线架构,从底层数据源到顶层业务应用划分为四个严密的作业层级:
- 目标数据源层(Target Sources):监控范围覆盖综合搜索列表页(用于监控竞品排名与宏观活动标价)、SKU 详情接口(获取各细分规格的基准价与实际库存)、促销会场页面,以及移动端私有 Native API 协议通道。
- 采集与反爬防护穿透层(Acquisition & Defense Bypass):这是保障数据稳定产出的基础设施。通过动态隧道代理池提供海量住宅高匿 IP,配合客户端 TLS/JA3 指纹伪装与请求头随机化,使爬虫请求特征与真实移动端及浏览器流量保持一致;结合自适应请求退避与动态签名计算,彻底规避 IP 封禁与滑块验证阻断。
- 解析演算与竞品归一化层(Pricing Engine & Normalization):原始响应经过字段提纯,分别提取各规格 SKU 的吊牌价、划线价及促销规则清单;随后调用促销演算引擎,模拟最优优惠叠加路径,得出单件净到手价(Net Price);最后通过正则知识库与相似度算法,将竞品 SKU 映射绑定至标准品库。
- 时序存储与决策应用层(BI & Decisions):将清洗后的价格快照写入 PostgreSQL 或时序数据库 InfluxDB,计算价格变动振幅与斜率。若检测到异常断崖破价,立即通过 Webhook 推送钉钉/企业微信工作群,并联动 ERP 系统执行跟价或促销策略对冲。
三、采集实现:穿透反爬与结构化请求
电商平台的风控系统对高频请求极其敏感。现代爬虫实践已不再依赖笨重的单体自动化框架(如未做指纹伪装的 Selenium),而是优先采用逆向私有 API 配合高性能异步 HTTP 客户端(如 httpx),辅以完善的异常重试与指数退避机制。
在设计请求器时,必须重点关注以下三个工程细节:
- Session 复用与连接池管理:频繁建立 TCP/TLS 握手不仅消耗本地资源,还会被目标服务器标记为异常短连接。应为每个代理通道保持一个独立的
httpx.AsyncClient实例。 - 请求头指纹与动态令牌:确保
User-Agent、Accept-Language、sec-ch-ua等浏览器原生特征完整且一致,针对接口所需的动态签名(如sign、token),通过算法还原或本地 RPC 签名服务实时生成。 - 状态码与反爬特征熔断:遇到 HTTP 403、429 或返回“访问过于频繁”、“验证码校验”等文本时,必须主动判定为封禁信号,立即下线当前代理 IP 并执行退避,严防脏数据污染后续分析库。
import asyncio
import logging
import random
from typing import Dict, Any, Optional
import httpx

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

class RobustEcomCollector:
    # 具备动态退避与反爬状态检测的电商异步采集器

    def __init__(self, proxy_pool_url: Optional[str] = None):
        self.proxy_pool_url = proxy_pool_url
        self.headers_pool = [
            {
                "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/126.0.0.0 Safari/537.36",
                "Accept": "application/json, text/plain, */*",
                "Accept-Language": "zh-CN,zh;q=0.9",
            },
            {
                "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/125.0.0.0 Safari/537.36",
                "Accept": "application/json, text/plain, */*",
                "Accept-Language": "zh-CN,zh;q=0.8,en;q=0.6",
            }
        ]

    async def fetch_sku_detail(self, item_id: str, max_retries: int = 3) -> Optional[Dict[str, Any]]:
        # 请求指定商品的详细定价与促销数据,集成指数退避重试
        api_url = f"https://api.ecom-mock-target.com/detail/v2?sku_id={item_id}"

        for attempt in range(1, max_retries + 1):
            headers = random.choice(self.headers_pool)
            # 真实生产中通过代理池获取高匿名隧道代理
            proxy_mount = {"http://": "http://127.0.0.1:7890", "https://": "http://127.0.0.1:7890"} if self.proxy_pool_url else None

            try:
                async with httpx.AsyncClient(proxies=proxy_mount, timeout=8.0, follow_redirects=True) as client:
                    response = await client.get(api_url, headers=headers)

                    # 1. 验证响应状态
                    if response.status_code == 200:
                        payload = response.json()
                        # 2. 检查应用层风控特征
                        if payload.get("code") == 0 and "data" in payload:
                            return payload["data"]
                        elif payload.get("code") in [403, 10002]:
                            logging.warning(f"触发反爬滑块拦截 (ID: {item_id}),准备重试")
                        else:
                            logging.error(f"业务接口返回异常: {payload}")
                    elif response.status_code in [403, 429]:
                        logging.warning(f"HTTP状态码 {response.status_code} 触发频控熔断")

            except (httpx.RequestError, httpx.TimeoutException) as err:
                logging.warning(f"请求失败 [尝试 {attempt}/{max_retries}]: {err}")

            # 指数退避抖动等待: 2^(attempt-1) + 随机浮动
            backoff_delay = (2 ** (attempt - 1)) + random.uniform(0.5, 1.5)
            await asyncio.sleep(backoff_delay)

        logging.error(f"商品 {item_id} 经过 {max_retries} 次重试全部失败")
        return None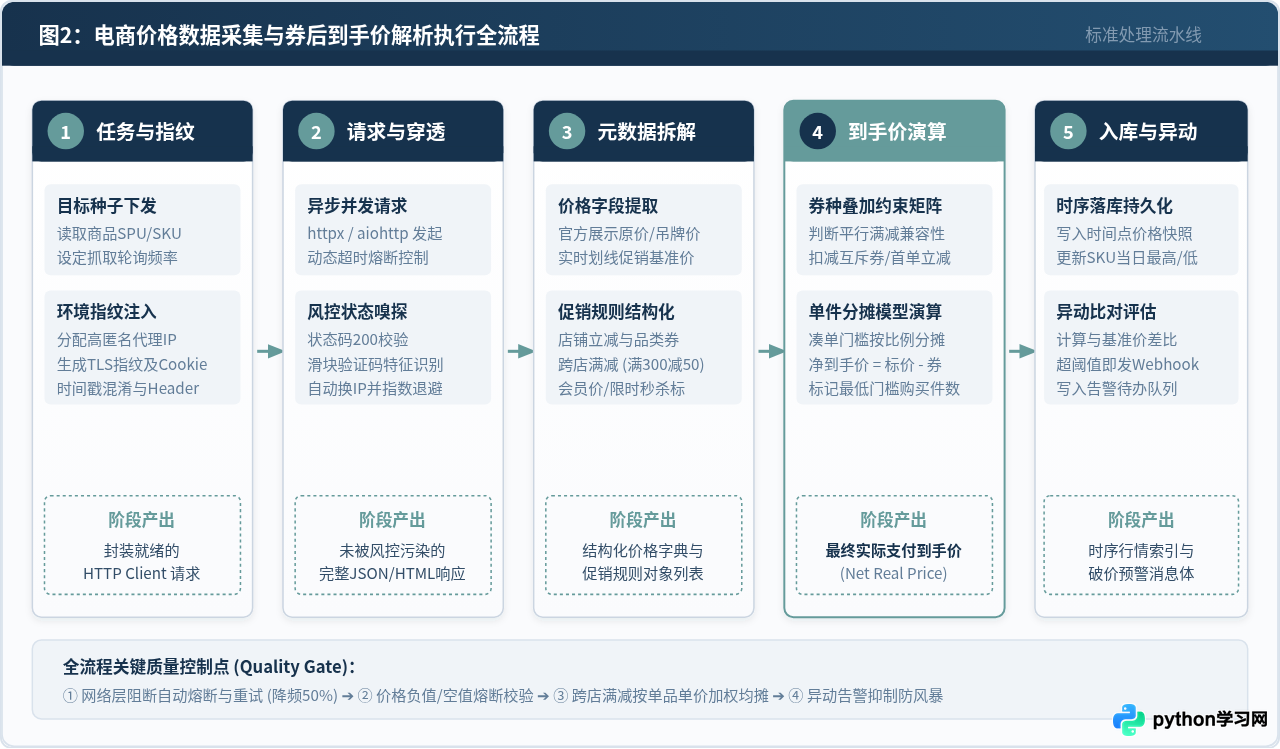
四、核心算法:优惠券叠加与券后到手价演算
采集到原始数据后,最核心的一环是优惠券与促销规则的多维拆解演算。如上方图 2 所示,完整的执行流程涵盖 5 个标准步骤:从种子分发、反爬探测应对、元数据提取,到最具技术含量的“券后到手价演算”与入库比对。
现代主流电商平台的优惠机制通常分为三个层级,且存在严密的计算优先级与互斥约束:
- 第一层:单品级立减 / 划线折让。例如“日常标价 ¥8,999,限时直降 ¥300”,此时商品基准核算价为 ¥8,699。
- 第二层:店铺级优惠券 / 阶梯满减。如“满 5,000 减 400 店铺券”。单品金额满足门槛时,可直接抵扣。
- 第三层:平台跨店津贴 / 品类满减。如“每满 300 减 50”或平台“百亿补贴消费券”。此类优惠券往往要求多件凑单,或在单件高额商品上按上限顶格抵扣。
from dataclasses import dataclass, field
from typing import List, Dict, Any

@dataclass
class CouponRule:
    coupon_id: str
    coupon_type: str  # 'SHOP_DISCOUNT', 'PLATFORM_REDUCE', 'SUBSIDY'
    threshold: float  # 使用门槛 (0表示无门槛)
    discount: float   # 减免金额
    is_stackable: bool = True  # 是否可叠加

@dataclass
class SkuPriceCalculationResult:
    sku_id: str
    sku_name: str
    original_price: float
    promotion_base_price: float
    final_net_price: float
    total_savings: float
    applied_coupons: List[str] = field(default_factory=list)

class EcomPricingEngine:
    # 电商促销叠加规则与到手价演算引擎

    @staticmethod
    def compute_net_price(sku_data: Dict[str, Any]) -> SkuPriceCalculationResult:
        sku_id = sku_data["sku_id"]
        sku_name = sku_data.get("spec_name", "默认规格")
        original_price = float(sku_data.get("original_price", 0.0))
        # 1. 单品立减后的活动基准价
        direct_discount = float(sku_data.get("direct_discount", 0.0))
        current_price = max(0.0, original_price - direct_discount)

        # 2. 提取并按优先级排序优惠券 (店铺券 -> 品类券 -> 跨店津贴)
        raw_coupons = sku_data.get("available_coupons", [])
        coupons = [
            CouponRule(
                coupon_id=c["id"],
                coupon_type=c["type"],
                threshold=float(c.get("threshold", 0)),
                discount=float(c.get("discount", 0)),
                is_stackable=c.get("stackable", True)
            )
            for c in raw_coupons
        ]

        # 3. 模拟最优叠加演算
        applied = []
        # A. 店铺券处理
        shop_coupons = [c for c in coupons if c.coupon_type == 'SHOP_DISCOUNT' and current_price >= c.threshold]
        if shop_coupons:
            best_shop_coupon = max(shop_coupons, key=lambda x: x.discount)
            current_price -= best_shop_coupon.discount
            applied.append(f"店铺券:-¥{best_shop_coupon.discount}")

        # B. 平台补贴与跨店券处理
        platform_coupons = [c for c in coupons if c.coupon_type in ['PLATFORM_REDUCE', 'SUBSIDY'] and current_price >= c.threshold]
        if platform_coupons:
            best_plat_coupon = max(platform_coupons, key=lambda x: x.discount)
            current_price -= best_plat_coupon.discount
            applied.append(f"平台券:-¥{best_plat_coupon.discount}")

        final_net_price = round(max(0.01, current_price), 2)
        total_savings = round(original_price - final_net_price, 2)

        return SkuPriceCalculationResult(
            sku_id=sku_id,
            sku_name=sku_name,
            original_price=original_price,
            promotion_base_price=round(original_price - direct_discount, 2),
            final_net_price=final_net_price,
            total_savings=total_savings,
            applied_coupons=applied
        )

# 示例验证执行
sample_sku = {
    "sku_id": "SKU_889102",
    "spec_name": "沙漠金 256GB 全网通",
    "original_price": 8999.0,
    "direct_discount": 300.0,  # 划线降300
    "available_coupons": [
        {"id": "CP_01", "type": "SHOP_DISCOUNT", "threshold": 5000.0, "discount": 400.0, "stackable": True},
        {"id": "CP_02", "type": "PLATFORM_REDUCE", "threshold": 8000.0, "discount": 500.0, "stackable": True}
    ]
}

calc_res = EcomPricingEngine.compute_net_price(sample_sku)
# 演算结果: 标价8999 -> 直降300 -> 店铺券400 -> 平台券500 -> 最终到手价: 7799.0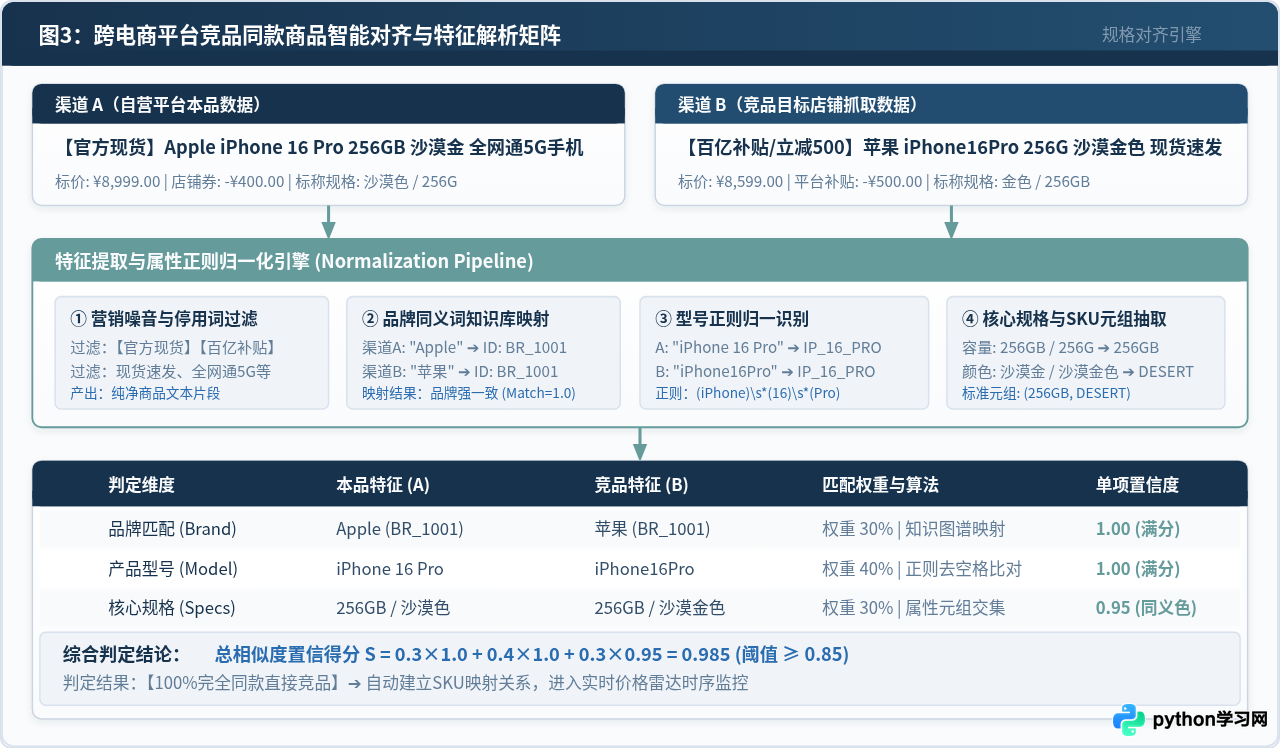
五、竞品归一化:跨平台同款匹配与特征对齐
抓取到多家平台的价格只是第一步。在竞品分析体系中,如果无法准确判断“渠道 A 的哪一个 SKU”对应“渠道 B 的哪一个 SKU”,所有价格走势和比价大屏都将失去基准。如上方图 3 所示,跨平台同款对齐需要依赖一个标准化的多维特征提取与置信度判定矩阵。
同款对齐的工业级处理管道包含以下四个关键阶段:
- 步骤一:停用词与营销干扰清洗。电商标题中普遍充斥着大量无关词汇,例如“【现货立减】”、“官方正品”、“限时包邮”、“速发”等。系统必须维护领域停用词表,通过正则表达式在分词前先行剔除这些噪声。
- 步骤二:品牌同义词知识库映射。不同平台对于品牌的写法存在中英文混杂问题(如“Apple”与“苹果”、“HUAWEI”与“华为”)。必须通过预设的品牌实体库,将所有输入统一映射为唯一的全局
Brand_ID。 - 步骤三:型号与规格参数正则抽取。型号是判定同款的刚性依据(如
iPhone 16 Pro与iPhone 16绝不可混淆)。利用编译好的模式串抽取核心配置元组(如存储容量256GB、网络制式、核心材质等)。 - 步骤四:分权置信度综合判定。根据业务特性赋予不同维度权重。通常:品牌匹配度占 30%(一票否决制),型号匹配度占 40%,核心配置参数占 30%。只有综合得分 S ≥ 0.85 的商品才会被系统判定为同一款可比竞品。
import re
from typing import Dict, Tuple, Optional

class ProductMatcher:
    # 跨平台竞品同款属性提取与相似度评分器

    BRAND_MAP = {
        "apple": "BR_APPLE",
        "苹果": "BR_APPLE",
        "huawei": "BR_HUAWEI",
        "华为": "BR_HUAWEI",
        "xiaomi": "BR_XIAOMI",
        "小米": "BR_XIAOMI"
    }

    STOP_WORDS = [r"【.*?】", r"\[.*?\]", r"现货速发", r"官方正品", r"百亿补贴", r"限时立减", r"全网通5G", r"包邮"]

    @classmethod
    def clean_title(cls, title: str) -> str:
        # 剔除营销停用词与多余标点
        cleaned = title
        for pattern in cls.STOP_WORDS:
            cleaned = re.sub(pattern, " ", cleaned, flags=re.IGNORECASE)
        return " ".join(cleaned.split())

    @classmethod
    def extract_brand(cls, text: str) -> Optional[str]:
        for kw, brand_id in cls.BRAND_MAP.items():
            if re.search(rf"{kw}", text, re.IGNORECASE) or kw in text:
                return brand_id
        return None

    @classmethod
    def extract_specs(cls, text: str) -> Dict[str, str]:
        # 正则抽取容量与颜色规格
        specs = {}
        # 提取存储容量: 如 128G, 256GB, 1TB
        cap_match = re.search(r"(\d+(?:GB|G|TB))", text, re.IGNORECASE)
        if cap_match:
            cap = cap_match.group(1).upper()
            if cap.endswith("G") and not cap.endswith("GB"):
                cap = cap + "B"
            specs["capacity"] = cap

        # 提取颜色特征
        colors = ["沙漠金", "钛原色", "黑色钛金属", "白色", "暗夜黑"]
        for c in colors:
            if c in text:
                specs["color"] = c
                break
        return specs

    @classmethod
    def compute_match_score(cls, title_a: str, title_b: str) -> Tuple[float, bool]:
        # 计算两款商品是否为同款,返回 (置信得分, 是否判定为同款)
        clean_a = cls.clean_title(title_a)
        clean_b = cls.clean_title(title_b)

        # 1. 品牌强校验 (权重 0.3)
        brand_a = cls.extract_brand(clean_a)
        brand_b = cls.extract_brand(clean_b)
        if not brand_a or not brand_b or brand_a != brand_b:
            return 0.0, False
        brand_score = 1.0

        # 2. 型号匹配 (权重 0.4)
        model_pattern = r"iPhone\s*16\s*Pro"
        has_model_a = bool(re.search(model_pattern, clean_a, re.IGNORECASE))
        has_model_b = bool(re.search(model_pattern, clean_b, re.IGNORECASE))
        model_score = 1.0 if (has_model_a and has_model_b) else 0.0
        if model_score == 0.0:
            return 0.3 * brand_score, False

        # 3. 规格参数强校验 (权重 0.3)
        specs_a = cls.extract_specs(clean_a)
        specs_b = cls.extract_specs(clean_b)

        spec_matches = 0
        total_spec_keys = max(len(specs_a), 1)
        for k, v in specs_a.items():
            if specs_b.get(k) == v:
                spec_matches += 1
        spec_score = spec_matches / total_spec_keys

        # 加权置信度
        total_score = round(0.3 * brand_score + 0.4 * model_score + 0.3 * spec_score, 3)
        is_matched = total_score >= 0.85
        return total_score, is_matched

# 测试样例验证
t1 = "【官方现货】Apple iPhone 16 Pro 256GB 沙漠金 全网通5G手机"
t2 = "【百亿补贴/立减500】苹果 iPhone16Pro 256G 沙漠金 现货速发"
score, matched = ProductMatcher.compute_match_score(t1, t2)
# 输出: score: 1.0, matched: True (判定为同款竞品)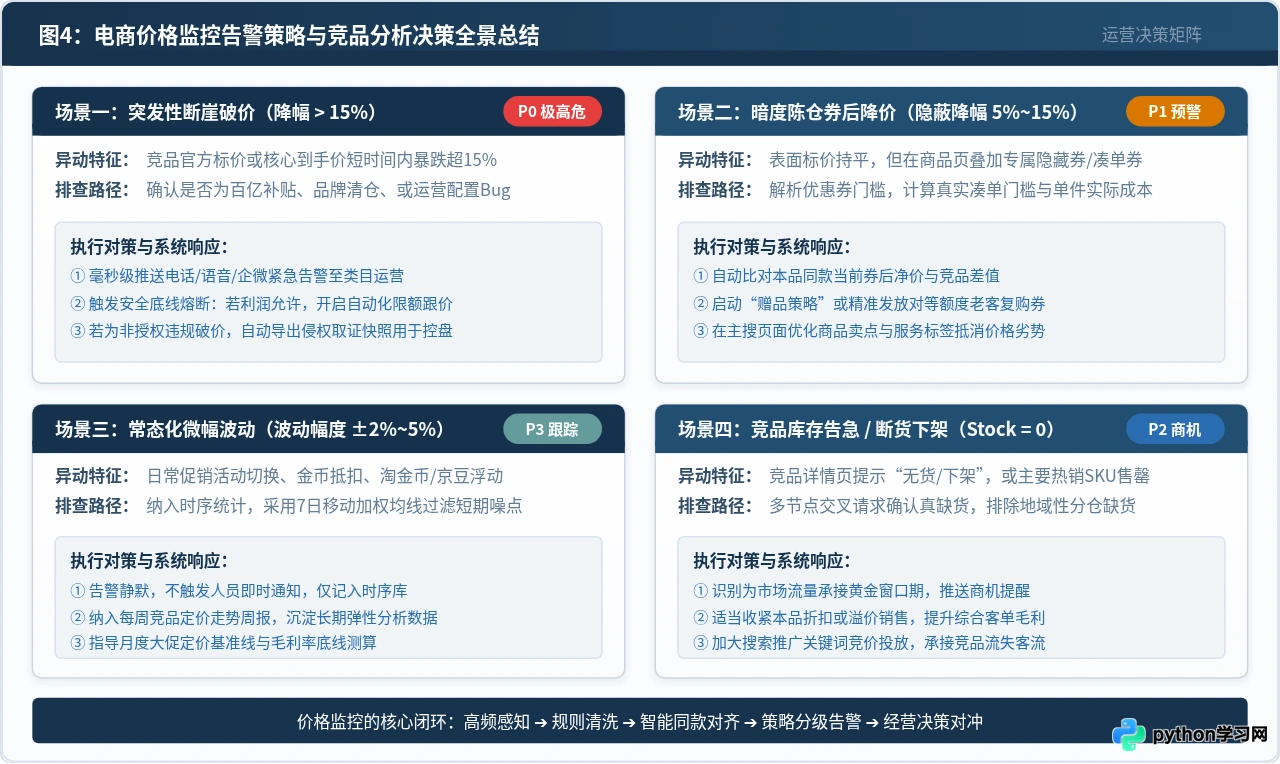
六、时序存储、异动告警与经营决策闭环
采集与对齐的最终目的是服务于日常经营决策与风险控制。如上方图 4 总结,监控系统根据价格异动形态与商业风险等级,将预警与应对动作明确划分为四个标准场景:
| 场景分类 | 异动特征与阈值 | 告警级别 | 系统自动化响应 | 业务端决策对策 |
|---|---|---|---|---|
| 突发断崖破价 | 竞品核心 SKU 到手价瞬时降幅 > 15% | P0 极高危 | 毫秒级推送企微/电话告警;触发利润保护熔断底线 | 核查是否为非授权窜货;利润允许时开启限额自动化跟价 |
| 暗度陈仓券后降价 | 表面标价稳定,暗中叠加专属隐藏券/满减 | P1 预警 | 自动测算实际券后价差与分摊成本;模拟加购真实性 | 启动赠品策略或定向针对老客发放抵扣券抵消劣势 |
| 常态微幅波动 | 日常价格在 ±2%~5% 区间内小幅波动 | P3 跟踪 | 静默入库,采用 7 日移动平均线平滑短期随机噪声 | 纳入每周竞品走势看板,用于评估月度大促定价基准 |
| 竞品库存告急/断货 | 竞品核心 SKU 状态变为“缺货/下架” | P2 商机 | 跨节点复测排除分仓缺货;识别为流量承接窗口 | 适度收紧本品折扣扩大毛利;加大搜索推广竞价抢占客流 |
在底层存储选型上,建议采用关系型数据库(如 PostgreSQL)存储商品元数据、SKU 映射关系与告警规则,配合时序表或 TimescaleDB 插件记录密集的价格流水快照。数据表核心结构如下:
-- 1. 标准商品库与映射对齐表
CREATE TABLE IF NOT EXISTS standard_product_mapping (
    id SERIAL PRIMARY KEY,
    standard_sku_id VARCHAR(64) NOT NULL,
    channel_name VARCHAR(32) NOT NULL,      -- 'JD', 'TMALL', 'PDD'
    channel_sku_id VARCHAR(64) NOT NULL,
    product_title VARCHAR(255) NOT NULL,
    brand_code VARCHAR(32) NOT NULL,
    spec_attributes JSONB,                 -- {"capacity": "256GB", "color": "沙漠金"}
    match_confidence NUMERIC(4, 3),        -- 0.985
    created_at TIMESTAMP WITH TIME ZONE DEFAULT CURRENT_TIMESTAMP,
    UNIQUE(channel_name, channel_sku_id)
);

-- 2. 价格时序快照流水表
CREATE TABLE IF NOT EXISTS sku_price_timeseries (
    time TIMESTAMP WITH TIME ZONE NOT NULL,
    channel_sku_id VARCHAR(64) NOT NULL,
    original_price NUMERIC(10, 2) NOT NULL,
    promotion_base_price NUMERIC(10, 2) NOT NULL,
    final_net_price NUMERIC(10, 2) NOT NULL,
    stock_status INT DEFAULT 1,             -- 1: 有货, 0: 无货
    applied_coupon_summary TEXT,
    PRIMARY KEY(time, channel_sku_id)
);

-- 3. 价格异动事件与告警记录表
CREATE TABLE IF NOT EXISTS price_alert_events (
    event_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    channel_sku_id VARCHAR(64) NOT NULL,
    alert_level VARCHAR(8) NOT NULL,        -- 'P0', 'P1', 'P2', 'P3'
    previous_price NUMERIC(10, 2) NOT NULL,
    current_price NUMERIC(10, 2) NOT NULL,
    price_change_rate NUMERIC(5, 4) NOT NULL, -- -0.1520
    is_handled BOOLEAN DEFAULT FALSE,
    notified_at TIMESTAMP WITH TIME ZONE DEFAULT CURRENT_TIMESTAMP
);
七、生产运维与合规边界
将价格监控系统投入持续稳定的工业级运行,必须兼顾系统自身的健壮性与合规边界:
- 礼貌抓取与频率调控:严格遵循最小必要原则。价格监控不需要“每秒刷十次”的侵略性请求。结合商品销售生命周期,日常以 30~60 分钟为轮询周期,大促预售或整点变价期缩短至 5~10 分钟。严格限制单 IP 并发数,避免对目标平台服务器造成不合理负载。
- 协议变更自愈机制(Schema Drift Detection):电商前端接口常伴随版本迭代发生字段名变更或加密盐值更新。系统必须建立“数据质量监控探针”。一旦发现某平台连续 5 个请求解析出 0 个价格或价格为负数,立即触发内部研发报警,暂停该渠道任务,防止误发雪崩式告警。
- 数据应用合规:采集的数据仅用于企业内部正当的市场分析、供需预测与自身定价策略优化;不侵犯个人隐私,严禁将未脱敏数据用于不正当竞争或非法转售。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















