


Python面试常考哪些高阶内容?底层原理与并发编程的学习必要性分析
深度梳理Python高阶面试常考知识体系,系统剖析底层对象模型、内存池、三代GC与GIL运行机理,详细论证并发编程与底层原理的学习必要性,并提供生产级故障排查与面试应对路径。
一、Python 高阶面试常考知识体系全景梳理
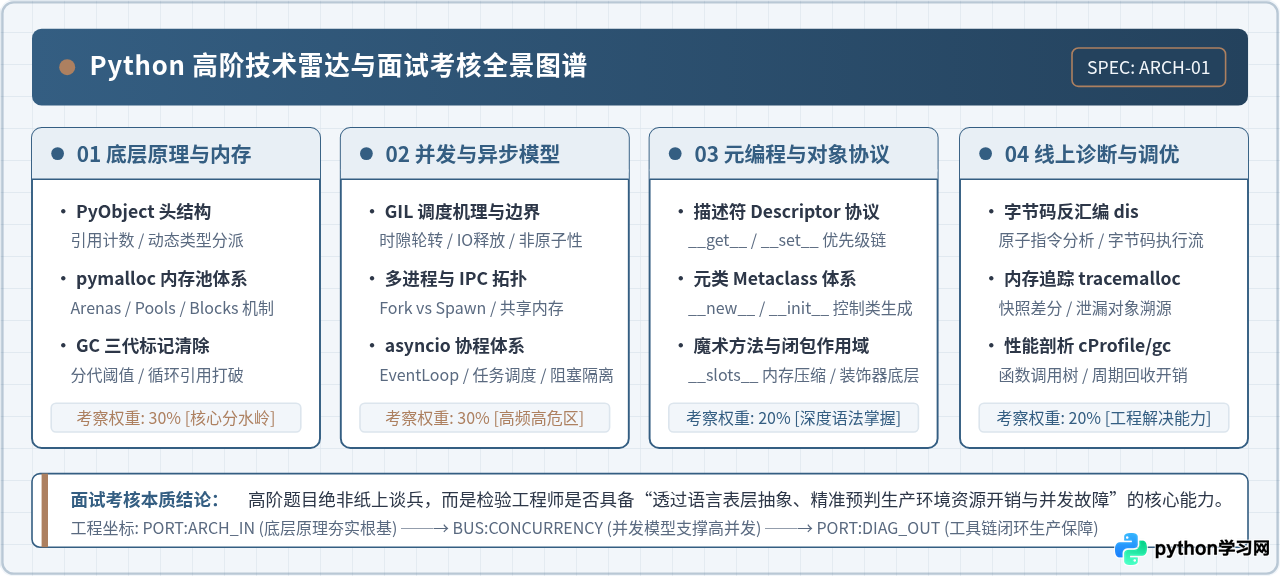
在技术面试中,当候选人的基础语法表达熟练后,考察重心会迅速从“如何实现某个功能”转向“该功能在解释器内如何运转”以及“极端并发与高负载下的系统表现”。综合各类中高级技术岗位考核要求,高阶考察内容主要集中在以下四个核心模块:
1. 内部运行机制与内存管理模型
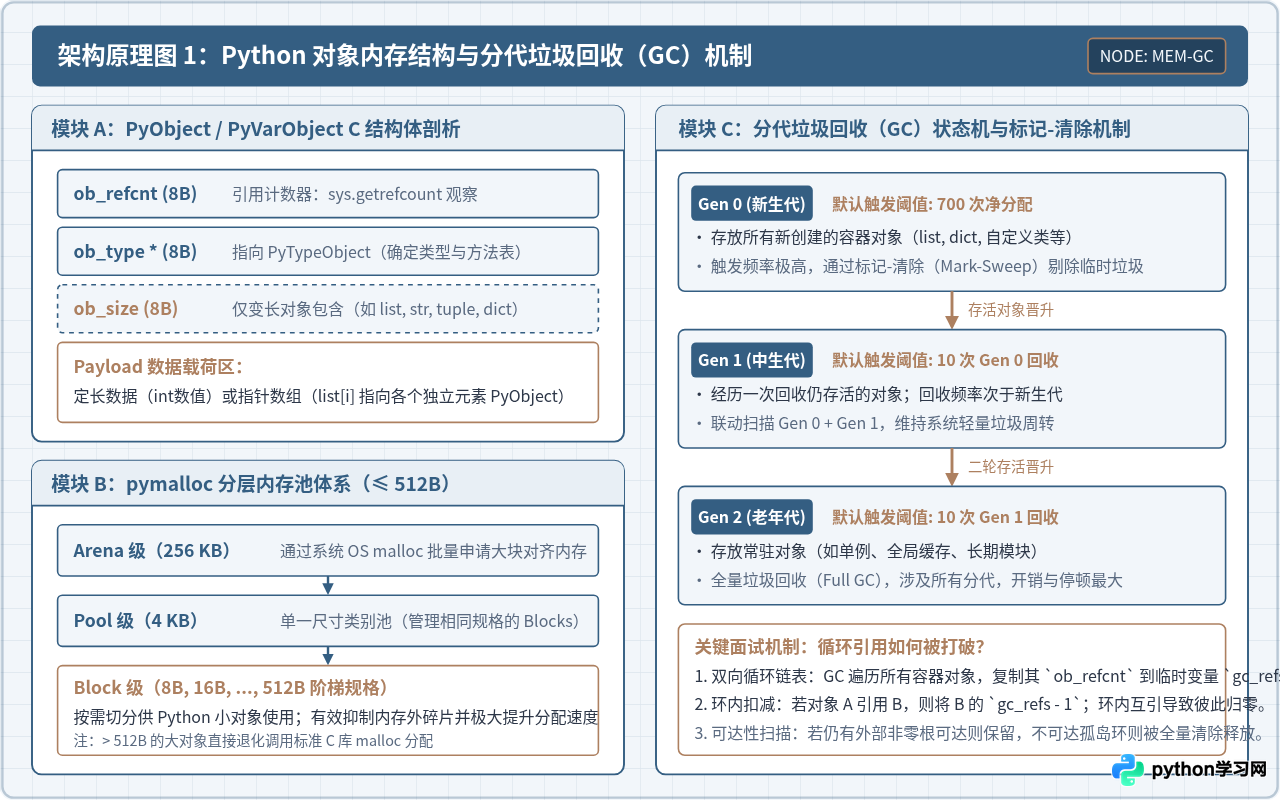
Python 是具备自动垃圾回收的动态语言,但高级工程师必须明确对象在 CPython 中的真实物理存在形式。常考细节包括:
- PyObject 与 PyVarObject 结构:在 C 源码层级,每个 Python 核心对象均包含公共头部。定长对象包含引用计数器
ob_refcnt与类型指针ob_type(共 16 字节);变长对象(如str、list、dict)额外包含长度字段ob_size(共 24 字节头部)。面试常以此切入考查动态类型分派原理。 - 小整数对象池与常量驻留机制:CPython 默认预分配
[-5, 256]区间内的整数对象并长期驻留内存;短字符串启用 intern 机制。考察重点在于is(指针内存地址比较)与==(内容相等性比较)的本质差异。 - pymalloc 分层内存池体系:针对小对象(≤ 512 字节),CPython 实现了三层内存分配器(Arena 256KB、Pool 4KB、Block 8~512B 阶梯),避免频繁向操作系统申请内存产生外部碎片;大于 512 字节的对象才直接调用标准 C 库的
malloc。 - 引用计数为主、分代收集(GC)为辅的回收体系:对象引用计数归零时立即释放;无法解决的孤岛循环引用则依赖分代垃圾回收器通过标记-清除(Mark-Sweep)机制处理。
2. 并发与异步模型
高并发是服务后端、分布式爬虫及数据处理系统的必考领域。面试官通常会检验候选人是否能跳出框架,从操作系统线程与事件驱动底层做出清晰论述:
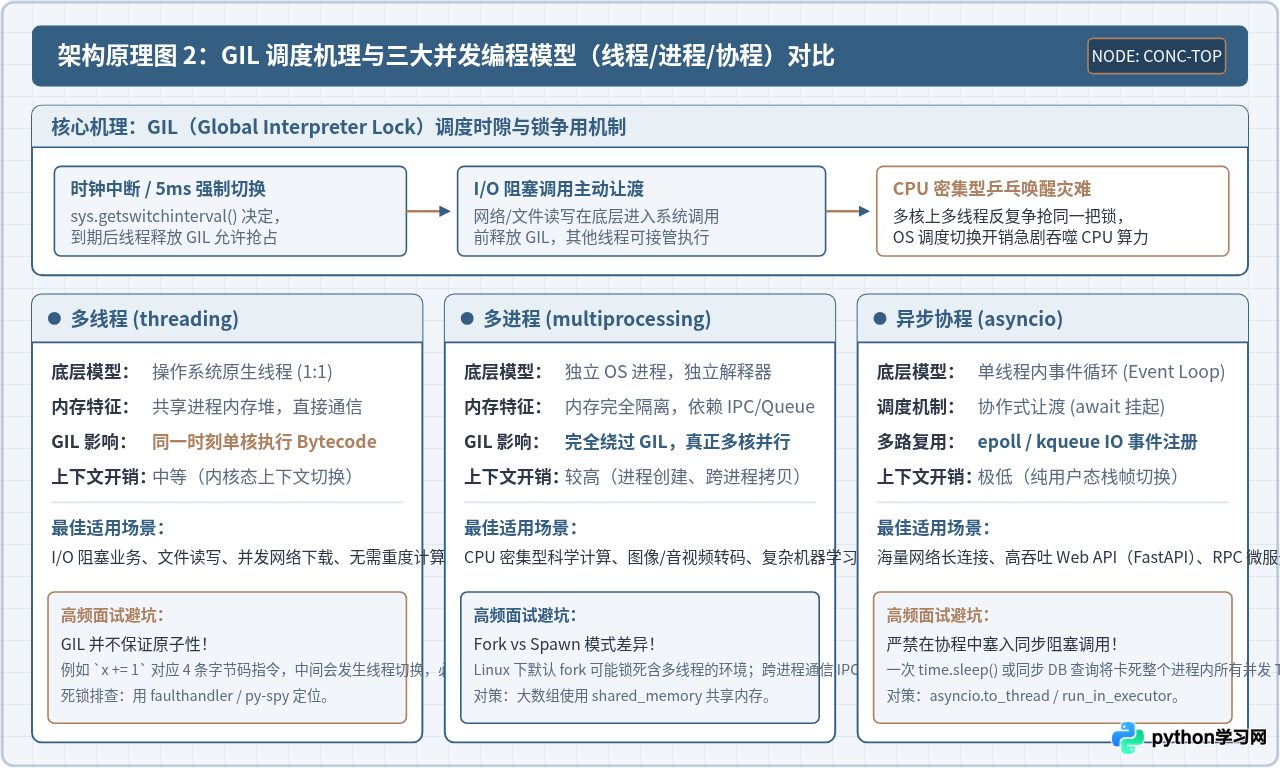
- GIL(全局解释器锁)的内部机理:GIL 是 CPython 进程级的互斥锁,确保同一时刻仅有一个系统原生线程执行 Python 字节码。其释放条件涵盖:执行时钟周期到期(
sys.getswitchinterval()默认 5 毫秒)、遇到阻塞式 I/O 调用时主动退避让渡。 - 多线程(threading)的真实边界:适合 I/O 密集型任务;在多核 CPU 密集型任务下不仅无法实现多核加速,还会因严重的锁争用和线程乒乓调度引起执行速度倒退。
- 多进程(multiprocessing)与进程间通信(IPC):绕过 GIL 实现物理多核并行的代价是进程独立的地址空间与 IPC 序列化(Pickle)开销;Linux 默认的
fork与跨平台推荐的spawn启动模式存在显著的行为差异。 - 异步协程(asyncio)底层调度:基于单线程内的事件循环(Event Loop)与底层系统的多路复用技术(Linux
epoll、macOSkqueue),通过协作式await让出控制权,实现单机百万长连接的高吞吐处理。
3. 语言高级特性与元编程
该部分考察候选人设计架构抽象与编写框架级代码的能力:
- 描述符(Descriptor)协议:实现了
__get__、__set__或__delete__的类。面试常考数据描述符(Data Descriptor)与非数据描述符的属性查找优先级链条:__getattribute__-> 数据描述符 -> 实例字典__dict__-> 非数据描述符 -> 类字典 ->__getattr__。 - 元类(Metaclass):类的创建模板。深度剖析
type作为所有类的默认元类,掌握自定义元类中重写__new__(创建类对象本身)与__init__(初始化类属性)以完成接口校验与 ORM 字段映射的流程。 __slots__内存压缩机制:通过在类定义中指定__slots__,禁止动态创建__dict__,改用固定长度的结构体数组存储属性引用,在大规模对象场景下可节省 60% 以上内存。
4. 生产级性能瓶颈与排查工具链
能否使用科学工具验证代码行为,是检验工程功底的试金石。包括使用 dis 模块反汇编 Python 字节码,使用 tracemalloc 追踪内存分配快照,以及利用 cProfile 与 py-spy 采集调用栈。
二、深度剖析:为什么面试官热衷于考察底层原理?
不少开发者会有疑惑:日常开发中各种 Web 框架与 ORM 已经高度封装,为什么面试依然不断追问底层结构?答案在于:高级工程师与普通开发者的技术分水岭,正是在于当黑盒抽象失效、系统出现线上诡异性能抖动或内存泄漏时,是否具备直接穿透表象定位根因的能力。
1. 底层原理是排查生产隐蔽 Bug 与内存泄漏的唯一依据
许多开发者误以为 Python 有自动垃圾回收就不会发生内存泄漏。但现实中,循环引用加上非预期的引用链残留,是线上服务常驻内存持续攀升的重灾区。
观察以下常见的类循环引用现象:
import sys
import gc

class Node:
    def __init__(self, name):
        self.name = name
        self.parent = None
        self.children = []

# 创建父子循环引用
parent = Node("parent")
child = Node("child")
parent.children.append(child)
child.parent = parent

# 删除局部作用域引用
del parent
del child

# 此时两个对象的引用计数由于互引均为 1,无法立即触发 refcnt==0 析构!
# 必须等待分代 GC 扫描 Gen 0 触发标记-清除
print(f"当前未回收的不可达对象数量: {gc.collect()}")当前未回收的不可达对象数量: 2
如果在循环引用的对象中定义了历史遗留的 __del__ 析构方法(在早于 Python 3.4 的 PEP 442 前),垃圾回收器因无法判定析构顺序,会将对象放入 gc.garbage 列表中拒绝销毁,从而造成永久性内存泄漏。在大型工程中,理解这一底层机制后,成熟团队会规范使用 weakref(弱引用模块)解耦父子引用链,从设计根源上消除隐患。
2. 极限空间开销优化:__slots__ 的底层工程价值
在微服务或大规模批处理流水线中,单节点可能常驻数百万个轻量业务实体对象。默认情况下,每个 Python 实例都会拥有一个独立的 __dict__ 散列表用于支持动态绑定属性。散列表为了降低哈希碰撞概率,存在大量预留槽位,导致单个空对象的内存开销便达到上百字节。
我们通过具体的度量代码查看内存占用差异:
import sys

class DefaultPoint:
    def __init__(self, x, y):
        self.x = x
        self.y = y

class SlottedPoint:
    __slots__ = ('x', 'y')
    def __init__(self, x, y):
        self.x = x
        self.y = y

p_default = DefaultPoint(10, 20)
p_slotted = SlottedPoint(10, 20)

# 计算对象本身与其 __dict__ 的总内存开销
default_size = sys.getsizeof(p_default) + sys.getsizeof(p_default.__dict__)
slotted_size = sys.getsizeof(p_slotted)

print(f"默认类实例内存占用: {default_size} 字节 (含 __dict__ 动态哈希表)")
print(f"__slots__ 实例内存占用: {slotted_size} 字节 (仅结构体固定偏移)")
print(f"单实例内存节约比例: {(default_size - slotted_size) / default_size * 100:.1f}%")默认类实例内存占用: 152 字节 (含 __dict__ 动态哈希表)
__slots__ 实例内存占用: 48 字节 (仅结构体固定偏移)
单实例内存节约比例: 68.4%
__slots__ 会关闭实例的动态属性赋值,且子类继承时若不显式声明 __slots__ 会重新恢复 __dict__。只有真正理解 CPython 底层结构体布局与属性查找流程的工程师,才能在合适的高并发、高基数缓存场景中安全使用该优化,避免误伤业务扩展性。
三、业务驱动:深入并发编程的学习必要性与避坑指南
业务系统从单机单任务向分布式高并发演化时,并发编程是不可跨越的核心关卡。深入理解并发模型之所以是面试必考,是因为多线程、多进程和异步协程在 Python 体系中各自存在显著的物理缺陷与严格的适用边界,选型错误或代码细节疏忽会导致极为致命的线上瘫痪。
1. 破除认知误区:GIL 并没有让多线程操作具备原子性
许多初中级开发者在面试中常犯一个经典错误:“既然 Python 有 GIL 保证同一时刻只有一个线程在运行,那么简单的累加操作 count += 1 是不是天然线程安全,不需要加锁?”
答案是否定的。GIL 保护的是 CPython 解释器自身的内部状态(如对象引用计数器),而不是用户代码层面的逻辑原子性。我们使用 Python 内置的 dis 模块反汇编 count += 1 的执行过程:
import dis

count = 0

def increment():
    global count
    count += 1

dis.dis(increment)6 0 LOAD_GLOBAL 0 (count)
2 LOAD_CONST 1 (1)
4 INPLACE_ADD
6 STORE_GLOBAL 0 (count)
8 LOAD_CONST 0 (None)
10 RETURN_VALUE
从字节码可以清晰看到,一行看似简单的 count += 1 实际被拆解为了四条独立的底层字节码指令:
LOAD_GLOBAL:从全局命名空间加载count的当前值入操作数栈;LOAD_CONST:将常量1入栈;INPLACE_ADD:执行就地相加计算;STORE_GLOBAL:将计算结果存回count。
当线程 A 刚执行完 INPLACE_ADD,若恰逢 5ms 切换时间片到期或时钟中断,解释器会挂起线程 A 并切换到线程 B。线程 B 读到了旧的 count 值完成计算并写回;随后线程 A 恢复执行,将其之前计算的过期值同样写回 STORE_GLOBAL,导致线程 B 的修改被静默覆盖,引发典型的数据丢失与竞态冒险(Race Condition)。
结论:在多线程共享状态的修改场景中,必须显式引入 threading.Lock 互斥锁,或者改用线程安全的 queue.Queue。
2. 异步编程(asyncio)的核心机制与“阻塞污染”事故
随着 FastAPI、Sanic、Tornado 等异步框架的普及,异步协程已成为高吞吐 Web 服务的标配。然而,如果在异步体系中误入了同步阻塞调用,会带来比单线程更恶劣的系统性雪崩。
这是因为 asyncio 运行在单线程单进程内。事件循环维护着一个就绪 Task 队列,只有当某个 Task 执行到 await 挂起点并等待底层 I/O 多路复用返回时,事件循环才会转而执行队列中的下一个 Task。
async def handle_request() 中写了一句 time.sleep(2),或者调用了同步的 requests.get(),或者执行了耗时 500ms 的复杂密码哈希计算,那么整个进程的事件循环会被完全冻结整整该时长!在此期间,所有其他并发客户端的握手、数据接收及定时任务全被卡死,P99 延迟瞬间飙升。
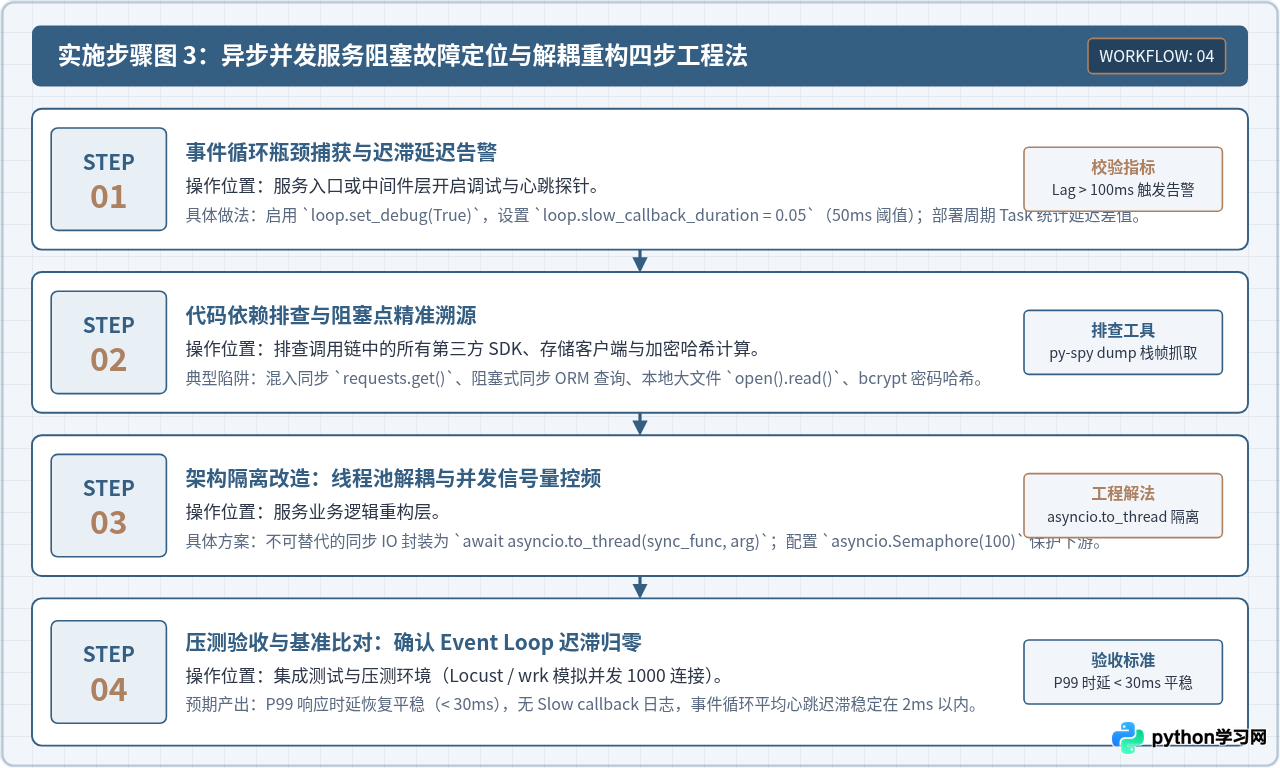
四、实操实施:异步并发阻塞排查与工程改造四步法
在实际生产环境中,若排查到事件循环卡顿,推荐按照以下规范化的四步法执行改造排查:
第一步:开启事件循环调试模式,捕获慢回调报警
在开发与灰度测试环境下,显式开启事件循环调试模式,并将慢回调判断阈值设置为 50ms。只要某个协程单次未让渡时间超过该阈值,解释器就会在日志中输出警告与堆栈溯源:
import asyncio
import logging

logging.basicConfig(level=logging.WARNING)

# 获取主事件循环并开启调试
loop = asyncio.new_event_loop()
asyncio.set_event_loop(loop)
loop.set_debug(True)

# 设置慢回调告警阈值为 50 毫秒(默认值为 100ms)
loop.slow_callback_duration = 0.05
第二步:定位并隔离不可替代的同步阻塞调用
在真实的存量系统中,往往存在无法立即替换为纯异步的第三方 SDK(如某银行同步接口、老版数据库驱动)。此时切忌直接在协程中调用,必须将其剥离并委托给独立的线程池。
Python 3.9+ 提供了官方标准方案 asyncio.to_thread,底层会自动调用 ThreadPoolExecutor 执行同步函数,同时主事件循环保持非阻塞响应:
import asyncio
import time

def legacy_sync_query(param):
    """模拟无法重写的遗留同步阻塞 SDK"""
    time.sleep(0.5)  # 同步阻塞 500ms
    return f"result: {param * 2}"

async def safe_api_handler(user_id):
    # 正确工程解法:使用 asyncio.to_thread 移出主事件循环线程
    result = await asyncio.to_thread(legacy_sync_query, user_id)
    return result

async def main():
    # 并发调度 5 个请求,主事件循环顺畅并发,耗时仅约 0.5s 而非 2.5s
    tasks = [safe_api_handler(i) for i in range(5)]
    results = await asyncio.gather(*tasks)
    print("并发执行结果:", results)

asyncio.run(main())并发执行结果: ['result: 0', 'result: 2', 'result: 4', 'result: 6', 'result: 8']
第三步:引入并发度限流(Semaphore),防止线程池与连接耗尽
将阻塞代码放入线程池并不意味着可以无限制并发。过度并发会导致系统上下文切换过载或打垮下游依赖,必须配合 asyncio.Semaphore 设立并发防护闸门:
import asyncio

# 限制最大同时处理的底层工作并发量为 10
semaphore = asyncio.Semaphore(10)

async def throttled_worker(task_id):
    async with semaphore:
        # 在受控并发门禁内执行业务
        return await asyncio.to_thread(legacy_sync_query, task_id)
第四步:压测与性能基准回归验证
改造完成后,使用压测工具(如 Locust 或 wrk)模拟线上典型并发连接。验证指标包括:
- 事件循环的平均心跳延迟(EventLoop Lag)保持在 5ms 以内;
- 无
Executing <Task ...> took X.XX seconds报警; - 接口 P99 响应耗时与系统 CPU 使用率符合并发预期。
五、高阶面试应对策略与学习路径规划
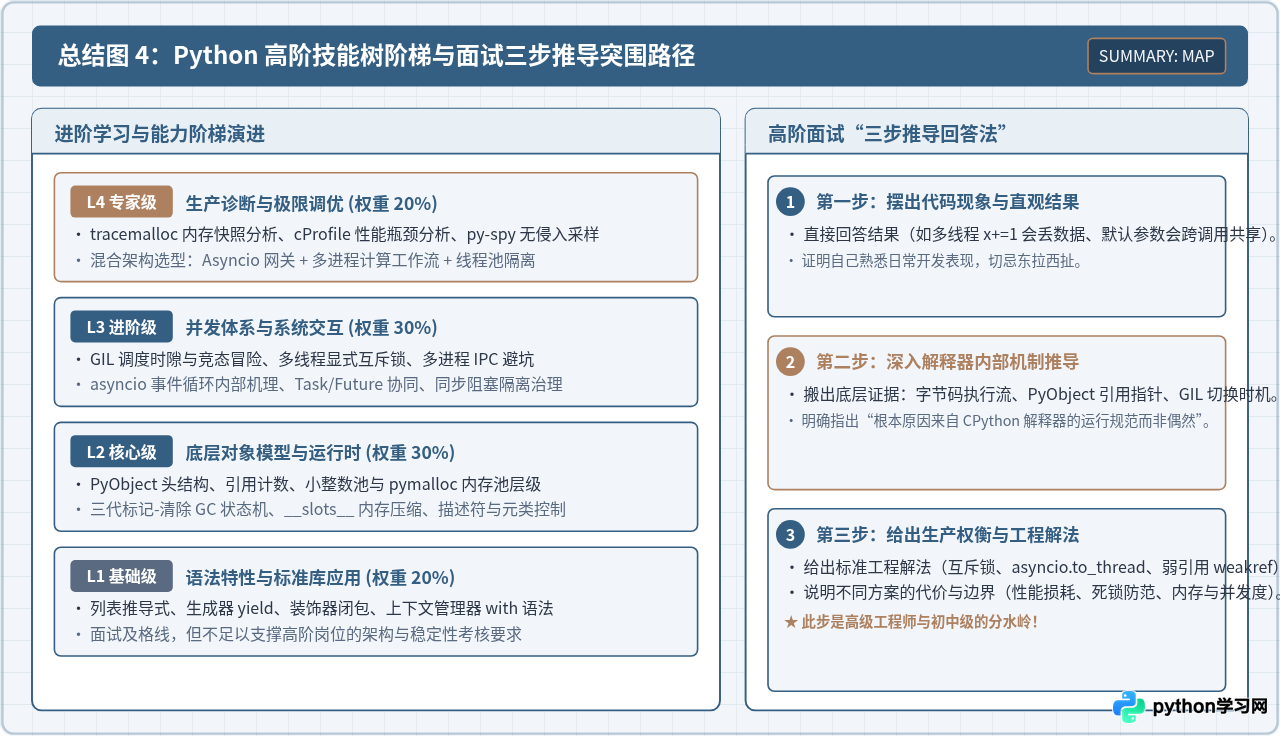
面对高阶面试中的底层原理与并发难题,单纯机械背诵零散的面试“八股文”往往在面临面试官层层深挖时迅速露出破绽。建议采取系统化的学习路径与应答框架:
1. 掌握“三步推导回答法”
当被问及高阶机制题时,推荐按照以下层次展开回答:
- 第一步:直接给出代码表象与直观结论(例如:“多线程下简单的累加不是线程安全的,会导致数值偏小”)。
- 第二步:深入解释器内部机制推导原因(例如:“因为在 CPython 字节码层面,
count += 1包含读取、加法、写回三条以上指令,时钟中断会导致线程在这几条指令之间发生上下文切换”)。 - 第三步:给出生产级权衡方案与工程避坑点(例如:“工程中应使用互斥锁
threading.Lock或使用原子队列;但加锁需注意锁粒度与死锁风险,若为纯高并发计数还可考虑 Redis 分布式计数或 Atomic 原生包装”)。
2. 并发模型技术选型决策矩阵
| 技术模型 | 底层机制 | GIL 限制 | 内存占用 | 上下文切换代价 | 最佳适用业务场景 |
|---|---|---|---|---|---|
| 多线程 (threading) | OS 原生系统线程 | 受限(同一时刻单核) | 较低(共享进程空间) | 中等(内核态调度切换) | 通用 I/O 阻塞调用、文件磁盘读写、多源爬取 |
| 多进程 (multiprocessing) | 独立 OS 进程 | 完全突破(多核真并行) | 较高(各进程独占内存) | 较高(跨进程通信与序列化) | CPU 密集计算、图像音视频处理、大数据清洗 |
| 异步协程 (asyncio) | 单线程 Event Loop | 运行于单线程无锁争用 | 极低(轻量栈帧对象) | 极低(纯用户态协作式调度) | 海量长连接、高吞吐 Web 服务、微服务 API 网关 |
| 混合并发模式 | Asyncio + 线程/进程池 | 按任务类型分流隔离 | 可控 | 平衡 | 现代化综合型后端服务(主流最佳实践) |
3. 高阶进阶学习路线与优先级建议
在复习与能力提升的时间分配上,建议遵循“从机制到系统,再到诊断工具”的演进规律:
- 重点一:吃透 PyObject 与垃圾回收(占投入精力 30%):利用官方源码文档与
gc模块,深入掌握标记-清除逻辑与循环引用断开机制,这是所有性能优化与内存故障分析的地基。 - 重点二:建立并发体系全景图(占投入精力 35%):不仅要理解 GIL 的历史成因与多核争抢机制,还要熟练掌握
asyncio核心组件(Future、Task、Loop)及多进程 IPC 的技术边界。 - 重点三:熟练使用分析工具链(占投入精力 20%):在本地实践中使用
dis查看字节码,用tracemalloc排查内存对象增长,用cProfile输出耗时火焰图,用事实证据代替主观猜测。 - 重点四:元编程与对象协议(占投入精力 15%):掌握描述符协议优先级与元类的
__new__控制流,具备阅读主流框架底层源码的核心能力。
总的来说,学习 Python 底层原理与并发编程并不是为了在面试中死记硬背枯燥的名词,而是为了在面对复杂的线上生产系统时,拥有站在解释器与操作系统视角审视架构、做出科学选型并从容解决疑难问题的工程底气。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















