


Python进阶学习:哪里可以找到数据分析与Web开发的专项练习题?
针对脱离基础语法后的Python学习者,系统梳理数据分析与Web开发两个方向的高质量专项练习题源、实训平台、考查要点与自检落地方法。
一、为什么通用刷题平台无法满足专项进阶?
很多开发者在学完 Python 核心语法后,习惯直接在各大算法平台上刷题。但很快就会遇到典型瓶颈:在平台上通过了几十道关于链表反转、回溯搜索的题目,面对一份包含 50 万行混杂着异常时间格式与空值的电商订单 CSV 时,依然不知如何高效清洗;或者在需要编写一个支持 JWT 认证并防止数据库 N+1 查询的 RESTful API 时,无从下手。
这种断层的根源在于题目考查维度的错位:
- 通用算法题的目标是时间与空间复杂度优化,输入输出多为规整的原生数据结构(列表、字符串、字典),运行于封闭单进程内存中。
- 数据分析专项考查的是“向量化思维”与“数据流工程”,重点在于如何利用 Pandas、NumPy 的底层 C/Cython 内存结构规避低效 Python 原生循环,完成多维聚合、复杂时间窗口推导以及异常数据插补。
- Web开发专项考查的是“系统边界”与“状态一致性”,核心包括 HTTP 协议语义、请求模式校验、ORM 事务原子性、分布式缓存击穿防护以及异步 I/O 调度。
二、数据分析专项练习题源与训练方法
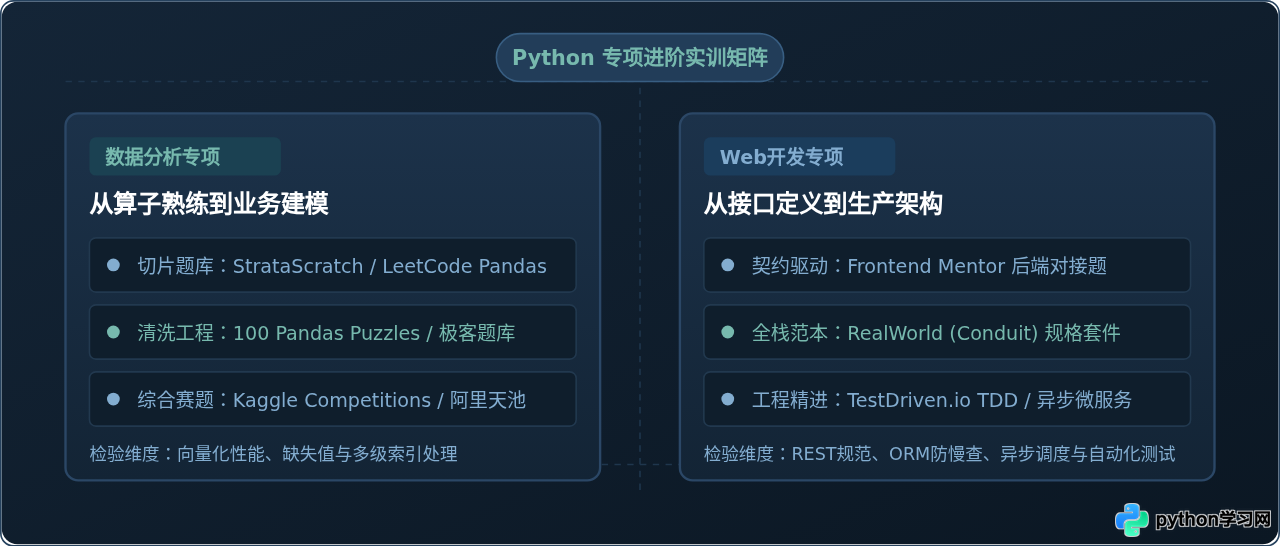
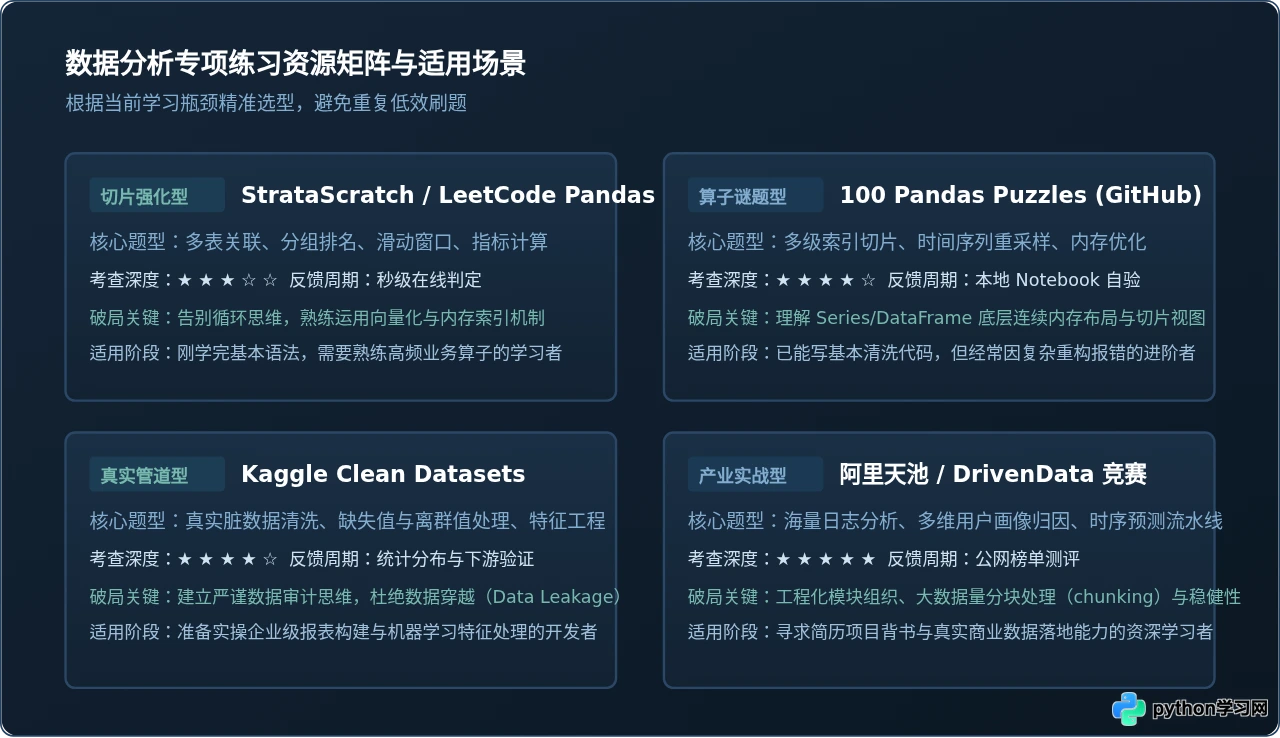
数据分析的核心能力在于:将真实业务诉求转化为矩阵数学或关系型代数运算,并用高效的向量化代码实现。以下是针对性极强的四个练习渠道:
1. StrataScratch(业务场景与真题切片首选) 实测推荐度:高
平台定位:聚合了主流科技公司真实面试题的专业平台。与普通算法网站不同,它的每道题都以具体业务问题切入(例如“计算每位用户在首单后30天内的留存复购率”、“识别连续3天活跃的异动账户”)。
做题建议:在语言选项中切换为 Python (Pandas)。先用标准 SQL 思考逻辑,再尝试用纯 Pandas 向量化语句写出解答,对比两种思维方式的异同。该平台的评测引擎会自动对比预期 DataFrame 输出。
2. LeetCode Pandas 专项 30 题(30 Days of Pandas) 算子熟悉期必备
平台定位:LeetCode 近年推出的官方 Pandas 专项学习计划。题目涵盖数据过滤、列操作、分组统计、重命名、表连接(Merge/Join)等核心操作。
做题建议:作为从零到一建立 Pandas 算子记忆的练兵场。解题时严格限制自己不准使用 apply()、iterrows() 或 for 循环,逼迫自己使用广播机制(Broadcasting)、isin()、groupby().agg() 等原生高效方法通过测试用例。
3. GitHub 精选仓库:100-pandas-puzzles 开源自测精选题库
平台定位:由社区开发者维护的由浅入深的 100 道 Pandas 益智谜题,涵盖创建、清洗、过滤、多级索引(MultiIndex)、时间序列和可视化。
做题建议:在本地 Jupyter Notebook 中运行。尤其要重点练习其“复杂时间序列重采样(Resample)”和“多级索引交叉切片(xs)”部分,这是日常工作中最容易写出冗长臃肿代码的环节。
4. Kaggle Community Datasets & 阿里天池(端到端综合清洗) 综合场景训练
平台定位:当切片题熟练后,需要面对真实的“脏数据”。Kaggle 上的经典数据集(如 Lending Club 违约预测、巴西电商 Olist 数据集)与阿里天池工业比赛数据集提供了数十个关联表与大量异常值。
做题建议:不直接跑现成模型,而是专项练习“探索性数据分析(EDA)与数据清洗流水线”:自行设计缺失值插补方案、识别异常离群点、统一不同格式的时间戳,并用 Python 编写可复用的清洗函数。
典型实战题目演练:连续活跃留存与向量化计算
以下为一个典型的数据分析切片考题:“统计每个用户在过去 7 天内的滑动消费均值,并找出消费金额连续 3 天递增的用户”。初学者常写出多层嵌套循环,耗时极高;而进阶的标准写法是利用滑动窗口 rolling() 与差分 diff():
import pandas as pd
import numpy as np

# 构造模拟测试数据
data = {
    'user_id': [101, 101, 101, 101, 102, 102, 102, 102],
    'order_date': pd.to_datetime([
        '2026-10-01', '2026-10-02', '2026-10-03', '2026-10-04',
        '2026-10-01', '2026-10-02', '2026-10-03', '2026-10-04'
    ]),
    'amount': [120.0, 150.0, 180.0, 140.0, 300.0, 280.0, 310.0, 350.0]
}
df = pd.DataFrame(data)

# 进阶向量化求解:排序、分组计算日差与3天窗口
df = df.sort_values(by=['user_id', 'order_date'])

# 1. 计算滑动消费均值(3天窗口)
df['rolling_3d_avg'] = (
    df.groupby('user_id')['amount']
    .transform(lambda s: s.rolling(window=3, min_periods=1).mean())
)

# 2. 向量化判定是否单日递增 (diff > 0)
df['is_increase'] = df.groupby('user_id')['amount'].diff() > 0

# 3. 计算连续递增天数(使用累积窗口)
df['consecutive_inc_days'] = (
    df.groupby('user_id')['is_increase']
    .transform(lambda s: s.rolling(window=2, min_periods=2).sum())
)

# 过滤出达标记录(示例输出)
print(df[['user_id', 'order_date', 'amount', 'rolling_3d_avg', 'is_increase']])
三、Web开发专项练习题:从API契约到高可用工程
与数据分析不同,Web 开发领域很难找到一个类似“在线单题 OJ”的集中刷题平台,因为 Web 后端依赖网络协议、进程生命周期、数据库事务与中间件协作。但这并不意味着没有专项题。
业内主流的高效练习方法是“契约驱动训练”与“规范工程套件”:
1. RealWorld 规范(Gothinkster / Conduit) 最贴近工业级的“Web后端大题”
平台定位:被称为“所有全栈工具的终极基准(The mother of all demo apps)”。官方提供了一套完整的 Medium 博客克隆版 API 规范(包含用户注册、JWT 认证、文章 CRUD、标签过滤、点赞关注等所有接口的入参出参严格定义)以及对应的 Postman 自动化自动化测试套件。
做题建议:不管你使用 FastAPI、Django 还是 Flask,下载官方的 Postman 测试集,在本地严格实现所有端点。只有当你的后端服务通过 100% 的 Postman 自动化用例断言时,才算“提交通过”。这是检验接口规范度与异常处理边界的最佳途径。
2. Frontend Mentor(反向推导式后端练习) 前后端解耦实训
平台定位:原本是一个前端 UI 练习网站,提供了从简易看板、电子商务购物车到大型多步骤表单的 Figma 原型与交互需求文档。
做题建议:反向利用其业务需求:挑选其高级(Advanced)级别的挑战(如“多用户协作任务管理看板”或“发票生成管理应用”),不写前端,专门为其设计 RESTful API 或 GraphQL 接口。编写包含分页(Pagination)、排序、模糊搜索、权限隔离(不同角色只读或可写)的后端服务。
3. TestDriven.io(TDD 与微服务实战专训) 工程级高质量教程与习题
平台定位:专注于 Python Web 领域测试驱动开发(TDD)、FastAPI、Docker、Celery 分布式任务的高质量工程化平台。
做题建议:参考其给出的系统架构挑战,专门练习“先写 pytest 测试用例,再写业务实现”的习惯。重点攻克“第三方支付回调幂等性”、“后台异步生成导出 Excel”、“WebSocket 实时状态同步”等传统语法书中不讲的实操痛点。
4. GitHub 题库:Project-Based Learning (Python) 结构化开源项目库
平台定位:收录了数百个有清晰指导步骤的工程项目,包含从自定义简单 HTTP 服务器、WSGI/ASGI 中间件开发,到基于 Redis 的限流器(Rate Limiter)实现。
做题建议:挑出其中的“中间件机制”与“限流算法”专项,自己从零手写一个基于令牌桶(Token Bucket)的 FastAPI/Starlette 中间件,以深入理解异步请求上下文与生命周期钩子。
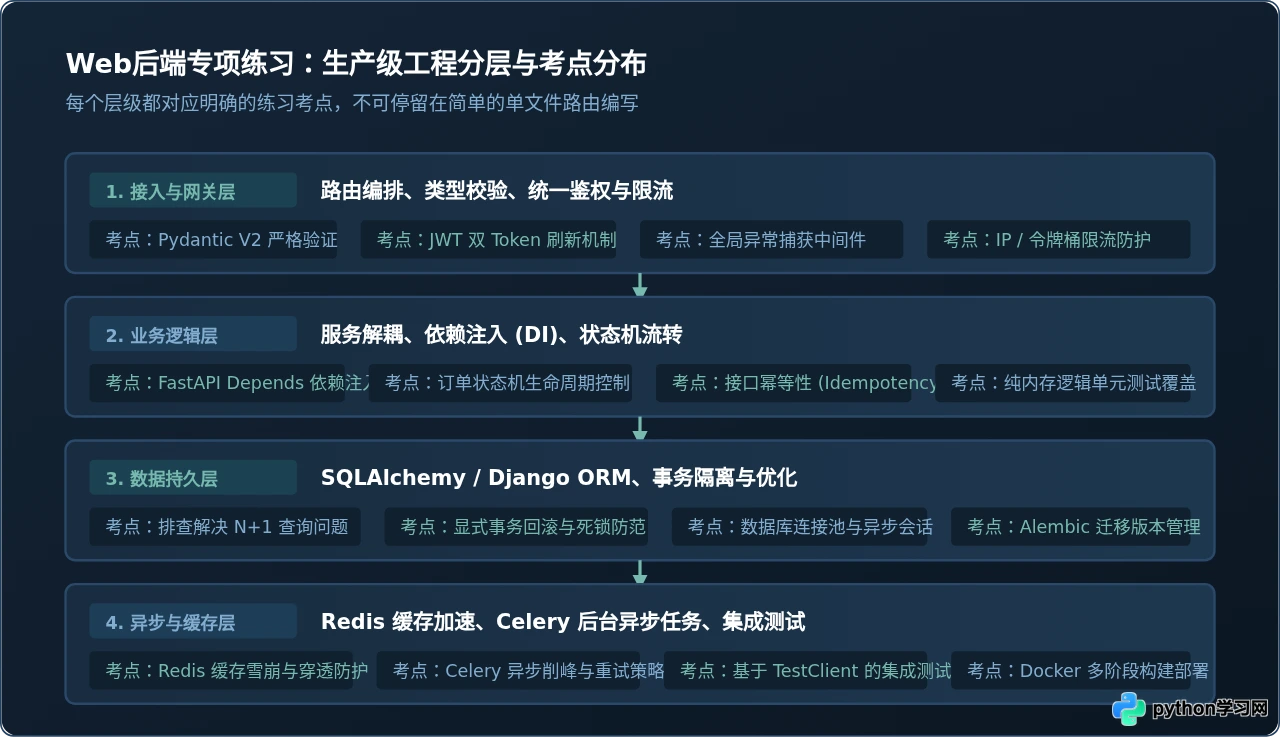
典型实战题目演练:带依赖注入与事务控制的 API 端点
以下为一个符合工业级标准的 FastAPI 专项练习题示例:“实现一个具备安全库存校验、显式数据库事务回滚、并由依赖注入管理连接的下单接口”:
from fastapi import FastAPI, Depends, HTTPException, status
from pydantic import BaseModel, Field
from sqlalchemy.orm import Session
from typing import Generator
# 假设已有数据表模型 Item, Order, 以及 sessionmaker SessionLocal

app = FastAPI(title="进阶Web练习示例")

class OrderCreateRequest(BaseModel):
    item_id: int = Field(..., gt=0, description="商品ID必须为正整数")
    quantity: int = Field(..., gt=0, le=50, description="单次下单量必须在 1~50 之间")

# 依赖项:管理数据库生命周期
def get_db() -> Generator[Session, None, None]:
    db = SessionLocal()
    try:
        yield db
    finally:
        db.close()

@app.post("/api/v1/orders", status_code=status.HTTP_201_CREATED)
def create_order(payload: OrderCreateRequest, db: Session = Depends(get_db)):
    # 显式使用事务处理,防止库存出现超卖与竞态
    with db.begin():
        # 1. 行级锁查询库存 (SELECT ... FOR UPDATE)
        item = db.query(Item).filter(Item.id == payload.item_id).with_for_update().first()
        if not item:
            raise HTTPException(
                status_code=status.HTTP_404_NOT_FOUND,
                detail=f"商品 ID {payload.item_id} 不存在"
            )
        if item.stock < payload.quantity:
            raise HTTPException(
                status_code=status.HTTP_400_BAD_REQUEST,
                detail=f"库存不足,当前剩余 {item.stock} 件"
            )

        # 2. 扣减库存并写入订单
        item.stock -= payload.quantity
        order = Order(item_id=item.id, quantity=payload.quantity, status="PAID")
        db.add(order)
        # 事务退出时自动 commit;若出现任何未捕获异常则自动 rollback

    return {"message": "下单成功", "order_id": order.id, "remaining_stock": item.stock}
四、进阶练习的自检与成果沉淀闭环
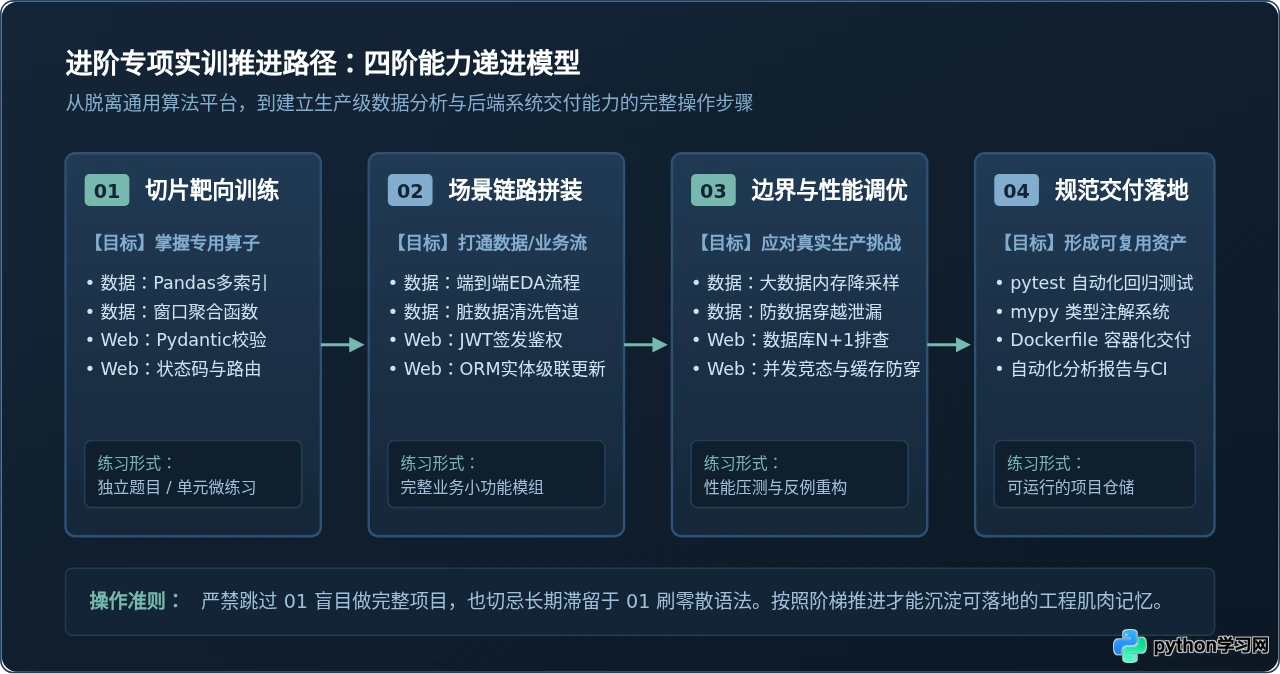
专项练习最忌讳的是“敲完代码以为懂了,遇到真实问题依然卡壳”。必须建立一个可量化、可验证的闭环自检机制,确保每一次专项练习都能转化为可长期维护的工程资产。
| 维度 | 数据分析专项自检标准 | Web开发专项自检标准 |
|---|---|---|
| 代码规范与类型 | 函数入参包含 pd.DataFrame 与 Series 类型注解;遵循 PEP 8 命名规范。 |
使用 mypy --strict 静态类型检查无报错;Pydantic 模型定义完整字段校验。 |
| 性能指标 | 对百万级 DataFrame 的操作拒绝逐行遍历;内存占用通过类型下潜(如 category, int32)降低 50% 以上。 |
单次请求数据库查询总次数恒定(无 N+1 慢查);核心接口响应耗时在压测下保持平稳。 |
| 自动化测试 | 编写针对数据清洗清洗规则的 pytest 断言,包含空值、重复时间戳、极端离群点等测试用例。 |
包含单元测试与基于 httpx / TestClient 的端到端 API 测试,测试覆盖率达到 80% 以上。 |
| 工程化交付 | 输出完整的交互式分析报告(HTML/Markdown)以及可配置化执行的数据处理脚本。 | 提供多阶段构建的 Dockerfile,支持 docker compose up 一键拉起应用与数据库。 |
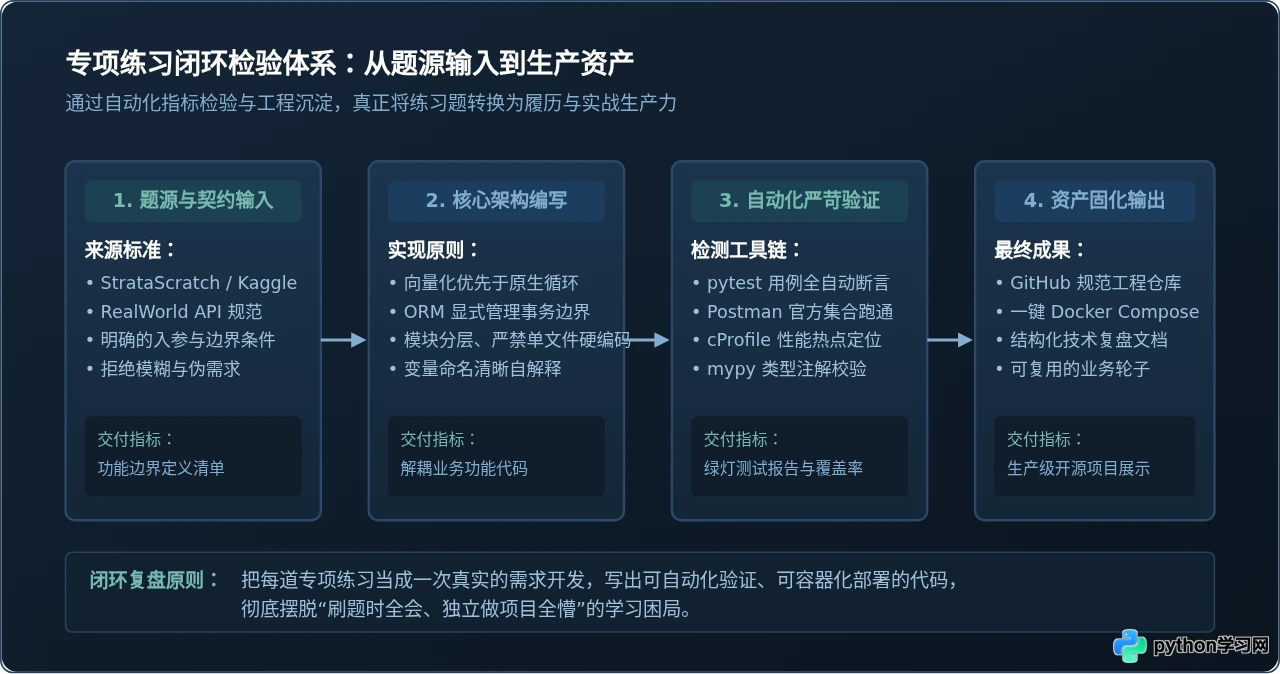
五、专项进阶中必须规避的四个典型陷阱
不停地刷视频、换教程,或者照抄别人现成的代码,大脑会产生“我已经学会”的虚假充实感。真正的专项练习必须关闭视频,仅依据题目需求与 API 契约文档,在本地空白工程中一行一行敲出实现与测试。
在 Pandas 中遇到复杂逻辑时,习惯性使用 for index, row in df.iterrows():。一旦数据量达到百万级别,这种写法会比原生向量化运算慢上百倍。在做专项题时,只要出现显式循环遍历 DataFrame,就要强制提醒自己寻找对应的矩阵或分组广播替代方案。
初学 Web 开发往往只看接口是否返回了 200 OK,却忽略控制台打印的 SQL 数量。在编写关联对象查询(例如文章列表包含作者信息和评论数)时,必须配置 SQLAlchemy 或 Django 的 SQL 调试日志,确保使用 joinedload() 或 select_related() / prefetch_related() 进行预加载,把查询次数控制在常数级。
很多开发者认为“小练习不需要写测试”。但在进阶专项阶段,没有 pytest 保护的代码是脆弱且无法重构的。只有先建立起自动化断言,你才能放心地优化数据处理算法、重写 ORM 实体层,并在重构后秒级验证功能是否完好。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















