


学完Python基础后怎么进阶?Web开发与数据方向的技能树对比

掌握了变量、数据结构、函数和面向对象等语法之后,进阶的关键不是漫无目的地刷语法题,而是选定一个具有完整工程闭环的应用领域。Python 生态中最主流的两个分支是 Web 开发与数据方向。本文将拆解这两个方向的核心知识架构、关键工具链与实践落地路径,提供可量化的评估指标,帮助你建立清晰的进阶目标。
一、基础完成的检验标准:在进阶之前确认基座
很多学习者在基础语法阶段停留过久,或者在尚不能独立编写小工具时就急于套用高级框架。在选择方向前,可以通过以下具体能力进行自我检验:
- 基本语法与逻辑控制:能够熟练使用字典、列表、推导式组织数据,编写逻辑分支与循环。
- 模块与虚拟环境:能够在命令行中使用
venv创建并激活虚拟环境,使用pip管理依赖文件requirements.txt。 - 异常与文件操作:理解文件读写规范(如
with open()上下文管理器),并能合理处理try...except异常。 - 面向对象编程:清楚类、实例、方法、属性的定义与调用机制,理解封装与继承的用法。
如果上述操作均可在不依赖代码补全的前提下独立完成,说明基础已经达标,应立即进入领域技能树的学习,通过解决具体工程问题来驱动进阶。
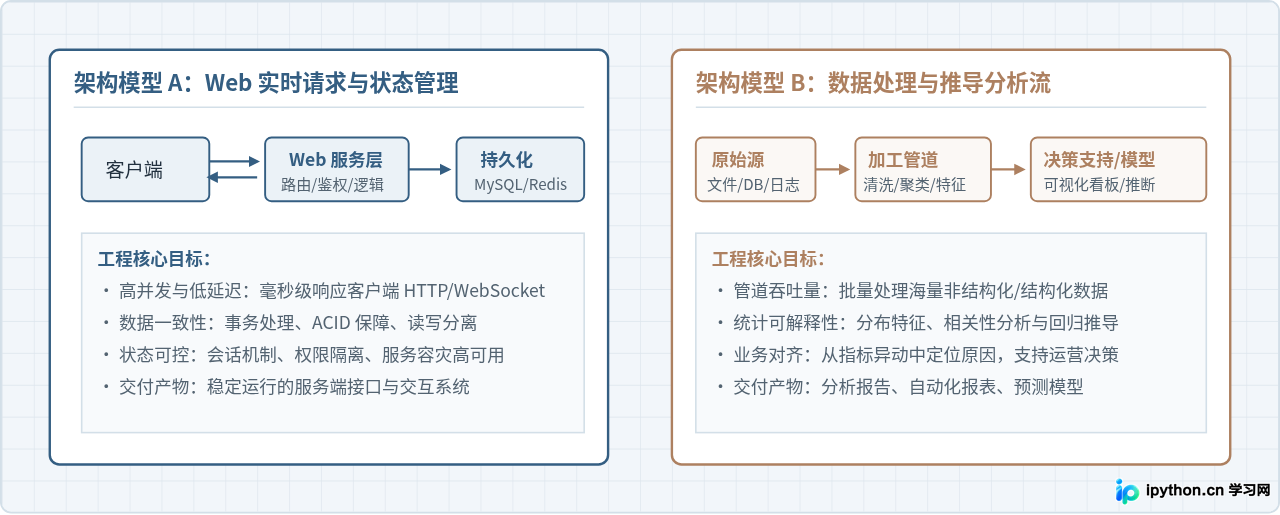
二、核心架构差异:从请求闭环到推导闭环
Web 开发与数据方向的核心区别在于**系统关注点**。Web 开发关注的是可靠的请求处理链路与状态持久化;而数据方向关注的是数据的流转、清洗、模式挖掘与结论表达。
三、技能树全景对比:技术栈与工具链
两个方向的技术要求从基础框架开始产生分化。了解具体的工具分工,有助于规划每个阶段的学习深度。
| 技术维度 | Web 开发方向 | 数据分析 / 挖掘方向 |
|---|---|---|
| 核心库与框架 | Django(全功能重型框架)、FastAPI(现代高性能接口框架)、Flask(轻量微框架) | Pandas(数据清洗与处理)、NumPy(矩阵计算)、Scikit-Learn(机器学习) |
| 数据存储体系 | 关系型数据库(PostgreSQL / MySQL)、缓存系统(Redis)、ORM(SQLAlchemy / Django ORM) | 数据仓库(ClickHouse / Hive)、分析型 SQL(多表关联统计、窗口函数)、数据湖格式(Parquet) |
| 数据传输与通信 | HTTP/HTTPS、RESTful API 标准、WebSocket 实时通信、JSON 数据交换格式 | 批处理管道、ETL 调度(Airflow / DolphinScheduler)、消息队列订阅 |
| 输出形式 | 可交互网站、企业后台、微服务 API 接口、身份验证系统 | 交互式可视化看板(Tableau / Superset)、数据分析报告、Jupyter Notebook 实验成果 |
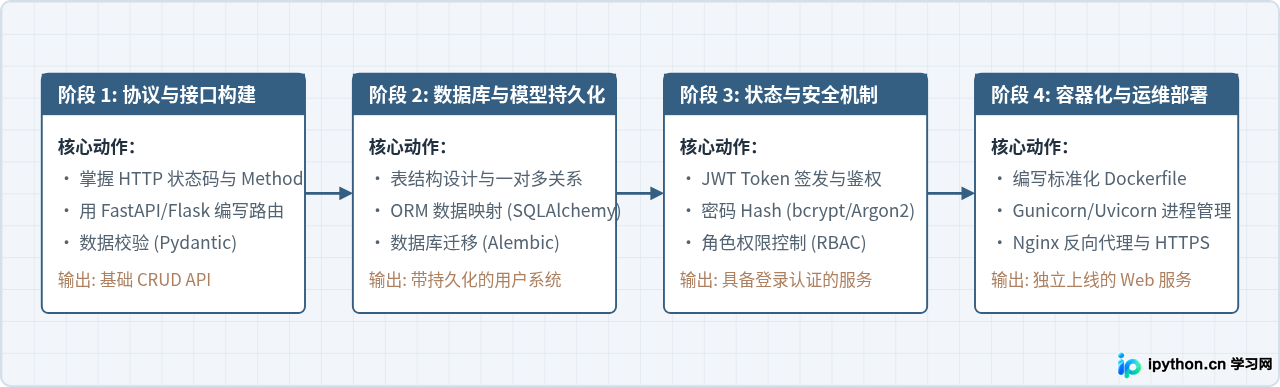
四、Web开发方向的典型进阶路径
学习 Web 开发的核心原则是:**从接口抽象到数据落地,再到部署上线**。不推荐一开始就接入复杂的微服务或高并发中间件,而是按逻辑顺序搭建完整功能。
实战示例:FastAPI 接口与入参校验
现代 Python Web 开发普遍依赖类型注解进行入参过滤与序列化。在项目目录中新建 main.py:
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field

app = FastAPI(title="用户状态管理服务")

class UserRegisterRequest(BaseModel):
    username: str = Field(..., min_length=3, max_length=20, description="用户名")
    email: str = Field(..., pattern=r"^[\w\.-]+@[\w\.-]+\.\w+$", description="合规邮箱")

@app.post("/api/v1/users", status_code=status.HTTP_201_CREATED)
def register_user(payload: UserRegisterRequest):
    # 模拟业务排重与入库
    if payload.username == "admin":
        raise HTTPException(
            status_code=status.HTTP_400_BAD_REQUEST,
            detail="保留用户名,不允许注册"
        )
    return {
        "code": 0,
        "message": "用户创建成功",
        "data": {"username": payload.username, "email": payload.email}
    }
在终端中执行启动命令:
uvicorn main:app --host 127.0.0.1 --port 8000 --reload在另外的终端窗口使用 curl 验证接口响应:
curl -X POST "http://127.0.0.1:8000/api/v1/users" \
     -H "Content-Type: application/json" \
     -d '{"username": "johndoe", "email": "john@example.com"}'
预期返回结果(示例):
{"code":0,"message":"用户创建成功","data":{"username":"johndoe","email":"john@example.com"}}五、数据方向的典型进阶路径
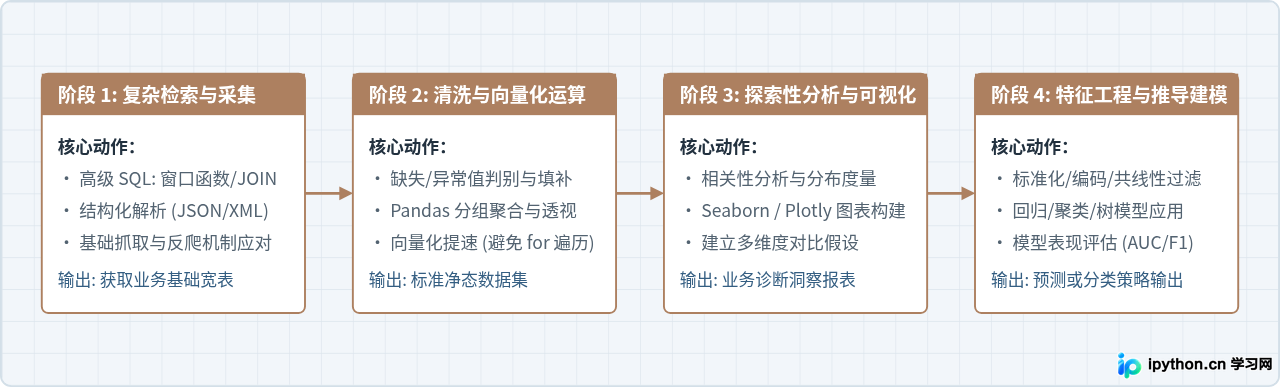
数据方向的进阶路线并非从算法模型开始,而是**从清洗加工到统计洞察**。实际工作中的瓶颈往往在于提取脏数据、指标口径对齐以及向量化加速,而不是模型参数调优。
实战示例:Pandas 向量化统计分析
避免使用循环遍历数据。以下示例展示如何利用 Pandas 的向量化计算与分组聚合功能,快速完成客单价计算与异常检测:
import pandas as pd
import numpy as np

# 1. 构建模拟交易数据
raw_data = {
    "order_id": [1001, 1002, 1003, 1004, 1005],
    "user_id": ["U1", "U2", "U1", "U3", "U2"],
    "category": ["电子", "家居", "电子", "生鲜", "家居"],
    "amount": [2999.0, 150.0, 4800.0, 45.0, np.nan],
    "quantity": [1, 2, 2, 5, 1]
}

df = pd.DataFrame(raw_data)

# 2. 清洗:填充缺失金额为该类目的中位数
df["amount"] = df.groupby("category")["amount"].transform(
    lambda x: x.fillna(x.median())
)

# 3. 向量化运算:单价计算与大额订单标识
df["unit_price"] = df["amount"] / df["quantity"]
df["is_high_value"] = df["amount"] > 1000.0

# 4. 指标统计:统计各品类的销售总额与客单价
summary = df.groupby("category").agg(
    total_sales=("amount", "sum"),
    avg_price=("unit_price", "mean"),
    order_count=("order_id", "count")
).reset_index()

print(summary)
控制台执行输出(示例):
  category  total_sales  avg_price  order_count
0       家居        300.0       75.0            2
1       电子       7799.0     2699.5            2
2 生鲜 45.0 9.0 1六、选择依据:四维度决策模型
方向的选择取决于学习者的思维习惯、过往技能背景以及预期的产出形式。可以通过以下四个维度进行判断:
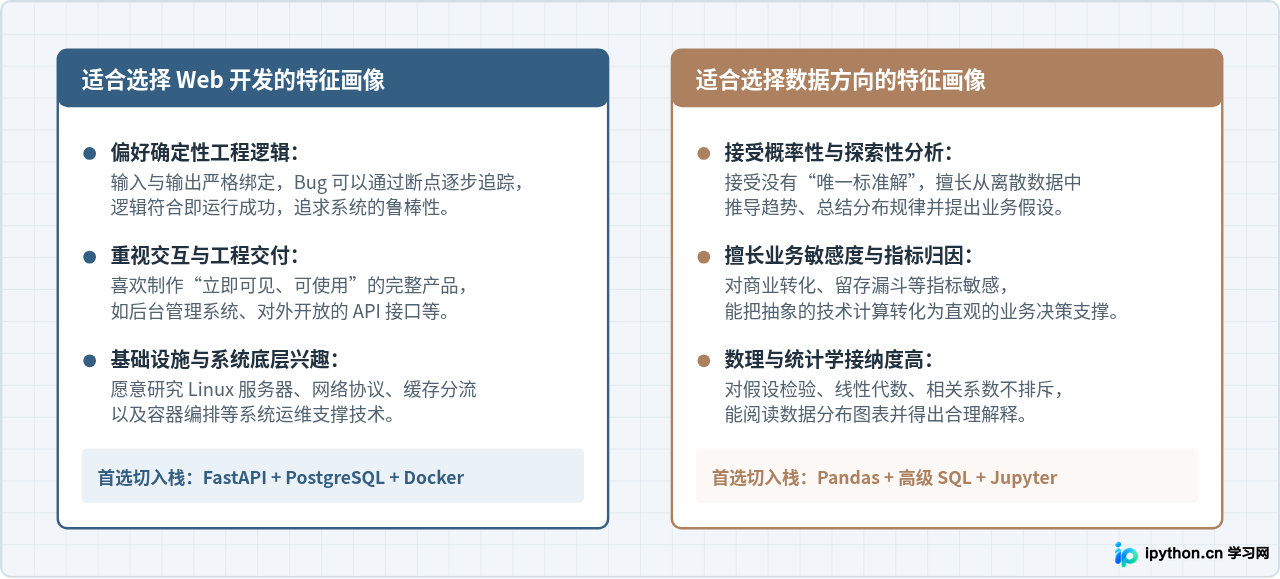
七、常见学习误区与排查建议
在进阶过程中,学习者常会遇到几个典型的低效陷阱:
- 误区 1:试图双线并进。Web 开发与数据处理在思维模式上有较大差异。同时学习 Django 和机器学习,往往会导致两边都停留在初级 API 调用的阶段。建议先集中精力将其中一个方向推进入门级项目闭环(如上线一个带鉴权的 API 系统,或产出一份完整的真实业务分析报告),再做横向扩展。
- 误区 2:只看视频不调试报错。真实的工程能力往往建立在排查报错(Stack Trace)的基础上。遇到报错时,应该先阅读控制台最下方的异常类型(如
KeyError,IntegrityError,TypeError),再根据调用栈定位具体出错的代码行,而不是直接重写或放弃。 - 误区 3:忽视基础工具链。Git 版本控制、命令行基础操作(如端口占用排查
lsof -i、文件检索grep)、虚拟环境隔离(venv)是两个方向通用的底层技能,越早熟练掌握,进阶阶段遇到的环境问题就越少。
八、总结与行动清单
学完 Python 基础语法后,避免迷茫的最好方式是立刻完成一个**端到端的具体任务**。不要停留在“继续看进阶教程”的状态,而是根据自己的倾向执行第一步:
- 如果倾向 Web 开发:使用 FastAPI 编写包含增删改查(CRUD)逻辑的接口,连接本地 SQLite 数据库,并使用 Postman 或 curl 跑通完整的请求验证。
- 如果倾向数据方向:寻找一个公开的数据集(如电商订单记录或公共气象数据),使用 SQL 完成多表聚合统计,并用 Pandas 清洗脏数据,计算出至少 3 个核心指标。
完成并跑通第一个最小闭环后,技能树上的每个知识节点就会在实际问题中找到对应的位置。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















