


Python内置difflib实现字符串模糊匹配基础教程
本教程详细介绍如何使用Python标准库difflib进行字符串模糊匹配,涵盖SequenceMatcher相似度计算原理、get_close_matches候选词检索、文本预处理技巧及性能适用边界。
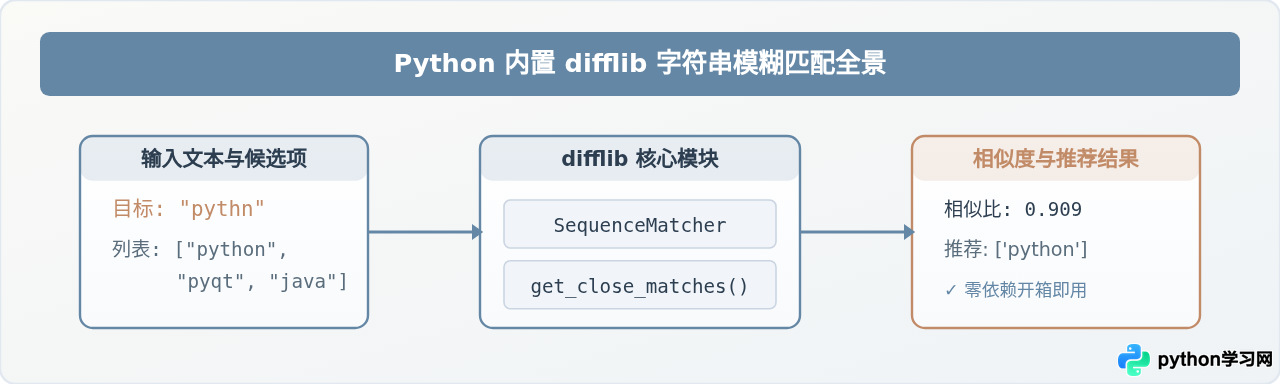
在日常开发中,处理拼写纠错、关键词联想、配置参数容错匹配以及数据清洗等任务时,常常需要衡量两个文本之间的相似程度,或者从成百上千个候选字符串中快速找出最接近的一项。Python 自带的标准库 difflib 提供了开箱即用的解决方案,无需安装任何第三方扩展包即可高效完成字符串模糊比对与候选检索。本文将系统讲解 difflib 的底层比对算法、核心类 SequenceMatcher 的使用细节、高层检索函数 get_close_matches 的参数配置,以及实际工程中的预处理要点与适用边界。
一、difflib 模糊匹配的核心机制与原理
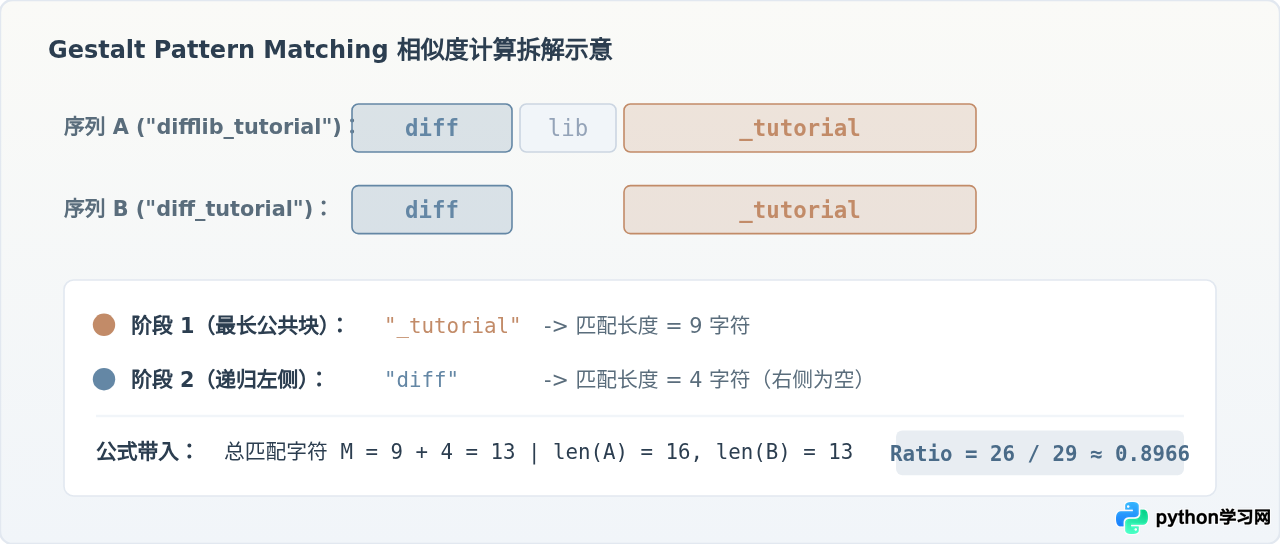
difflib 的核心算法基于 Gestalt Pattern Matching(格式塔模式匹配算法,由 John W. Ratcliff 和 John A. Obershelp 于 1988 年提出)。与常见的信息科学编辑距离(如 Levenshtein Distance)不同,Gestalt 算法不仅关注单个字符的插入、删除与替换次数,更侧重于识别两个序列中连续重合的子序列。
算法执行过程大致分为三步:
- 寻找最长公共子序列:在给定的两个序列 A 与 B 中,找出一段长度最大的连续匹配字符片段;
- 递归处理两侧残差:以最长公共子序列为界,将序列 A 和 B 分别划分为左、右两部分,并在左右子序列中递归继续寻找最长公共片段,直到没有重合片段为止;
- 计算相似度比值(Ratio):将所有找到的匹配片段长度累加得到总匹配字符数 $M$。相似度由公式定义:
Similarity Ratio = 2.0 × M / (len(A) + len(B))
其中 $M$ 是所有匹配片段的长度总和,分母为两个序列长度之和。计算结果是一个介于 0.0 到 1.0 之间的浮点数:当两个字符串完全一致时返回 1.0;当毫无共同字符时返回 0.0。
二、使用 SequenceMatcher 精确计算字符串相似度
difflib.SequenceMatcher 是一个功能通用的序列比对类。它不仅可以用于字符串,也可以用于任意可哈希元素的列表比对。类构造函数的完整签名如下:
difflib.SequenceMatcher(isjunk=None, a='', b='', autojunk=True)参数解释:
isjunk:可选的回调函数。用于指定哪些字符为“无用字符”(例如空格或换行符)。如果不关心噪声过滤,传入None;a、b:待比对的两个序列(通常为字符串);autojunk:布尔值,默认为True。启用后,算法会自动将序列中频繁出现的字符判定为垃圾字符(启发式优化,用于加快长文本比对)。在短文本匹配时,建议显式设为False,避免误判。
1. 基础相似度比对代码
以下示例展示如何导入模块、实例化 SequenceMatcher 并调用 ratio() 方法获取匹配分值:
import difflib

str1 = "difflib_tutorial"
str2 = "diff_tutorial"

# 创建比对器实例
matcher = difflib.SequenceMatcher(None, str1, str2, autojunk=False)

# 获取精确相似度
similarity = matcher.ratio()
print(f"相似度评分: {similarity:.4f}")
终端示例输出:
[示例输出]
相似度评分: 0.8966
2. 快速估算方法:quick_ratio() 与 real_quick_ratio()
除了耗时相对较高的 ratio() 之外,SequenceMatcher 还提供了两个用于快速筛选的方法:
real_quick_ratio():以极快的速度返回相似度的理论上限(仅基于两字符串长度差异估算);quick_ratio():基于字符计数直方图进行粗略比对,返回比real_quick_ratio()更紧凑的上限值。
这两个方法计算速度极快,且保证其结果大于或等于最终的 ratio()。在海量候选项过滤时,可以先通过这两个方法快速淘汰明显低于阈值的候选项,从而减少完整 ratio() 计算带来的性能开销。
三、使用 get_close_matches 检索最相近候选词
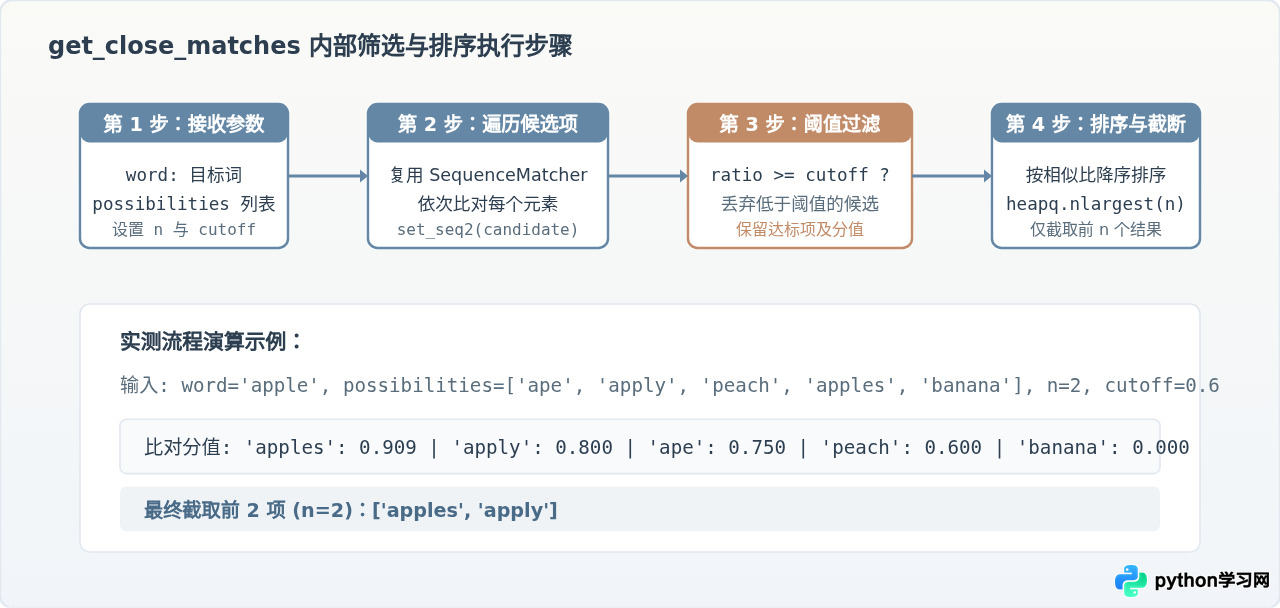
如果业务需求是从一个词典或列表中找到与输入词最相似的 $N$ 个结果,直接使用高层封装函数 difflib.get_close_matches 是最简便的选择。
difflib.get_close_matches(word, possibilities, n=3, cutoff=0.6)参数详细说明:
word:目标输入字符串;possibilities:由候选字符串组成的序列(列表、元组或集合);n:返回的最优匹配结果最大数量,默认值为 3;必须为正整数;cutoff:相似度阈值,浮点数范围在 0.0 到 1.0 之间,默认值为 0.6。相似度低于该阈值的候选词将被直接舍弃。
实战:命令行输入纠错与提示
在编写 CLI 工具时,用户经常会输错子命令。借助 get_close_matches,可以在用户输入无效命令时给出友好的修正建议:
import difflib

# 系统支持的有效命令列表
VALID_COMMANDS = ["status", "commit", "checkout", "cherry-pick", "branch", "rebase"]

def run_command(user_cmd: str):
    if user_cmd in VALID_COMMANDS:
        print(f"正在执行命令: {user_cmd}")
        return

    print(f"错误: 未知命令 '{user_cmd}'")
    # 模糊查找最匹配的命令(最多推荐 2 个,相似度门槛 0.5)
    suggestions = difflib.get_close_matches(user_cmd, VALID_COMMANDS, n=2, cutoff=0.5)

    if suggestions:
        formatted = ", ".join(f"'{s}'" for s in suggestions)
        print(f"您是否想输入: {formatted} ?")
    else:
        print("未找到相似的命令,请键入 --help 查看支持的完整指令列表。")

# 测试输入拼写错误
run_command("chechout")
run_command("statu")
终端示例输出:
[示例输出]
错误: 未知命令 'chechout'
您是否想输入: 'checkout' ?
错误: 未知命令 'statu'
您是否想输入: 'status' ?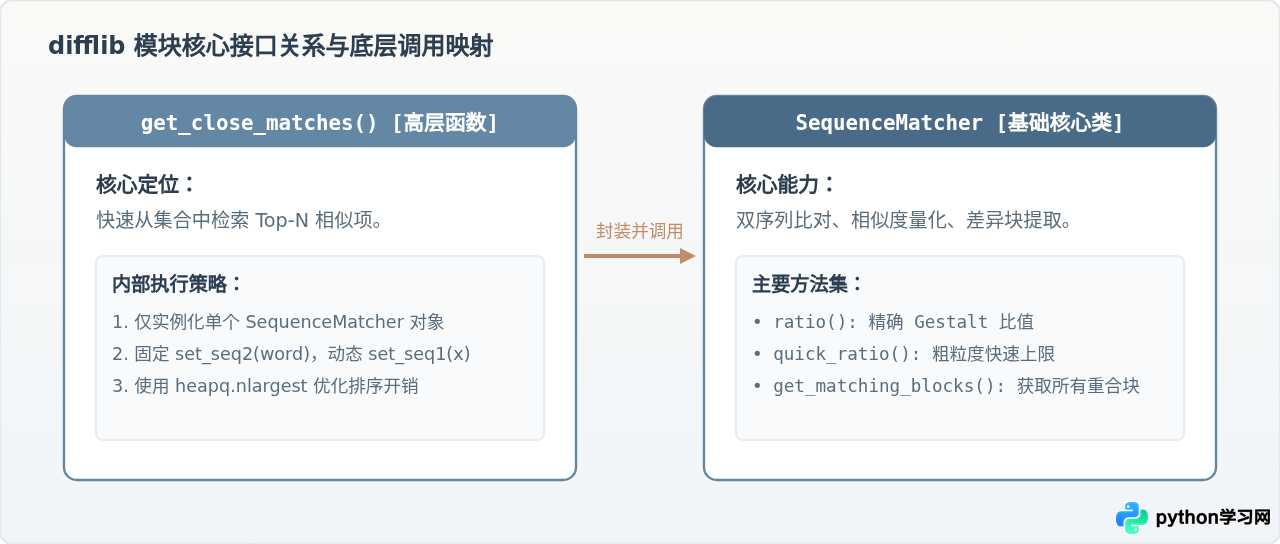
四、工程实践中的预处理与常见陷阱
在实际业务中直接套用 difflib,有时会发现匹配结果不符合直觉。这主要是由于大小写、标点符号、空格以及默认参数配置引起的。了解以下常见陷阱并进行针对性预处理,能够显著提升匹配质量。
1. 大小写敏感性
difflib 是严格区分大小写的。例如字符 'A' 和 'a' 的 ASCII 码不同,在计算时被视为完全不相同的字符:
import difflib

# 默认区分大小写
score_case = difflib.SequenceMatcher(None, "Python", "python").ratio()
print(f"'Python' 与 'python' 相似度: {score_case:.4f}")

# 统一转为小写后再比对
score_lower = difflib.SequenceMatcher(None, "Python".lower(), "python".lower()).ratio()
print(f"预处理转小写后相似度: {score_lower:.4f}")
终端示例输出:
[示例输出]
'Python' 与 'python' 相似度: 0.8333
预处理转小写后相似度: 1.0000
2. autojunk 启发式过滤陷阱
SequenceMatcher 的 autojunk 参数默认值为 True。当一个字符在一个序列中出现的次数超过一定比例(长序列中若超过 1% 且序列长度大于等于 200)时,该字符会被自动归为“垃圾字符”并不参与比对。在短字符串或含有高频重复字符的特定序列中,这可能导致部分匹配被忽略,如果发现相似度异常偏低,可显式传入 autojunk=False。
3. 忽略首尾空白与标点符号
如果希望在比对时跳过空格或标点,可以通过 isjunk 传入一个判定函数。例如过滤所有空格字符:
import difflib

# 定义空白字符过滤函数
is_space = lambda c: c in " \t\r\n"

s1 = "hello world"
s2 = "helloworld"

# 使用 isjunk 忽略空格干扰
matcher = difflib.SequenceMatcher(is_space, s1, s2)
print(f"忽略空格后的相似度: {matcher.ratio():.4f}")
终端示例输出:
[示例输出]
忽略空格后的相似度: 0.9524
五、性能边界与技术选型总结
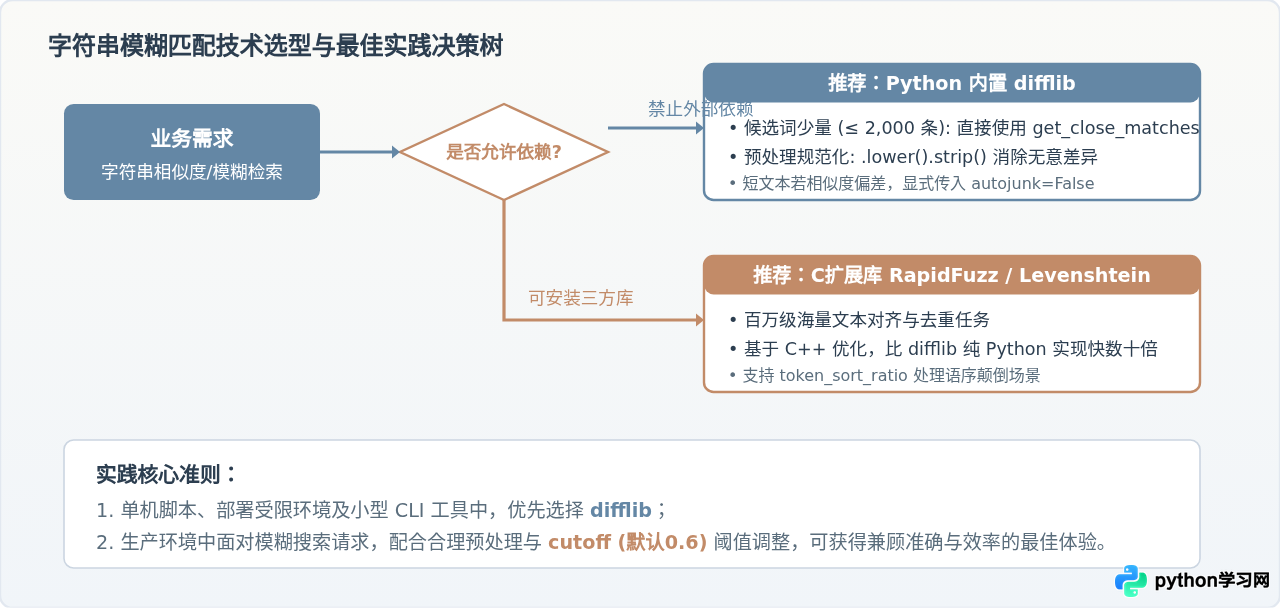
选择 difflib 最核心的收益是零外部依赖与高开箱即用性。然而,由于 SequenceMatcher 的最坏时间复杂度为 $O(N \times M)$(其中 $N, M$ 分别为两个字符串的长度),且纯 Python 代码在 CPU 密集型循环中有一定开销,因此在面临不同规模的业务场景时需要合理选型。
| 比对库/方案 | 实现语言 | 典型算法 | 依赖情况 | 适合场景 |
|---|---|---|---|---|
| difflib | 纯 Python | Gestalt Pattern Matching | Python 内置无依赖 | CLI 参数容错、配置键匹配、小于千级的轻量候选项检索 |
| Levenshtein / RapidFuzz | C / C++ | Levenshtein / Jaro-Winkler | 需通过 pip 安装编译库 | 数万至百万级文本清洗、高并发模糊搜索、NLP 数据集去重 |
| Elasticsearch / Whoosh | Java / Python | 倒排索引 + BM25 / Fuzzy Query | 独立服务或外部全文检索库 | 大规模全文搜索、复杂分词查询、企业级搜索系统 |
六、总结
Python 内置的 difflib 模块为开发者提供了一套轻量且功能完整的字符串相似度计算与模糊匹配工具。在不需要引入额外三方依赖的前提下,通过底层 SequenceMatcher 可以获得精确到浮点数的比对评分;通过高层 get_close_matches 则能一行代码实现候选列表的 Top-N 智能检索。结合统一大小写、过滤无关空格等前置预处理,difflib 能够高效胜任绝大多数轻量级文本校对与容错匹配任务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















