


Python嵌套序列解包技巧:怎么从复杂数据结构中提取数据
深入解析Python嵌套序列解包机制,讲解如何通过结构镜像对齐、星号扩展表达式从多层复杂元组与列表中高效提取数据,附完整实战代码、错误排查与技术选型决策。
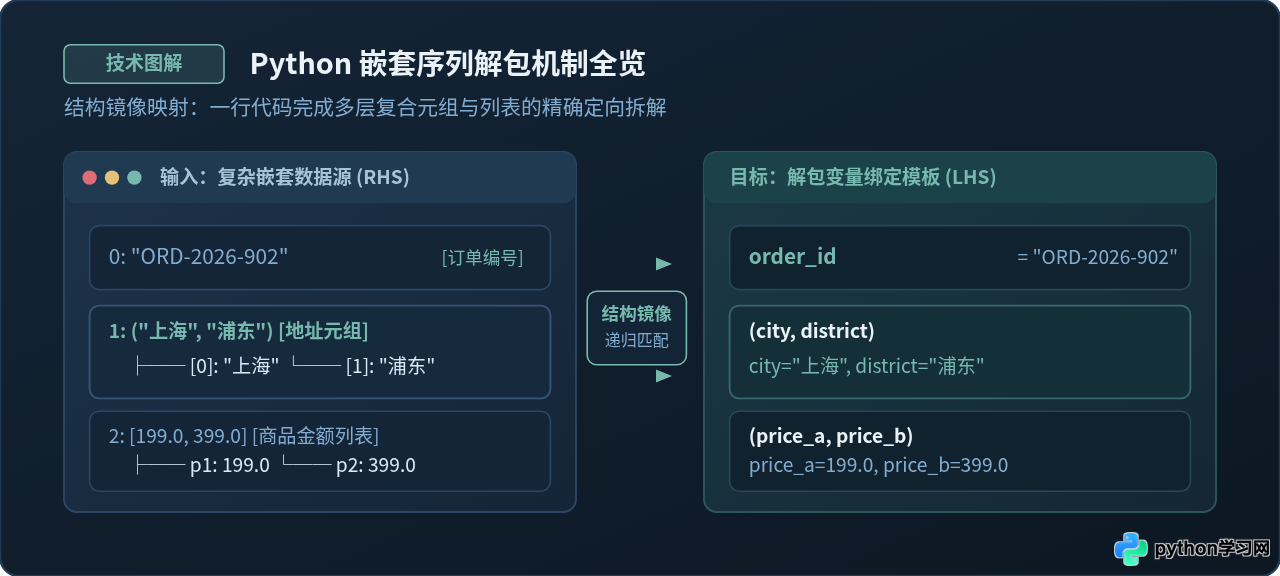
record[1][0] 进行访问,这类代码不仅晦涩易错,而且难以维护。在 Python 中,从复合数据结构中定向提取目标字段的核心解法是嵌套序列解包(Nested Sequence Unpacking):通过在等号左侧构建与右侧数据树形拓扑完全一致的括号变量模板,一行代码即可递归对齐并提取深层数据,同时获得严格的原生结构校验。
一、结构镜像机制:为什么嵌套括号能解构多层数据?
Python 官方语法规范中,解包赋值并不局限于平铺的一维可迭代对象。赋值语句的左侧(目标表达式列表,Target List)本身就支持递归语法结构。只要在左侧使用圆括号 (...) 或方括号 [...] 声明对应的子序列槽位,Python 解释器在编译期生成字节码时,就会安排递归的解包指令。
假设某条订单系统的原始回执结构如下:
# 假设的数据载荷:包含标量编号、两级地理位置元组、数值评分列表
payload = (10086, ("北京", "朝阳"), ("ACTIVE", (39.92, 116.44)))
若使用传统的连续下标读取经纬度,代码必须写成 lat = payload[2][1][0]。这类写法被称为“幻数索引(Magic Indexing)”,读者无法仅凭这行代码看出数据代表什么,一旦接口层在中途插入新字段,整条下标链便会全盘错位。
通过结构镜像解包,我们只需写出对应的变量骨架:
user_id, (city, district), (status, (lat, lng)) = payload

print(user_id)   # 输出示例: 10086
print(city)      # 输出示例: 北京
print(lat, lng)  # 输出示例: 39.92 116.44
在上述代码中,等号两端呈现出严格的拓扑同构映射。Python 解释器会首先校验外层序列包含 3 个槽位,随后将第 0 项直接绑定至 user_id;检测到第 1 项对应嵌套元组 (city, district),即下潜至该子序列完成两个局部变量的绑定;进入第 2 项后,进一步深入两层完成 lat 与 lng 的赋值。
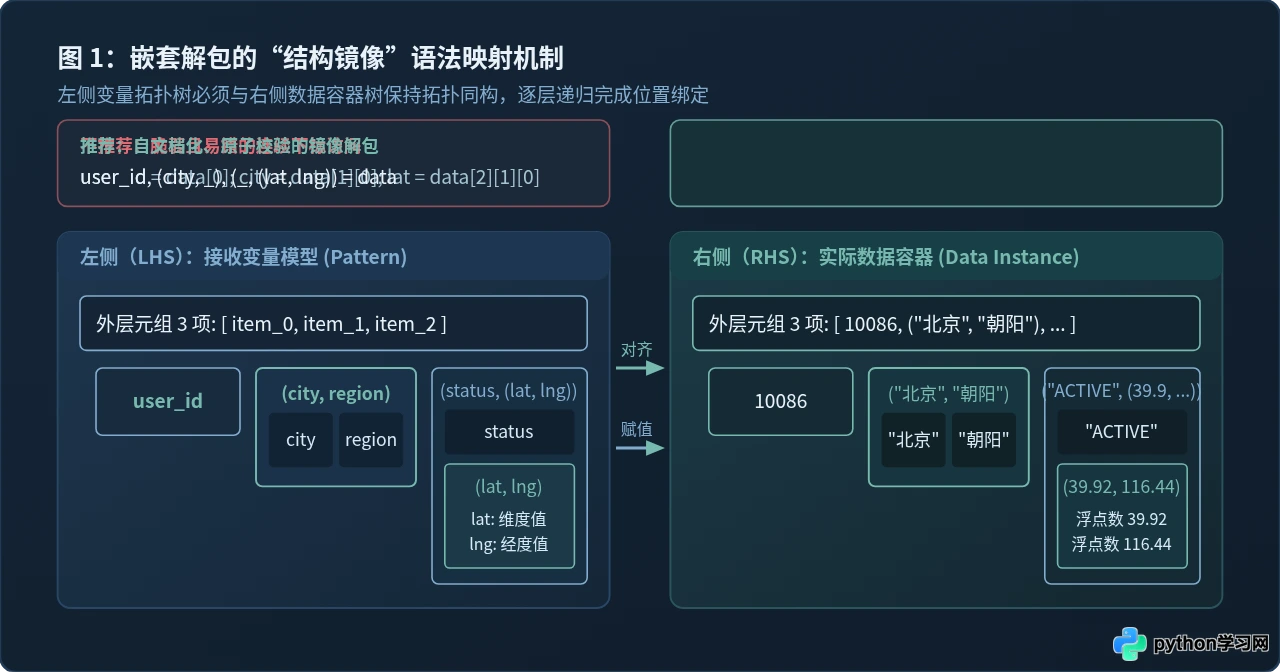
[a, (b, c)] 去解包 ("val1", ["val2", "val3"]) 完全合法,因为解包只关心对象的可迭代协议与元素序列次序。但在工程实践中,为了保持代码的自文档化与意图表达清晰,建议左侧括号书写习惯尽量呼应右侧数据的本来面貌。
二、嵌套解包的执行过程与运行时断言特性
理解嵌套解包的内部执行流程,有助于掌握它与常规赋值的本质差异。解包赋值在 Python 中兼具“数据绑定”与“运行时拓扑断言(Structural Assertion)”双重职责。
整个解包执行过程可以分解为四个明确的步骤:
- 外层长度校验:检查右侧容器总长度是否精确匹配左侧外层变量槽位数(若未使用星号,则必须严格相等)。
- 浅层标量赋值:对外层非嵌套变量名直接建立引用绑定。
- 递归展开子容器:遇到嵌套括号时,将对应位置的对象视为独立待解包序列,递归进入子层。
- 叶子变量定标生效:所有嵌套分支全部解包完毕后,整条语句原子性完成。
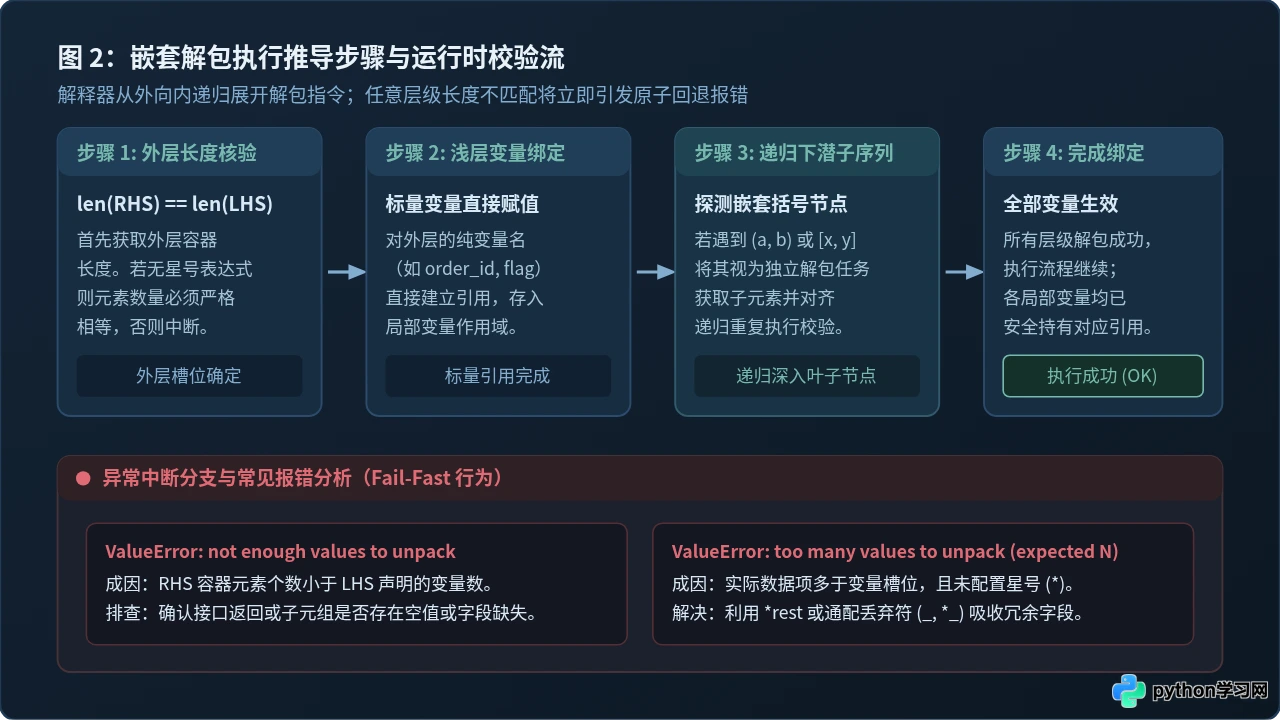
这种“快速失败(Fail-Fast)”机制是嵌套解包最实用的优势之一。如果上游数据因为脏数据、网络丢包或版本迭代缺失了某个子字段,下标访问可能会返回错误的值或者在极深的代码调用处引发异常;而嵌套解包会在数据进入的第一时间抛出 ValueError,阻断脏数据向下游隐式渗透。
三、结合扩展星号(*):弹性提取可变长度的嵌套数据
真实业务场景中的数据往往不是完全固定长度的。例如在批量日志行中,中间可能夹杂着不确定数量的中间事件,或者在末尾包含变长的指标数组。如果在嵌套解包中只写固定数量的变量名,就会因长度不符而报错。
Python 3 遵循 PEP 3132 规范引入了扩展可迭代对象解包(Extended Iterable Unpacking),即星号表达式 *rest。当星号与嵌套序列结合时,表现出极高的灵活性与精准度。
1. 星号在不同嵌套层级的独立作用域
Python 语法明确规定:在同一个括号层级内部,只能出现至多一个星号表达式;但在不同的嵌套层级之间,星号各自拥有完全独立的作用域。
# 示例:多级日志批次数据
# 结构:[批次ID, 中间日志项1, 中间日志项2, ..., (状态码, 指标值1, 指标值2, ...)]
log_batch = [
    "BATCH-2026-X",
    "conn_init",
    "auth_passed",
    "token_refresh",
    (200, 45.2, 58.1, 62.0)
]

# 跨层级嵌套星号解包
batch_id, *middle_events, (status_code, *metrics) = log_batch

print(f"批次编号: {batch_id}")
print(f"中间流转事件 (列表): {middle_events}")
print(f"终端状态码: {status_code}")
print(f"指标测量集 (列表): {metrics}")

# 示例输出:
# 批次编号: BATCH-2026-X
# 中间流转事件 (列表): ['conn_init', 'auth_passed', 'token_refresh']
# 终端状态码: 200
# 指标测量集 (列表): [45.2, 58.1, 62.0]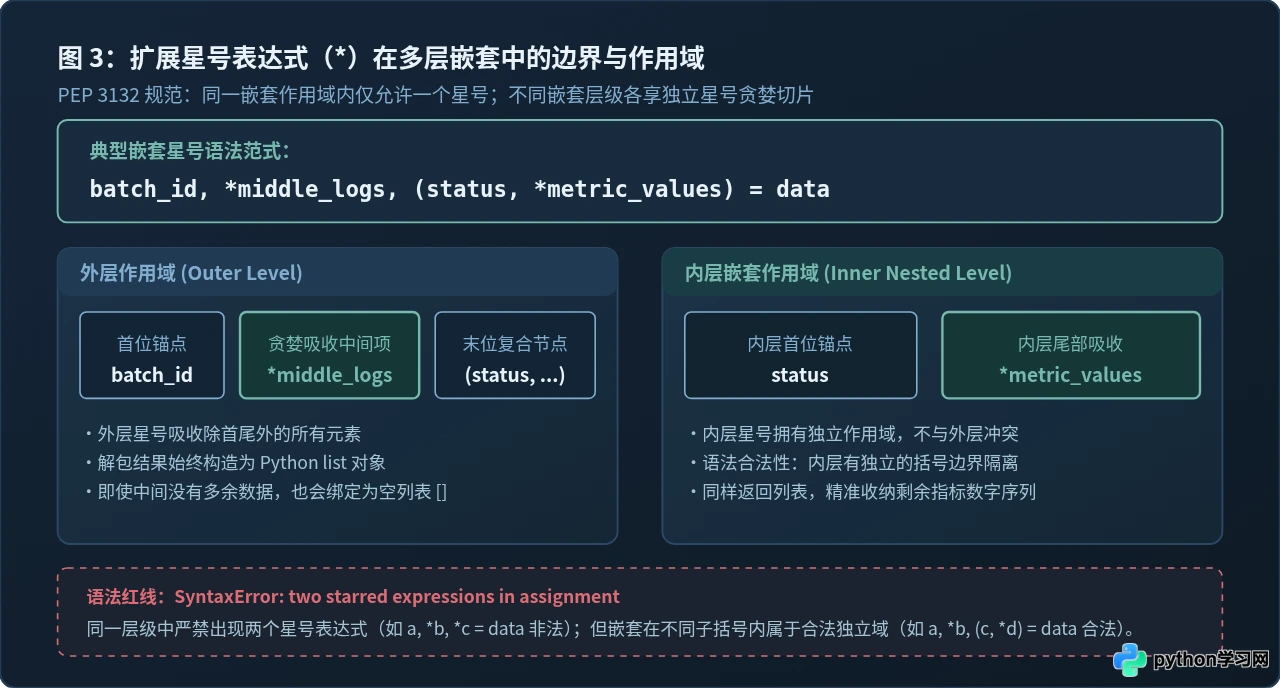
2. 星号变量的边界表现
- 类型一致性:星号变量所捕获的内容,在解包完成后永远被构造为一个标准的 Python
list,哪怕原容器是元组或生成器。 - 零匹配容忍:当待吸收区间不存在多余元素时,星号变量会自动绑定为一个空的列表
[],不会触发ValueError。 - 哑变量丢弃(Dump Variable):如果你只关注嵌套序列的首尾字段而需要忽略中间所有变长内容,可以使用
*_占位,例如head, *_, (tail_status, *_) = payload。
四、循环与迭代场景中的原地解包实战
除了单次赋值语句,嵌套解包在 for 循环体、生成器表达式以及内置迭代工具(如 enumerate 与 zip)中能够发挥巨大的工程价值。
1. 遍历地理栅格或带元数据的多维列表
# 多维航线轨迹数据点:[(点位编号, (经度, 纬度), [高度, 速度, 俯仰角]), ...]
route_track = [
    ("WP-01", (121.47, 31.23), [1200.0, 450.0, 1.2]),
    ("WP-02", (121.52, 31.28), [1500.0, 480.0, 2.5]),
    ("WP-03", (121.60, 31.35), [1800.0, 510.0, 0.0]),
]

# 在循环头部直接进行原地嵌套解包
for point_id, (lon, lat), (altitude, *flight_dynamics) in route_track:
    print(f"到达路标 {point_id}:坐标 ({lon}, {lat}),巡航高度 {altitude} 米")
2. 避开 enumerate() 的双层括号陷阱
许多初学者在结合 enumerate() 遍历复杂结构时容易写出导致报错的代码。因为 enumerate(iterable) 在每次迭代时产出一个形如 (index, item) 的二元组。如果 item 本身是一个复合元组,必须使用明确的嵌套括号将其隔开:
records = [
    ("ORD-A", ("上海", 199.0)),
    ("ORD-B", ("杭州", 299.0)),
]

# 正确写法:外层括号区分索引,内层括号解构 item
for step, (order_id, (city, amount)) in enumerate(records, start=1):
    print(f"步骤 {step}: 订单 {order_id} 发往 {city},金额 {amount}")

# 常见错误写法:
# for step, order_id, (city, amount) in enumerate(records):
# 会引发 ValueError: not enough values to unpack (expected 3, got 2)
五、常见错误排查与语法避坑指南
在实际编写嵌套解包代码时,最常见的阻碍主要来自括号书写疏漏与数据形状失配。
高发场景:从数据库查询返回的某些字段为
None,或者本应是双元组的字段返回了空元组 ()。排查对策:在解包前对空值进行默认值兜底,或者在解包层引入条件守卫,避免将非容器类型送入嵌套槽位。
代码对照:
# 错误代码(解释器直接抛出语法错误,无法通过编译)
a, *b, *c, (d, e) = data

# 正确代码(将第二个星号放入独立的嵌套子作用域)
a, *b, (d, *c) = data(x) 只表示优先级运算括号,不是元组!如果要解包一个仅含单一元素的嵌套元组,必须保留尾部逗号:
nested_data = ("A", (100,))

# 正确解包单一元素的嵌套元组:
code, (value,) = nested_data

# 若写成 code, (value) = nested_data
# 此时 (value) 退化为普通标识符,等价于 code, value = nested_data
# 最终 value 拿到的将是整个元组 (100,),导致类型与预期不符。
六、技术选型与重构边界:何时解包,何时建立对象模型?
嵌套解包非常强大,但并不意味着所有多层数据结构都应该无限期使用解包来处理。工程代码的可维护性取决于在正确的地方使用适合的抽象工具。
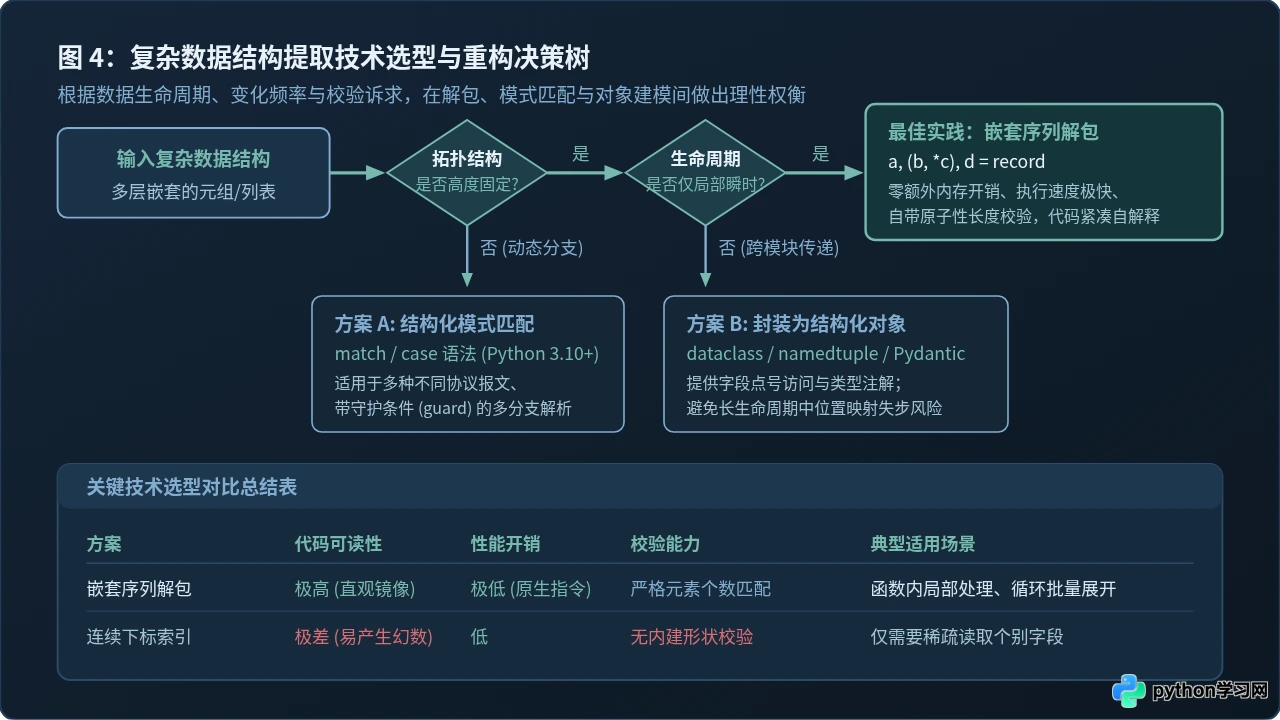
| 技术方案 | 典型代码特征 | 内存/性能 | 形态校验能力 | 最适合的业务场景 |
|---|---|---|---|---|
| 嵌套序列解包 | a, (b, *c) = data |
零开销,原生指令 | 极强(严格按形状校验) | 局部函数内快速清洗、数据管道中转、临时元组拆解 |
| 模式匹配 (match/case) | case [a, (b, c)]: |
低,带运行时判断 | 极强(支持类型与守卫条件) | 多协议分支响应、复杂事件路由、支持备选结构的解析 |
| 具名元组 (NamedTuple) | record.user.city |
极低(仍基于元组实现) | 强(支持类型标注) | 需要通过明确字段名访问、在多个模块间长生命周期传递 |
| 数据类 (dataclass) | @dataclass class Order: |
轻量(对象实例) | 极强(可结合校验框架) | 核心领域模型、复杂业务实体、持久化实体对象 |
实用重构准则:
- 如果嵌套层级小于等于 3 层,且数据只在当前函数作用域内瞬时消费,优先使用嵌套序列解包,代码最简练高效。
- 如果需要针对不同的返回格式分支做针对性提取,推荐升级到 Python 3.10+ 的
match/case结构化模式匹配。 - 如果数据结构需要在超过两个模块或长链条函数间透传,请在数据入口处完成解包后,立即封装为
typing.NamedTuple或dataclass,避免让位置依赖污染核心业务逻辑。
七、总结
从复杂数据结构中提取数据,本质上是一场在“代码表达力”与“结构脆弱度”之间的权衡。Python 提供的嵌套序列解包机制,以最小的语法开销实现了结构镜像映射,消除了散落各处的幻数下标,并提供了天然的结构断言保障。
在日常开发中,熟练掌握“对称镜像排布”、“星号分层吸收”以及“循环原地解构”三项核心技巧,足以帮助我们优雅、稳健地驾驭绝大多数多层序列数据。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















