


Python用pandas读取CSV清洗后保存为新文件
系统讲解如何使用Python的pandas库完整读取CSV原始数据、探查与清洗脏数据(去除空格、删除重复、填充缺失、转换字段类型),并以安全规范的方式导出保存为全新CSV文件的完整操作指南。
pandas.read_csv() 载入原始数据、排查脏字符与格式缺陷、执行去重/剔空/格式矫正,并最终使用 to_csv(..., index=False, encoding='utf-8-sig') 安全保存为全新CSV文件的完整执行链路。
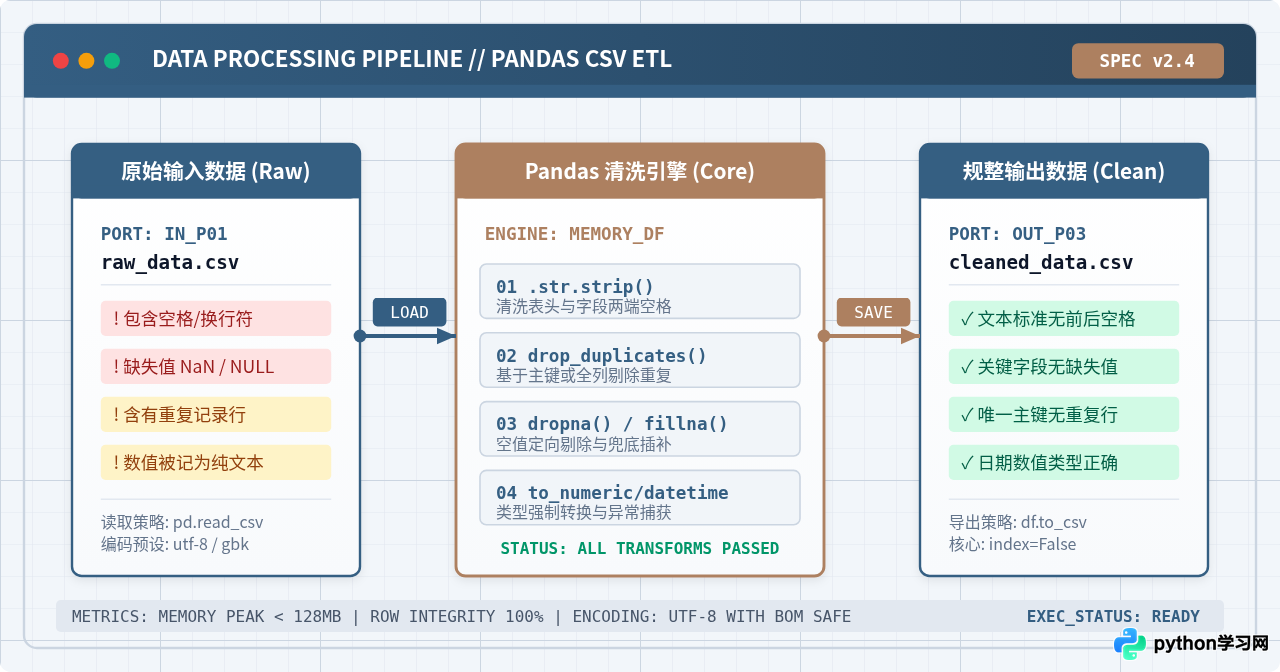
一、标准处理全景与最小可运行代码
为了让整个清洗逻辑一目了然,我们首先给出符合生产规范的最小完整范例。整个过程遵循“读入隔离、内存规整、独立存盘”的设计原则,确保不会污染原始文件,也不会引入任何额外的索引杂质。
# 示例:最小化端到端清洗与保存代码
import pandas as pd

# 1. 载入原始 CSV 文件
raw_file = "raw_data.csv"
df = pd.read_csv(raw_file, encoding='utf-8-sig')

# 2. 清洗操作:修剪表头与字符串空格、去除重复、丢弃关键主键缺失、规整数值
df.columns = df.columns.str.strip()
df = df.drop_duplicates()
df = df.dropna(subset=['order_id', 'user_id'])
df['amount'] = pd.to_numeric(df['amount'], errors='coerce').fillna(0.0)

# 3. 保存至全新文件(务必设置 index=False)
output_file = "cleaned_data.csv"
df.to_csv(output_file, index=False, encoding='utf-8-sig')

print(f"清洗完成,已保存至: {output_file},有效记录数: {len(df)}")
上述代码展示了最核心的三要素:指定清晰的输入输出路径、在内存中链式处理脏数据、使用防破坏参数导出。接下来,我们将按实际执行步骤,把各个环节需要把控的关键参数与排坑细节具体展开。
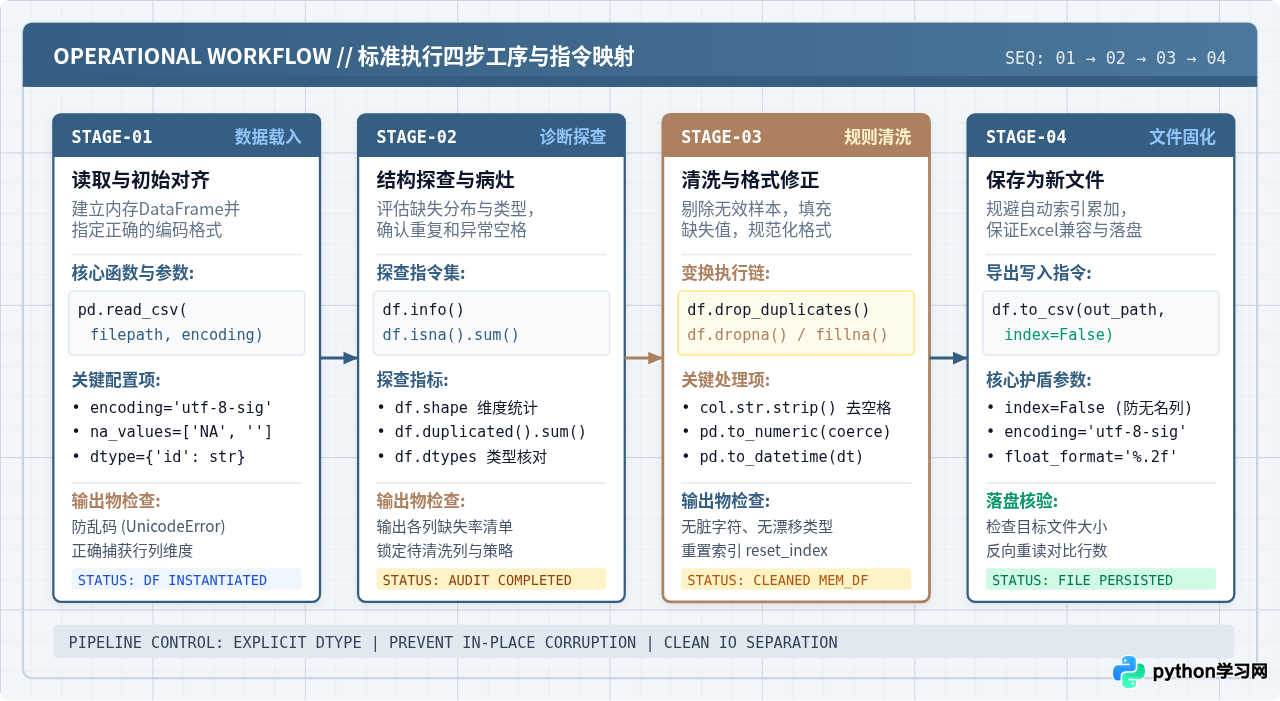
二、步骤一:读取CSV文件与边界配置
使用 pd.read_csv() 读取外部文件时,看似只需传入一个文件名,但在实际生产场景中,文件往往来自不同操作系统或第三方系统导出,极易遇到编码不兼容、首行异常、特殊缺失符号等问题。
1. 正确处理字符编码与中文防乱码
中文环境中最常见的报错是 UnicodeDecodeError: 'utf-8' codec can't decode byte...。这是因为文件可能是由 Windows 平台的 Excel 导出的 ANSI/GBK 格式,或者虽为 UTF-8 但带有特殊字节标记。
- 推荐首选:
encoding='utf-8-sig'。它可以自动兼容标准 UTF-8 以及带有 BOM 头()的 CSV,避免第一个列名开头出现多余不可见字符。 - GBK/Windows系统导出:如果确定文件为国内旧系统或中文 Windows Excel 另存所得,应设置
encoding='gb18030'或encoding='gbk'。
# 安全读取示例:针对可能存在编码差异的容错读取策略
try:
    df = pd.read_csv("raw_orders.csv", encoding='utf-8-sig')
except UnicodeDecodeError:
    df = pd.read_csv("raw_orders.csv", encoding='gb18030')
2. 显式声明缺失符号与字段类型
原始 CSV 中经常用 "-"、"N/A"、"NULL"、"None" 或空白字符串表示缺失值。如果不在读取阶段声明,pandas 可能会将整列都判定为通用文本对象(object),增加后续清洗成本。
# 统一将特定标记识别为 NaN,并显式锁定主键类型防止前导零丢失
df = pd.read_csv(
    "raw_orders.csv",
    encoding='utf-8-sig',
    na_values=['-', 'N/A', 'NULL', '', 'none'],
    dtype={'order_sn': str, 'phone': str}  # 防止电话与单号被转成浮点数或丢弃开头的0
)
三、步骤二:数据结构探查与脏数据定位
在直接上手修改数据之前,必须先对数据进行全方位探查。盲目写清洗逻辑容易造成“误删大量数据”或“遗漏潜在异常”。
# 基础体检三板斧
print("--- 1. 数据维度 (行数, 列数) ---")
print(df.shape)

print("
--- 2. 列类型及非空计数 ---")
df.info()

print("
--- 3. 各列缺失值统计 ---")
print(df.isna().sum())

print("
--- 4. 重复行数统计 ---")
print(f"完全重复记录数: {df.duplicated().sum()}")
通过 df.info() 可以快速发现两类典型病灶:一是本该是数值或日期的列却呈现为 object;二是某些列的非空数量明显低于总行数,说明存在大量空缺。
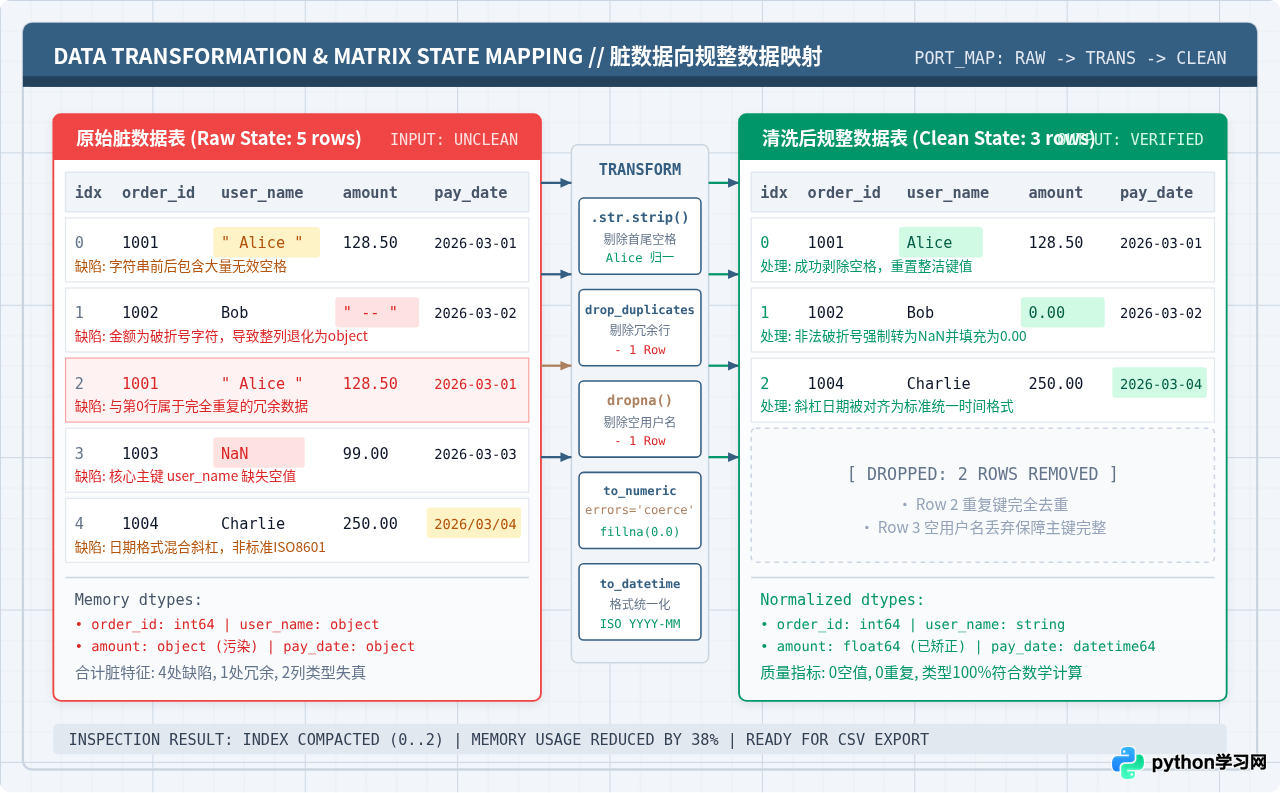
四、步骤三:核心清洗操作实战
数据清洗的核心目标是让每一列具备纯净的语义、合理的类型以及唯一确定性。根据工程实践,清洗通常包含以下四个标准动作。
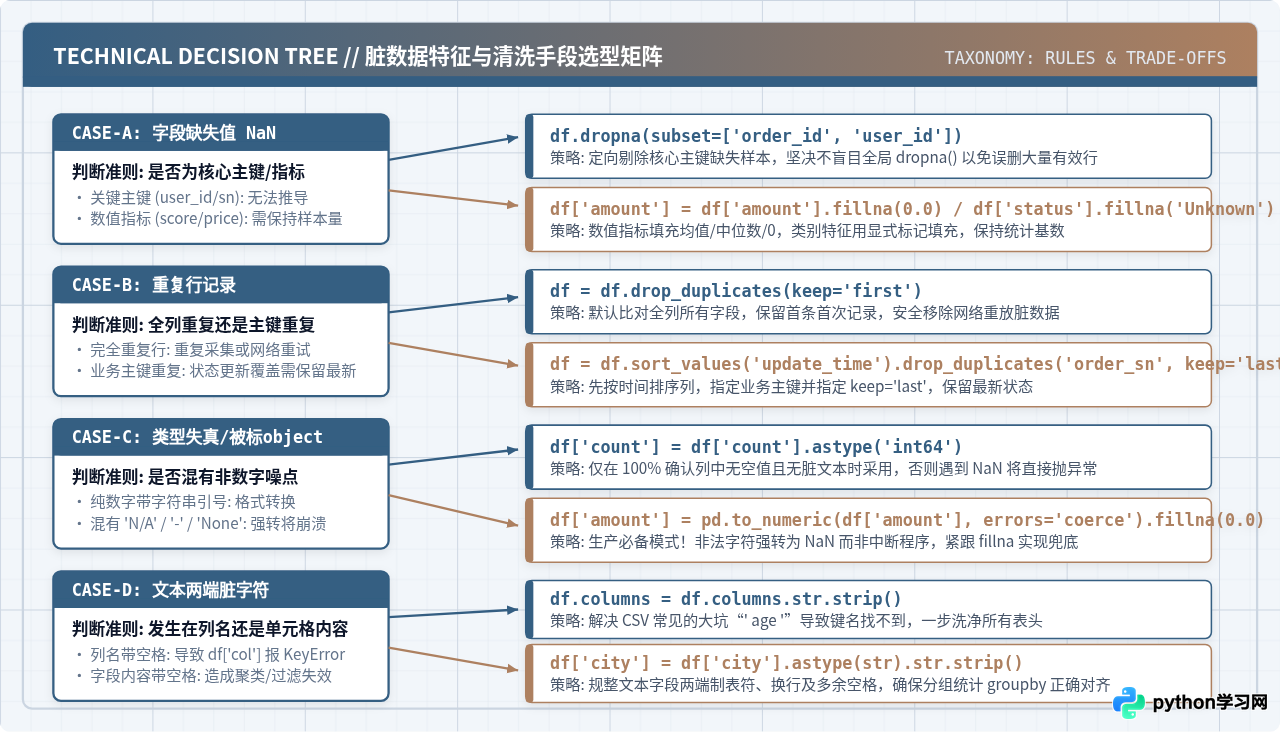
1. 去除列名与字段两端的多余空格
从手工维护的 CSV 或非标准格式中导出的数据,表头或内容常带有无意按下的空格。例如表头为 " order_id ",若直接用 df['order_id'] 取值会报 KeyError。
# 清除所有列名的首尾空格
df.columns = df.columns.str.strip()

# 针对字符串列批量去除首尾空格与制表符
string_cols = df.select_dtypes(include=['object', 'string']).columns
for col in string_cols:
    df[col] = df[col].astype(str).str.strip()
2. 重复记录行剔除 (drop_duplicates)
重复记录通常由重复导出、重放抓取或上游合并导致。清洗时要明确是“全字段完全相同才去重”,还是“业务主键相同即去重”。
- 全行匹配去重:直接调用
df.drop_duplicates(),默认保留首次出现的记录(keep='first')。 - 基于业务主键去重:若同一个单号多次记录,需先按更新时间排序,再保留最后一条最新记录。
# 业务主键去重示例:按更新时间保留最新一条
df = df.sort_values('update_time').drop_duplicates(subset=['order_sn'], keep='last')
3. 缺失值科学处理 (dropna / fillna)
对待缺失值(NaN / None)不能简单粗暴地全量丢弃。必须根据业务重要性实行分流策略:
- 关键主键与唯一标示:对于无法推理的字段(如订单ID、用户ID),缺失意味着数据无效,必须坚决丢弃:
df = df.dropna(subset=['order_id'])。 - 数值型度量指标:如金额、数量,若缺失可填充兜底值
0.0,或基于上下文填充列均值/中位数:df['amount'] = df['amount'].fillna(0.0)。 - 文本分类字段:如省份、渠道来源,若缺失填充为显式标记
"Unknown"或"未填写"。
4. 数据类型规范化与安全转换
直接使用 df['col'].astype(float) 是初学者容易踩坑的地方——一旦列中隐藏着一个未能识别的字符串(如 "null" 或字符破折号),程序会立刻抛出 ValueError 崩溃。
推荐的生产实践是使用 pd.to_numeric() 配合 errors='coerce':它会将所有无法转换为有效数字的异常字符强制转换为 NaN,再通过 fillna() 兜底,保证流程平稳运行。
# 稳健转换数值列
df['amount'] = pd.to_numeric(df['amount'], errors='coerce').fillna(0.0)

# 稳健转换日期列为统一格式
df['pay_date'] = pd.to_datetime(df['pay_date'], errors='coerce')
# 剔除日期完全损坏无法解析的废弃样本
df = df.dropna(subset=['pay_date'])
五、步骤四:将清洗后数据导出为新CSV文件
清洗完成后,调用 df.to_csv() 导出文件。此处的参数配置直接决定了生成文件是否合规、是否会对下次分析产生副作用。
index=False,导出的 CSV 将包含一列未命名的行号。当该文件被再次读取并保存时,会累加出 Unnamed: 0、Unnamed: 0.1 等无用列,造成数据文件污染。
# 规范保存为新文件
clean_output_path = "orders_cleaned_2026.csv"

df.to_csv(
    clean_output_path,
    index=False,               # 严禁保存行索引,确保列结构对齐
    encoding='utf-8-sig',       # 带 BOM 的 UTF-8,确保 Excel 与各类软件直接双击不乱码
    float_format='%.2f',        # 统一浮点数保留2位小数,防止科学计数法失真
    date_format='%Y-%m-%d'     # 统一日期格式落盘
)
六、完整工程级脚本与前后校验闭环
在自动化调度或脚本交付中,除了清洗操作本身,还必须加入“前置输入校验”与“落盘后反向核验”,形成一个高鲁棒性的执行闭环。以下给出具备异常处理与成果复核的完整工程脚本:
# -*- coding: utf-8 -*-
import os
import sys
import pandas as pd

def clean_csv_pipeline(input_file: str, output_file: str) -> bool:
    """
    读取原始CSV,执行清洗并安全保存为新文件
    """
    # 1. 前置条件检查
    if not os.path.exists(input_file):
        print(f"[错误] 目标输入文件不存在: {input_file}")
        return False

    print(f"[*] 正在读取原始数据: {input_file} ...")
    try:
        df = pd.read_csv(input_file, encoding='utf-8-sig')
    except UnicodeDecodeError:
        df = pd.read_csv(input_file, encoding='gb18030')

    initial_rows = len(df)
    print(f"[*] 原始数据载入成功,共计 {initial_rows} 行,{len(df.columns)} 列")

    # 2. 表头与文本清洗
    df.columns = df.columns.str.strip()
    for col in df.select_dtypes(include=['object']).columns:
        df[col] = df[col].astype(str).str.strip()

    # 3. 剔除全行完全重复记录
    df = df.drop_duplicates()

    # 4. 关键主键非空校验(示例以 order_id 为例)
    if 'order_id' in df.columns:
        df = df.dropna(subset=['order_id'])

    # 5. 数值列安全转换(示例以 amount 为例)
    if 'amount' in df.columns:
        df['amount'] = pd.to_numeric(df['amount'], errors='coerce').fillna(0.0)

    # 6. 重置自增索引
    df = df.reset_index(drop=True)
    final_rows = len(df)
    print(f"[*] 内存清洗完毕,保留有效行数: {final_rows} (清理剔除: {initial_rows - final_rows} 行)")

    # 7. 导出至新文件(防止覆盖原始数据)
    print(f"[*] 正在写入规整数据至: {output_file} ...")
    df.to_csv(output_file, index=False, encoding='utf-8-sig', float_format='%.2f')

    # 8. 闭环落盘验收
    if os.path.exists(output_file) and os.path.getsize(output_file) > 0:
        verify_df = pd.read_csv(output_file, encoding='utf-8-sig')
        assert len(verify_df) == final_rows, "行数校验不一致!"
        print(f"[✓] 导出验收通过!文件大小: {os.path.getsize(output_file)} 字节,校验行数一致。")
        return True
    else:
        print("[错误] 目标文件导出失败或为空文件!")
        return False

if __name__ == "__main__":
    clean_csv_pipeline("raw_data.csv", "cleaned_data.csv")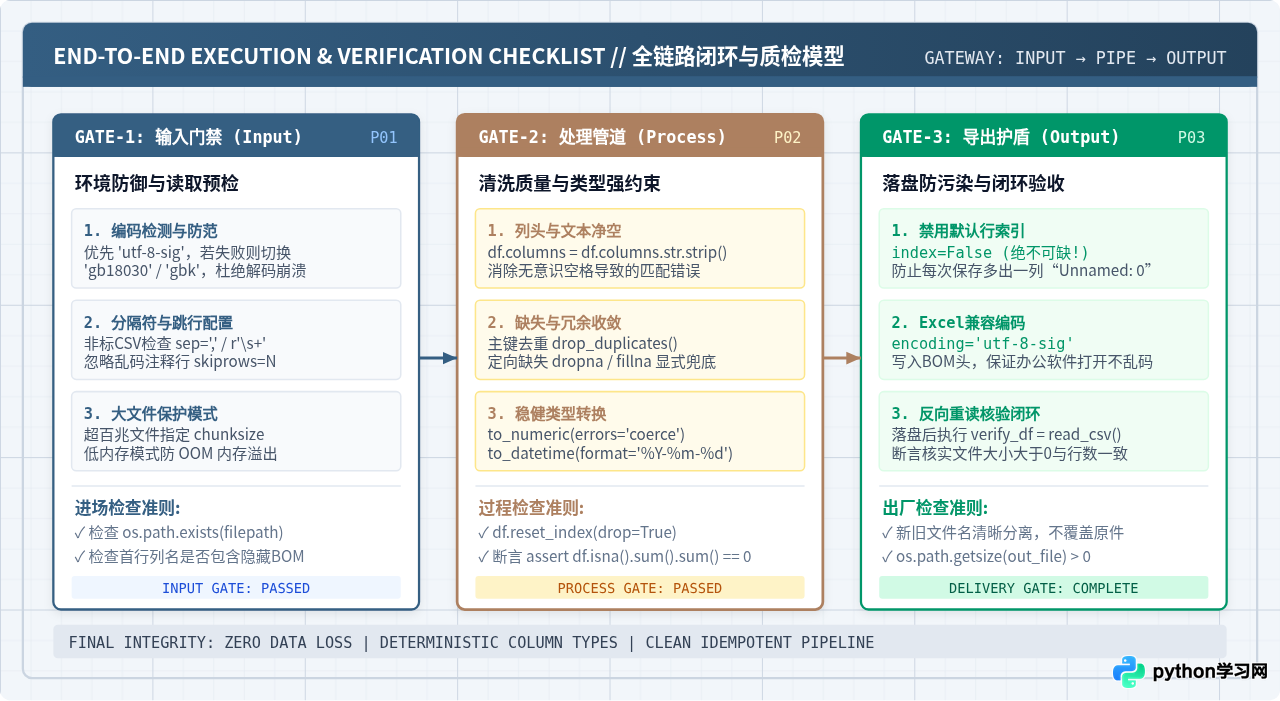
七、常见排错排查与工程注意事项
| 常见问题表现 | 根本原因排查 | 推荐修复方案 |
|---|---|---|
导出的文件多了一列 Unnamed: 0 |
调用 to_csv() 时未指定 index=False,导致行索引被作为数据列写出。 |
在 to_csv(out_path, index=False) 中强制加入 index=False。若已有多余列,读取后执行 df.drop(columns=[col for col in df if 'Unnamed' in col]) 剔除。 |
| Excel 打开 CSV 出现中文乱码(一堆菱形或乱字符) | 标准 UTF-8 没有写入微软体系识别的 BOM 字节序,导致 Windows Excel 默认以 ANSI 编码解析。 | 写入与读取均显式声明 encoding='utf-8-sig'。 |
DtypeWarning: Columns (...) have mixed types |
CSV 某列前千行是数字,后续突然出现字符串,pandas 内存推断冲突。 | 在 read_csv 中指定 dtype={'col': str} 或 low_memory=False,并在后续逻辑中显式用 pd.to_numeric(..., errors='coerce') 转换。 |
身份证号/银行卡号末尾数字变成 .0 或科学计数法 1.23E+17 |
未预设类型时,长数字字符串被 pandas 自动推断为 float64 导致精度被截断。 |
读取时在 dtype 参数中强行指定为主键字符串:dtype={'id_card': str}。 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















